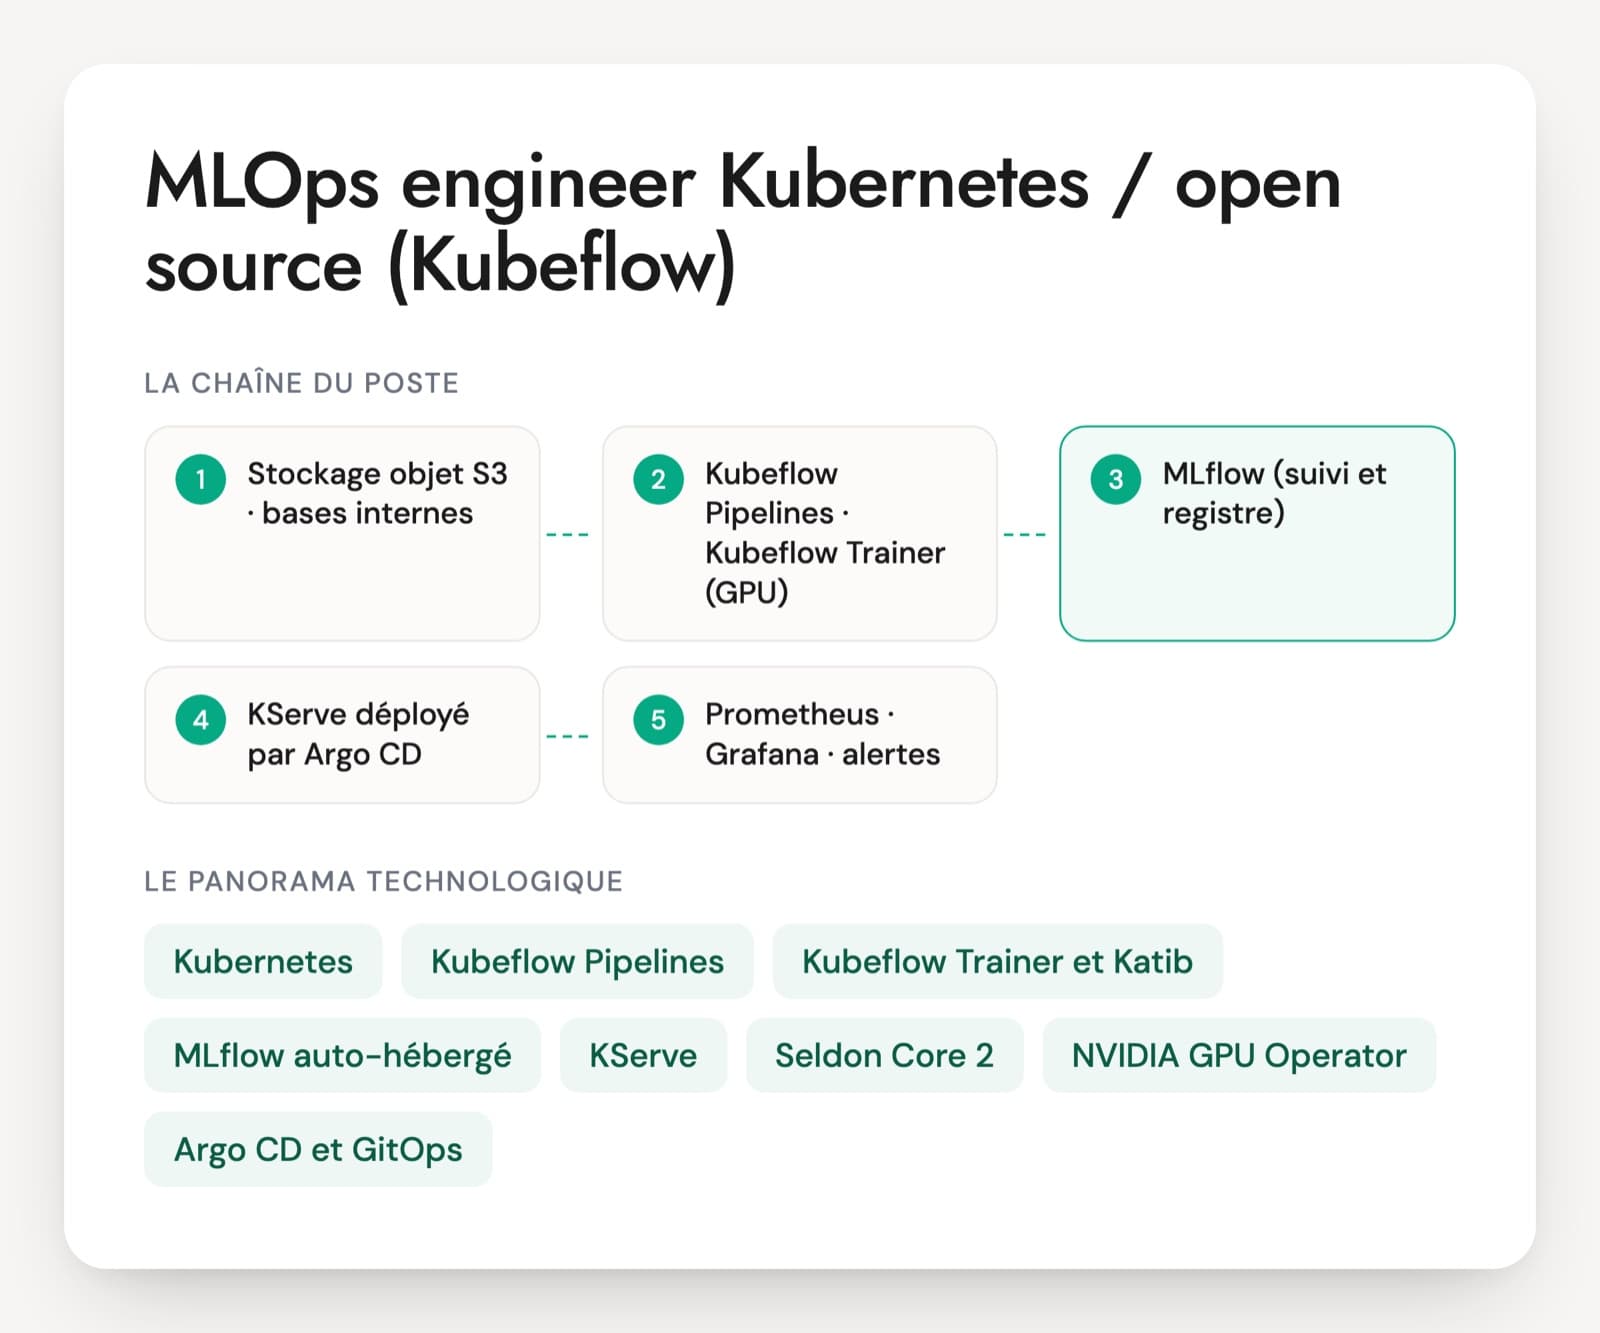
Le MLOps engineer Kubernetes et Kubeflow construit et exploite la plateforme où les data scientists entraînent, enregistrent et servent leurs modèles, sur un cluster que l'entreprise opère elle-même. On le cherche surtout dans la défense, l'industrie, le secteur public et les organisations qui gardent leurs données sur site pour des raisons de souveraineté. Les offres citent Kubeflow, MLflow, KServe, Argo CD, Docker, Terraform et des GPU NVIDIA.
Le risque, c'est un CV qui aligne ces outils sans les avoir exploités. Une installation de démonstration tient en une journée, alors qu'une plateforme partagée par plusieurs équipes demande autre chose : des GPU découpés proprement, un MLflow qui supporte la charge, des montées de version sans casse, un cluster parfois sans internet. Les personnes qui l'ont vécu parlent spontanément de pods en attente, de cache de pipeline trompeur et de démarrages à froid.
Le PDF contient 30 questions réparties sur six axes, un cas de 20 minutes sur un modèle de classification de documents à servir dans un datacenter fermé et une grille de 1 à 4.
Kubeflow, MLflow, KServe : la pile open source du poste
Kubernetes
Le socle de la plateforme. Chaque équipe dispose d'un espace de noms avec ses quotas, et chaque étape d'entraînement ou de service tourne dans un pod. Le MLOps engineer n'administre pas toujours le cluster, mais il doit savoir pourquoi un pod reste en attente ou redémarre en boucle.
Kubeflow Pipelines
L'outil qui décrit les chaînes d'entraînement en Python et les exécute sur le cluster, une étape par conteneur. Les résultats intermédiaires vont dans un stockage objet et un cache évite de relancer ce qui n'a pas changé. Kubeflow est désormais un projet diplômé de la CNCF.
Kubeflow Trainer et Katib
Kubeflow Trainer lance les entraînements distribués sur plusieurs nœuds et GPU (PyTorch, MPI, fine-tuning de LLM). Il succède au Training Operator, dont les PyTorchJob apparaissent encore sur beaucoup de CV. Katib automatise la recherche d'hyperparamètres en lançant des essais en parallèle.
MLflow auto-hébergé
Le suivi des expériences et le registre de modèles. Installé sur site, il demande une base PostgreSQL, un stockage objet pour les artefacts et une authentification. Depuis MLflow 2.9, les alias comme champion remplacent les anciens stades Staging et Production pour désigner la version en service.
KServe
Le service de modèles sur Kubernetes, projet en incubation à la CNCF. Une ressource InferenceService déploie un modèle en mode standard ou en mode Knative, capable de descendre à zéro. Une ressource dédiée aux LLM s'appuie sur vLLM. Les déploiements progressifs se pilotent depuis la même ressource.
Seldon Core 2
Une alternative à KServe, appréciée pour ses pipelines d'inférence. Sa version 2 est publiée sous Business Source License, ce qui impose de vérifier les conditions d'usage commercial avec l'éditeur. C'est un bon sujet pour voir si la personne regarde au-delà de la technique.
NVIDIA GPU Operator
Il installe et maintient sur chaque nœud les pilotes, le plugin qui expose les GPU à Kubernetes et l'export des métriques. Il gère aussi le partage des cartes, par découpage matériel (MIG) ou par temps partagé (time-slicing). Les GPU coûtent cher, leur partage est souvent le premier sujet de friction.
Argo CD et GitOps
Argo CD applique sur les clusters ce qui est décrit dans Git et signale tout écart. Les composants de la plateforme et les modèles en service se déploient par merge request. Revenir en arrière revient à annuler un commit.
Stockage objet, registre d'images et secrets
Un stockage compatible S3 (MinIO, Ceph) garde artefacts et modèles. Un registre comme Harbor héberge les images, indispensable sur un cluster sans internet. Les secrets passent par Vault ou un équivalent, jamais en clair dans Git.
Ce poste existe surtout là où les données ne peuvent pas partir chez un fournisseur cloud : défense, aéronautique, secteur public, santé, industrie, ou entreprises qui ont acheté leurs propres GPU. La personne travaille entre les data scientists et l'équipe qui administre Kubernetes, parfois dans la même équipe. En ESN, les missions consistent souvent à monter la plateforme d'un client ou à reprendre une installation Kubeflow vieillissante. La charge d'exploitation est plus lourde qu'avec un service managé : authentification, sauvegardes, mises à jour, pilotes GPU et astreinte reviennent à l'équipe. Les certifications Kubernetes de la CNCF attestent le socle, pas la partie machine learning.
Les compétences à confirmer chez un MLOps engineer Kubernetes
- Kubeflow Pipelines et entraînement distribué
- MLflow auto-hébergé : suivi et registre
- Service de modèles avec KServe
- GPU sur Kubernetes : partage et ordonnancement
- GitOps et exploitation de la plateforme
- Sécurité, multi-équipes et environnements déconnectés
Ce qu'un MLOps engineer Kubeflow doit savoir diagnostiquer, en cinq questions
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · senior
Un entraînement PyTorch distribué sur quatre nœuds GPU démarre à moitié : deux pods tournent, deux restent en attente, et les GPU réservés ne font rien. Que se passe-t-il, et comment l'évitez-vous ?
Une bonne réponseL'ordonnanceur de Kubernetes place les pods un par un : sans ordonnancement groupé (gang scheduling), une partie des workers démarre et bloque des GPU en attendant les autres. La réponse passe par une file d'attente qui n'admet le job que si toutes ses ressources sont libres, par exemple Kueue ou Volcano, que l'on associe à Kubeflow Trainer. S'y ajoutent des quotas par équipe et un délai au-delà duquel le job est annulé.
Signal d'alerte« On ajoute des nœuds », sans comprendre le blocage. Ou ignorer qu'un job distribué a besoin de tous ses pods en même temps.
Question 2 · confirmé
Vous installez MLflow pour cinquante data scientists. Quelle architecture déployez-vous ?
Une bonne réponseUn serveur de suivi derrière une authentification (proxy OIDC devant l'interface ou authentification intégrée), une base PostgreSQL pour les métadonnées, un stockage objet compatible S3 pour les artefacts, servis par le serveur lui-même pour ne pas distribuer de clés S3 à chacun. Des sauvegardes de la base, des expériences rangées par équipe, et une montée de version qui passe par la migration du schéma de base.
Signal d'alerteUn pod MLflow avec SQLite sur un volume local, sans authentification, ouvert à tout le réseau.
Question 3 · confirmé
Vous servez un modèle avec KServe. Mode Knative ou déploiement standard : comment choisissez-vous ?
Une bonne réponseLe mode Knative, dit serverless, descend à zéro réplique et absorbe des pics imprévisibles, au prix de démarrages à froid et de composants supplémentaires à opérer. Le mode standard donne un contrôle complet des ressources et convient aux GPU et à la production stable, avec une mise à l'échelle par HPA ou KEDA. Pour les LLM, KServe propose une ressource dédiée, LLMInferenceService. La personne relie le choix à la latence attendue et à la taille du modèle.
Signal d'alerteNe connaître qu'un mode, ou mettre en scale-to-zero un modèle GPU de plusieurs gigaoctets appelé par une application qui attend une réponse immédiate.
Question 4 · senior
Votre cluster compte huit GPU A100 et une vingtaine de data scientists veulent des notebooks avec GPU. Comment partagez-vous les cartes ?
Une bonne réponseAvec le GPU Operator, deux mécanismes : MIG découpe une A100 en instances isolées au niveau matériel, mémoire et pannes comprises ; le time-slicing fait tourner plusieurs pods à tour de rôle sur une carte, sans isolation mémoire ni partage proportionnel du calcul. Il réserve des instances MIG aux notebooks, éteint les notebooks inactifs et envoie les gros entraînements en jobs dans une file d'attente plutôt que dans un notebook.
Signal d'alerteUn GPU entier par notebook, allumé toute la semaine. Ou le time-slicing présenté comme une isolation entre utilisateurs.
Question 5 · confirmé
Comment installez-vous et mettez-vous à jour Kubeflow, MLflow et KServe sur plusieurs clusters ?
Une bonne réponseEn GitOps avec Argo CD : manifests Kustomize ou charts Helm versionnés dans Git, une application par composant, des environnements de développement, recette et production, une synchronisation automatique hors production et validée en production. Avant une montée de version, il lit les notes de version (changements de CRD, passage du Training Operator à Kubeflow Trainer), sauvegarde les bases et teste en recette.
Signal d'alerteDes kubectl apply lancés depuis un poste, ou une seule installation sans environnement de test.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Plateforme ML auto-hébergée : ce que les recruteurs veulent savoir
Kubeflow est-il indispensable pour ce poste ?
Non. Beaucoup de plateformes associent MLflow, Argo Workflows ou Airflow et KServe sans installer Kubeflow en entier. Ce qui compte, c'est l'exploitation sur Kubernetes : pipelines conteneurisés, registre, service de modèles, GPU. Une personne qui a tenu une de ces combinaisons apprendra vite Kubeflow. Méfiez-vous plutôt du profil qui connaît l'interface Kubeflow sans savoir comment elle s'exécute sur le cluster.
Un ingénieur DevOps Kubernetes peut-il tenir ce poste ?
Souvent, s'il accepte d'apprendre le cycle de vie d'un modèle. Il a déjà Helm, Argo CD, la supervision et la sécurité du cluster. Il lui manque en général la reproductibilité d'un entraînement, la notion de dérive, le registre de modèles et les particularités des GPU. En entretien, testez-le sur un entraînement distribué bloqué et sur la bascule d'un modèle, pas sur Kubernetes seul.
Faut-il exiger KServe, Seldon ou BentoML en particulier ?
Exiger l'outil exact réduit beaucoup le vivier. Les notions sont proches : ressource de déploiement, mise à l'échelle, déploiement progressif, serveur d'inférence adapté au modèle. Vérifiez plutôt que la personne sait choisir entre les modes de service et explique un démarrage à froid. Pour Seldon Core 2, regardez si elle connaît sa licence, la Business Source License, qui pèse dans un choix d'entreprise.
Sous quelle forme faire passer un test technique à ce profil ?
Un exercice de diagnostic en direct marche bien : la sortie d'un kubectl describe sur un pod GPU en attente, un manifest InferenceService mal réglé, un extrait de pipeline qui installe ses paquets au lancement. La personne explique ce qu'elle voit et ce qu'elle corrige. En une heure, vous mesurez l'expérience d'exploitation, ce qu'un projet à rendre montre mal. Delectus AI propose la grille du PDF pour noter chaque axe.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.