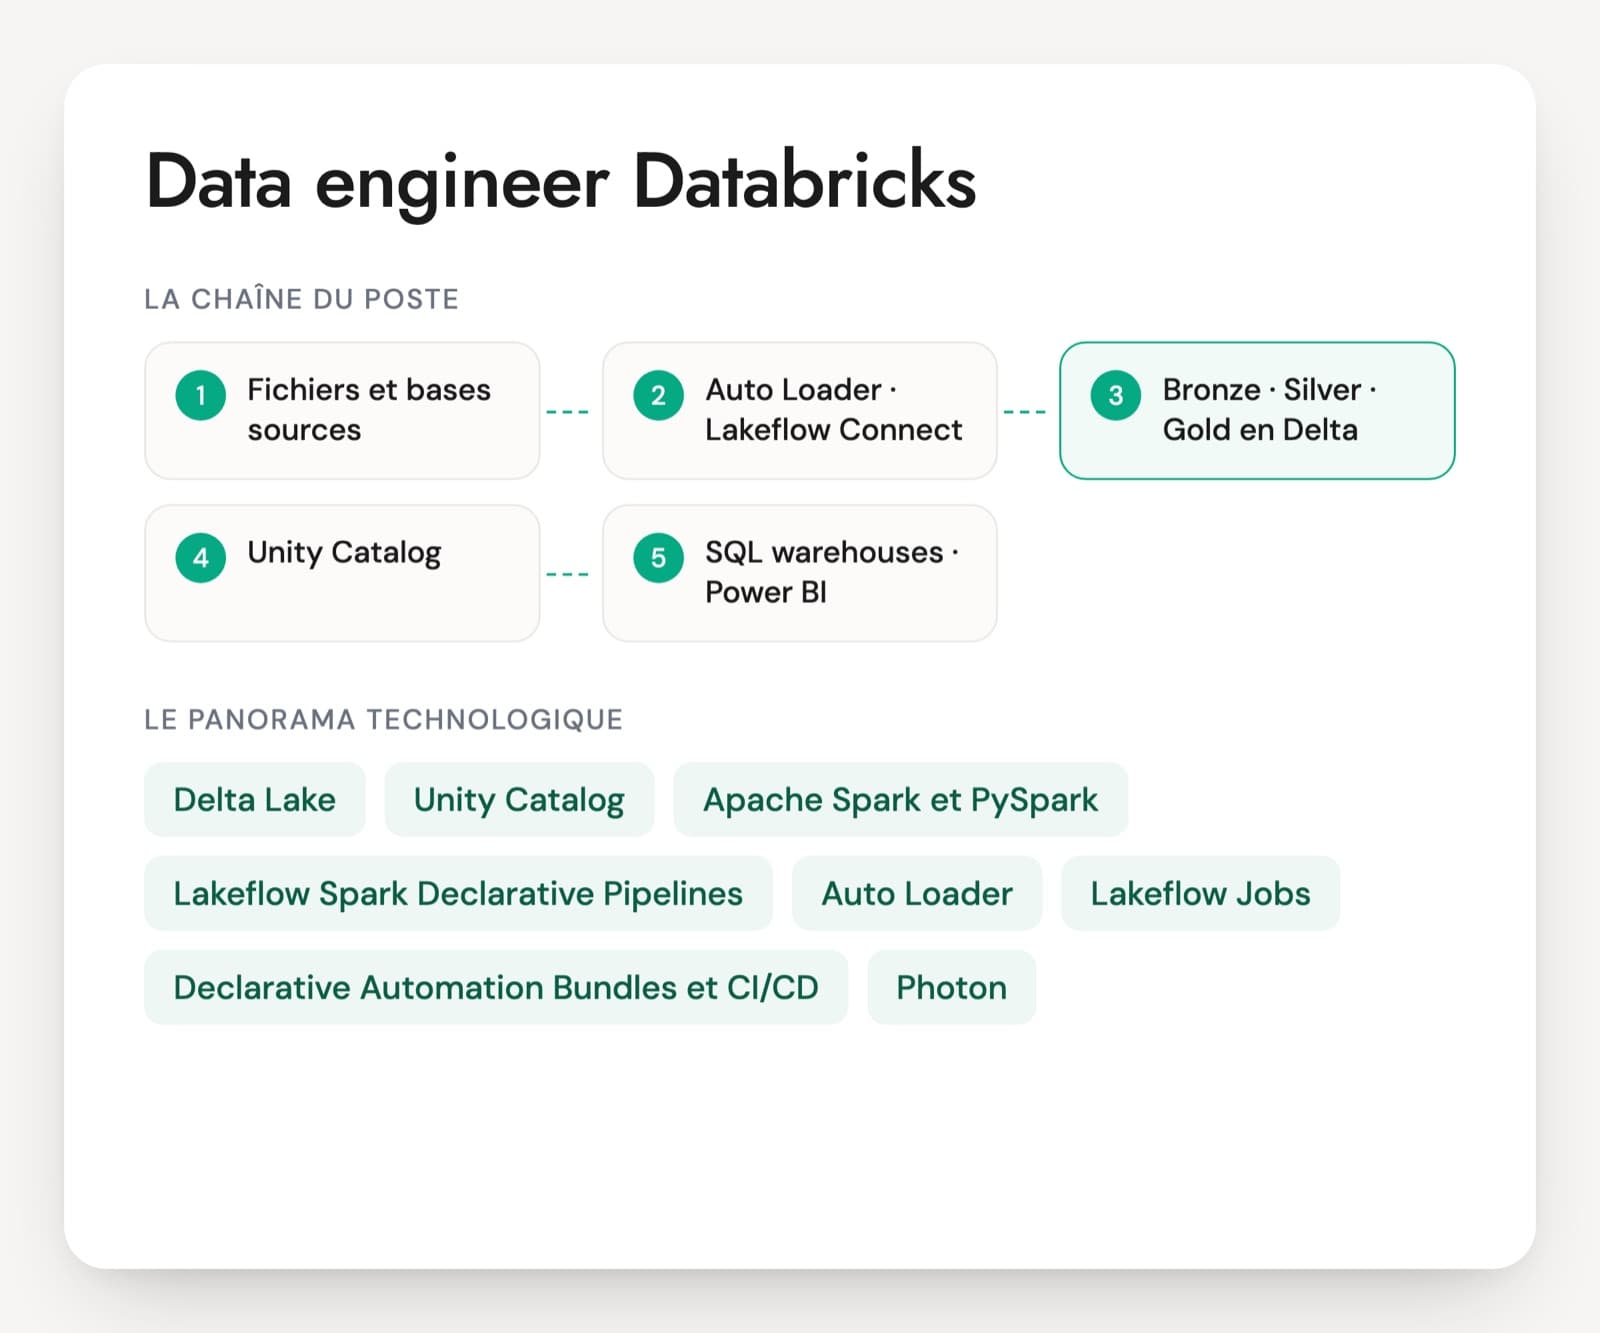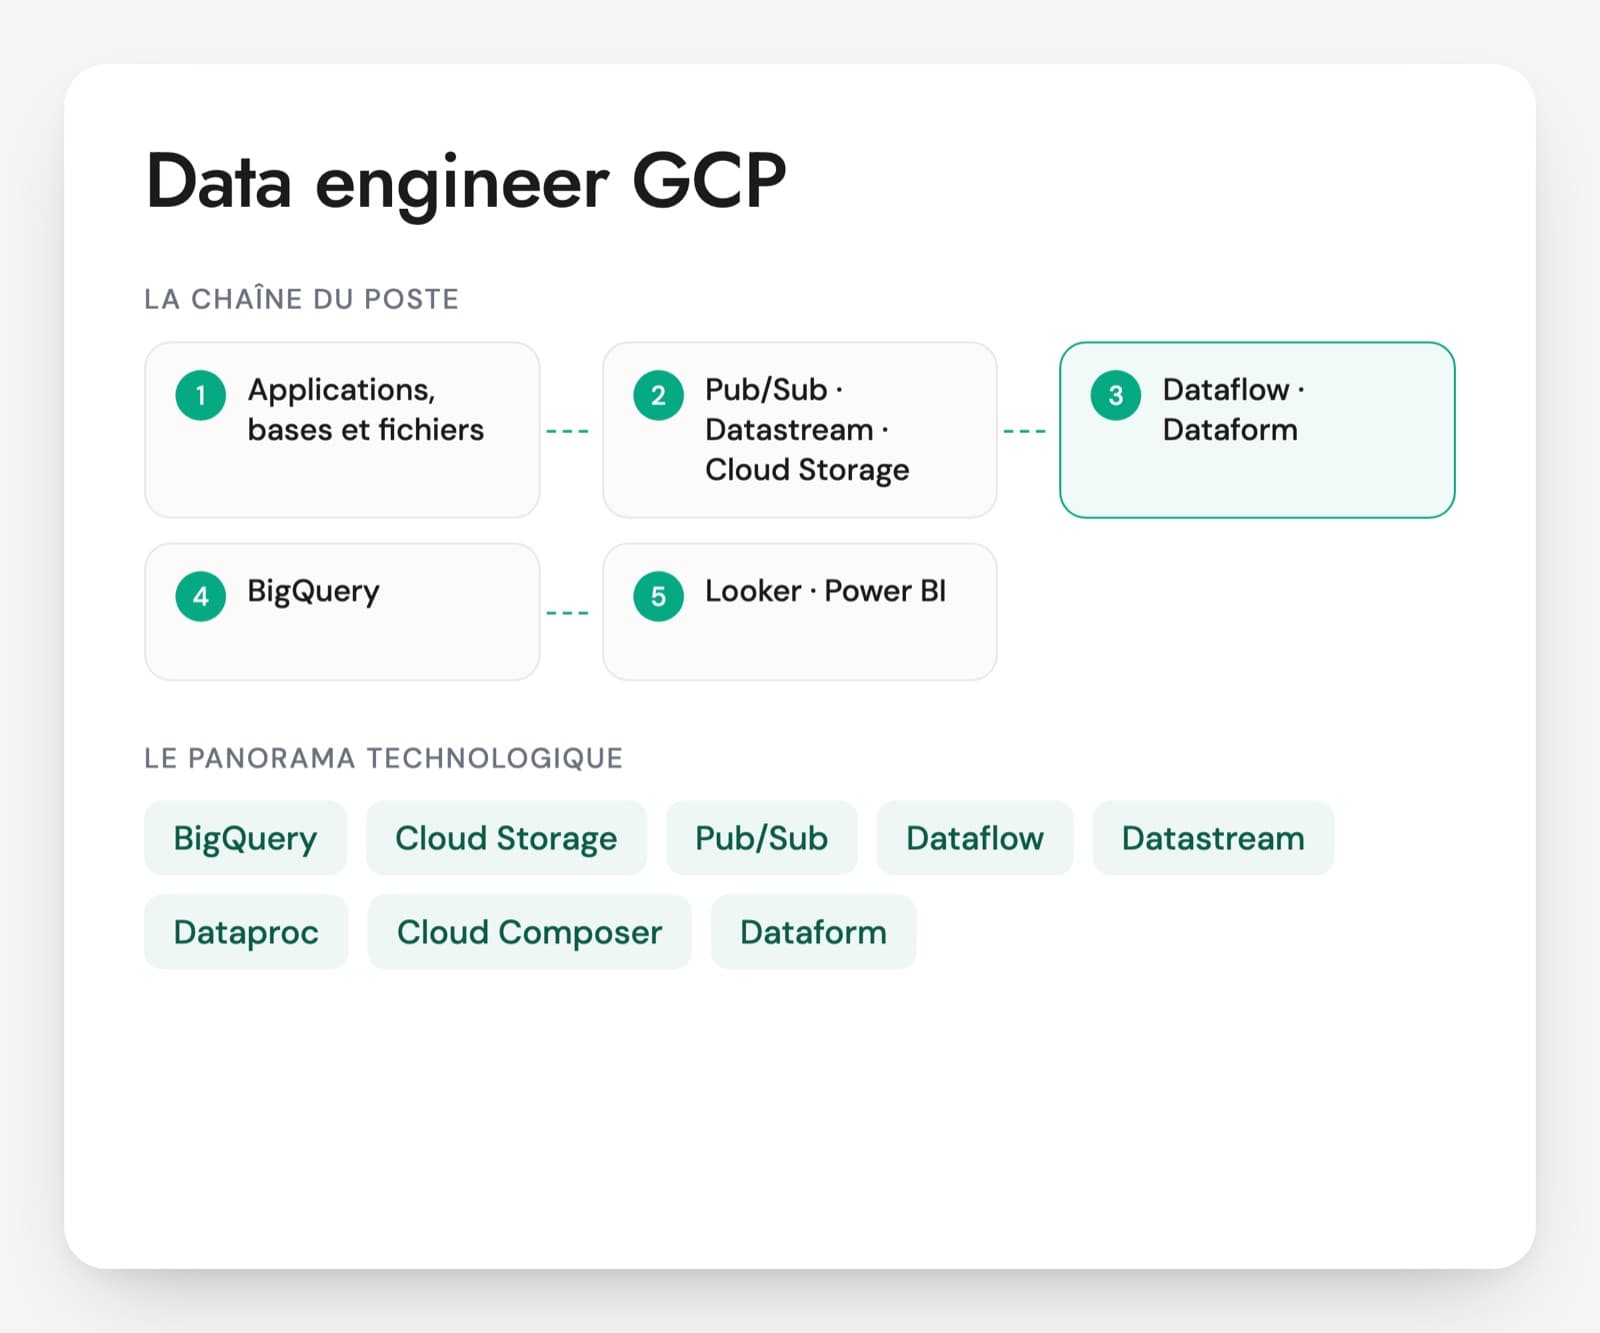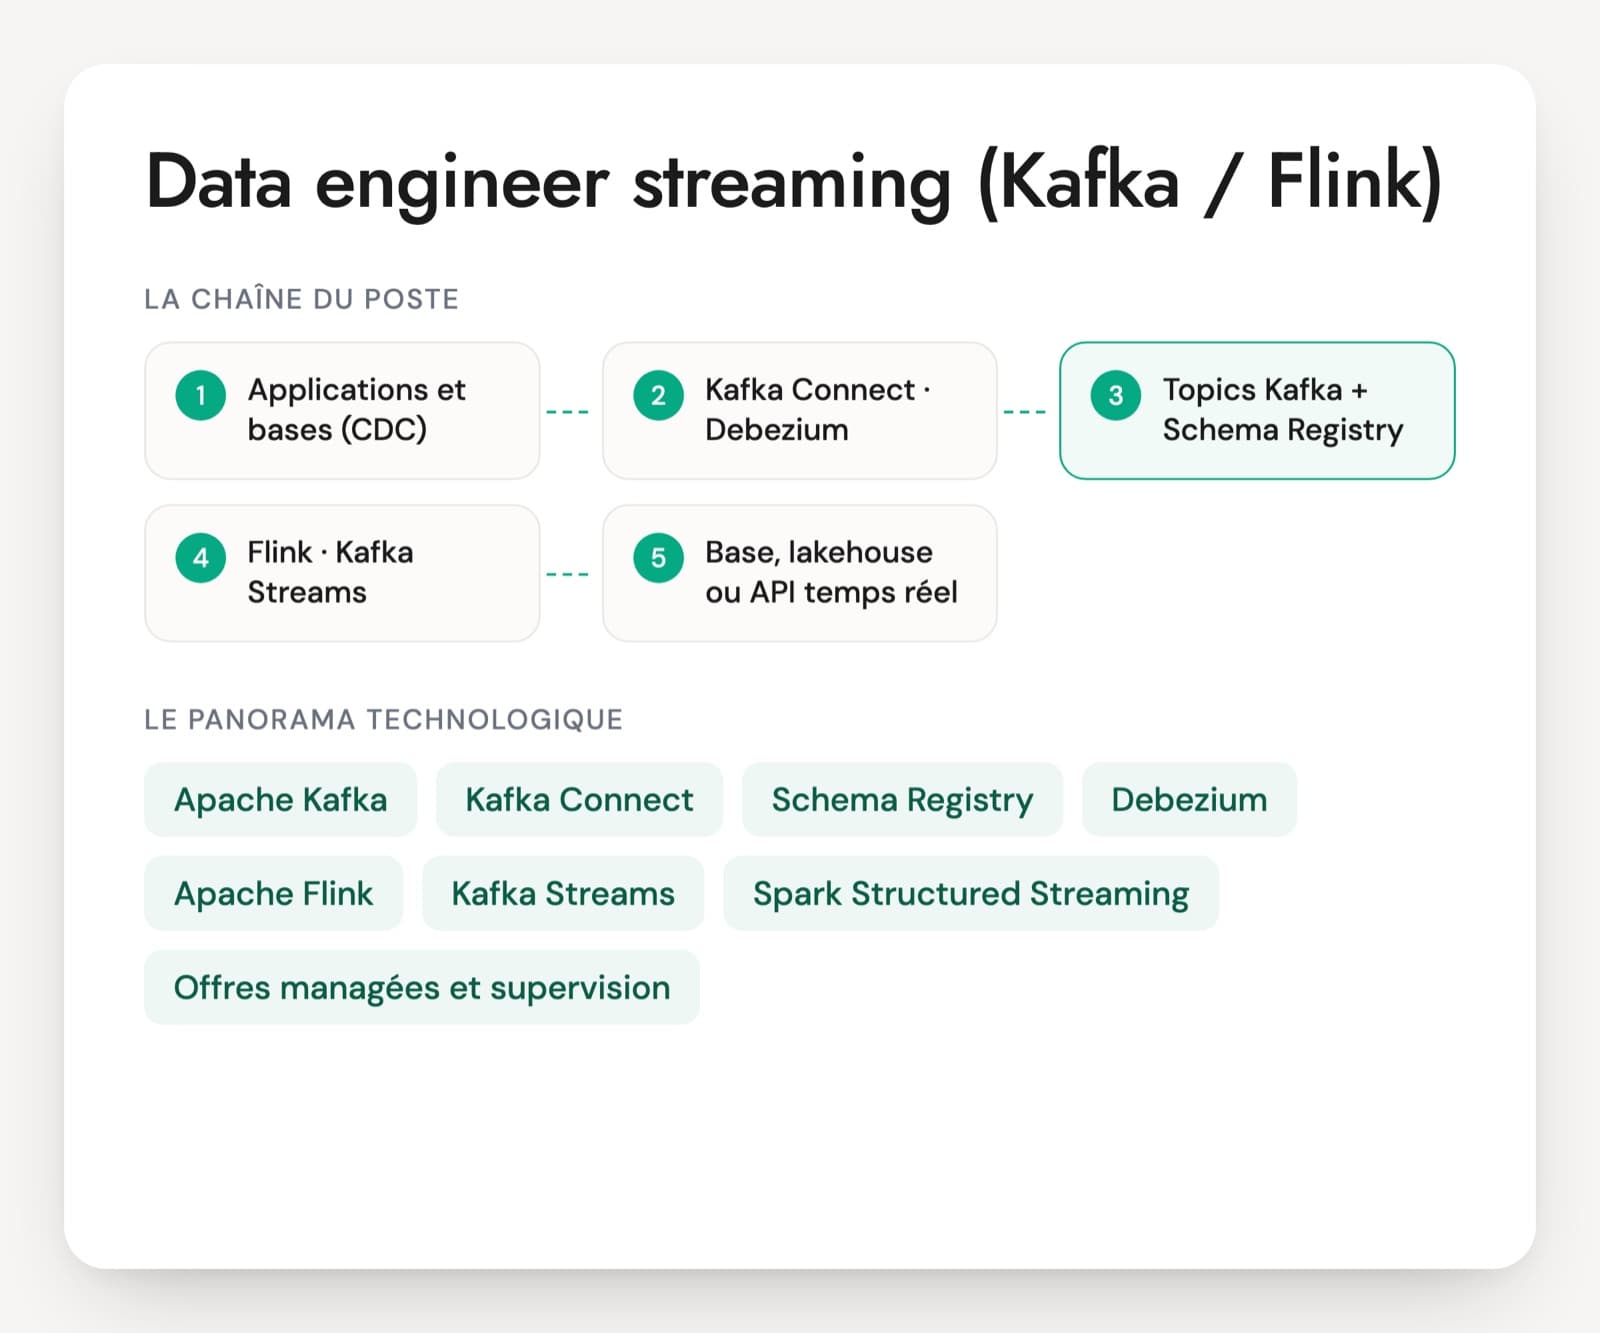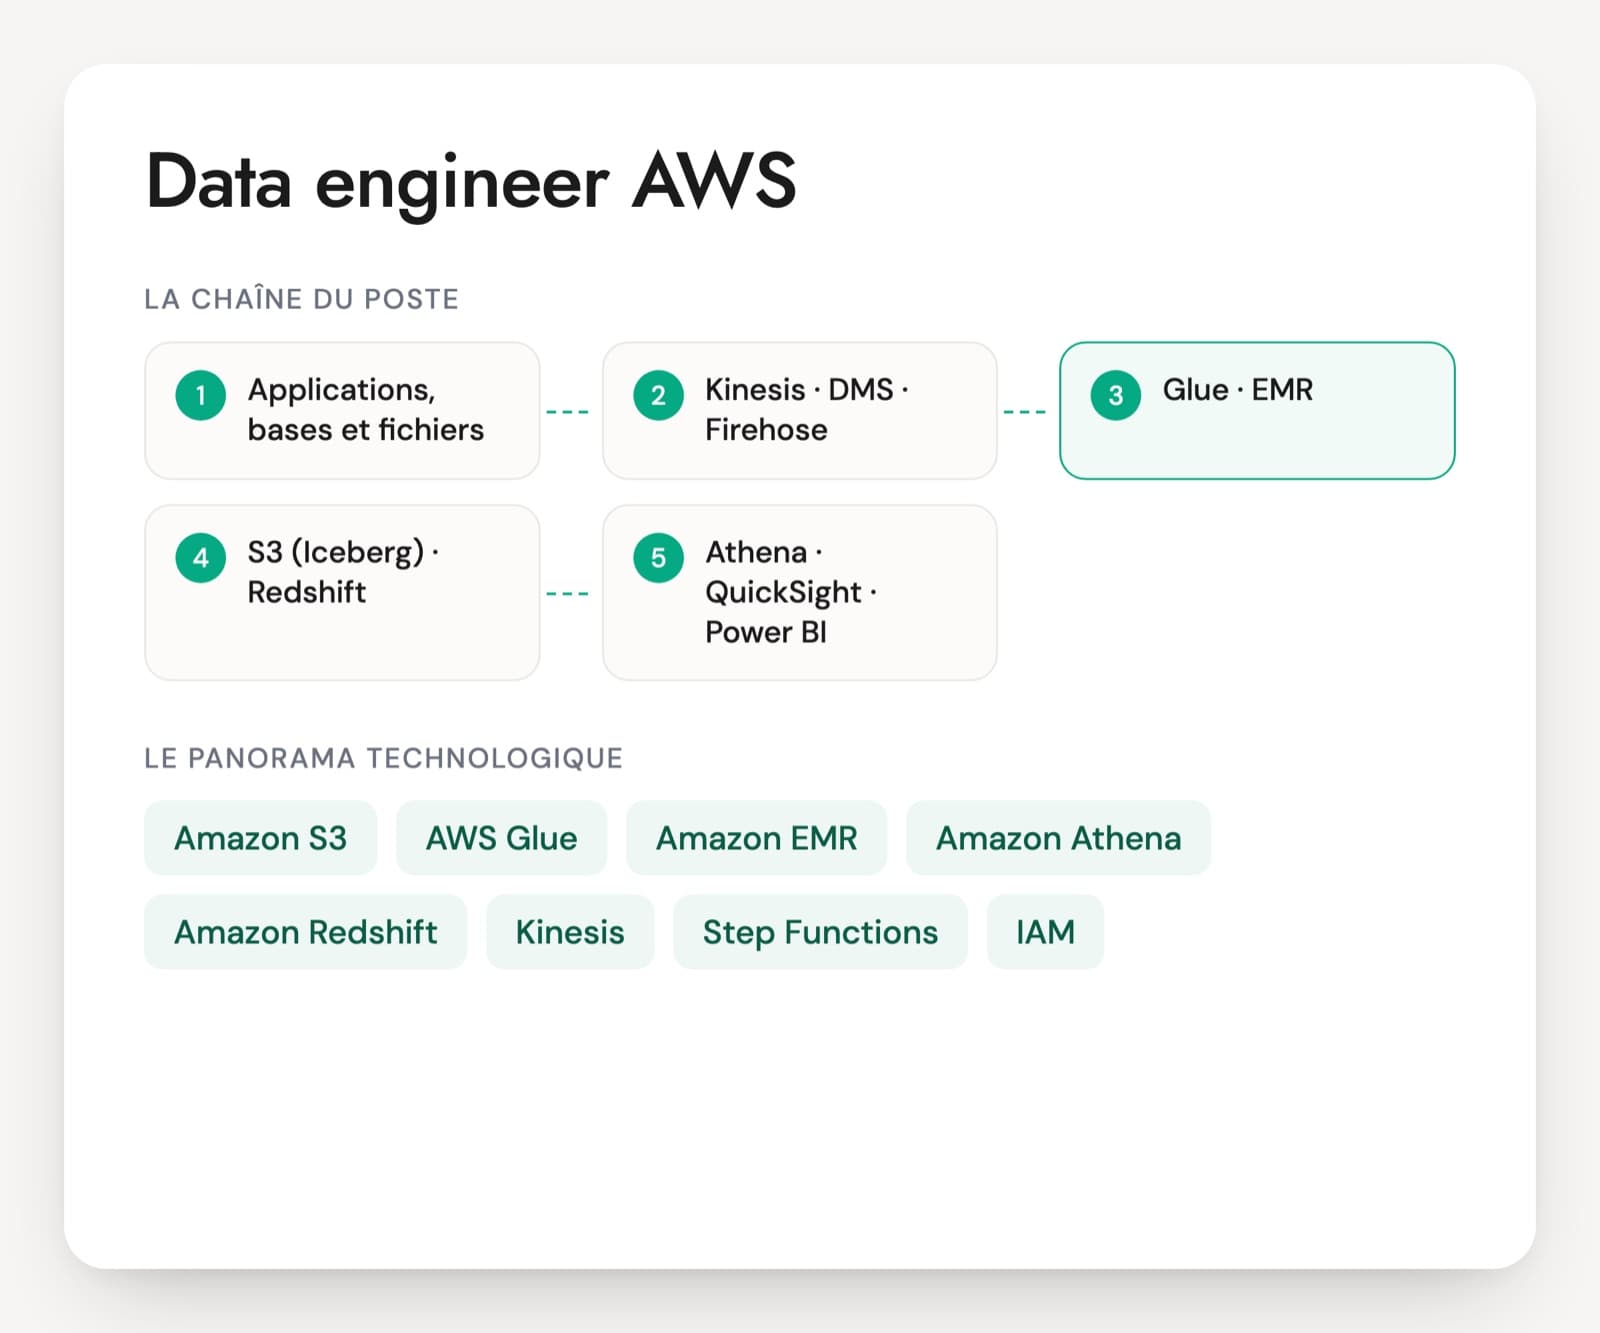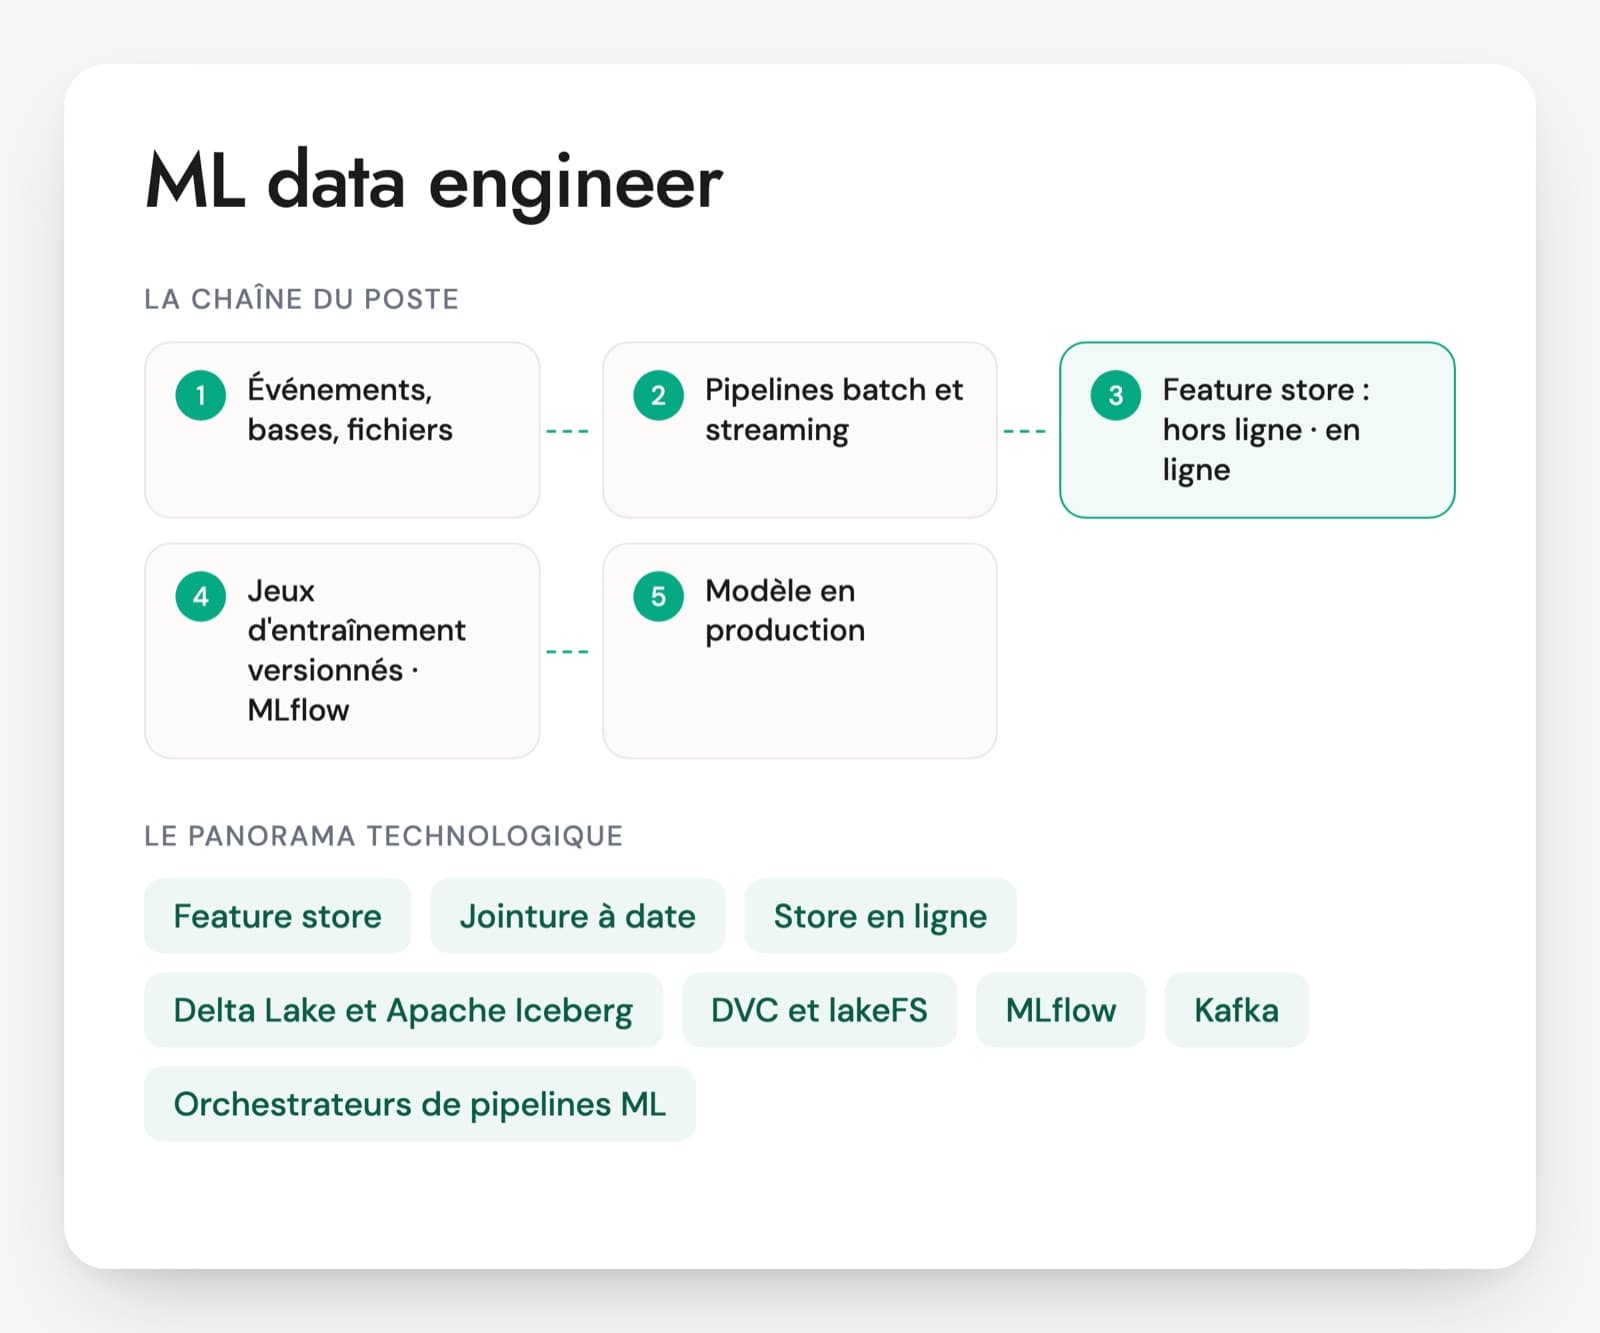
Un ML data engineer prépare les données dont les modèles ont besoin, à l'entraînement comme en production. Il construit les tables de features, les jeux d'entraînement reproductibles et les flux qui alimentent un modèle en ligne. Ces questions d'entretien s'adressent aux scale-ups qui mettent des modèles en production, aux équipes data de grands comptes qui structurent leur plateforme ML et aux ESN qui placent ces profils en mission.
Le risque principal tient à un réflexe venu de la BI. Un data engineer habitué aux tableaux de bord joint les tables dans leur état actuel, ce qui convient à un reporting et fausse un modèle. Le jeu d'entraînement contient alors des informations que le modèle n'aura jamais au moment de prédire. Il faut aussi vérifier que la même feature est calculée de la même façon hors ligne et en ligne, et qu'un jeu d'entraînement peut être reconstruit des mois plus tard.
Pour construire l'entretien complet, le PDF reprend ces questions et en ajoute d'autres, 30 au total sur six axes, avec un cas de 20 minutes sur un modèle d'attrition et une grille de 1 à 4 par axe.
L'outillage d'un data engineer machine learning, expliqué simplement
Feature store
Un catalogue de features, ces variables calculées que lit un modèle (nombre d'achats sur 30 jours, ancienneté du client). Il garde l'historique pour l'entraînement et la dernière valeur pour le scoring. Les plus cités sont Feast en open source, Feature Engineering dans Unity Catalog chez Databricks, qui a repris Tecton en 2025, Vertex AI Feature Store et SageMaker Feature Store.
Jointure à date (point-in-time)
La technique qui associe à chaque exemple d'entraînement la valeur d'une feature telle qu'elle était connue à ce moment, et pas aujourd'hui. Une erreur ici donne un modèle brillant en test et décevant en production. C'est le sujet qui sépare le mieux les candidats.
Store en ligne
Une base clé-valeur très rapide (Redis, DynamoDB, Bigtable, Cassandra) qui renvoie en quelques millisecondes les features d'un client au moment du scoring. Le data engineer l'alimente et surveille la fraîcheur des valeurs qu'elle contient.
Delta Lake et Apache Iceberg
Des formats de tables qui gardent l'historique des versions. On peut relire une table telle qu'elle était à une date passée, ce qui aide à reconstruire un jeu d'entraînement. Cet historique est limité par la rétention configurée, un point à vérifier en entretien.
DVC et lakeFS
Des outils de versioning de données. DVC suit des fichiers et des jeux de données à côté du code dans Git, lakeFS applique des branches et des commits à un data lake entier. lakeFS a repris le projet DVC fin 2025, et les deux restent disponibles.
MLflow
L'outil le plus répandu pour suivre les expériences et enregistrer les modèles. Le data engineer y rattache la référence exacte des données utilisées par chaque entraînement, ce qui rend un modèle auditable.
Kafka, Flink et Spark Structured Streaming
Les briques du temps réel. Kafka transporte les événements, Flink ou Spark calculent des agrégats en continu (nombre de transactions sur dix minutes, par exemple) qui partent vers le store en ligne. On les trouve surtout dans la fraude, la publicité et la recommandation.
Orchestrateurs de pipelines ML
Airflow, Dagster, Lakeflow Jobs, Vertex AI Pipelines ou SageMaker Pipelines enchaînent le calcul des features, la construction du jeu, la validation et l'entraînement. Chaque étape doit pouvoir être relancée pour une date passée.
Validation et surveillance des données
Great Expectations, Deequ ou les tests dbt contrôlent chaque table avant usage. Evidently ou des métriques maison comparent les données de production à celles de l'entraînement pour détecter une dérive avant qu'elle ne dégrade le modèle.
Le poste se situe entre le data engineering classique et le MLOps. Dans une scale-up, la même personne monte souvent le feature store, les pipelines d'entraînement et une partie du serving. Dans un grand compte, elle rejoint une plateforme ML existante sur Databricks, Vertex AI ou SageMaker et travaille à côté d'équipes MLOps et data science distinctes. En ESN, les missions consistent souvent à industrialiser des modèles restés au stade du notebook. Les intitulés varient beaucoup : ML data engineer, data engineer IA, feature engineer, parfois ML engineer. Lisez la fiche de poste pour savoir si le serving en ligne fait partie du périmètre, car il change la moitié des questions à poser.
Les aptitudes à faire démontrer par un ML data engineer
- Jointures à date et prévention des fuites
- Feature store hors ligne et en ligne
- Reproductibilité et versioning des jeux d'entraînement
- Features calculées en temps réel
- Validation et détection de dérive des données
- Pipelines d'entraînement orchestrés et rejouables
Cinq questions sur les données d'entraînement et de serving
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Un modèle d'attrition est excellent à l'entraînement puis s'effondre en production. Côté données, que soupçonnez-vous en premier ?
Une bonne réponseUne fuite d'information : des features calculées avec des données postérieures à la date de prédiction. Par exemple une jointure sur la table clients dans son état actuel, un nombre de réclamations qui inclut celles déposées après le départ, un statut mis à jour à la résiliation. La personne vérifie que chaque feature porte une date antérieure à la date du label et reconstruit le jeu avec une jointure à date. Elle cite aussi l'écart entre le calcul d'entraînement et celui de production, et un découpage aléatoire là où il fallait un découpage dans le temps.
Signal d'alerte« Il faut changer d'algorithme » ou « il manque des données », sans jamais regarder la date des features.
Question 2 · confirmé
Décrivez à voix haute la jointure qui associe à chaque ligne d'entraînement la dernière valeur connue d'une feature à cette date.
Une bonne réponseUne jointure à date (point-in-time, ou as-of) : pour chaque couple entité et date du label, on prend les valeurs de la même entité dont la date est inférieure ou égale à celle du label, puis la plus récente, avec un ROW_NUMBER par ligne de label trié par date décroissante, ou un ASOF JOIN là où le moteur le propose (Snowflake, DuckDB). Une durée de validité écarte les valeurs trop anciennes. Feast (get_historical_features) ou les feature tables à clé temporelle de Databricks font ce calcul.
Signal d'alerteUne jointure sur l'identifiant seul qui ramène la dernière valeur connue aujourd'hui, ou une tolérance approximative du type « date du label plus un jour ».
Question 3 · confirmé
La même feature est calculée en batch dans l'entrepôt pour l'entraînement et par l'API au moment du scoring. Comment évitez-vous qu'elles divergent ?
Une bonne réponseUne seule définition pour les deux usages : un feature store qui calcule la feature hors ligne puis la matérialise dans le store en ligne, ou un code partagé exécuté des deux côtés. À défaut, on journalise les valeurs servies en ligne et on entraîne sur ces valeurs. La personne compare régulièrement les distributions en ligne et hors ligne pour détecter l'écart (training-serving skew) et versionne les définitions.
Signal d'alerteDeux implémentations dans deux langages, l'une réécrite par l'équipe backend « à l'identique », sans contrôle.
Question 4 · confirmé
Six mois plus tard, il faut réentraîner exactement le même modèle pour un audit. Qu'avez-vous conservé côté données ?
Une bonne réponseUne référence figée du jeu d'entraînement : version ou horodatage de la table Delta, snapshot ou tag Iceberg, commit DVC ou lakeFS. S'y ajoutent le commit Git du code de préparation, la version des définitions de features et du label, la graine du découpage, le tout rattaché au run dans l'outil de suivi (MLflow, par exemple). La personne sait que le time travel ne garde l'historique que le temps de la rétention configurée.
Signal d'alerte« On relancera la requête », sur des tables modifiées tous les jours.
Question 5 · senior
Une feature compte les transactions d'un client sur les dix dernières minutes pour un score de fraude en ligne. Comment la calculez-vous et la servez-vous ?
Une bonne réponseUn calcul en continu (Flink, Spark Structured Streaming ou Kafka Streams) sur des fenêtres glissantes en temps de l'événement, avec un watermark pour les retards, qui écrit le résultat par client dans un store en ligne (Redis, DynamoDB, Bigtable). La personne mesure la fraîcheur, prévoit une valeur par défaut si la donnée manque et explique comment le même calcul est rejoué sur l'historique pour l'entraînement.
Signal d'alerteUn job batch toutes les heures, ou une requête sur la base transactionnelle à chaque appel sans penser à la charge.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Où s'arrête le data engineer ML
Data engineer ML, ML engineer, MLOps : où passe la frontière ?
Le data engineer ML fabrique les données : features, jeux d'entraînement, flux vers le store en ligne. Le ML engineer construit et optimise les modèles et leur code de service. Le MLOps s'occupe du déploiement, du registre de modèles et de la surveillance de la plateforme. Dans une petite équipe, une seule personne couvre souvent les trois. Votre fiche de poste doit dire lequel de ces périmètres est prioritaire.
Un data engineer ML doit-il savoir entraîner des modèles ?
Il n'a pas besoin d'en concevoir, mais il doit comprendre comment un modèle consomme ses données : ce qu'est un label, pourquoi on découpe dans le temps, ce qu'est une fuite d'information, comment une feature catégorielle est encodée. Sans ces notions, il livre des jeux techniquement propres et inutilisables. Une question sur une fuite de données, posée tôt dans l'entretien technique, suffit souvent à vérifier ce niveau.
Comment vérifier qu'un candidat sait éviter les fuites de données ?
Un test technique SQL court, fait en direct, fonctionne bien : une table d'événements, une table de labels datés, et la consigne de construire le jeu d'entraînement sans information future. La jointure à date, le choix de la dernière valeur connue et la gestion des valeurs trop anciennes montrent vite le niveau. Faites commenter le raisonnement pendant l'écriture, il compte autant que la requête finale.
Que vaut l'expérience d'un data engineer BI pour ce poste ?
Elle apporte le SQL, la modélisation, l'orchestration et la qualité de données, qui restent le socle. Il lui manque souvent le raisonnement temporel propre au machine learning et l'expérience du serving en ligne. En entretien, posez la question de la jointure à date et celle de la cohérence entre entraînement et production. Un profil BI qui y répond bien peut devenir opérationnel rapidement.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.