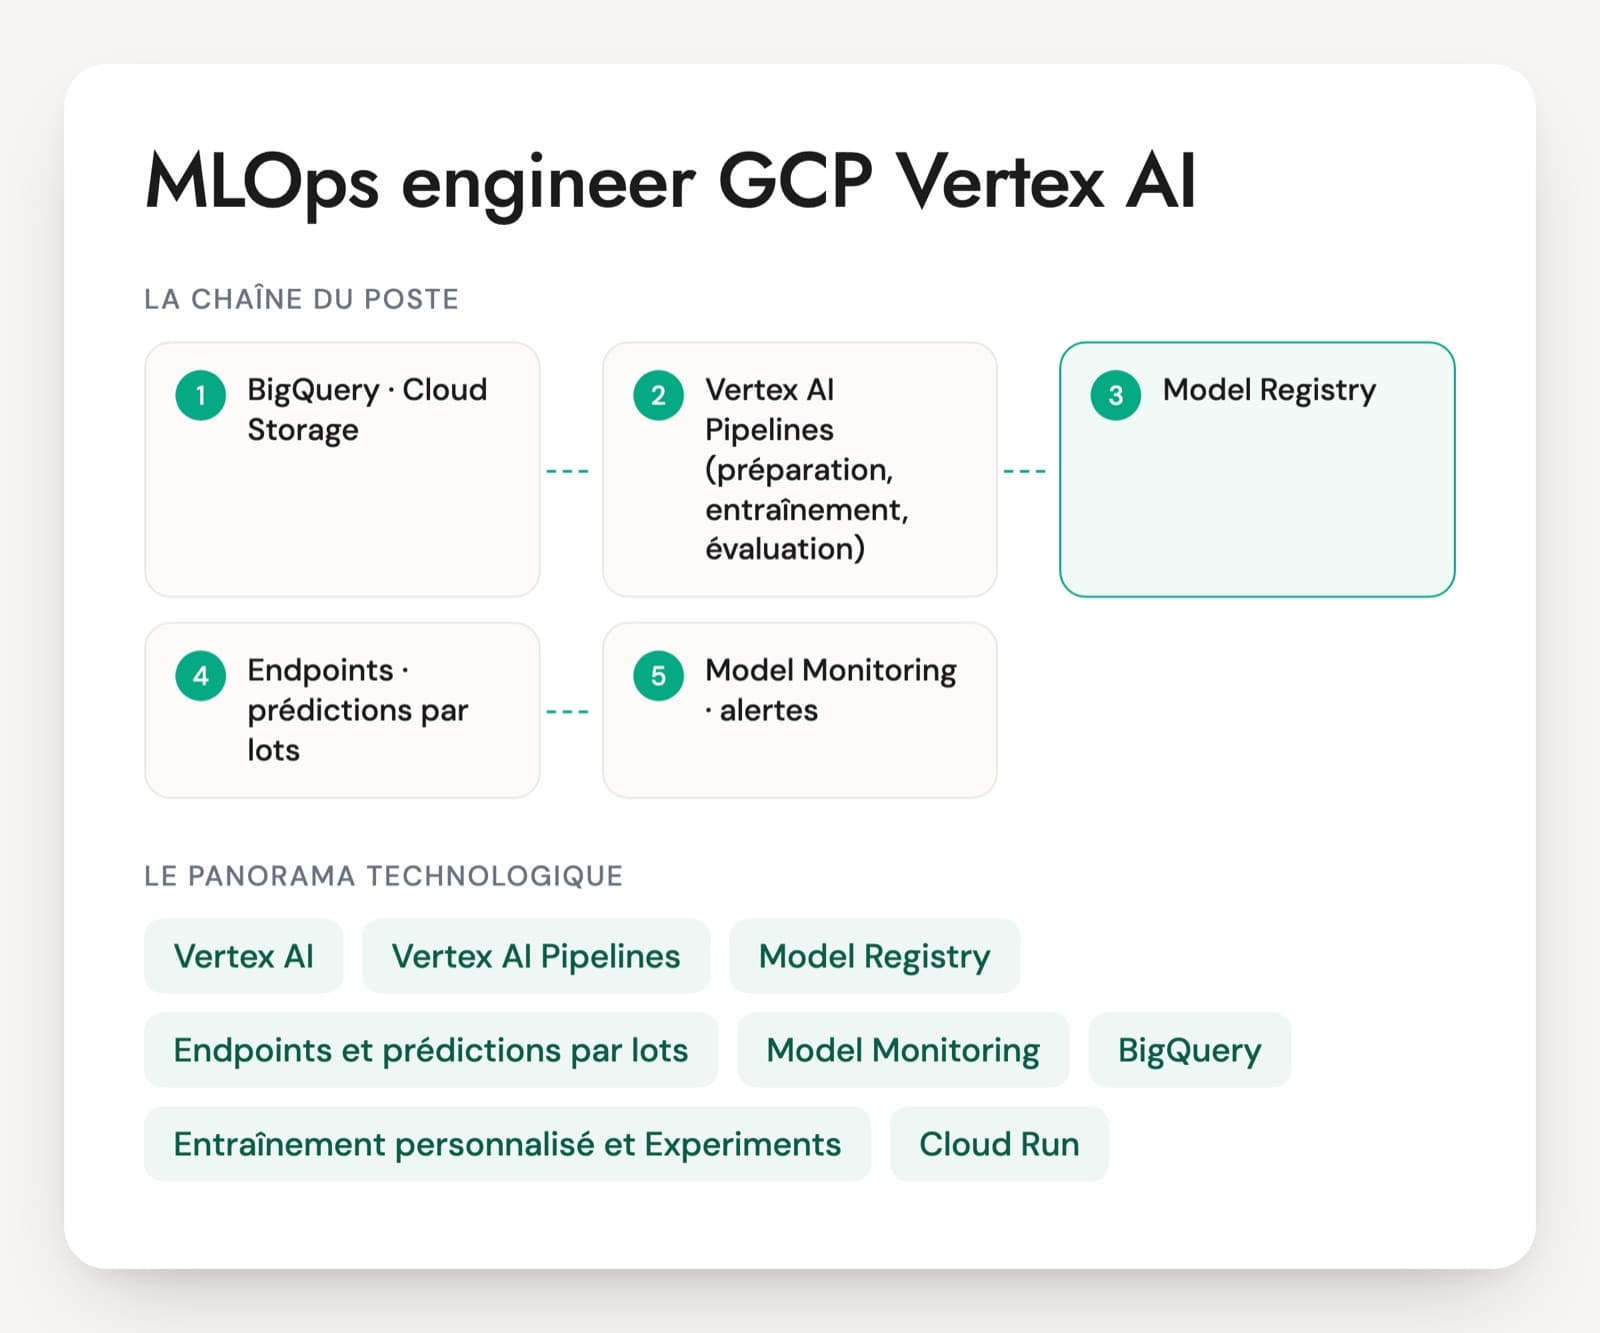
Un MLOps engineer Vertex AI transforme les notebooks des data scientists en chaînes automatiques : pipelines d'entraînement, registre de modèles, endpoints de prédiction, prédictions par lots et surveillance de la dérive. Les données viennent presque toujours de BigQuery. Dans une ESN, la mission démarre souvent sur un projet pilote à industrialiser chez le client. Chez un client final, la personne tient la plateforme et ses coûts dans la durée.
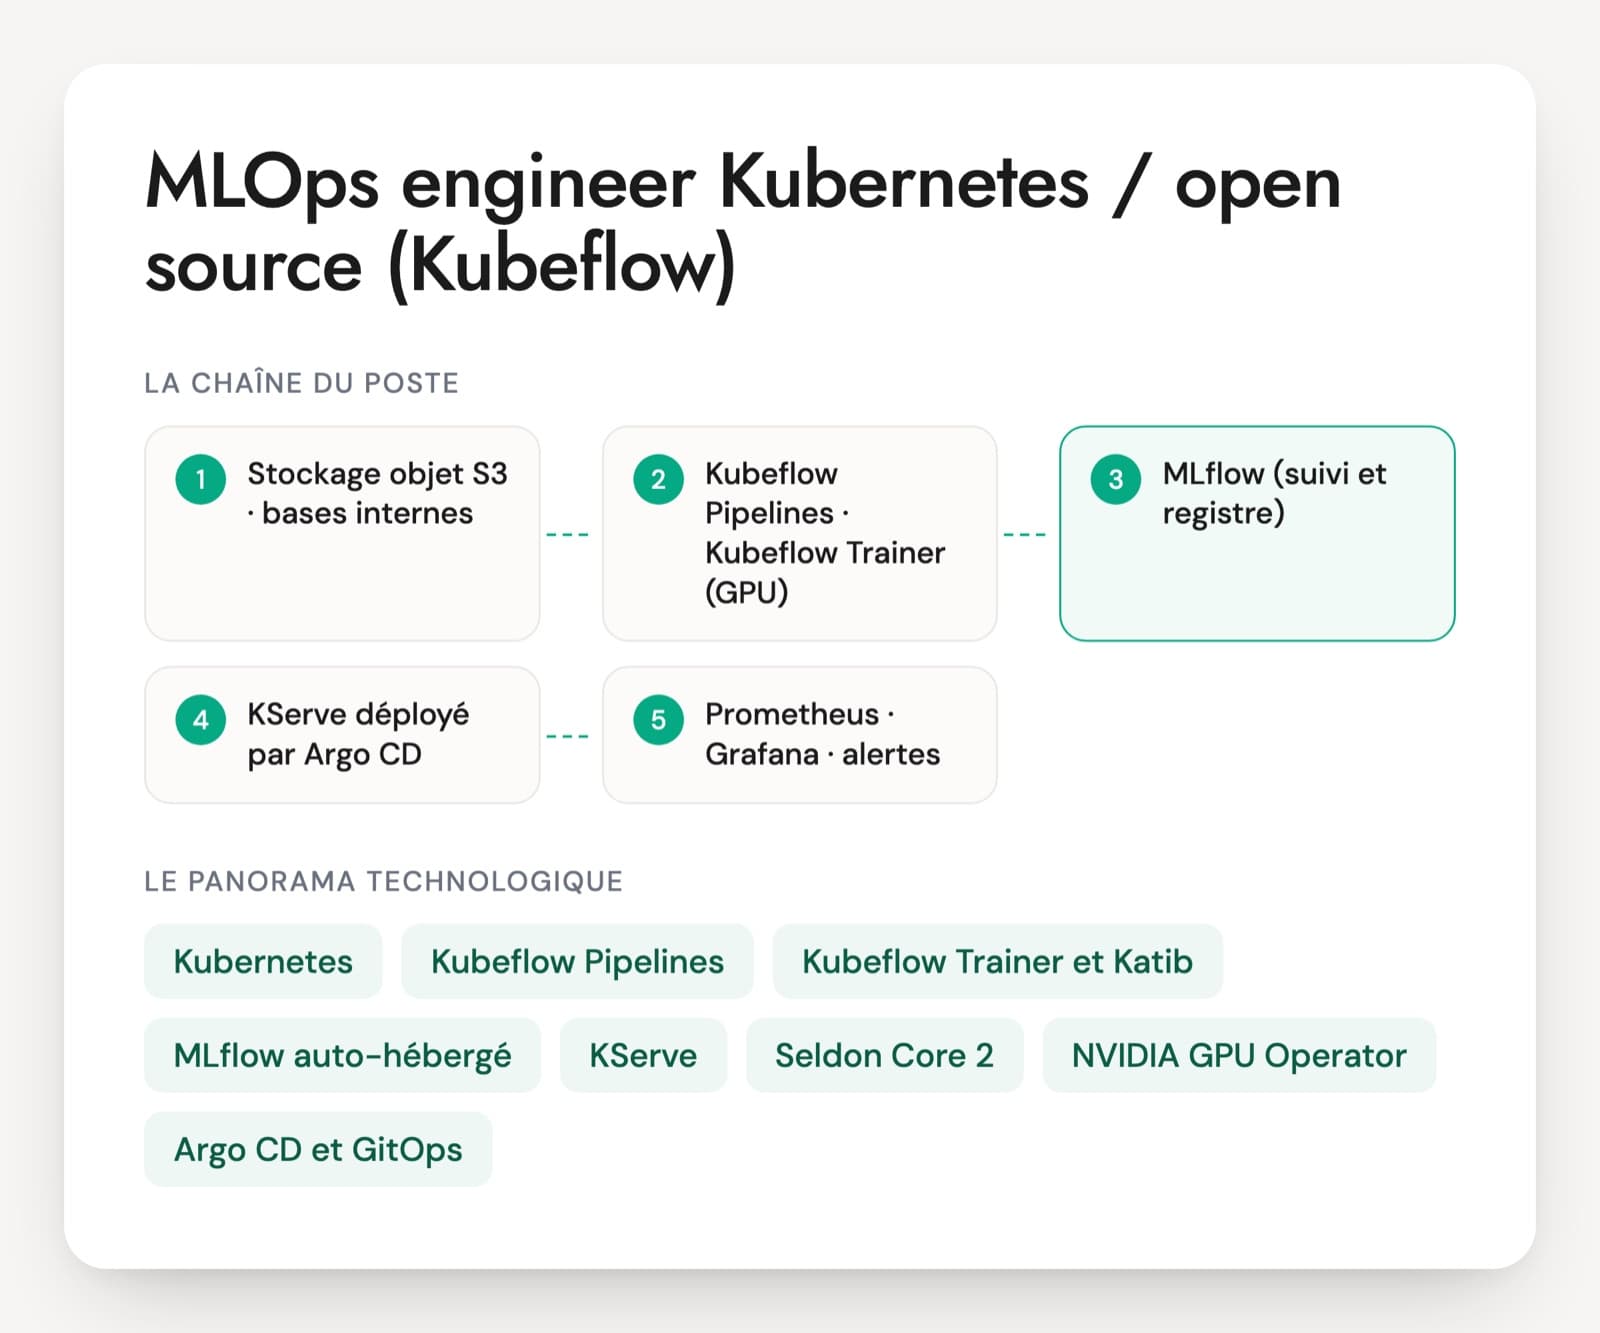
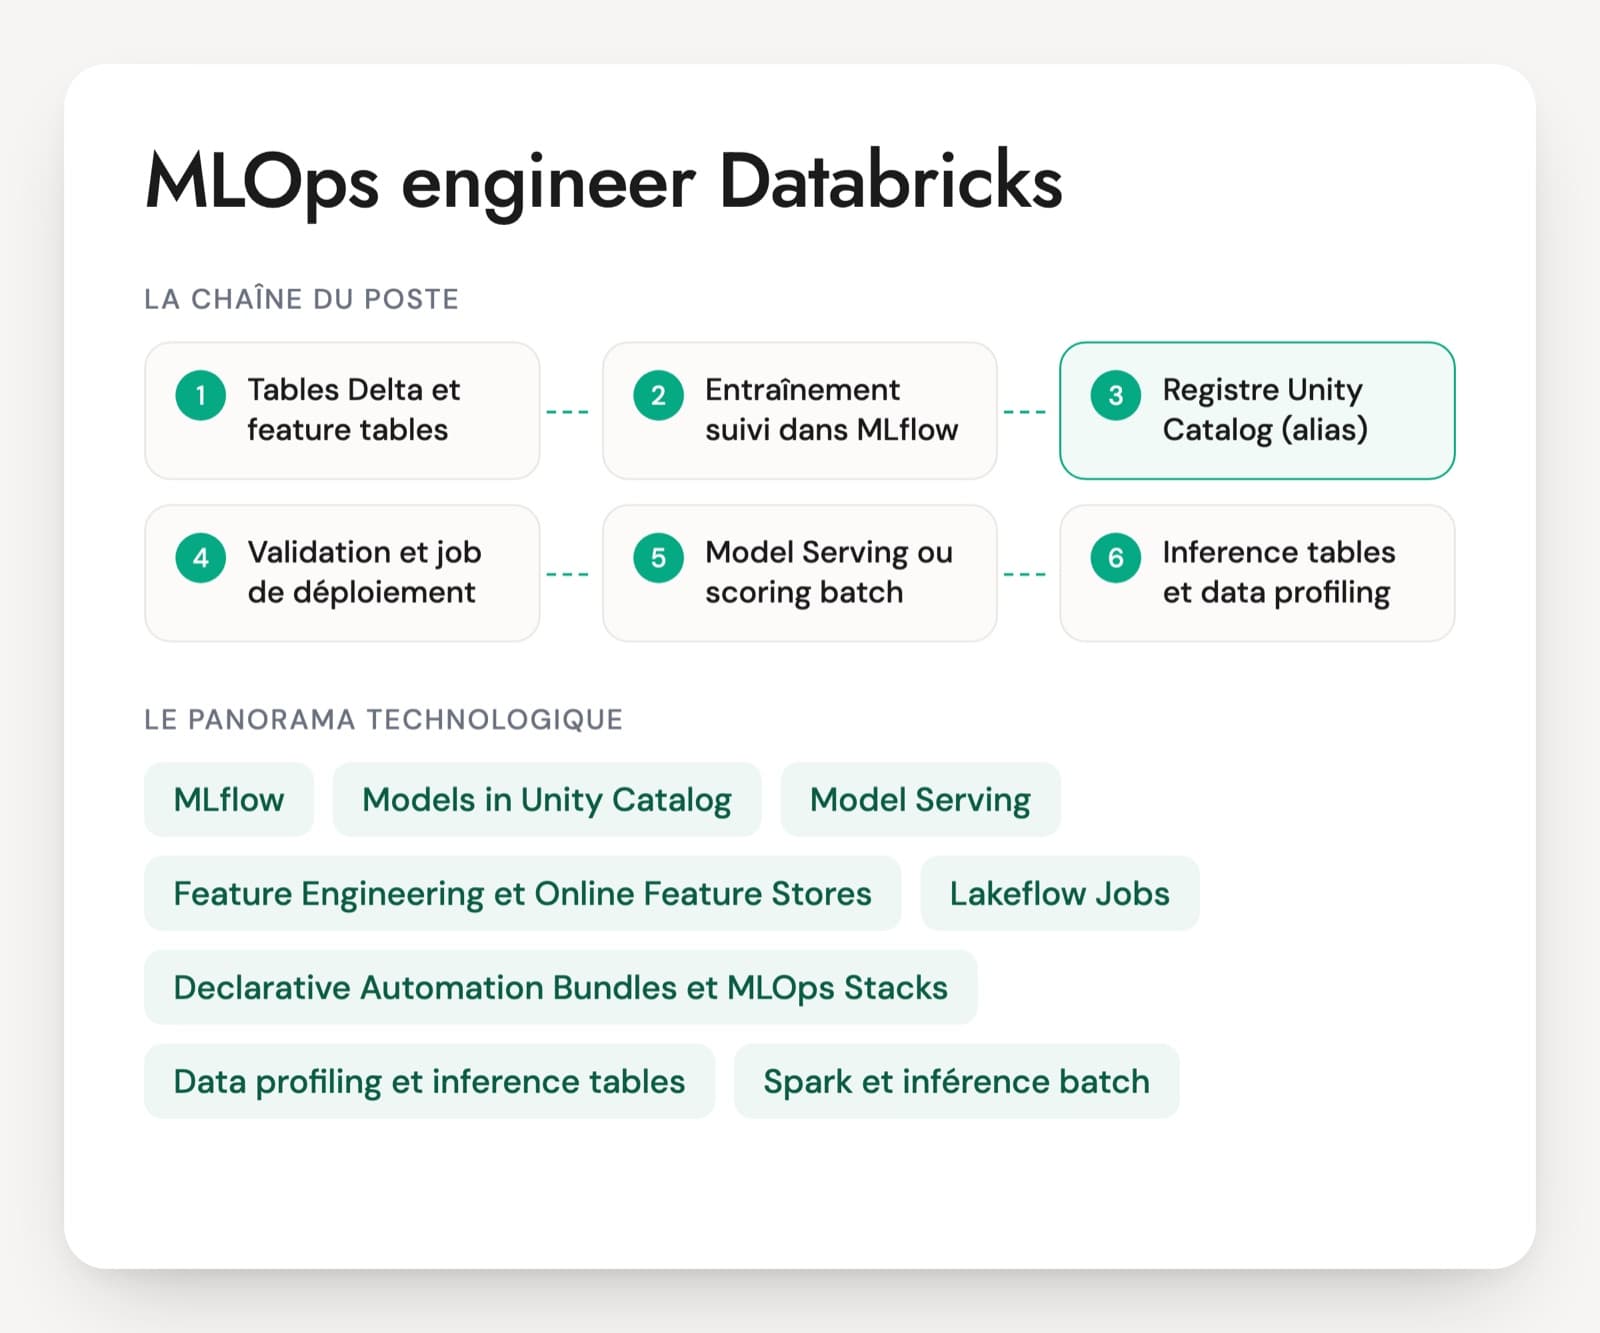
Les CV citent Vertex AI, Kubeflow Pipelines et MLflow à peu près dans les mêmes termes. L'écart se voit sur des sujets précis : le cache d'un pipeline qui ressert des données périmées, une version de modèle promue d'un projet à l'autre, un partage de trafic absent sur certains types d'endpoint, une alerte de dérive mal réglée. Autre détail utile au tri : la documentation Google présente désormais Vertex AI sous le nom Gemini Enterprise Agent Platform, alors que les offres disent encore Vertex AI.
Un pipeline Vertex AI mis en production avec son déclenchement suffit pour un junior. Avec un senior, la discussion porte sur le passage des modèles du projet de développement à la production, et sur qui valide la promotion.
Vertex AI côté MLOps : ce que la personne fait tourner
Vertex AI (Gemini Enterprise Agent Platform)
La plateforme de machine learning de Google Cloud, qui regroupe l'entraînement, les pipelines, le registre, le service des modèles et leur surveillance. Google l'a rebaptisée Gemini Enterprise Agent Platform en avril 2026, et les services suivent : Gemini Enterprise Agent Platform Pipelines, Model Registry on Gemini Enterprise Agent Platform. Pourtant les offres d'emploi et les CV parlent encore de Vertex AI. Les deux noms désignent les mêmes services.
Vertex AI Pipelines
Le service qui exécute les pipelines d'entraînement sans cluster à gérer. Les pipelines s'écrivent avec le SDK Kubeflow Pipelines, plus rarement avec TFX. Chaque étape tourne dans un conteneur, les résultats intermédiaires sont gardés, et le lineage de chaque run est conservé dans ML Metadata. C'est le cœur du poste.
Model Registry
Le registre des modèles et de leurs versions. On y retrouve la provenance d'une version, ses métriques et les endpoints où elle est déployée. Les modèles BigQuery ML et ceux entraînés ailleurs peuvent aussi y être enregistrés. Demandez comment la personne fait passer une version du développement à la production.
Endpoints et prédictions par lots
Un endpoint sert un modèle en ligne, avec un partage de trafic entre plusieurs versions. Google recommande les endpoints dédiés, publics ou privés via Private Service Connect, qui acceptent des requêtes plus lourdes et plus longues que l'endpoint public partagé. Pour scorer une table entière, un job de prédiction par lots évite de garder des machines allumées en permanence.
Model Monitoring
La surveillance des modèles en production. La version 1, disponible pour tous, compare les données reçues par un endpoint aux données d'entraînement et à leur propre historique. La version 2, encore en preview, ajoute la dérive des prédictions, l'attribution des features et les modèles servis hors de la plateforme.
BigQuery, BigQuery ML et Feature Store
BigQuery fournit les données d'entraînement et peut entraîner lui-même des modèles classiques en SQL avec BigQuery ML. Le Feature Store actuel garde les features dans des tables BigQuery et les sert en ligne, de préférence avec Bigtable. Le mode de service en ligne dit optimisé est déprécié, avec un arrêt annoncé le 17 février 2027.
Entraînement personnalisé et Experiments
Les jobs d'entraînement lancent le code de l'équipe dans une image Docker, sur des CPU ou des GPU choisis au lancement. Experiments garde les paramètres et les métriques de chaque essai pour les comparer. Un bon profil sait expliquer comment il rend un entraînement reproductible.
Cloud Run, GKE et Artifact Registry
Artifact Registry stocke les images et les modèles de pipeline compilés. Cloud Run sert parfois de petits modèles ou une API qui appelle l'endpoint, avec une mise à l'échelle jusqu'à zéro. GKE prend le relais quand l'équipe veut un serveur d'inférence précis ou un contrôle fin des GPU.
IAM, réseau et coûts
Chaque pipeline tourne sous un compte de service aux droits limités. Les endpoints privés, les VPC Service Controls et la localisation européenne des données répondent aux exigences de sécurité. L'export de la facturation dans BigQuery et les étiquettes posées sur les jobs permettent de savoir ce que coûte chaque modèle.
Le poste change selon la maturité de l'équipe data. Dans une scale-up, le MLOps engineer GCP pose souvent les premiers pipelines et la CI des modèles. Dans un grand compte, il hérite de projets pilotes à industrialiser et d'exigences de sécurité fortes : projets séparés par environnement, endpoints privés, données en Europe. En ESN, il passe d'un client à l'autre et doit lire vite un existant. Les offres françaises demandent presque toujours Python, Docker, Terraform et une CI GitLab ou GitHub en plus des services Vertex AI. La certification Google Professional Machine Learning Engineer, valable deux ans, couvre ces services ; l'expérience de production se vérifie en entretien.
Les points techniques à valider chez un MLOps engineer GCP
- Pipelines Vertex AI et Kubeflow Pipelines
- Registre de modèles et promotion entre projets
- Endpoints, partage de trafic et prédictions par lots
- Monitoring de dérive et réentraînement
- Données d'entraînement : BigQuery, BigQuery ML, features
- CI/CD, sécurité et coûts sur GCP
Questions d'entretien MLOps sur Vertex AI, du pipeline à la dérive
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Votre pipeline Vertex AI de réentraînement tourne deux heures, alors que seule l'étape d'évaluation a changé. Comment évitez-vous de tout relancer ?
Une bonne réponseAvec le cache d'exécution des pipelines : une étape dont le composant et les entrées n'ont pas bougé reprend le résultat du run précédent. Pour que cela marche, chaque étape reçoit ses données en artefacts ou en paramètres explicites et le code est figé dans une image versionnée. La personne cite aussi le revers : il faut couper le cache sur une étape qui lit des données fraîches, sinon elle ressert le résultat d'hier.
Signal d'alerte« On relance tout, c'est plus sûr », ou un pipeline écrit comme un seul gros script. Autre alerte : une personne qui active le cache partout sans voir qu'il peut servir des données périmées.
Question 2 · confirmé
Un modèle validé dans le projet GCP de développement doit partir en production dans un autre projet. Comment le faites-vous passer sans le réentraîner ni perdre sa traçabilité ?
Une bonne réponseLa version du modèle est enregistrée dans Model Registry avec ses métadonnées : run de pipeline d'origine, données utilisées, métriques d'évaluation. Elle est copiée vers le registre du projet de production, ou rangée dans un projet de registre commun que les autres lisent. L'image de service est désignée par son digest, et c'est la CI qui fait la promotion après approbation. Le lien entre la version servie et le run qui l'a produite ne se perd jamais.
Signal d'alerteUn réentraînement en production « pour être sûr », sans lien avec la version validée. Ou un fichier .pkl téléchargé sur un poste puis rechargé à la main dans la console.
Question 3 · confirmé
Une nouvelle version d'un modèle de scoring doit remplacer l'ancienne sur un endpoint Vertex AI. Comment limitez-vous le risque ?
Une bonne réponseLa nouvelle version est déployée sur le même endpoint, à côté de l'ancienne, avec un partage de trafic : une petite part d'abord, puis davantage si la latence, le taux d'erreur et la distribution des scores restent normaux. Le retour arrière consiste à remettre tout le trafic sur l'ancienne version. Un nombre minimal de répliques évite les démarrages à froid pendant la bascule.
Signal d'alerteRetirer l'ancien modèle puis déployer le nouveau, avec une coupure entre les deux. Ou créer un endpoint par version et changer l'URL dans l'application à chaque mise en production.
Question 4 · confirmé
Trois mois après la mise en production, le métier signale que le modèle se trompe plus souvent. Qu'auriez-vous dû surveiller, et que faites-vous maintenant ?
Une bonne réponseIl distingue deux causes. L'écart entre entraînement et production (training-serving skew) vient souvent d'une feature calculée autrement en ligne. La dérive, elle, vient d'une population qui change. Côté outils : Model Monitoring sur les entrées et les sorties, la journalisation des requêtes et réponses de l'endpoint dans BigQuery, puis la performance réelle dès que les vraies étiquettes arrivent. Il cherche ensuite la feature qui a bougé, écarte un bug de pipeline en amont et ne réentraîne que si la dérive est réelle.
Signal d'alerte« On réentraîne toutes les semaines, le problème est réglé », sans chercher la cause. Ou une surveillance limitée au CPU et à la latence de l'endpoint.
Question 5 · confirmé
Un data scientist propose de faire le modèle dans BigQuery ML. Quand est-ce un bon choix, et comment le raccordez-vous au reste de la chaîne ?
Une bonne réponseQuand les données sont déjà dans BigQuery et qu'un modèle classique suffit : régression logistique, arbres boostés, k-means, séries temporelles. L'entraînement et l'inférence s'écrivent en SQL, sans sortir les données. Il connaît les limites (architectures sur mesure, deep learning poussé) et l'intégration : l'entraînement devient une étape du pipeline, et le modèle peut être enregistré dans Model Registry pour être versionné ou déployé sur un endpoint.
Signal d'alerteUn refus de principe (« ce n'est pas du vrai ML »), ou un export CSV de toute la table pour entraîner le même modèle dans un notebook.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
MLOps sur Google Cloud : réponses courtes aux questions de recrutement
Sur quelles compétences juger un MLOps engineer Vertex AI ?
Sur sa capacité à écrire et maintenir des pipelines avec le SDK Kubeflow Pipelines, à versionner et promouvoir des modèles dans Model Registry, à déployer sur des endpoints avec partage de trafic et à surveiller la dérive. Ajoutez BigQuery, Docker, Terraform, une CI et les droits IAM. Ne vous étonnez pas de lire Agent Platform sur un CV récent : c'est le nouveau nom de Vertex AI dans la documentation Google.
Un profil MLOps formé sur SageMaker ou Azure ML peut-il prendre ce poste ?
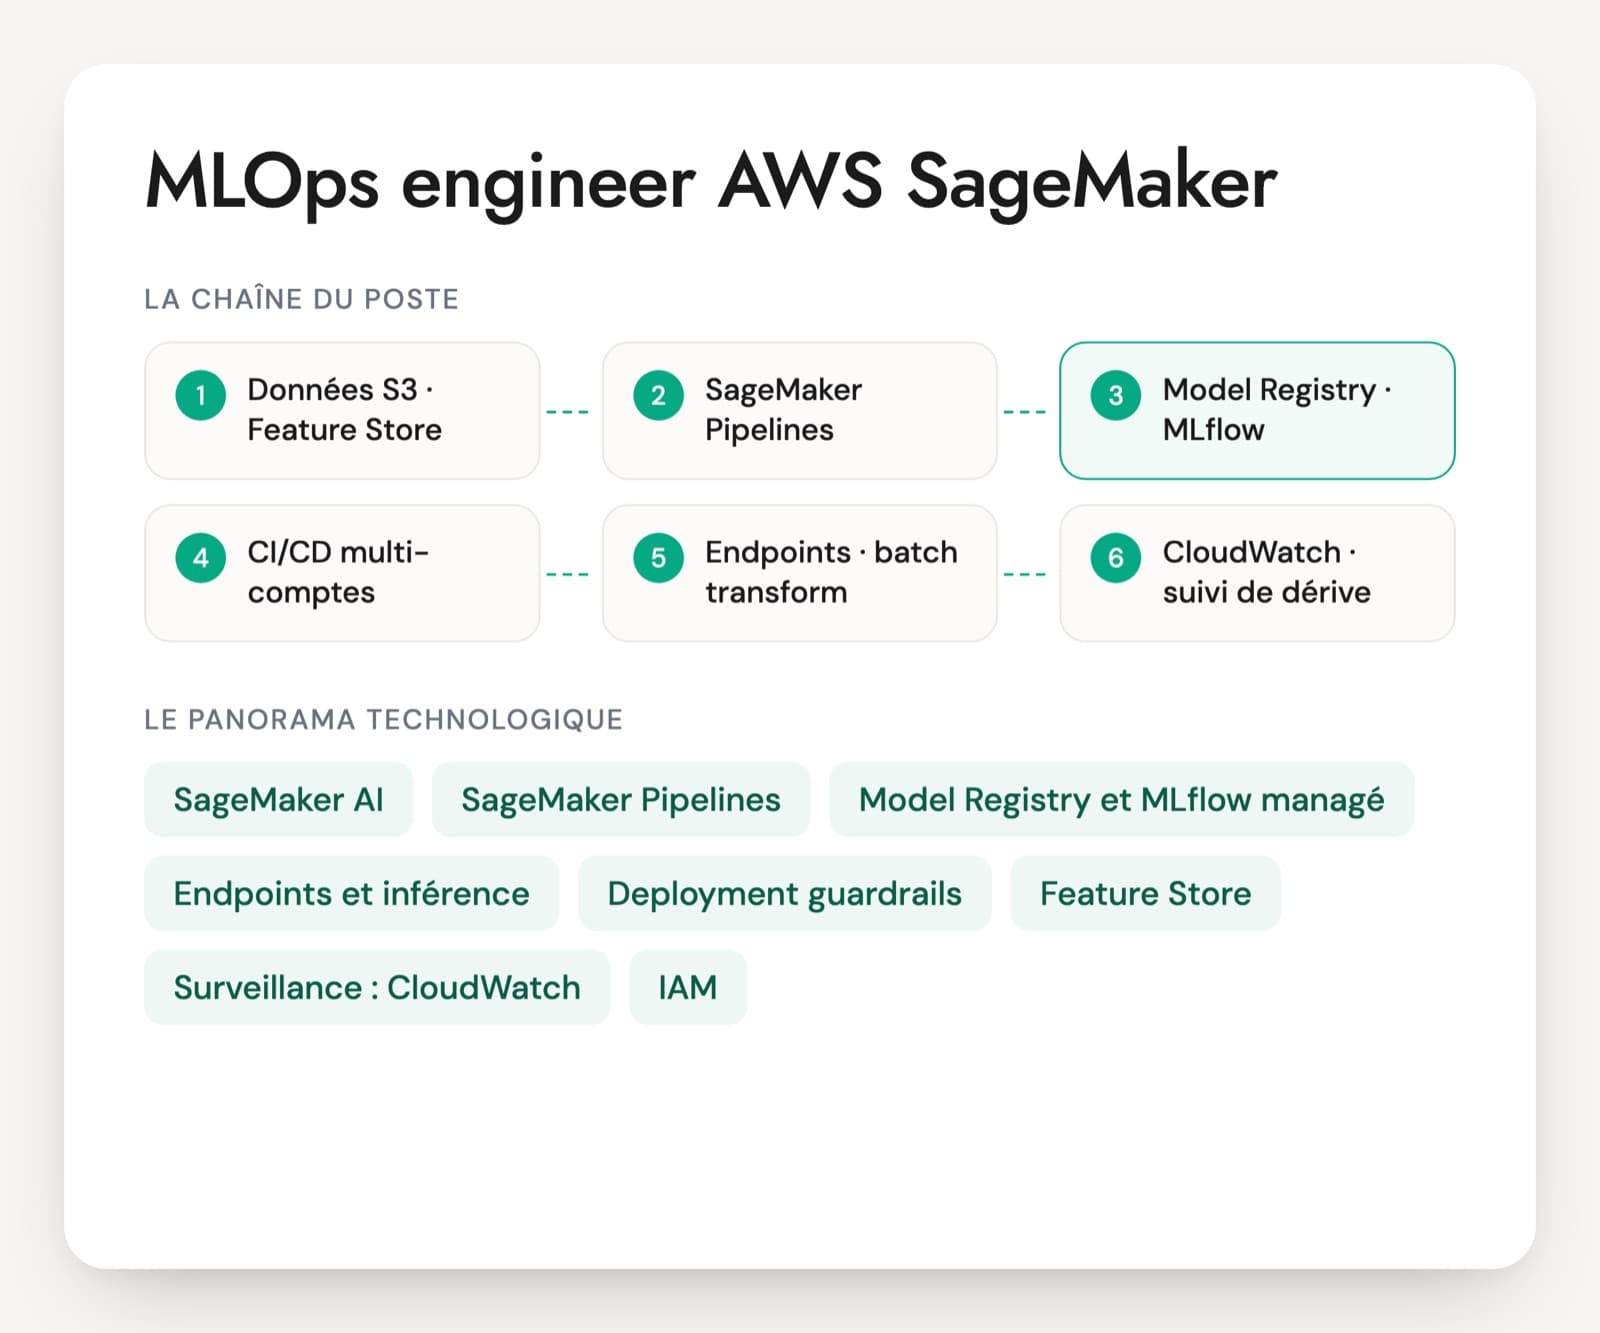
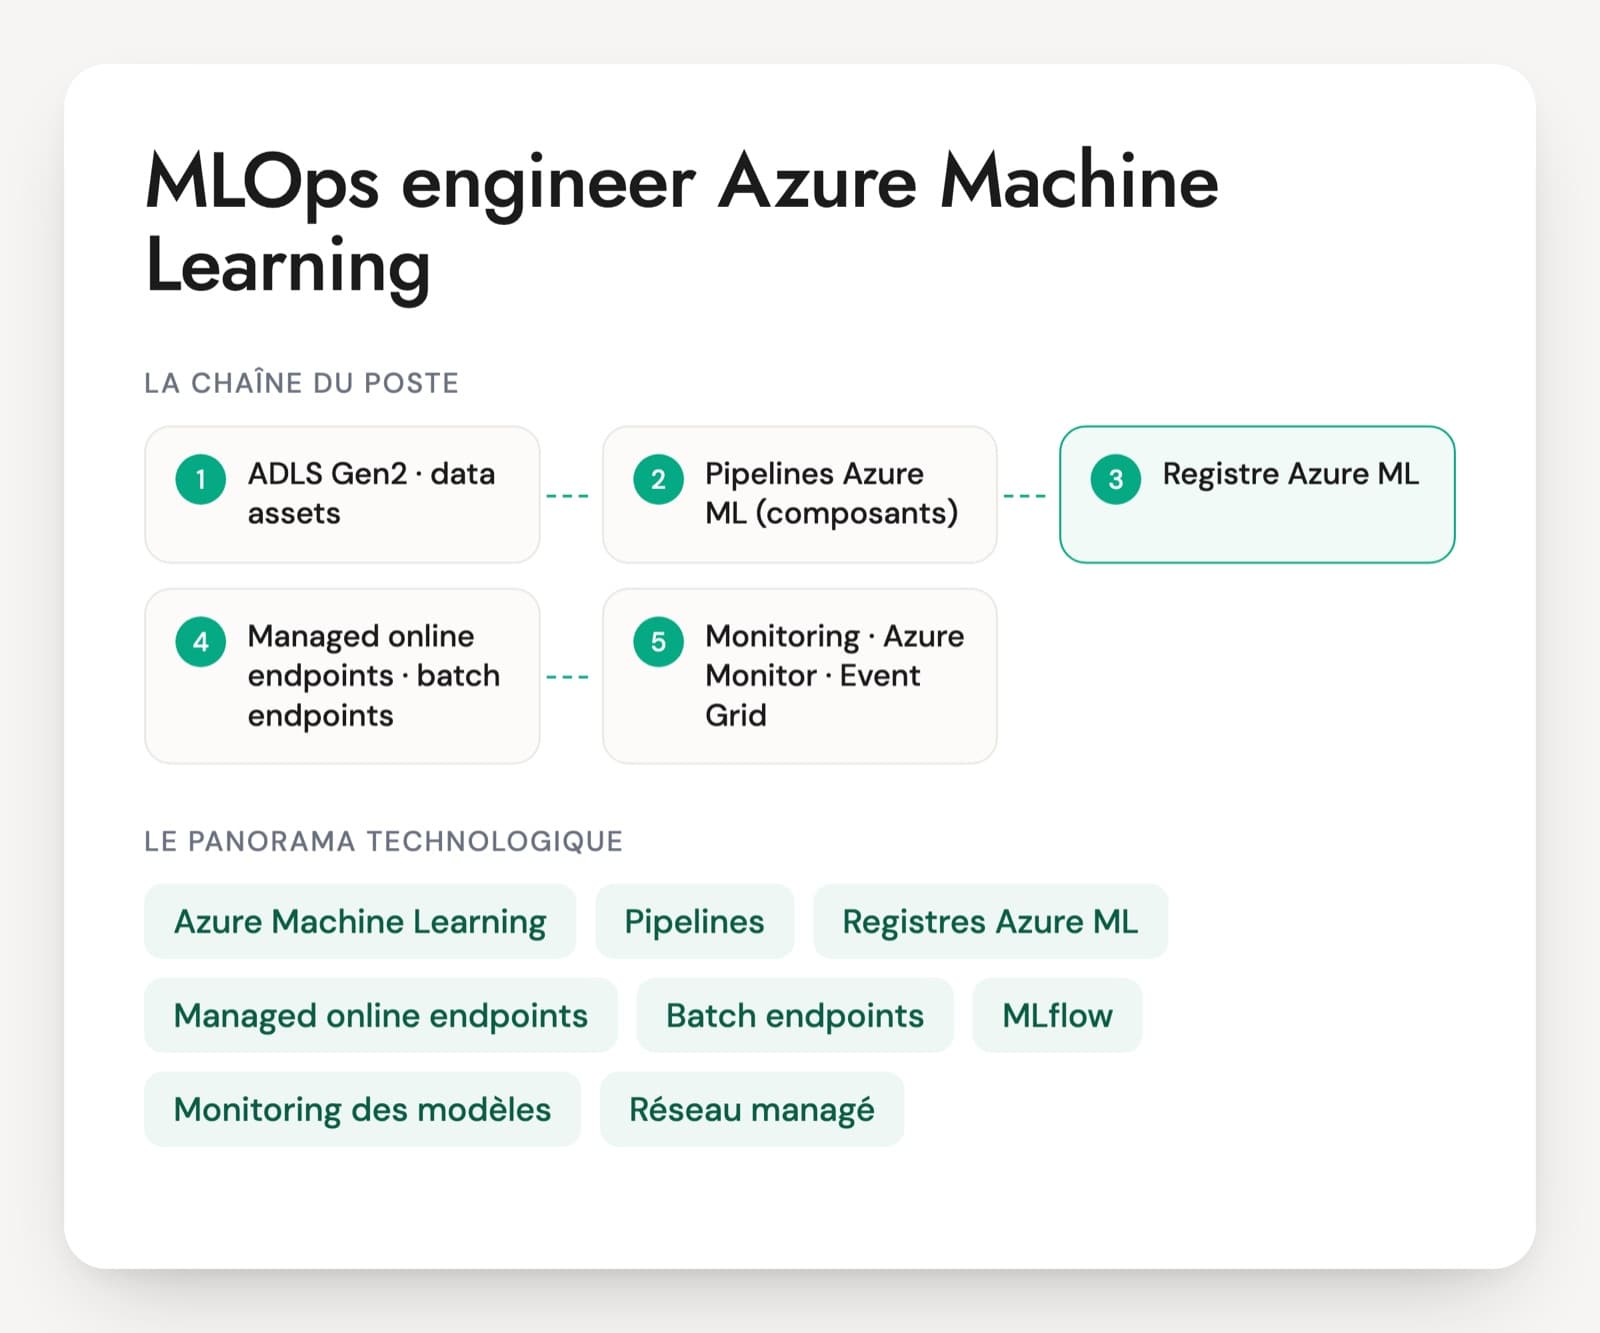
Oui, les notions se transposent : pipeline, registre, endpoint, monitoring. Ce qui change, ce sont les détails de GCP, comme les comptes de service, les types d'endpoint et leurs limites, ou le lien étroit avec BigQuery. En entretien, posez une question où ces détails comptent, par exemple le partage de trafic sur un endpoint privé ou la promotion d'un modèle entre deux projets. Prévoyez quelques semaines de prise en main.
La certification Professional Machine Learning Engineer est-elle un bon filtre ?
Elle prouve une connaissance large des services de Google Cloud pour le machine learning, de l'entraînement à la surveillance. Elle est valable deux ans et Google l'a mise à jour pour suivre le passage à Gemini Enterprise Agent Platform. Elle ne montre pas qu'une personne a tenu un modèle en production. Demandez un incident vécu : une dérive détectée, un retour arrière sur un endpoint, un pipeline qui ressortait de mauvais résultats.
Quel test technique proposer à un MLOps engineer Vertex AI ?
Un exercice d'une heure en entretien vaut mieux qu'un projet à rendre. Montrez un pipeline Kubeflow court avec deux défauts, comme une dépendance installée au lancement et un cache qui ressert des données anciennes, et demandez à la personne de les trouver et d'expliquer le déploiement qui suivrait. Une grille commune permet de comparer les candidats sur les mêmes points, comme celle du PDF de cette page.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.