Administrations, défense, banques, industriels sous contrainte de secret : beaucoup d'organisations françaises veulent des modèles de langage sans envoyer leurs données à un service américain. Elles prennent des modèles open source (Mistral, Llama, Qwen, Gemma), les adaptent par fine-tuning et les servent sur leurs GPU, sur site ou sur un cloud qualifié. Le profil recherché porte des noms variés : AI engineer fine-tuning, ingénieur LLMOps, ML engineer LLM. Il fait le lien entre l'entraînement, l'évaluation et l'exploitation sur GPU.
Le fine-tuning LLM est devenu facile à démarrer. Un tutoriel QLoRA tourne en une heure sur un GPU loué, et le CV affiche alors LoRA, PEFT et Hugging Face. Ce qui manque souvent : un jeu d'évaluation construit avant d'entraîner, une estimation juste de la mémoire GPU, la tenue d'un serveur vLLM sous charge. Les mêmes CV citent encore TGI, que Hugging Face a mis en maintenance puis archivé en mars 2026 au profit de vLLM et SGLang.
Les questions de la page vont de la décision de fine-tuner jusqu'à la mise en production d'un adaptateur. Le PDF les complète : 30 questions sur six axes, un cas de 20 minutes sur un assistant de rédaction hébergé sur site et une grille de 1 à 4.
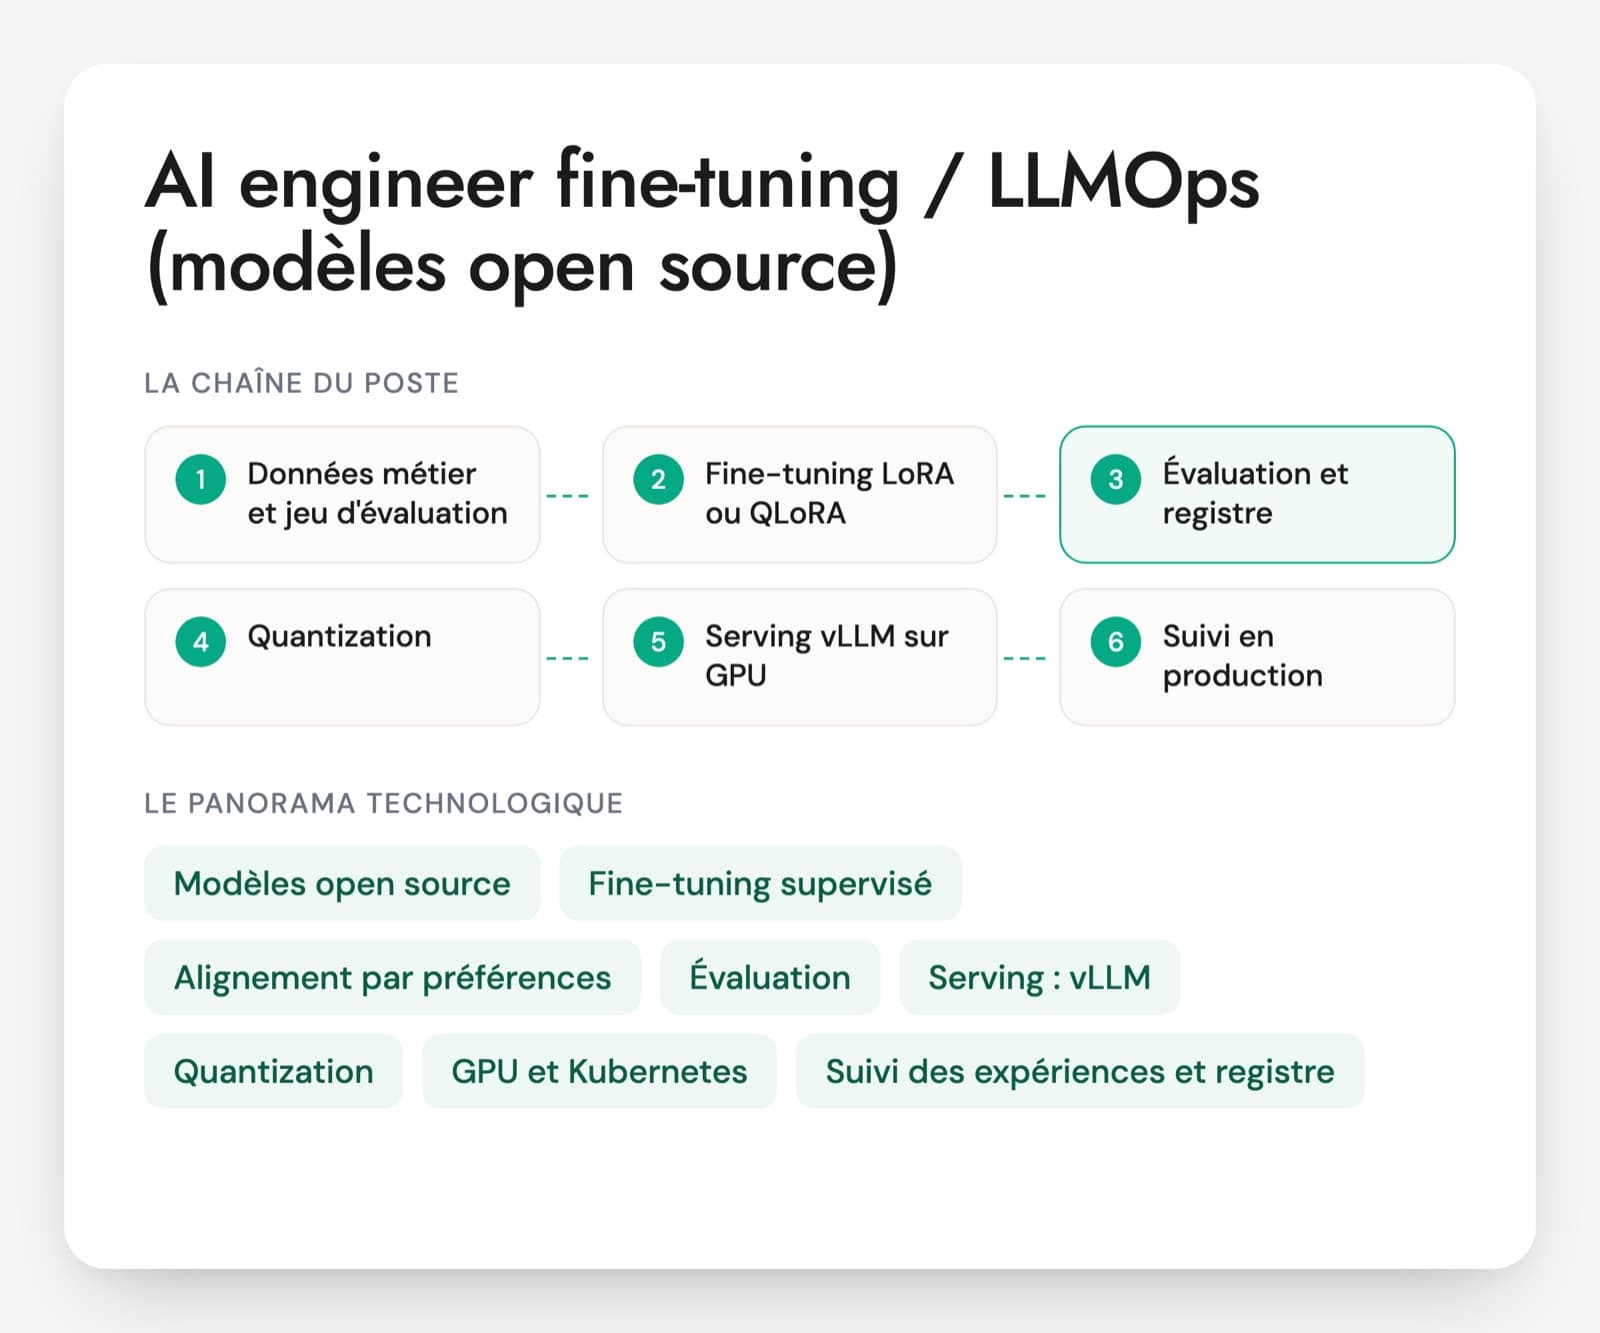
Les frameworks d'entraînement et les serveurs d'inférence du poste
Modèles open source (open weights)
Des modèles dont les poids sont téléchargeables : Mistral, Llama, Qwen, Gemma et d'autres, de quelques milliards à plusieurs centaines de milliards de paramètres. Les licences diffèrent : Apache 2.0 pour une partie des modèles Mistral et Qwen, licence propre à Meta pour Llama, avec ses conditions. Vérifiez que la personne regarde la licence avant le benchmark.
Fine-tuning supervisé, LoRA et QLoRA
Le fine-tuning supervisé (SFT) poursuit l'entraînement sur des exemples de questions et de réponses attendues. LoRA n'entraîne que de petites matrices ajoutées au modèle gelé, ce qui divise la mémoire nécessaire. QLoRA charge en plus le modèle de base en 4 bits. Les bibliothèques courantes sont PEFT, TRL, Unsloth et Axolotl.
Alignement par préférences (DPO, GRPO)
Après le SFT, on peut apprendre au modèle à préférer une réponse à une autre. DPO s'entraîne sur des paires de réponses, l'une préférée, l'autre rejetée. GRPO, popularisé par les modèles de raisonnement, utilise une récompense calculée, par exemple un résultat vérifiable. Ces méthodes demandent des données soignées et une évaluation rigoureuse.
Évaluation
Un jeu de cas propre au métier, construit avant l'entraînement, complété par des tests de capacités générales (lm-evaluation-harness) et de sécurité. Un modèle juge peut noter les réponses ouvertes, à condition d'en contrôler les biais sur un échantillon relu. Sans évaluation, impossible de dire si le fine-tuning a servi.
Serving : vLLM, SGLang, llama.cpp
vLLM est le serveur d'inférence le plus répandu pour servir un modèle à plusieurs utilisateurs : gestion paginée du cache KV, batching continu, cache des préfixes, plusieurs adaptateurs LoRA sur un même modèle, API compatible OpenAI. SGLang est son concurrent direct. llama.cpp et le format GGUF servent aux postes de travail et aux petites machines. TGI, archivé en 2026, appelle une migration.
Quantization
Réduire la précision des poids pour gagner de la mémoire et de la vitesse : FP8 sur les GPU récents qui le gèrent, INT4 avec AWQ ou GPTQ, GGUF pour llama.cpp. Le gain se paie par une perte de qualité qu'il faut mesurer sur les cas métier, en particulier pour le raisonnement et les longs contextes.
GPU et Kubernetes
Les modèles tournent sur des GPU NVIDIA ou AMD, sur site ou dans un cloud. Kubernetes avec le GPU Operator, KServe ou un déploiement maison orchestre les serveurs d'inférence, avec un autoscaling qui doit tenir compte du temps de chargement des poids. Le partage d'un GPU (MIG, time-slicing) aide pour les petits modèles.
Suivi des expériences et registre
MLflow ou Weights & Biases enregistrent chaque entraînement : données, hyperparamètres, courbes, résultats d'évaluation. Un registre de modèles garde les versions validées et leur statut. C'est ce qui permet de savoir, six mois plus tard, quel modèle tourne en production et avec quelles données il a été entraîné.
Le poste se trouve surtout là où la donnée ne peut pas sortir : secteur public, défense, banque, santé, industrie, et chez les éditeurs ou ESN qui leur vendent des solutions hébergées sur site ou sur un cloud qualifié SecNumCloud. Les offres publiées en France parlent de déploiement de modèles open source sur des clusters GPU internes, de vLLM et SGLang, de quantization, de Kubernetes et OpenShift, de MLflow, d'évaluation par LLM-as-judge. Certaines missions portent surtout sur le serving et l'exploitation, d'autres sur l'entraînement : précisez lequel des deux vous cherchez avant de rédiger l'offre. Aucune certification ne couvre ce périmètre, l'entretien et les exemples de projets font foi.
De l'entraînement au GPU : les compétences à vérifier
- Décision et préparation du fine-tuning
- LoRA, QLoRA et alignement
- Évaluation des modèles
- Serving et inférence
- Quantization, GPU et coûts
- LLMOps et conformité
Cinq questions qui séparent la pratique du tutoriel
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Le métier veut « entraîner le modèle sur nos documents » pour qu'il réponde aux questions internes. Vous lancez un fine-tuning ?
Une bonne réponsePas pour cela. Le fine-tuning apprend surtout une forme : un format de sortie, un ton, une tâche répétée comme l'extraction ou la classification, ou le transfert d'un savoir-faire d'un gros modèle vers un petit. Il fait mal retenir des faits précis, et il faudrait le refaire à chaque mise à jour des documents. Pour répondre sur des documents, un RAG convient mieux. La bonne réponse commence par une base de comparaison : un prompt soigné et un jeu d'évaluation, puis le fine-tuning seulement si l'écart mesuré le justifie.
Signal d'alerte« Oui, on fine-tune sur les PDF » sans jeu d'évaluation, ou l'idée que le modèle saura ensuite citer ses sources.
Question 2 · confirmé
Vous disposez d'un seul GPU de 24 Go et devez adapter un modèle de 8 milliards de paramètres. Comment faites-vous ?
Une bonne réponseUn fine-tuning complet ne tient pas : les poids seuls font environ 16 Go en bf16, avant les gradients et les états de l'optimiseur. On gèle donc le modèle et on entraîne des adaptateurs LoRA, de petites matrices ajoutées à certaines couches. Avec QLoRA, le modèle de base est chargé en 4 bits et seuls les adaptateurs sont entraînés en précision normale. S'y ajoutent le gradient checkpointing, un petit batch compensé par l'accumulation de gradients, une longueur de séquence maîtrisée. Il sait citer les réglages : rang, alpha, couches ciblées, taux d'apprentissage.
Signal d'alerte« On réduit le batch à 1 et ça passe » en fine-tuning complet, ou une confusion entre la quantization pour entraîner et celle pour servir le modèle.
Question 3 · confirmé
Après le fine-tuning, le modèle fait mieux sur votre tâche mais répond moins bien aux questions générales. Que s'est-il passé, et comment l'auriez-vous vu avant ?
Une bonne réponseC'est un oubli des capacités générales (catastrophic forgetting) ou un surapprentissage : trop d'époques, un taux d'apprentissage trop fort, des données trop étroites. On le corrige avec un rang LoRA plus faible, moins d'époques, un arrêt sur la perte de validation, un mélange de données générales. On l'aurait vu avec une suite d'évaluation qui couvre la tâche, quelques tests de capacités générales et des cas de sécurité, rejouée avant et après. Il vérifie aussi le gabarit de conversation (chat template), dont une erreur dégrade tout.
Signal d'alerteNe suivre que la perte d'entraînement, ou évaluer sur les données qui ont servi à entraîner.
Question 4 · senior
Votre modèle tourne sous vLLM et la latence explose dès trente utilisateurs simultanés. Que regardez-vous ?
Une bonne réponseLes métriques de vLLM : temps avant le premier token, temps entre deux tokens, file d'attente, taux d'occupation du cache KV et préemptions de requêtes. Si le cache KV sature, il libère de la mémoire (quantization des poids en FP8 ou AWQ, longueur de contexte maximale réduite, gpu-memory-utilization ajusté), active le prefix caching si les prompts partagent un début, règle le nombre de séquences traitées en même temps. Ensuite seulement : parallélisme sur plusieurs GPU ou répliques supplémentaires derrière un répartiteur, et décodage spéculatif si la latence par token reste le problème.
Signal d'alerte« On prend un plus gros GPU » sans métrique, ou une confusion entre débit total et latence par utilisateur.
Question 5 · senior
On vous demande de faire tenir un modèle de 70 milliards de paramètres sur moins de GPU. Quelles options de quantization proposez-vous, et comment mesurez-vous la perte ?
Une bonne réponseLes ordres de grandeur d'abord : environ 140 Go de poids en 16 bits, la moitié en FP8, autour de 35 à 40 Go en 4 bits, plus le cache KV qui grandit avec le contexte et le nombre d'utilisateurs. FP8 sur les GPU qui le gèrent nativement perd peu, les formats 4 bits (AWQ, GPTQ) perdent davantage, surtout en raisonnement et sur les contextes longs. La mesure se fait sur le jeu d'évaluation métier, comparé au modèle d'origine, avec des données de calibration représentatives du vrai usage.
Signal d'alerte« On passe en 4 bits, ça ne change rien », sans mesure, ou aucune idée de la mémoire nécessaire.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Profil d'entraînement ou d'exploitation, et autres choix de recrutement
Doit-on chercher un profil d'entraînement ou un profil d'exploitation des modèles ?
Cela dépend de votre projet. Beaucoup d'équipes utilisent un modèle open source tel quel avec un RAG, et ont surtout besoin de quelqu'un qui sait le servir, le surveiller et maîtriser la facture GPU. Le fine-tuning devient central pour des tâches très spécifiques ou des modèles compacts. Un même profil couvre rarement les deux en profondeur. Classez vos besoins, puis utilisez les axes du PDF pour pondérer l'entretien.
Un data scientist qui a fine-tuné des modèles BERT est-il prêt pour les LLM ?
Il a les bases : jeux d'entraînement et de validation, surapprentissage, métriques. Il lui manque souvent ce qui est propre aux LLM : gabarits de conversation, LoRA et QLoRA, méthodes par préférences, estimation de la mémoire GPU, serving à plusieurs utilisateurs avec vLLM. Les questions sur la mémoire et sur la latence montrent vite s'il a déjà servi un modèle génératif sous charge.
Faut-il faire entraîner un modèle au candidat pendant le test technique ?
Non. Un exercice de diagnostic en entretien vaut mieux qu'un entraînement à faire chez soi, qui coûterait du GPU au candidat. Montrez des courbes de perte, un tableau d'évaluation avant et après fine-tuning, ou les métriques d'un serveur vLLM saturé, et demandez une lecture à voix haute. Vous verrez en trente minutes si la personne sait relier un symptôme à une cause.
Un modèle open source affiné relève-t-il de l'AI Act ?
Oui, comme tout système d'IA mis sur le marché ou utilisé dans l'Union, selon son usage. Celui qui déploie l'assistant porte les obligations liées au cas d'usage, comme la transparence ou les exigences du haut risque. Les lignes directrices de la Commission ne font de celui qui modifie un modèle à usage général un nouveau fournisseur qu'au-delà d'un volume de calcul important, loin d'un fine-tuning LoRA courant. Faites valider le cas précis par votre juriste.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.