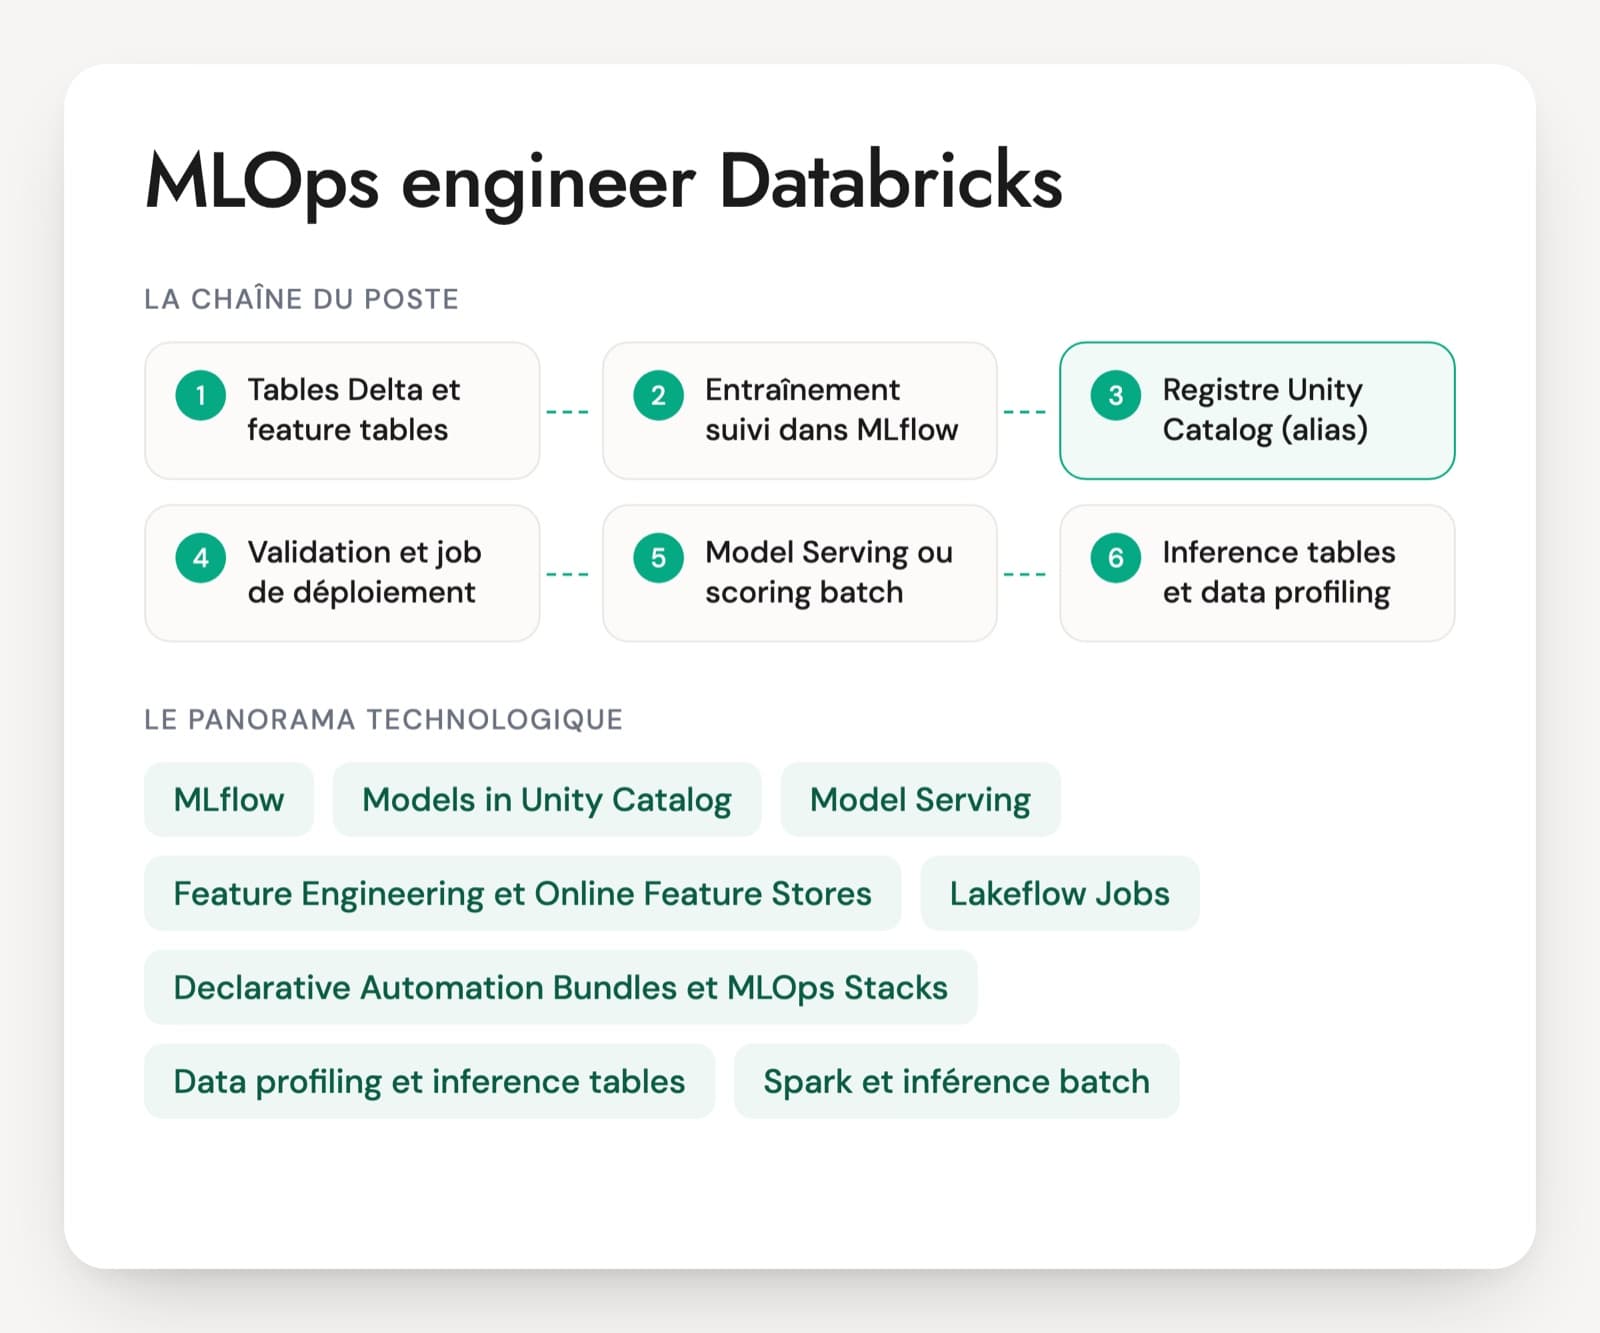
Recruter un MLOps engineer Databricks revient à chercher la personne qui industrialise le travail des data scientists sur le lakehouse. Elle suit les expériences dans MLflow, enregistre les modèles dans Unity Catalog, calcule les features dans des tables Delta, déploie avec Model Serving ou en batch, puis surveille la dérive. En ESN, la mission démarre souvent sur des modèles déjà en place mais scorés à la main. Chez un client final, le poste consiste à monter une plateforme que plusieurs équipes de data science vont partager.
Les CV mélangent deux profils proches. Le data engineer Databricks connaît Spark et Delta, mais n'a pas forcément promu un modèle ni réglé un endpoint. Le data scientist a beaucoup utilisé MLflow pour suivre ses essais, sans s'occuper de la CI ni des droits. La différence s'entend quand la personne parle d'alias champion, de jointure point-in-time, de cold start ou d'inference tables.
Si vous n'avez qu'une demi-heure, gardez les questions sur la promotion et sur la dérive, qui situent déjà bien un profil. Le PDF contient l'entretien complet, avec 30 questions réparties sur six axes, un cas de 20 minutes sur un modèle de résiliation à remettre en production et une grille de notation de 1 à 4.
Ce que Databricks fournit à un MLOps engineer, brique par brique
MLflow (tracking et évaluation)
Le carnet de bord des expériences : chaque entraînement y laisse ses paramètres, ses métriques, ses artefacts et le modèle produit. Databricks l'héberge et l'intègre au workspace. MLflow 3 renforce le suivi du modèle lui-même et de ses évaluations. Un profil de production sait retrouver le code et les données derrière n'importe quel modèle.
Models in Unity Catalog
Le registre des modèles, rangé comme les tables (catalogue, schéma, modèle). Chaque version garde son lignage vers les données d'entraînement, et des alias comme champion ou challenger désignent celle qu'on utilise. Les anciens stages Staging et Production n'existent pas dans Unity Catalog, ce qui trahit vite les profils restés sur l'ancien registre.
Model Serving
Les endpoints REST serverless qui exposent un modèle en temps réel, sur CPU ou GPU. Ils savent répartir le trafic entre deux versions, s'éteindre faute d'appels (scale to zero) et journaliser les requêtes dans des inference tables via AI Gateway. Les mêmes endpoints servent aussi des modèles de fondation et des agents.
Feature Engineering et Online Feature Stores
Les features sont des tables Delta déclarées dans Unity Catalog. À l'entraînement, des lookups datés évitent d'utiliser des informations du futur. Pour le temps réel, les tables sont publiées dans un Online Feature Store, adossé à Lakebase, où l'endpoint va chercher les valeurs tout seul.
Lakeflow Jobs
L'orchestrateur de Databricks, ex-Workflows. Il enchaîne mise à jour des features, entraînement, validation et scoring batch, avec reprises et alertes. MLflow 3 y ajoute des jobs de déploiement, en préversion, déclenchés à chaque nouvelle version de modèle avec une étape d'approbation.
Declarative Automation Bundles et MLOps Stacks
Les bundles décrivent un projet en YAML (jobs, expériences, modèles, endpoints) et le déploient par environnement avec la CLI depuis la CI. Ils s'appelaient Databricks Asset Bundles, nom que vous lirez encore dans la plupart des CV. MLOps Stacks est un modèle de projet bâti sur eux.
Data profiling et inference tables
Le data profiling, nouveau nom de Lakehouse Monitoring, calcule sur une table des statistiques dans le temps, la dérive des entrées et des prédictions, et la performance quand les étiquettes sont disponibles. Appliqué aux inference tables, il dit si le modèle se dégrade. Des alertes SQL peuvent alors lancer une analyse ou un réentraînement.
Spark et inférence batch
Pour scorer des millions de lignes, le modèle MLflow est chargé comme une fonction Spark ou appelé depuis SQL avec ai_query. C'est souvent la majorité des usages réels. Vérifiez que la personne sait scorer une grosse table sans tout rapatrier sur une seule machine.
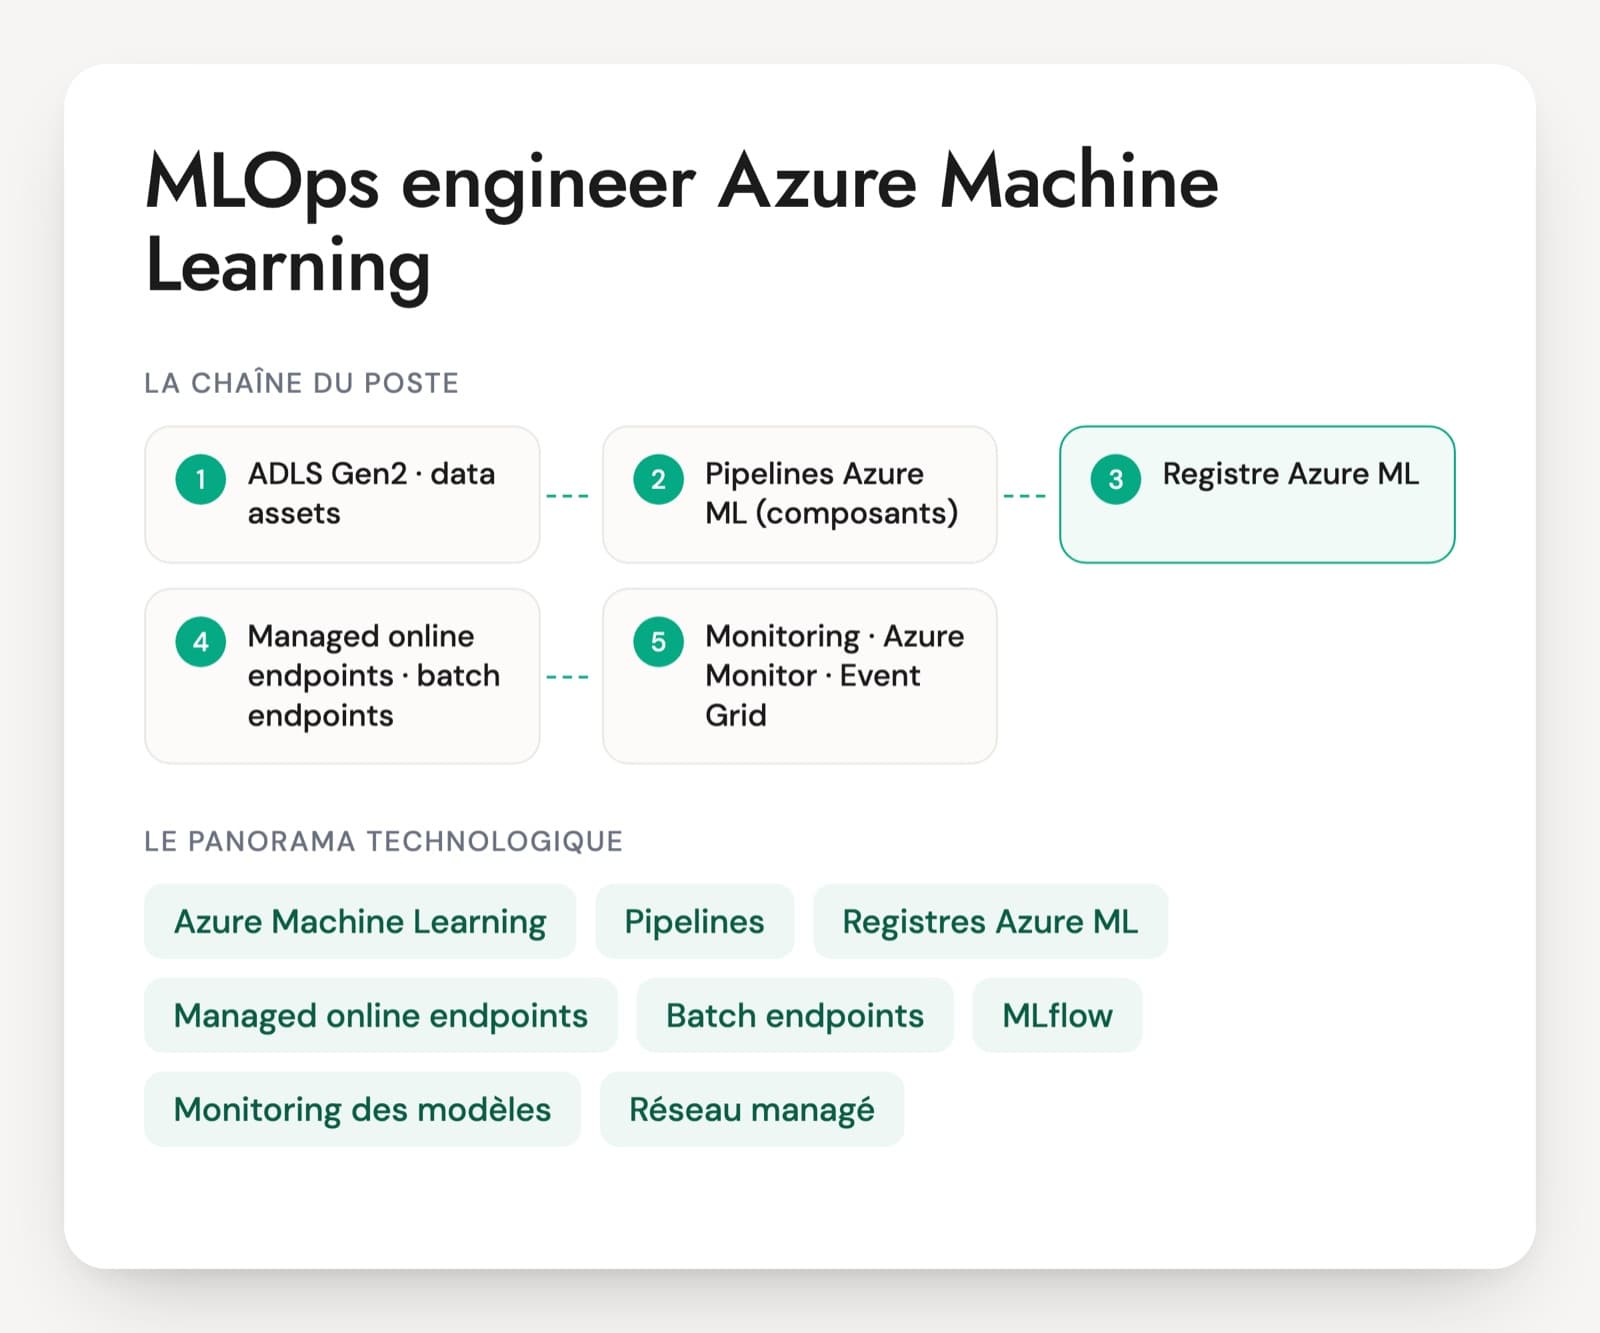
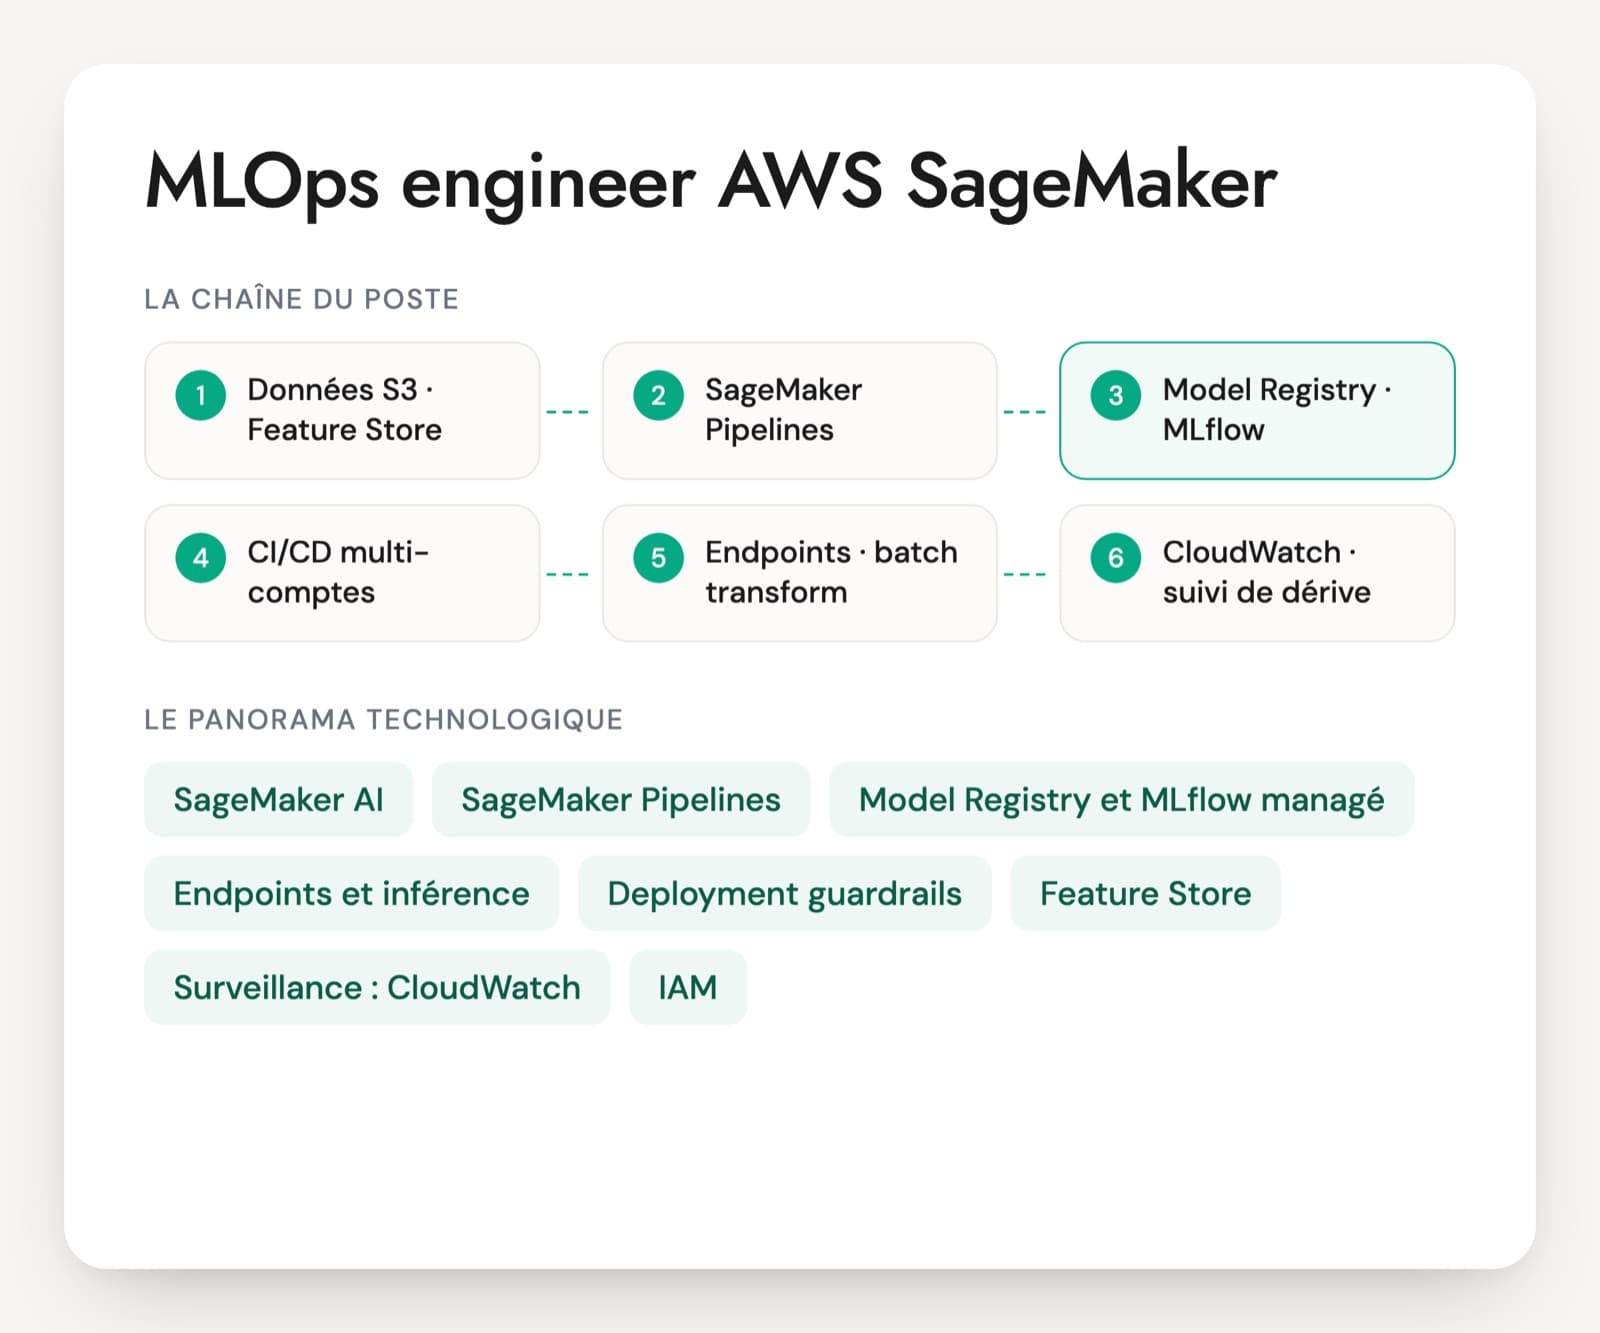
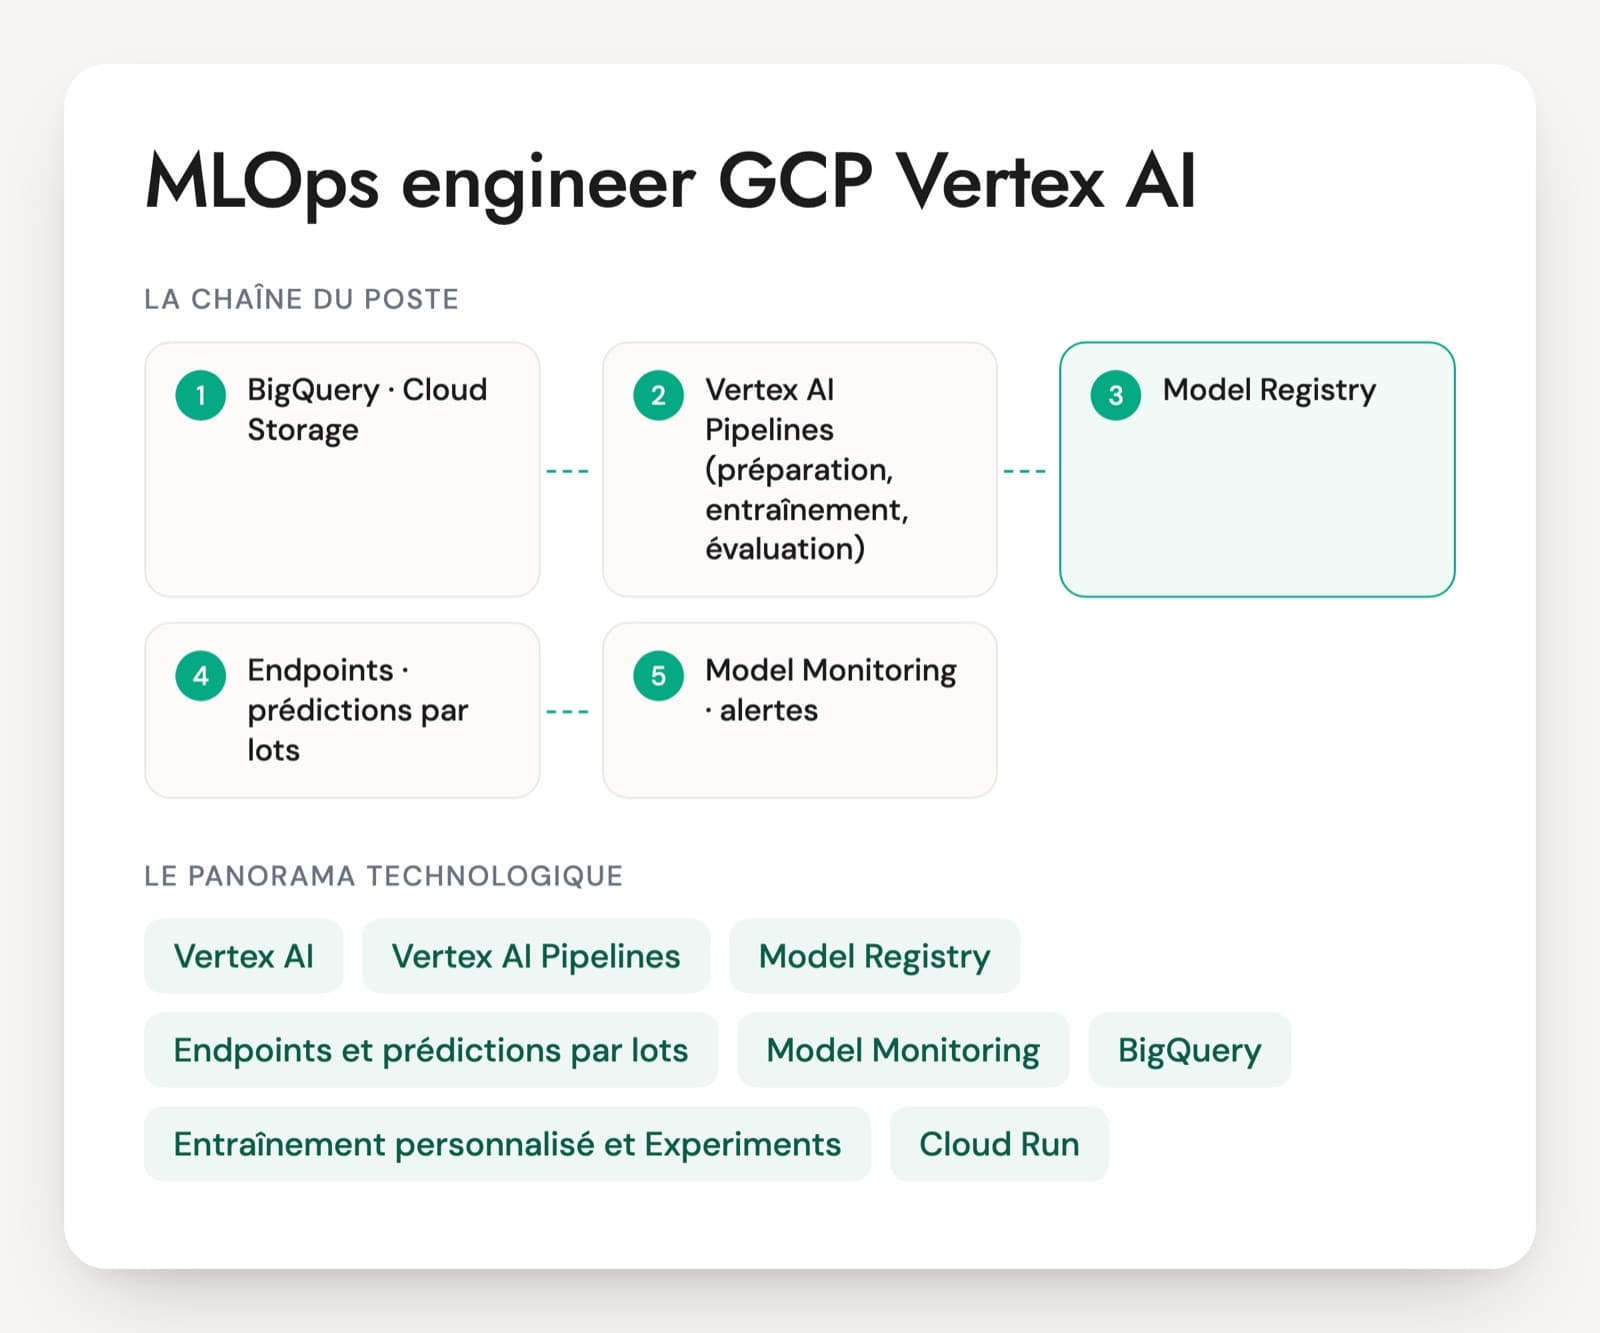
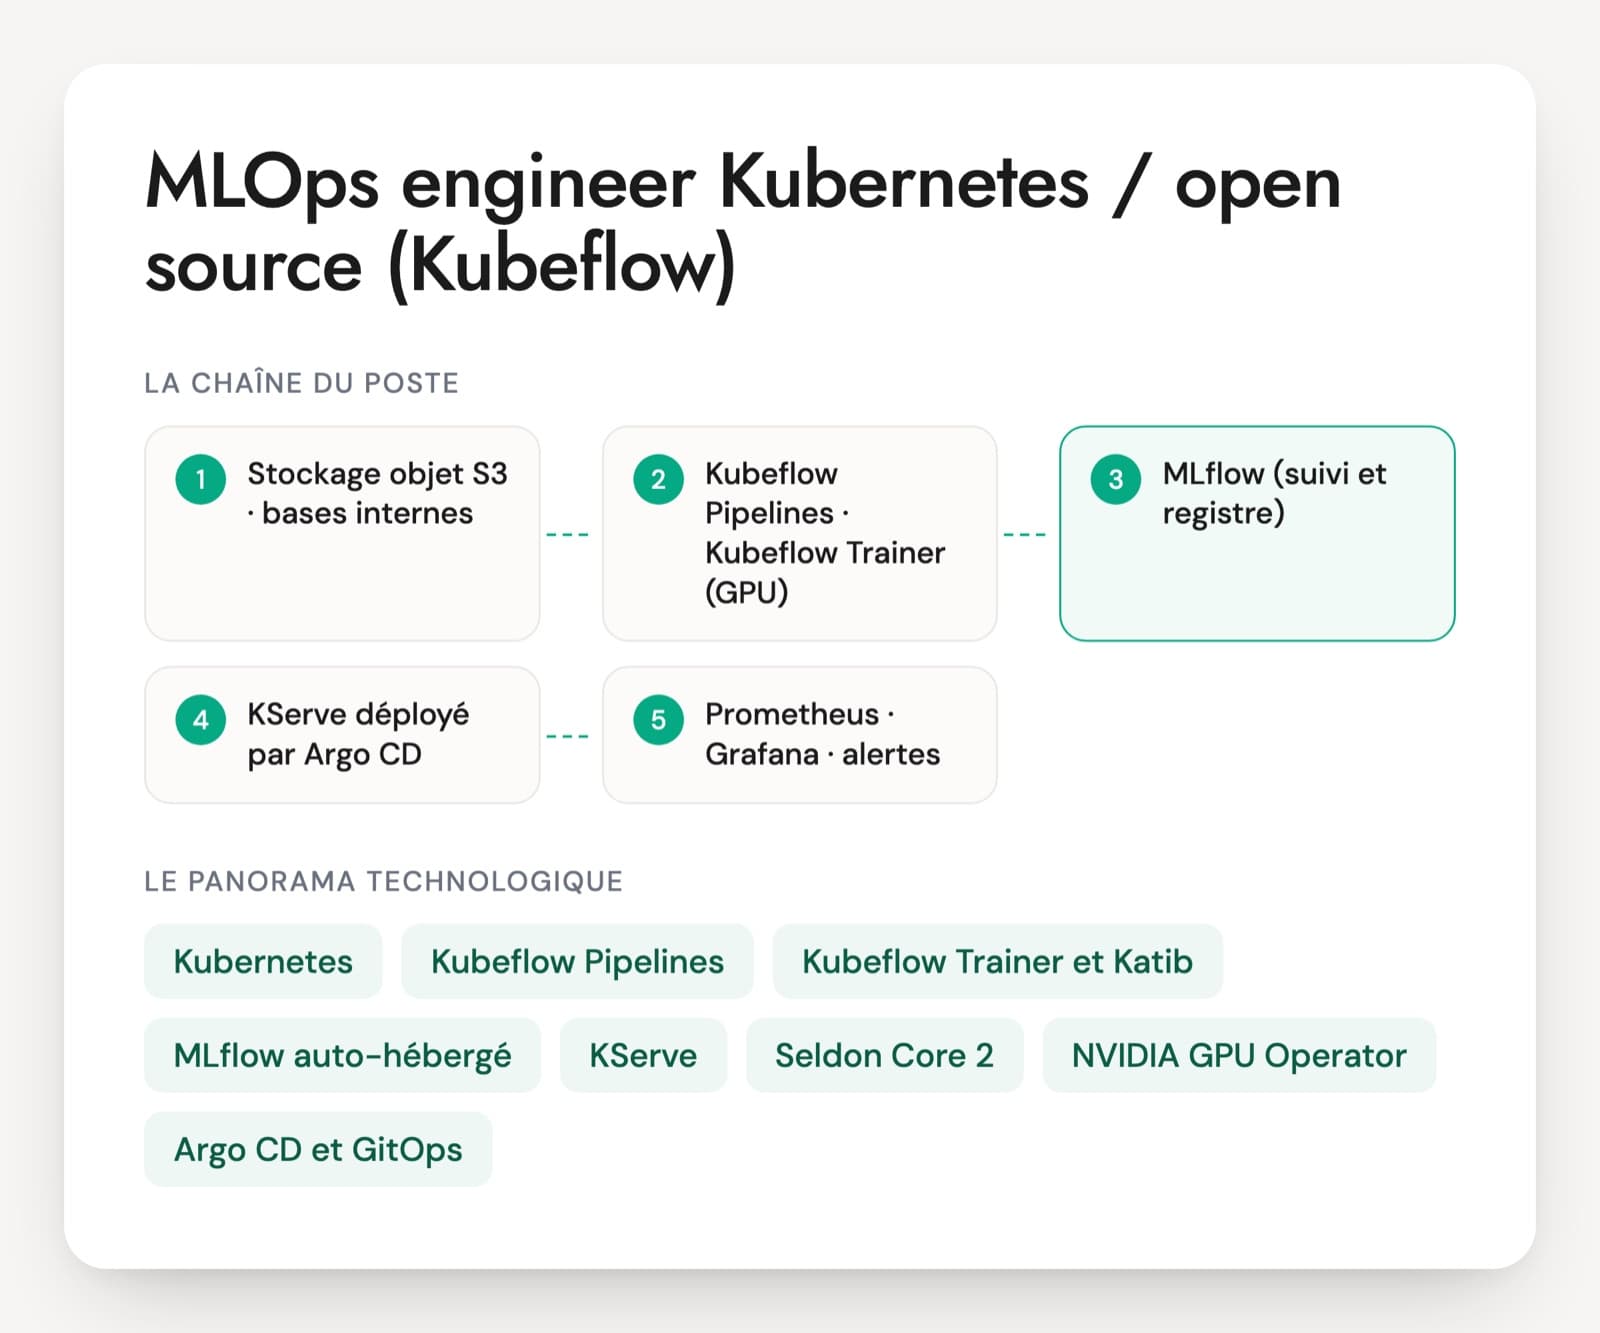
Le poste se recrute rarement sous un seul intitulé : MLOps engineer, ML engineer Databricks ou ML platform engineer selon l'entreprise. Les offres françaises le placent souvent sur Azure Databricks, avec Azure DevOps ou GitHub Actions pour la CI, et y ajoutent souvent des sujets d'IA générative (serving de LLM, AI Gateway, évaluation). En ESN, il faut reprendre vite un existant fait de notebooks. Chez un client final, la personne construit la plateforme et les règles que les data scientists suivront ensuite. Les certifications Databricks Machine Learning Associate et Professional attestent la connaissance des outils. L'expérience de production se vérifie en entretien.
Six savoir-faire à couvrir avec un MLOps engineer Databricks
- Suivi d'expériences et registre MLflow
- Promotion des modèles entre environnements
- Features et cohérence entraînement-serving
- Serving temps réel et inférence batch
- CI/CD avec bundles et Lakeflow Jobs
- Monitoring de dérive et réentraînement
MLflow, registre et serving : cinq questions à poser
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Un data scientist vous dit que son meilleur modèle, « c'est le run d'hier soir ». Comment retrouvez-vous exactement ce qui l'a produit ?
Une bonne réponseIl ouvre le run MLflow : paramètres, métriques, commit Git enregistré avec le run, environnement logué avec le modèle (dépendances figées), signature et exemple d'entrée. Pour les données, la version de la table Delta utilisée ou le dataset logué dans le run. Une fois le modèle enregistré dans Unity Catalog, le lignage relie la version du modèle aux tables qui l'ont nourri.
Signal d'alerte« Le notebook est dans mon dossier personnel », ou un fichier pickle déposé sur un stockage sans aucune trace des données ni du code qui l'ont produit.
Question 2 · senior
Votre modèle est validé en recette. Vous faites passer en production le modèle lui-même, ou le code qui l'entraîne ?
Une bonne réponseIl connaît les deux schémas. Databricks recommande de promouvoir le code : Git porte la version validée, et la production réentraîne sur ses propres données dans le catalogue de production, ce qui automatise aussi les réentraînements. Promouvoir le modèle se justifie quand l'entraînement coûte très cher ou ne se rejoue pas facilement : on copie alors la version d'un catalogue à l'autre, avec une validation en staging.
Signal d'alerteUne position dogmatique sans critère, ou « j'exporte le pickle et je l'envoie à l'équipe de production ».
Question 3 · confirmé
Le modèle est bon hors ligne et nettement moins bon en production. Les features sont calculées dans un notebook pour l'entraînement et dans l'API pour le serving. Que soupçonnez-vous ?
Une bonne réponseUn écart entre entraînement et serving : deux implémentations des mêmes features qui ne donnent pas les mêmes valeurs. Ou une fuite de données, une feature calculée à l'entraînement avec une information postérieure à la prédiction. La correction passe par des feature tables dans Unity Catalog, un jeu d'entraînement construit avec des lookups datés, et un modèle logué avec ses métadonnées de features pour que le serving les récupère lui-même. Il compare ensuite les distributions grâce aux inference tables.
Signal d'alerte« On réentraîne plus souvent », sans chercher d'où vient l'écart.
Question 4 · confirmé
Un endpoint Model Serving met trente secondes à répondre le lundi matin, puis tout redevient normal. Que vérifiez-vous ?
Une bonne réponseLe scale to zero : sans trafic pendant le week-end, l'endpoint s'est éteint et le premier appel paie le démarrage. Viennent ensuite la taille du modèle et de son environnement, qui allonge ce démarrage, et la concurrence minimale configurée. Pour un endpoint de production, il garde une capacité minimale aux heures ouvrées ou désactive le scale to zero, en connaissant le coût de ce choix.
Signal d'alerte« On passe sur une machine plus grosse », sans avoir regardé les métriques de l'endpoint.
Question 5 · confirmé
Comment déployez-vous le même projet ML en développement, staging et production depuis votre CI ?
Une bonne réponseAvec un bundle : un fichier databricks.yml qui déclare des targets par environnement et les ressources du projet (jobs, expériences, modèles enregistrés, endpoints). La CI (GitHub Actions, Azure DevOps ou GitLab) lance la validation puis le déploiement avec la CLI Databricks, authentifiée par un service principal. Il connaît le modèle de projet MLOps Stacks, qui part de ce principe.
Signal d'alerteDes jobs créés à la main dans l'interface, et des notebooks copiés d'un workspace à l'autre.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Avant de lancer le recrutement d'un MLOps engineer Databricks
Quelle différence entre un MLOps engineer Databricks et un data engineer Databricks ?
Le data engineer construit et fiabilise les tables : ingestion, transformations Spark, Delta, orchestration. Le MLOps engineer part de ces tables pour faire vivre des modèles : suivi dans MLflow, registre Unity Catalog, features, endpoints, monitoring de dérive et réentraînement. Les deux partagent la plateforme et une partie des outils. Un data engineer peut évoluer vers le poste s'il a déjà déployé et surveillé un modèle, pas seulement préparé ses données.
Un profil venu d'Azure ML ou de SageMaker est-il vite opérationnel sur Databricks ?
Souvent, car les notions sont les mêmes : registre, endpoints, pipelines, monitoring. Ce qui change, c'est le rangement dans Unity Catalog, les alias à la place des stages, les feature tables en Delta, les bundles et le coût des clusters. Demandez-lui de transposer un déploiement qu'il a fait ailleurs. S'il raisonne en environnements, en droits et en retour arrière, quelques semaines suffisent en général pour l'outillage.
Que mettre dans un test technique de MLOps engineer Databricks ?
Un projet court plutôt qu'un exercice d'algorithmique : un modèle déjà entraîné dans un notebook, à transformer en job planifié avec enregistrement dans Unity Catalog, alias, test automatique et déploiement par bundle. Sans workspace disponible, faites décrire la même chaîne au tableau et commenter un fichier databricks.yml fourni. Ce qui compte, c'est le retour arrière, les droits et la manière de détecter qu'un modèle se dégrade.
La certification Databricks Machine Learning Professional est-elle un bon filtre ?
Elle indique que la personne connaît les services ML de la plateforme et leur usage. Elle ne dit rien d'une plateforme tenue dans la durée, avec plusieurs équipes, des incidents et une facture. Servez-vous-en pour trier des CV proches, puis demandez un exemple précis : un modèle promu avec ses contrôles, un endpoint dépanné, une dérive détectée. Sans exemple de production, le niveau reste à confirmer par une mise en situation.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.