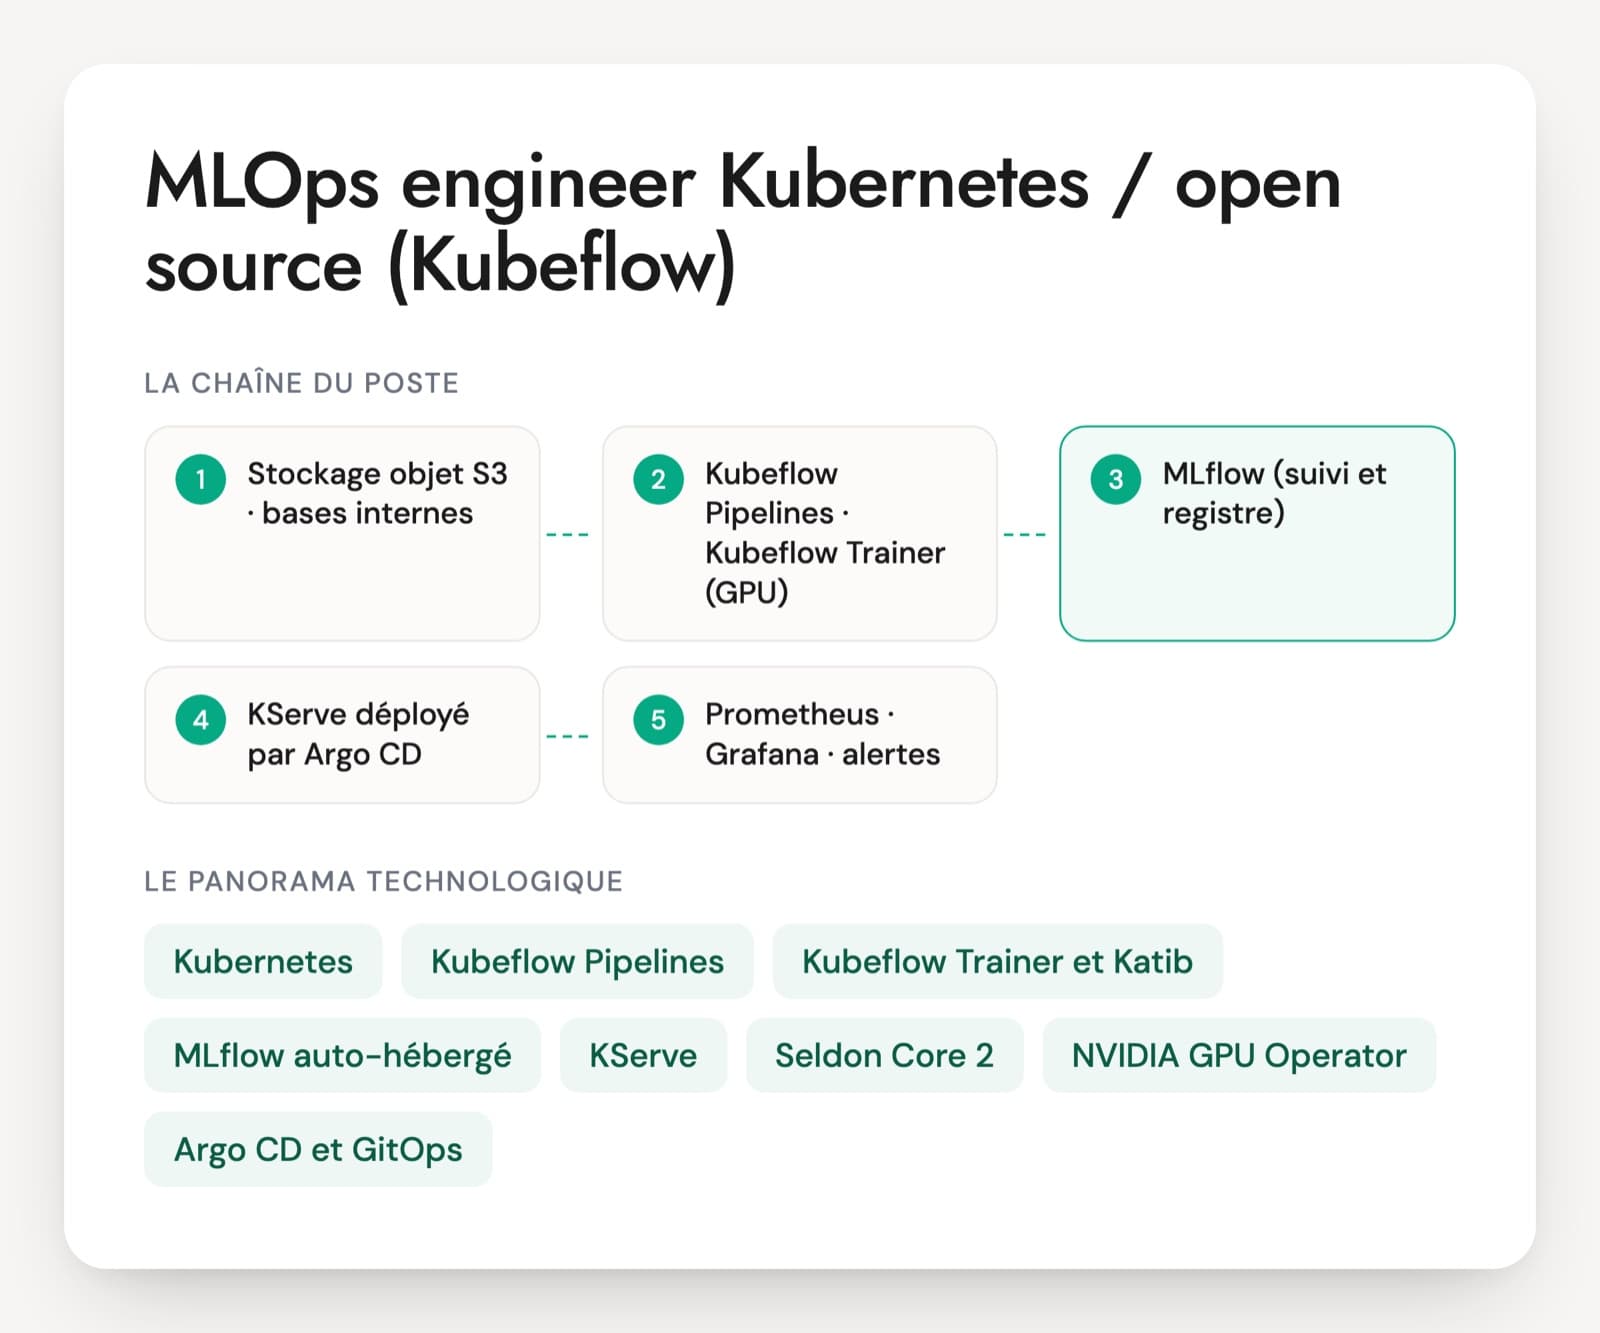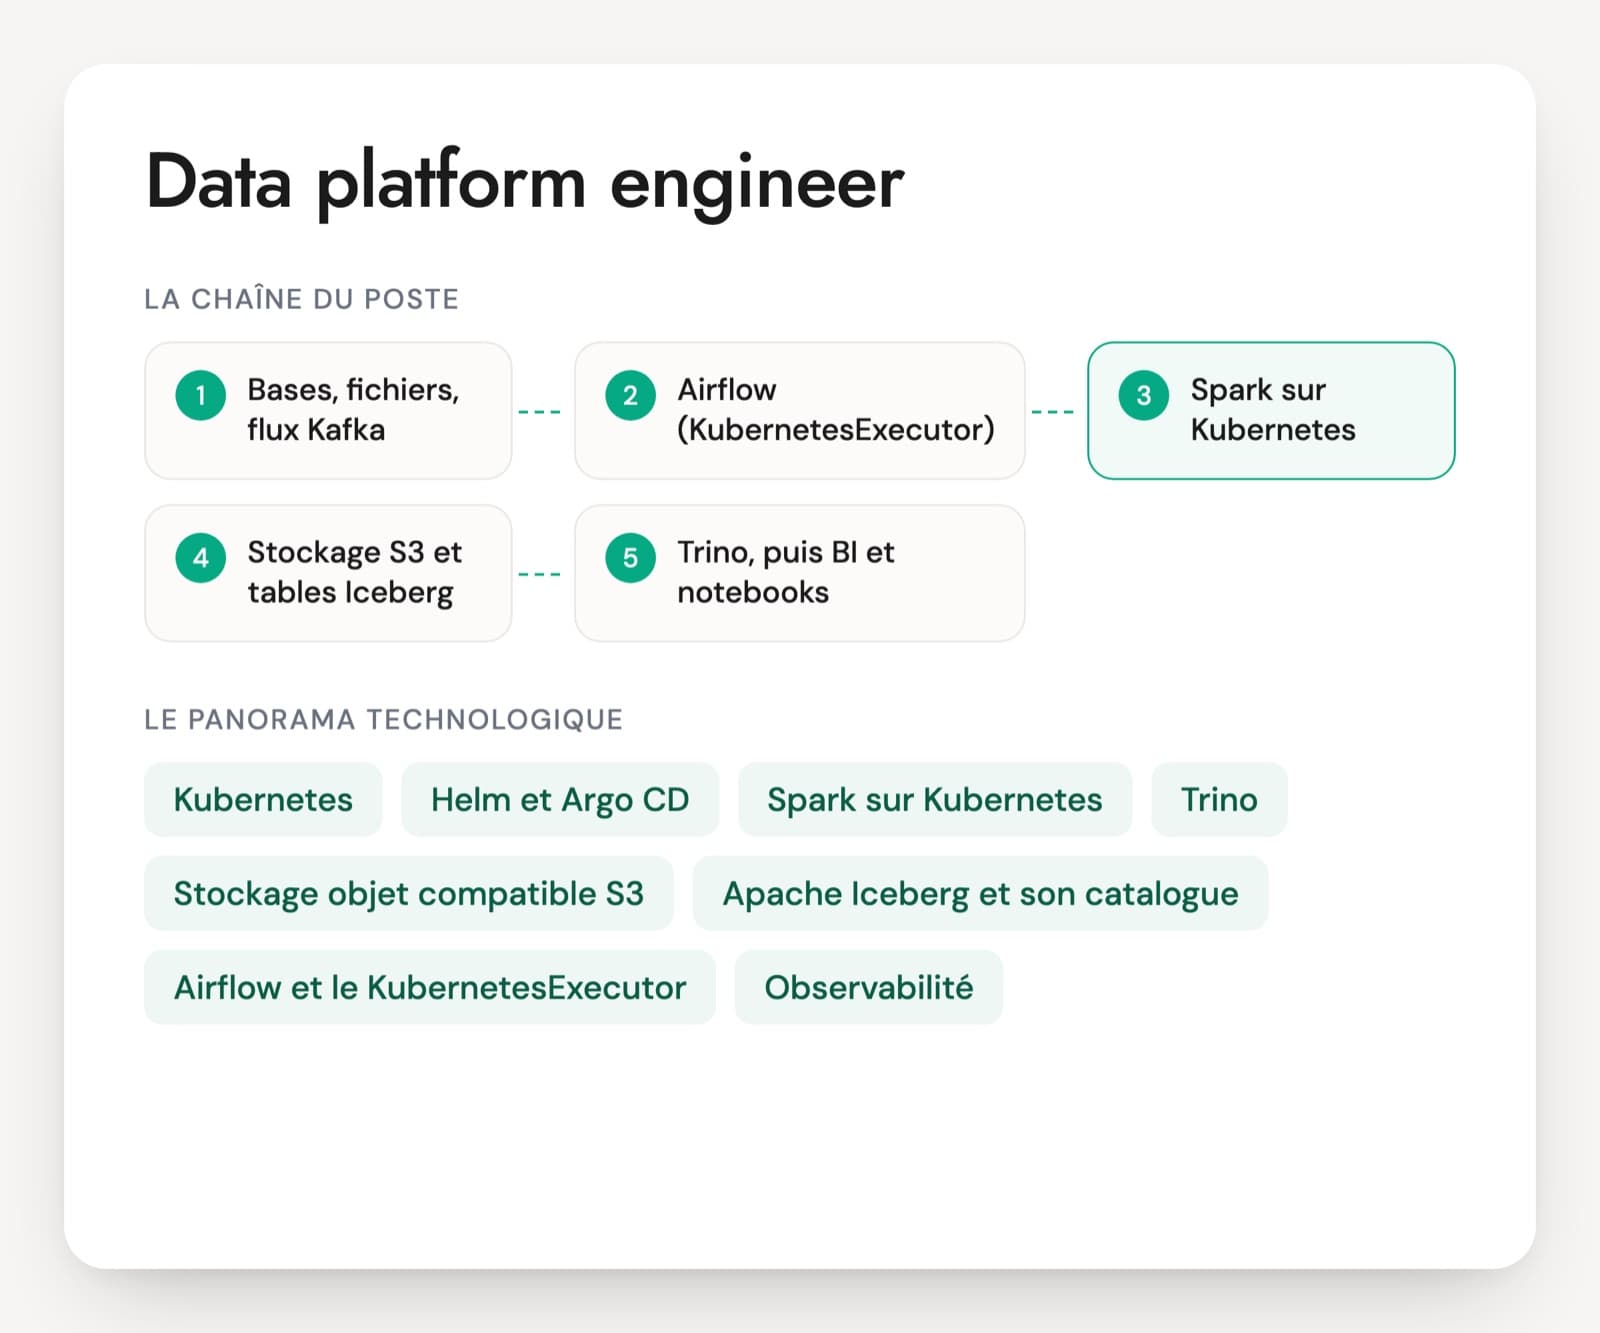
Un data platform engineer sur Kubernetes construit et exploite l'outillage dont se servent les data engineers, les data scientists et les analystes. Le choix d'héberger soi-même revient souvent dans le secteur public, la défense, l'industrie ou chez les acteurs qui veulent garder leurs données sur leurs serveurs. La plateforme réunit en général Spark lancé par un opérateur, Trino pour les requêtes SQL, Airflow avec le KubernetesExecutor, des tables Iceberg sur un stockage compatible S3, le tout déployé par Helm et Argo CD.
Le risque, à l'entretien, vient des profils DevOps solides qui n'ont jamais vu une charge data. Déployer une API sans état n'a rien à voir avec des executors Spark qui réclament de la mémoire hors tas, un shuffle à conserver quand un pod disparaît ou un coordinateur Trino qui sature. À l'inverse, un data engineer qui a lancé des jobs sur un cluster déjà monté ne sait pas forcément le faire évoluer ni le mettre à jour.
Qui opère le cluster, l'équipe data elle-même ou une équipe infra : le manager doit le préciser. Faites raconter au candidat une mise à jour de Spark ou de Trino qui s'est mal passée.
La pile open source d'une plateforme data sur Kubernetes
Kubernetes
Le système qui fait tourner tous les services dans des conteneurs, répartis sur les machines du cluster. Pour une plateforme data, la difficulté porte sur les ressources : mémoire et CPU réservés par pod, quotas par équipe, nœuds dédiés aux gros calculs. Les questions doivent partir de là plutôt que des commandes de base.
Helm et Argo CD
Helm installe chaque service à partir d'un paquet configurable (un chart). Argo CD applique en continu ce qui est décrit dans un dépôt Git, c'est l'approche GitOps. Toute modification passe par une merge request, et une correction faite à la main sur le cluster est détectée.
Spark sur Kubernetes
Spark lance un pod driver qui crée lui-même ses pods executors. Sur une plateforme, les jobs passent souvent par le Spark Operator, aujourd'hui maintenu par le projet Kubeflow, qui décrit chaque application dans un fichier YAML. La mémoire des pods, le shuffle et l'ordonnancement en lot (Volcano, YuniKorn) sont les sujets délicats.
Trino
Le moteur SQL distribué qui interroge les tables du lac et d'autres sources sans les copier. Un coordinateur répartit chaque requête sur des workers. En production, il faut limiter la mémoire par requête et répartir la capacité entre équipes pour qu'une requête lourde ne bloque pas les autres.
Stockage objet compatible S3
Les fichiers du lac vivent dans un stockage objet hébergé sur place : MinIO, Ceph (passerelle RGW) ou un autre produit compatible S3. Le dépôt communautaire de MinIO est archivé depuis avril 2026 et ne reçoit plus de mises à jour, ce qui pousse beaucoup d'équipes à revoir ce choix. Demandez à la personne ce qu'elle exploite aujourd'hui.
Apache Iceberg et son catalogue
Iceberg est un format de table posé sur des fichiers Parquet. Il apporte les mises à jour, l'historique des versions et l'évolution du schéma. Un catalogue (Hive Metastore, Nessie, Apache Polaris ou un catalogue REST) garde la liste des tables et leur version courante, et Spark comme Trino passent par lui.
Airflow et le KubernetesExecutor
Airflow orchestre les traitements. Avec le KubernetesExecutor, chaque tâche tourne dans son propre pod, avec ses ressources et son image. Le gain est l'isolation. En contrepartie, les journaux disparaissent avec le pod si personne n'a prévu de les envoyer ailleurs.
Observabilité
Prometheus collecte les métriques, Grafana les affiche, un outil comme Loki ou OpenSearch centralise les journaux. Sur une plateforme data, on suit aussi le retard des DAG, la durée des jobs Spark et la file d'attente de Trino, pas seulement l'état des pods.
Sécurité et secrets
Une authentification unique (souvent Keycloak en OIDC) pour les interfaces, des droits Kubernetes (RBAC) par équipe, des règles réseau entre services et un coffre à secrets comme Vault relié au cluster. Les clés d'accès au stockage ne doivent jamais se trouver dans une image ni dans Git.
Le poste existe surtout là où les données ne peuvent pas partir chez un fournisseur cloud américain, ou là où l'on veut une plateforme open source sans dépendre d'un éditeur : administrations, défense, santé, industrie, opérateurs, certains grands comptes. Les offres paraissent sous des intitulés variés, data platform engineer, ingénieur DevOps plateforme data, DataOps engineer ou SRE data. Le candidat attendu a deux cultures. Il exploite Kubernetes au quotidien (ressources, mises à jour, réseau, sécurité) et comprend comment se comportent les charges data, de la mémoire d'un executor Spark à la concurrence des requêtes Trino. La certification CKA atteste la première. La seconde se vérifie en entretien.
Ce que doit maîtriser un data platform engineer Kubernetes
- Ressources et ordonnancement Kubernetes pour les charges data
- Spark sur Kubernetes
- Trino, stockage objet et tables Iceberg
- Airflow sur Kubernetes
- GitOps, Helm et mises à jour de la plateforme
- Sécurité, secrets et observabilité
Les questions à soumettre à un data platform engineer Kubernetes
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Cette nuit, les jobs Spark sont restés bloqués avec des pods executors en Pending. Que regardez-vous ?
Une bonne réponseLes événements des pods (kubectl describe) : manque de CPU ou de mémoire sur les nœuds, quota du namespace atteint, taint ou sélecteur de nœud qui ne correspond à rien, volume persistant non attaché. Il rappelle qu'un executor demande sa mémoire Spark plus une surcharge (memoryOverhead), donc plus que ce que l'équipe a configuré. Un bon profil parle aussi de l'autoscaler et de l'ordonnancement en lot (Volcano, YuniKorn) pour éviter qu'un driver démarre et attende des executors qui ne viendront jamais.
Signal d'alerte« On agrandit le cluster » sans lire les événements, ou supprimer les pods en espérant qu'ils repartent.
Question 2 · senior
Une requête Trino lancée par un analyste fait tomber des workers en manque de mémoire et casse les requêtes des autres. Comment protégez-vous le cluster ?
Une bonne réponseDes limites de mémoire par requête (query.max-memory, query.max-memory-per-node) cohérentes avec le tas Java, lui-même dimensionné sous la limite mémoire du pod. Des resource groups qui plafonnent la concurrence et la mémoire par équipe ou par utilisateur. Des pods workers avec requests égales aux limits pour éviter les évictions. Pour les très gros traitements, un cluster séparé avec l'exécution tolérante aux pannes (retry-policy TASK et un exchange manager sur le stockage objet).
Signal d'alerteDonner plus de mémoire aux pods sans limite par requête, ou un tas Java réglé à la taille totale du pod.
Question 3 · confirmé
Avec le KubernetesExecutor, les journaux d'une tâche Airflow en échec ont disparu avec son pod. Comment l'évitez-vous, et comment donnez-vous plus de mémoire à une seule tâche ?
Une bonne réponseUne journalisation distante vers un bucket du stockage objet, ou un volume partagé, configurée pour tous les pods de tâche. Pour une tâche gourmande, un pod_override dans l'executor_config qui change ses ressources, sans toucher au pod_template_file commun. Il cite la base de métadonnées PostgreSQL, puisque le KubernetesExecutor n'accepte pas SQLite.
Signal d'alerteLire les journaux avec kubectl logs sur un pod déjà supprimé, ou augmenter la mémoire de toutes les tâches.
Question 4 · confirmé
Vous devez monter de version le chart Helm de Trino déployé par Argo CD. Comment procédez-vous ?
Une bonne réponseUne lecture des notes de version du chart et de Trino, la modification de la version et des valeurs dans Git par merge request, une revue du différentiel affiché par Argo CD, un déploiement d'abord sur le cluster de recette, puis en production à une heure creuse. Le retour arrière se fait par un revert dans Git. Il ne touche pas aux ressources à la main, puisque Argo CD les signalerait comme désynchronisées.
Signal d'alerteUn helm upgrade lancé depuis son poste sur la production, ou un kubectl edit directement sur le cluster.
Question 5 · confirmé
Un job Spark doit lire un bucket du stockage objet. Comment lui donnez-vous ses identifiants sans les écrire dans le code ni dans l'image ?
Une bonne réponseUn Secret Kubernetes injecté en variable d'environnement ou en fichier, alimenté depuis Vault par External Secrets Operator ou l'injecteur de Vault. Un compte de service et une politique d'accès au bucket par application, des droits RBAC qui limitent qui peut lire les Secrets du namespace, une rotation des clés. Il sait que les Secrets doivent être chiffrés au repos côté serveur d'API.
Signal d'alerteUne clé d'accès dans spark-defaults.conf intégré à l'image ou dans le dépôt Git, ou une seule clé administrateur pour toutes les équipes.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Plateforme data auto-hébergée : questions fréquentes des recruteurs
Quelle différence entre un data platform engineer et un data engineer ?
Le data engineer construit les pipelines qui transforment les données. Le data platform engineer construit et exploite les outils sur lesquels ces pipelines tournent : cluster, Spark, Trino, Airflow, stockage, droits, supervision. Ses clients sont les équipes data internes. Sur une plateforme Kubernetes auto-hébergée, le poste est plus proche du SRE que du développement de pipelines, mais il demande de comprendre le fonctionnement de Spark et de Trino pour les régler correctement.
La certification CKA suffit-elle pour ce poste ?
La Certified Kubernetes Administrator montre une bonne pratique de l'administration d'un cluster : ressources, réseau, stockage, mises à jour, dépannage. Elle ne couvre ni Spark, ni Trino, ni Airflow. Un candidat certifié doit encore expliquer la mémoire d'un executor, le shuffle ou les resource groups de Trino. Un profil sans certification, qui a exploité une plateforme data en production et raconte ses incidents avec précision, peut être plus adapté.
Quel test technique proposer à un data platform engineer Kubernetes ?
Un exercice sur un cluster de quelques nœuds (kind ou k3d suffisent) donne de bons signaux : un job Spark en Pending à débloquer, un chart Helm à modifier proprement, un DAG Airflow dont les journaux disparaissent. Une heure suffit. Faites commenter le diagnostic à voix haute. Si vous préférez un format sans machine, un schéma de plateforme à critiquer et des extraits de YAML à corriger fonctionnent aussi.
Pourquoi héberger soi-même une plateforme data au lieu d'utiliser un service cloud ?
Les raisons tiennent surtout à la localisation des données et à la dépendance aux fournisseurs : exigences de souveraineté, données sensibles qui ne doivent pas quitter les serveurs de l'organisation, qualification SecNumCloud attendue, volonté d'éviter un éditeur unique. Le coût se discute au cas par cas. Pour le recrutement, ce choix change le profil : la personne doit tenir les mises à jour, la sécurité et la capacité que fournirait sinon un service managé.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.