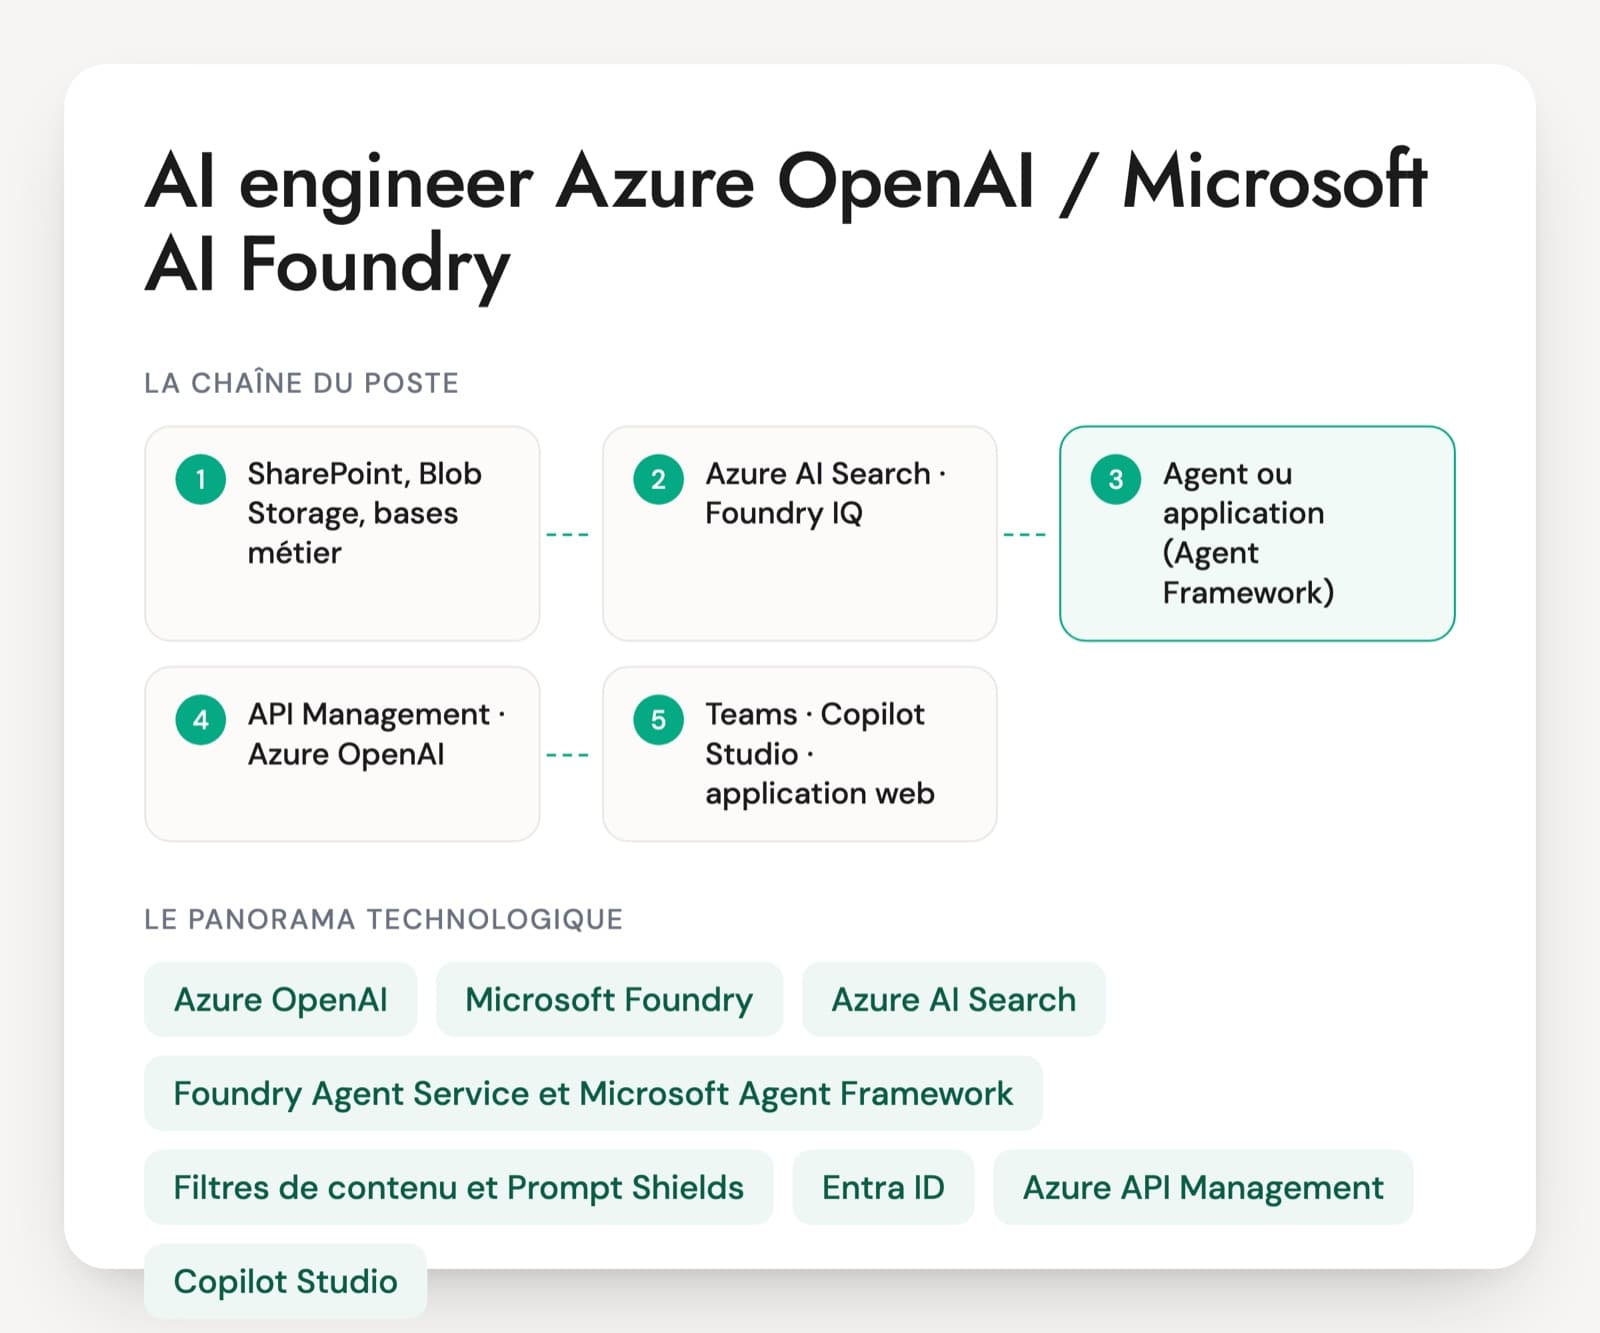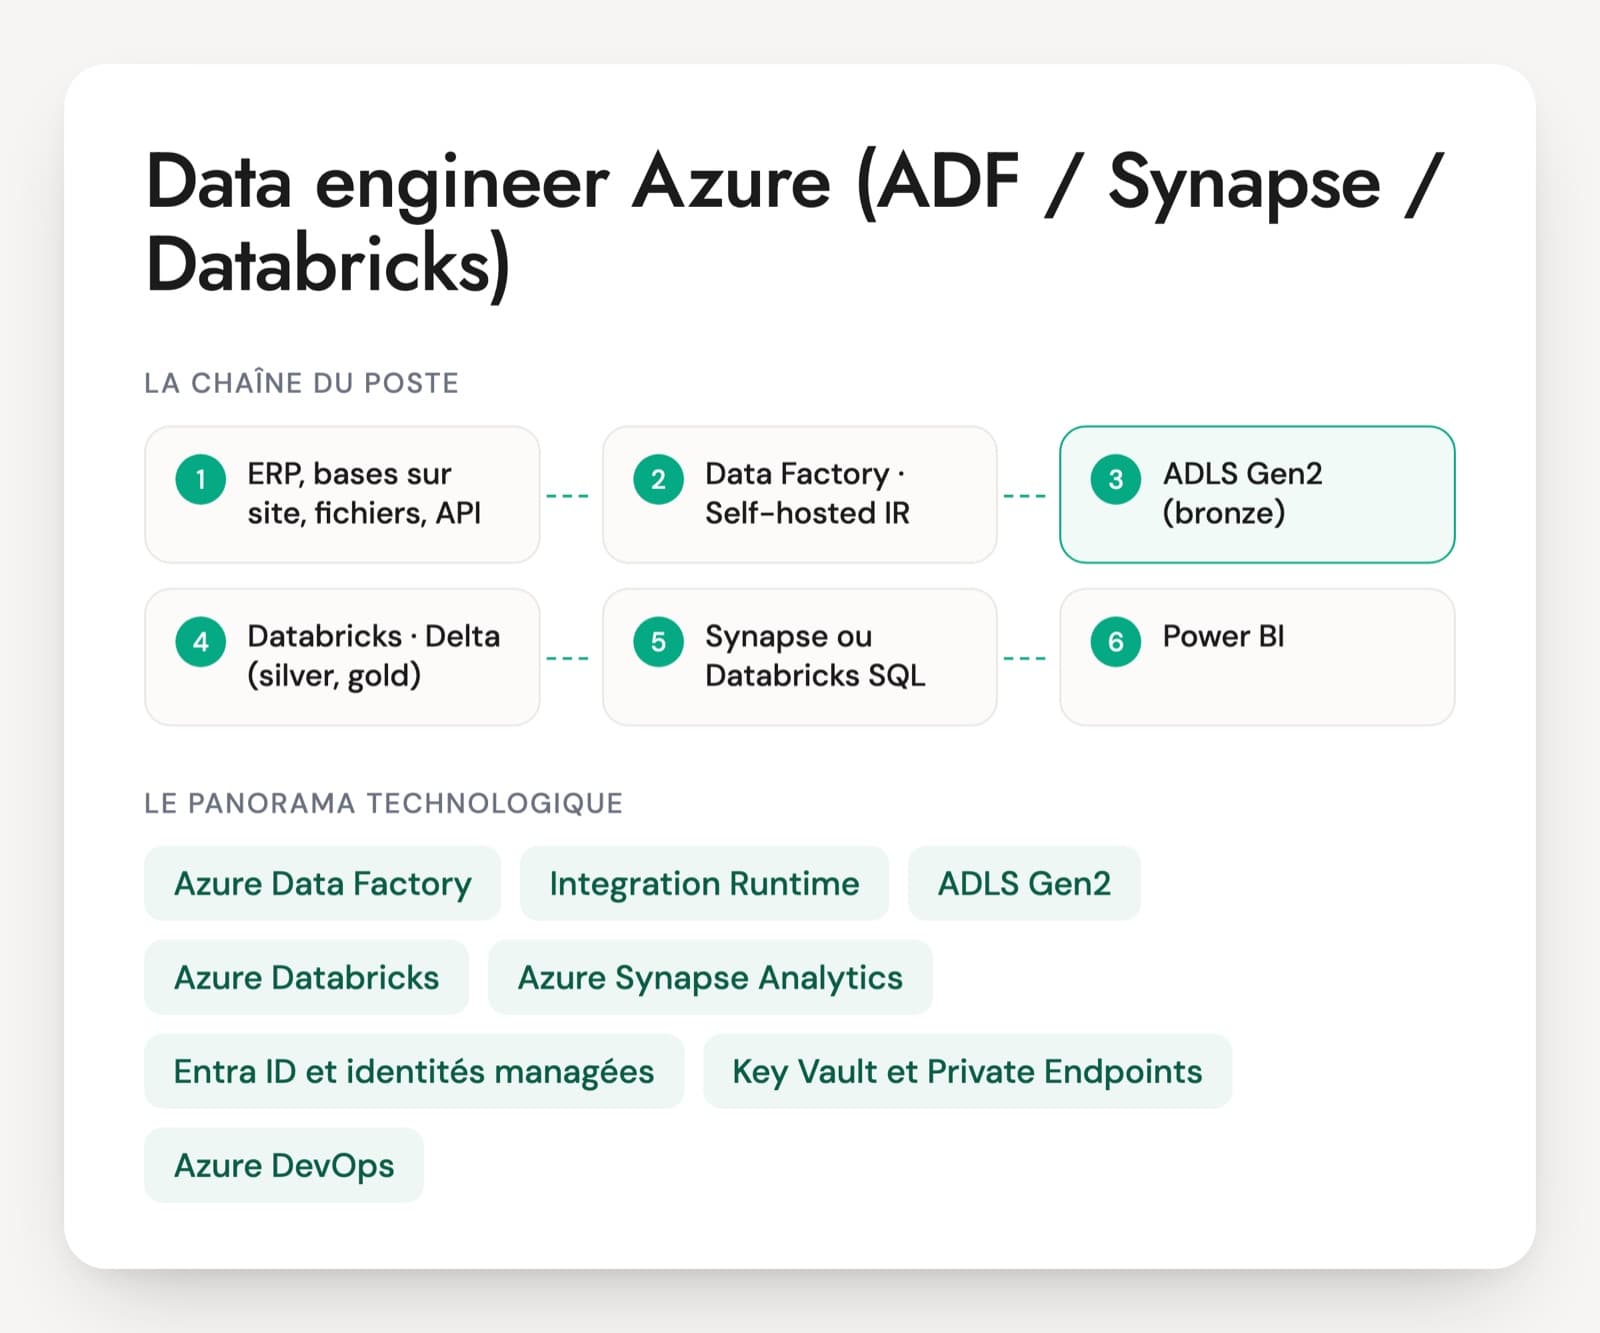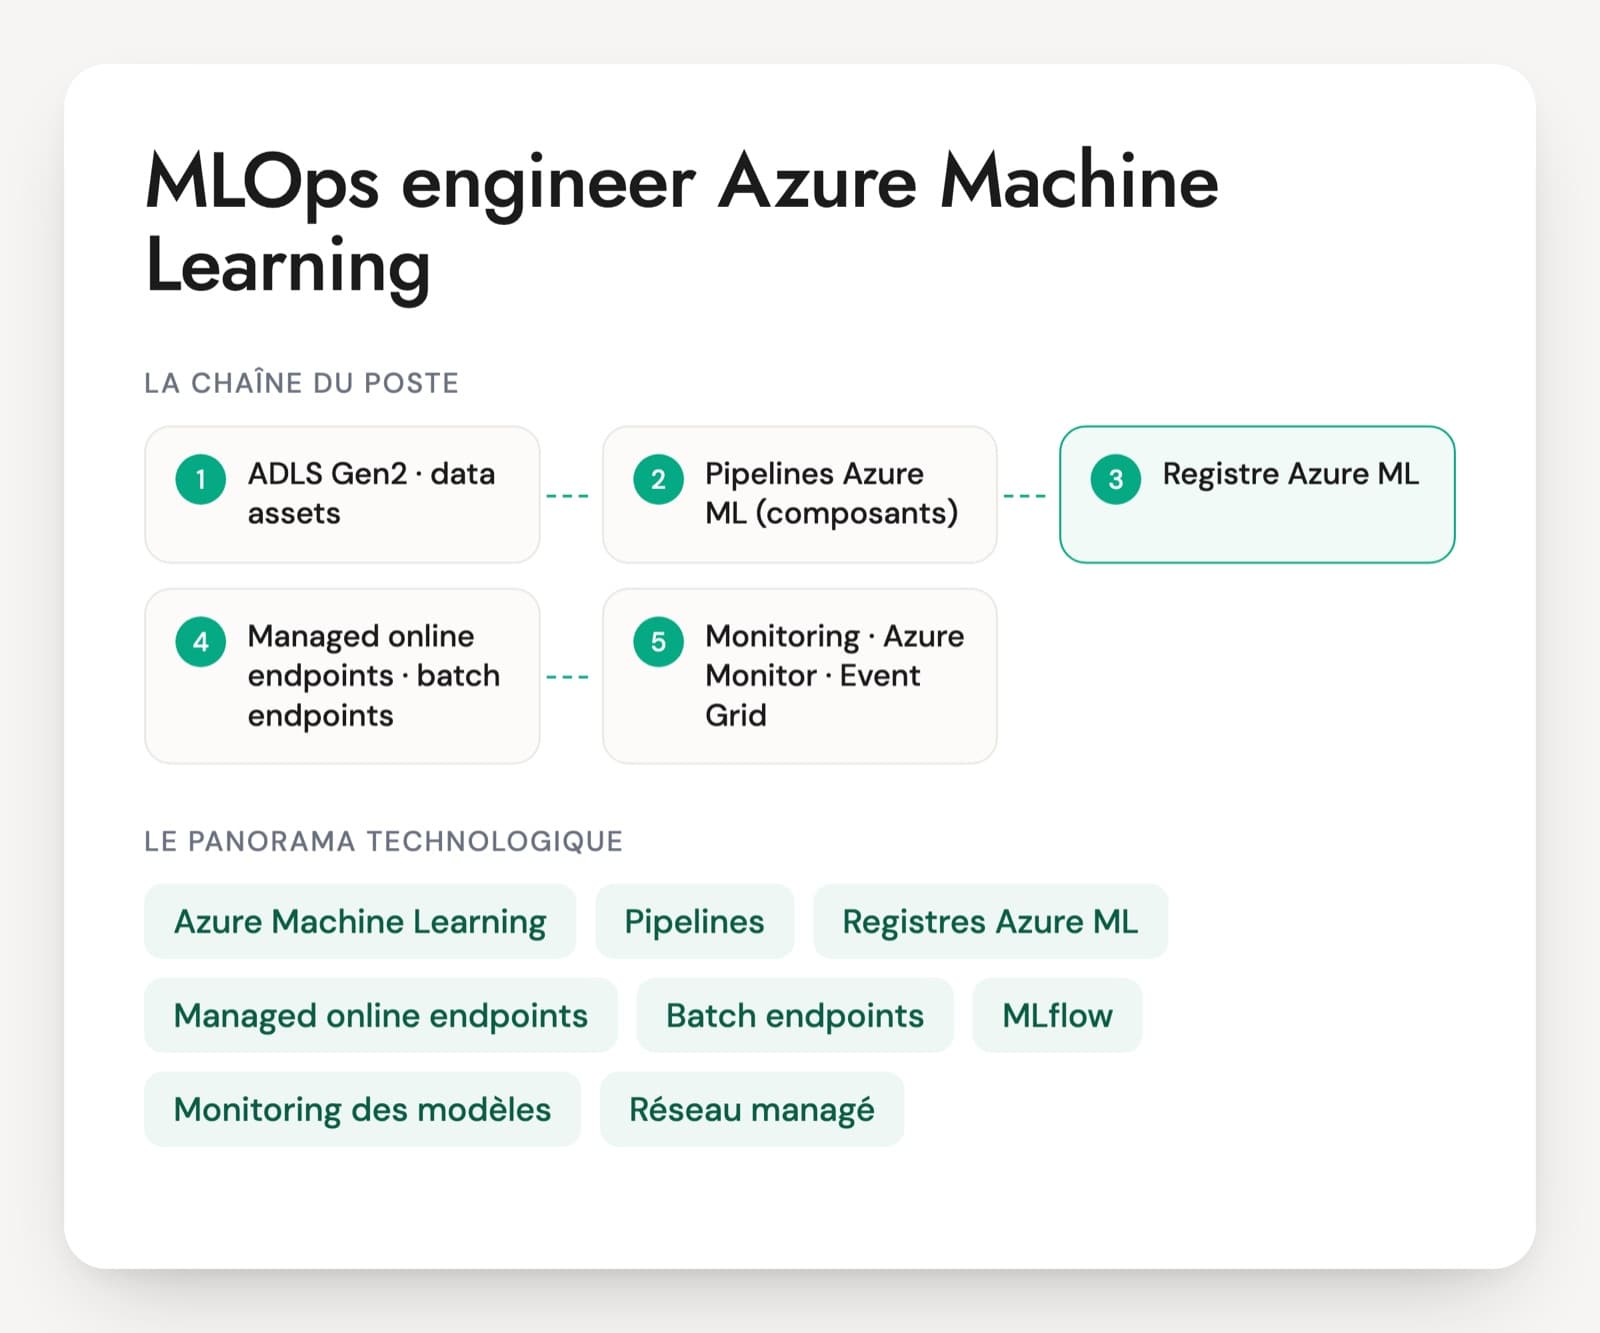
Un MLOps engineer Azure Machine Learning fait passer les modèles des data scientists du notebook à la production. Il écrit les pipelines et les composants, range les modèles dans des registres, les déploie sur des managed online endpoints ou des batch endpoints et surveille leur dérive. Le poste se trouve surtout dans les grands comptes et les ESN partenaires de Microsoft, où la sécurité réseau et les identités Entra ID pèsent autant que le machine learning.
Deux profils se ressemblent sur le papier. L'un a monté des pipelines dans le studio pour un projet pilote. L'autre a tenu des modèles en production derrière un réseau privé, avec plusieurs workspaces et une CI. La différence s'entend vite sur des sujets concrets : la fin de support du SDK v1, les registres partagés entre abonnements, le trafic en miroir, le quota réservé aux mises à jour ou le monitoring incompatible avec certains réglages réseau.
Workspaces derrière un réseau privé, projets encore sur le SDK v1 : ces deux réponses du manager fixent le niveau attendu. Le PDF reprend un modèle de priorisation de dossiers déployé dans un réseau fermé.
Les services Azure qu'un MLOps engineer configure et exploite
Azure Machine Learning (workspace, CLI et SDK v2)
Le service de Microsoft pour entraîner, déployer et surveiller des modèles. Tout s'organise dans un workspace, piloté par le studio web, le CLI v2 (az ml) ou le SDK Python azure-ai-ml. Le support du CLI v1 a pris fin le 30 septembre 2025 et celui du SDK v1 le 30 juin 2026, donc un existant en v1 est à migrer.
Pipelines, composants et environnements
Un pipeline enchaîne des composants, chacun décrit en YAML avec ses entrées, ses sorties, son code et son environnement. L'environnement fixe l'image Docker et les dépendances, pour que l'entraînement tourne pareil partout. Les jobs s'exécutent sur des clusters de calcul ou en calcul serverless, sans cluster à gérer.
Registres Azure ML
Un registre range modèles, environnements, composants et données hors des workspaces, pour que plusieurs workspaces, abonnements ou régions s'en servent. C'est l'outil prévu pour faire passer un modèle du développement à la production. Demandez à la personne comment elle s'en sert, ou comment elle s'en passe.
Managed online endpoints
Le service recommandé pour exposer un modèle en temps réel. Un endpoint porte plusieurs déploiements, entre lesquels on répartit le trafic pour une bascule progressive, avec en option une copie du trafic vers la nouvelle version. Azure gère les machines, les mises à jour et la mise à l'échelle automatique.
Batch endpoints
Le pendant pour les traitements par lots. Un job lancé à la demande ou planifié score un gros volume de données sur un cluster qui démarre puis s'arrête. C'est souvent le bon choix pour un score recalculé chaque nuit.
MLflow
Le workspace Azure ML sert de serveur de suivi MLflow : paramètres, métriques et modèles s'y enregistrent avec l'API MLflow standard. Un modèle au format MLflow se déploie sans écrire de script de scoring. La plupart des offres le citent, à côté d'Azure ML.
Monitoring des modèles
Des moniteurs planifiés comparent les données de production à une référence : dérive des entrées et des prédictions, qualité des données, attribution des features (en preview), performance quand la vérité terrain est disponible. Les alertes partent par e-mail ou par Event Grid, qui peut lancer un réentraînement.
Réseau managé, identités et Entra ID
Le réseau virtuel managé isole le workspace, avec un mode qui n'autorise que les sorties approuvées. Les jobs et les endpoints accèdent au stockage et au Key Vault par des identités managées, et les utilisateurs se connectent avec Entra ID. C'est là que se jouent la plupart des difficultés de mise en production chez les grands comptes.
Azure DevOps, GitHub Actions, Bicep ou Terraform
La CI construit les environnements, lance les tests, soumet les pipelines et promeut les modèles. Bicep ou Terraform décrivent les workspaces, le réseau et les droits. Les offres françaises demandent l'un ou l'autre de ces outils, rarement aucun.
Le MLOps engineer Azure ML travaille le plus souvent dans un groupe déjà équipé en Microsoft : Entra ID, Azure DevOps, abonnements séparés par environnement, politique réseau stricte. En ESN, la mission consiste souvent à faire passer des projets pilotes en production chez le client, ou à migrer du SDK v1 vers le v2. Le poste voisine avec Microsoft Foundry (anciennement Azure AI Foundry), qui porte les projets d'IA générative : certaines offres demandent les deux. Microsoft a retiré en juin 2026 la certification Azure Data Scientist Associate (DP-100). La certification Machine Learning Operations Engineer Associate (examen AI-300), qui couvre Azure ML et Microsoft Foundry, colle mieux au poste ; l'expérience de production reste à vérifier en entretien.
Ce qu'un entretien MLOps sur Azure ML doit permettre de trancher
- Pipelines, composants et environnements (CLI et SDK v2)
- Registres Azure ML et promotion entre workspaces
- Managed online endpoints et batch endpoints
- Monitoring des modèles en production
- Réseau managé, identités managées et Entra ID
- CI/CD et infrastructure as code
Cinq sujets de production à creuser avec un MLOps engineer Azure ML
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Vous reprenez un projet Azure ML écrit avec le SDK v1 (azureml-core). Que faites-vous, et par quoi commencez-vous ?
Une bonne réponseIl sait que le support du CLI v1 a pris fin le 30 septembre 2025 et celui du SDK v1 le 30 juin 2026 : le code tourne encore, mais sans correctifs. Il inventorie les scripts, puis migre vers le SDK azure-ai-ml et le CLI v2 : les ScriptRunConfig deviennent des command jobs, les pipelines à base de PythonScriptStep deviennent des pipelines de composants, les déploiements ACI ou AKS v1 passent sur des managed online endpoints. Des tests comparent les prédictions avant et après.
Signal d'alerte« Ça marche encore, on n'y touche pas. » Ou une réécriture complète lancée sans inventaire ni test de non-régression.
Question 2 · confirmé
Votre organisation a un workspace Azure ML de développement et un de production, dans deux abonnements. Comment un modèle passe-t-il de l'un à l'autre ?
Une bonne réponsePar un registre Azure ML, qui sert de dépôt commun aux workspaces, un peu comme un dépôt Git pour les assets. Le modèle candidat y est publié depuis le job d'entraînement, puis déployé sur un endpoint du workspace de production. Les composants et les environnements y sont aussi rangés, ce qui permet de rejouer le même pipeline en production sur les données de production. Le lien vers le job d'origine reste consultable, et les droits sur le registre sont distincts de ceux des workspaces.
Signal d'alerteTélécharger le fichier du modèle et le recharger à la main en production. Ou donner aux data scientists des droits d'écriture sur le workspace de production.
Question 3 · confirmé
Une nouvelle version d'un modèle doit remplacer l'actuelle sur un managed online endpoint. Décrivez votre mise en production.
Une bonne réponseDeux déploiements sous le même endpoint, l'ancien et le nouveau (bleu et vert). Le nouveau démarre à 0 % du trafic et se teste directement avec l'en-tête azureml-model-deployment. Puis un trafic en miroir copie une part des requêtes vers lui sans renvoyer ses réponses aux clients, avant une montée progressive et la suppression de l'ancien. Il suit latence et erreurs par déploiement dans Azure Monitor, et vérifie que le quota de cœurs tient les deux déploiements à la fois.
Signal d'alerteSupprimer l'endpoint et le recréer, ce qui change l'URL et casse les appels. Ou une mise à jour en place sans possibilité de revenir en arrière.
Question 4 · confirmé
Comment mettez-vous en place la surveillance d'un modèle de scoring servi sur un managed online endpoint ?
Une bonne réponseIl active la collecte des données d'inférence sur le déploiement, puis un moniteur Azure ML planifié : dérive des entrées comparée aux données d'entraînement, dérive des prédictions comparée aux données de validation, qualité des données, et performance réelle quand la vérité terrain arrive. Les fenêtres de production et de référence ne se chevauchent pas, et les alertes peuvent passer par Event Grid. La latence et les erreurs se suivent à part, dans Azure Monitor.
Signal d'alerteUne surveillance réduite au CPU et à la latence, ou des métriques regardées une fois par trimestre.
Question 5 · senior
Le RSSI exige qu'aucun flux sortant d'un workspace Azure ML ne parte vers internet. Que configurez-vous ?
Une bonne réponseLe réseau virtuel managé en mode allow_only_approved_outbound, avec des private endpoints vers le stockage, le Key Vault et le registre de conteneurs. L'accès public au workspace est coupé et l'entrée passe par son private endpoint. Chaque besoin sortant devient une règle explicite, sachant que les règles FQDN s'appuient sur Azure Firewall et s'ajoutent à la facture. Il anticipe les effets de bord : paquets Python à installer, premier calcul plus long à provisionner, monitoring des modèles non pris en charge dans ce mode.
Signal d'alerte« On ajoute un NSG et c'est bon », ou aucune idée de ce qui casse quand la sortie internet est coupée.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Recrutement MLOps sur Azure : les réponses aux points qui bloquent
Qu'attendre d'un MLOps engineer Azure Machine Learning au-delà du studio ?
Le studio suffit pour un projet pilote. En production, attendez le CLI ou le SDK v2, des pipelines en composants versionnés, des registres pour passer d'un workspace à l'autre, des managed online endpoints avec bascule progressive et une surveillance de dérive. Ajoutez le réseau managé, les identités managées, une CI Azure DevOps ou GitHub et Bicep ou Terraform. Un profil qui ne connaît que les clics dans l'interface aura du mal sur ces sujets.
Un CV qui cite surtout le SDK v1 d'Azure ML doit-il vous inquiéter ?
Pas forcément, beaucoup de projets ont été écrits avant le v2. Le support du CLI v1 a pris fin en septembre 2025 et celui du SDK v1 le 30 juin 2026. Vérifiez que la personne connaît l'équivalent v2 de ce qu'elle a fait : command jobs, pipelines de composants, managed online endpoints à la place d'ACI ou d'AKS v1. Si elle a déjà mené une migration, c'est un atout pour un existant à reprendre.
La certification DP-100 a-t-elle encore du poids ?
Microsoft a retiré en juin 2026 la certification Azure Data Scientist Associate, obtenue avec l'examen DP-100, au profit de la Machine Learning Operations Engineer Associate (AI-300). Un titulaire a étudié Azure ML, MLflow et le déploiement de modèles, ce qui reste une base utile. Elle était plus orientée data science que production. Pour un poste MLOps, interrogez plutôt la personne sur un déploiement réel, un incident d'endpoint ou une configuration réseau qu'elle a dû faire valider par la sécurité.
Comment construire un test technique pour un MLOps engineer Azure ML ?
Partez d'un dépôt court : un composant YAML, un fichier d'environnement et la définition d'un déploiement d'endpoint, avec deux ou trois erreurs volontaires (dépendance non figée, secret en clair, trafic basculé d'un coup). Demandez de les corriger en expliquant à voix haute, puis de décrire la promotion vers la production. Une heure suffit, et la discussion en dit plus qu'un projet à rendre.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.