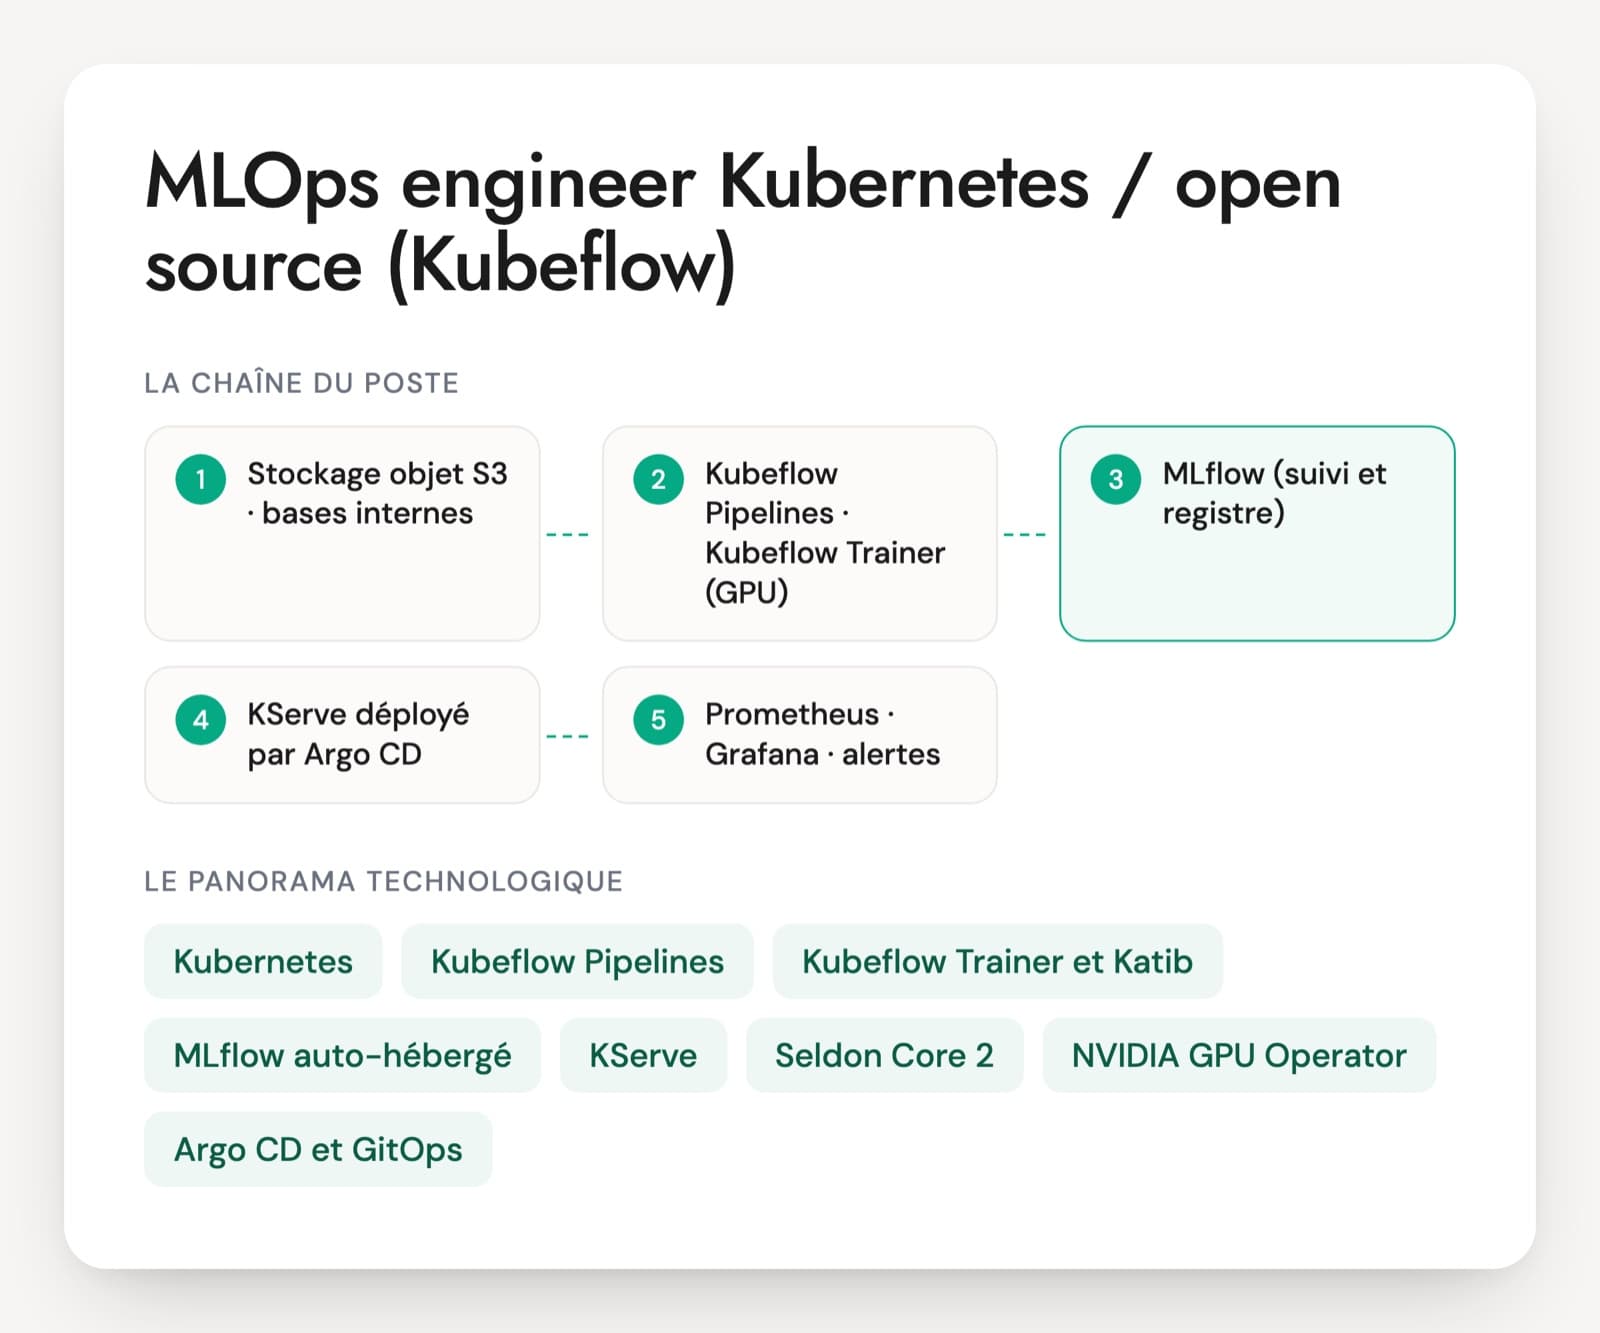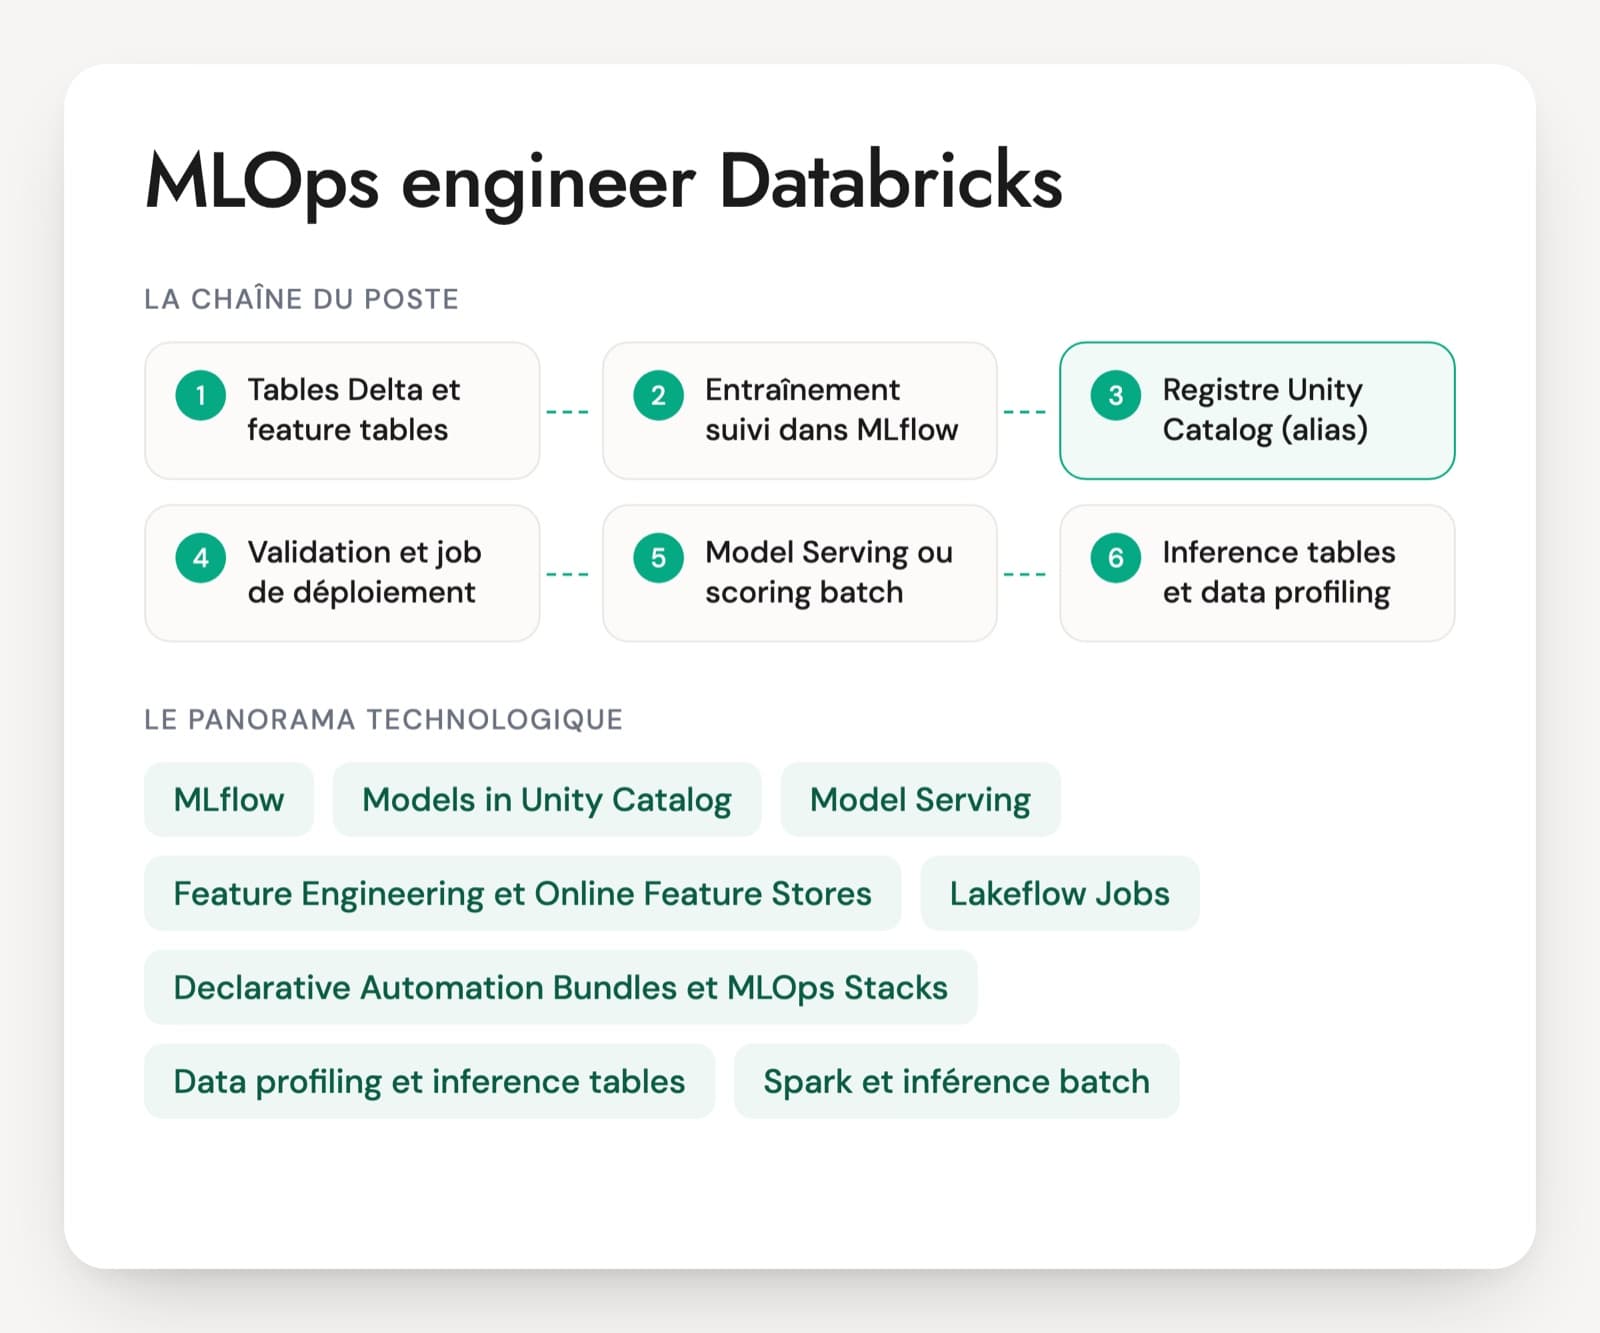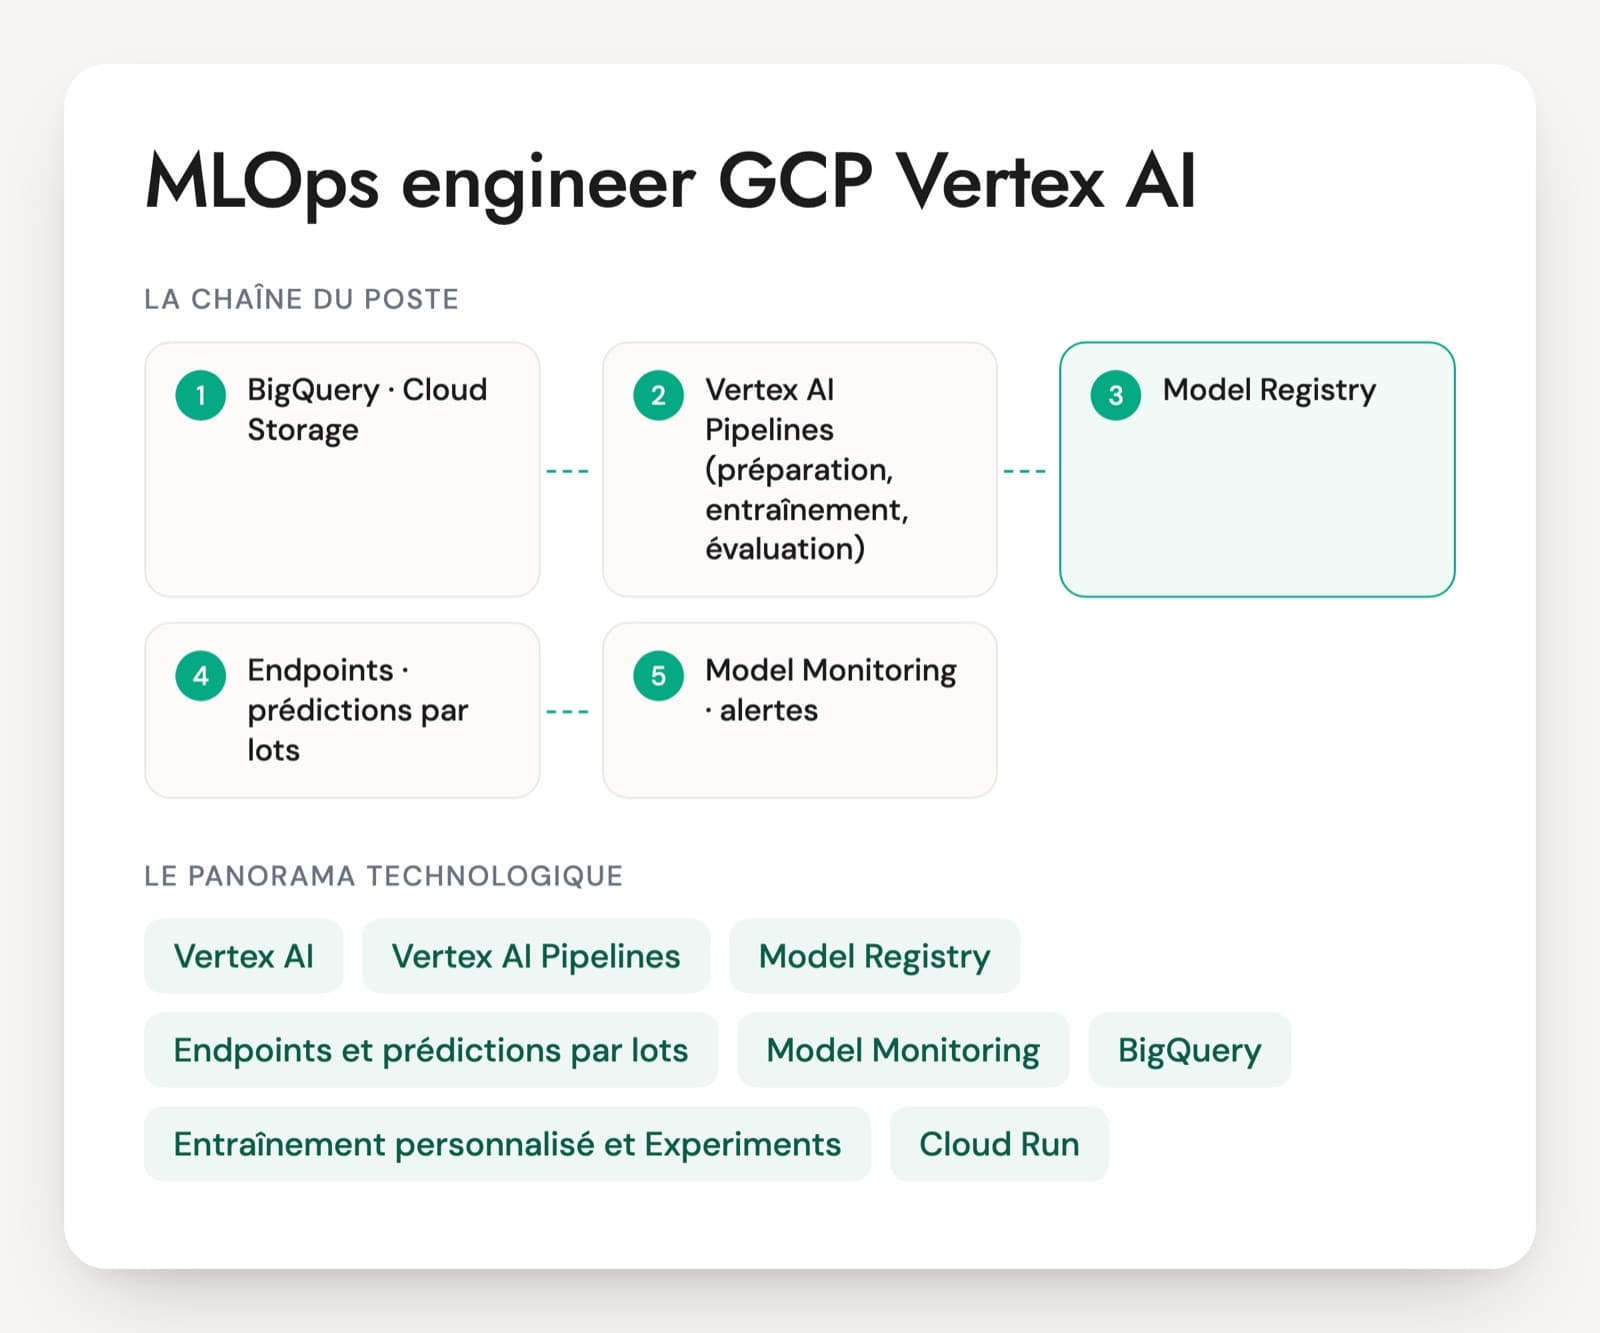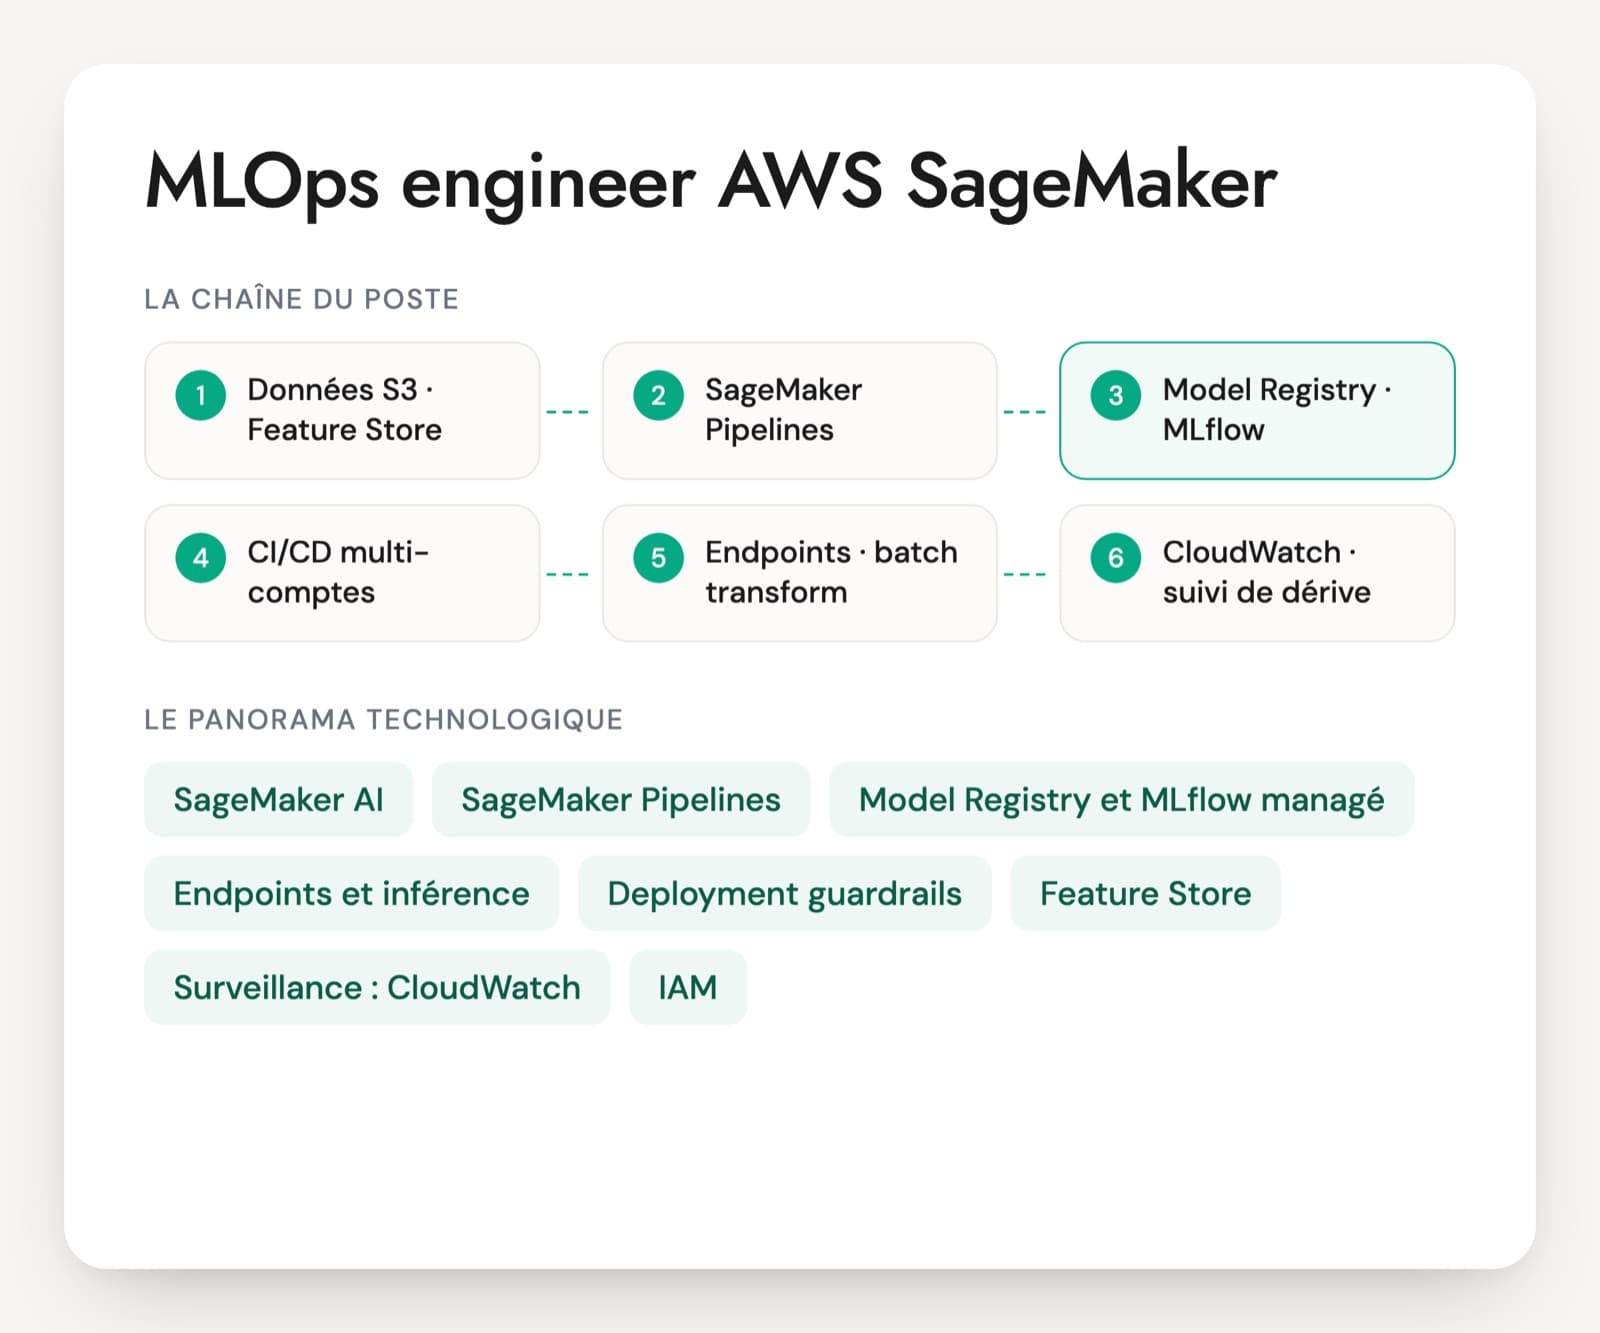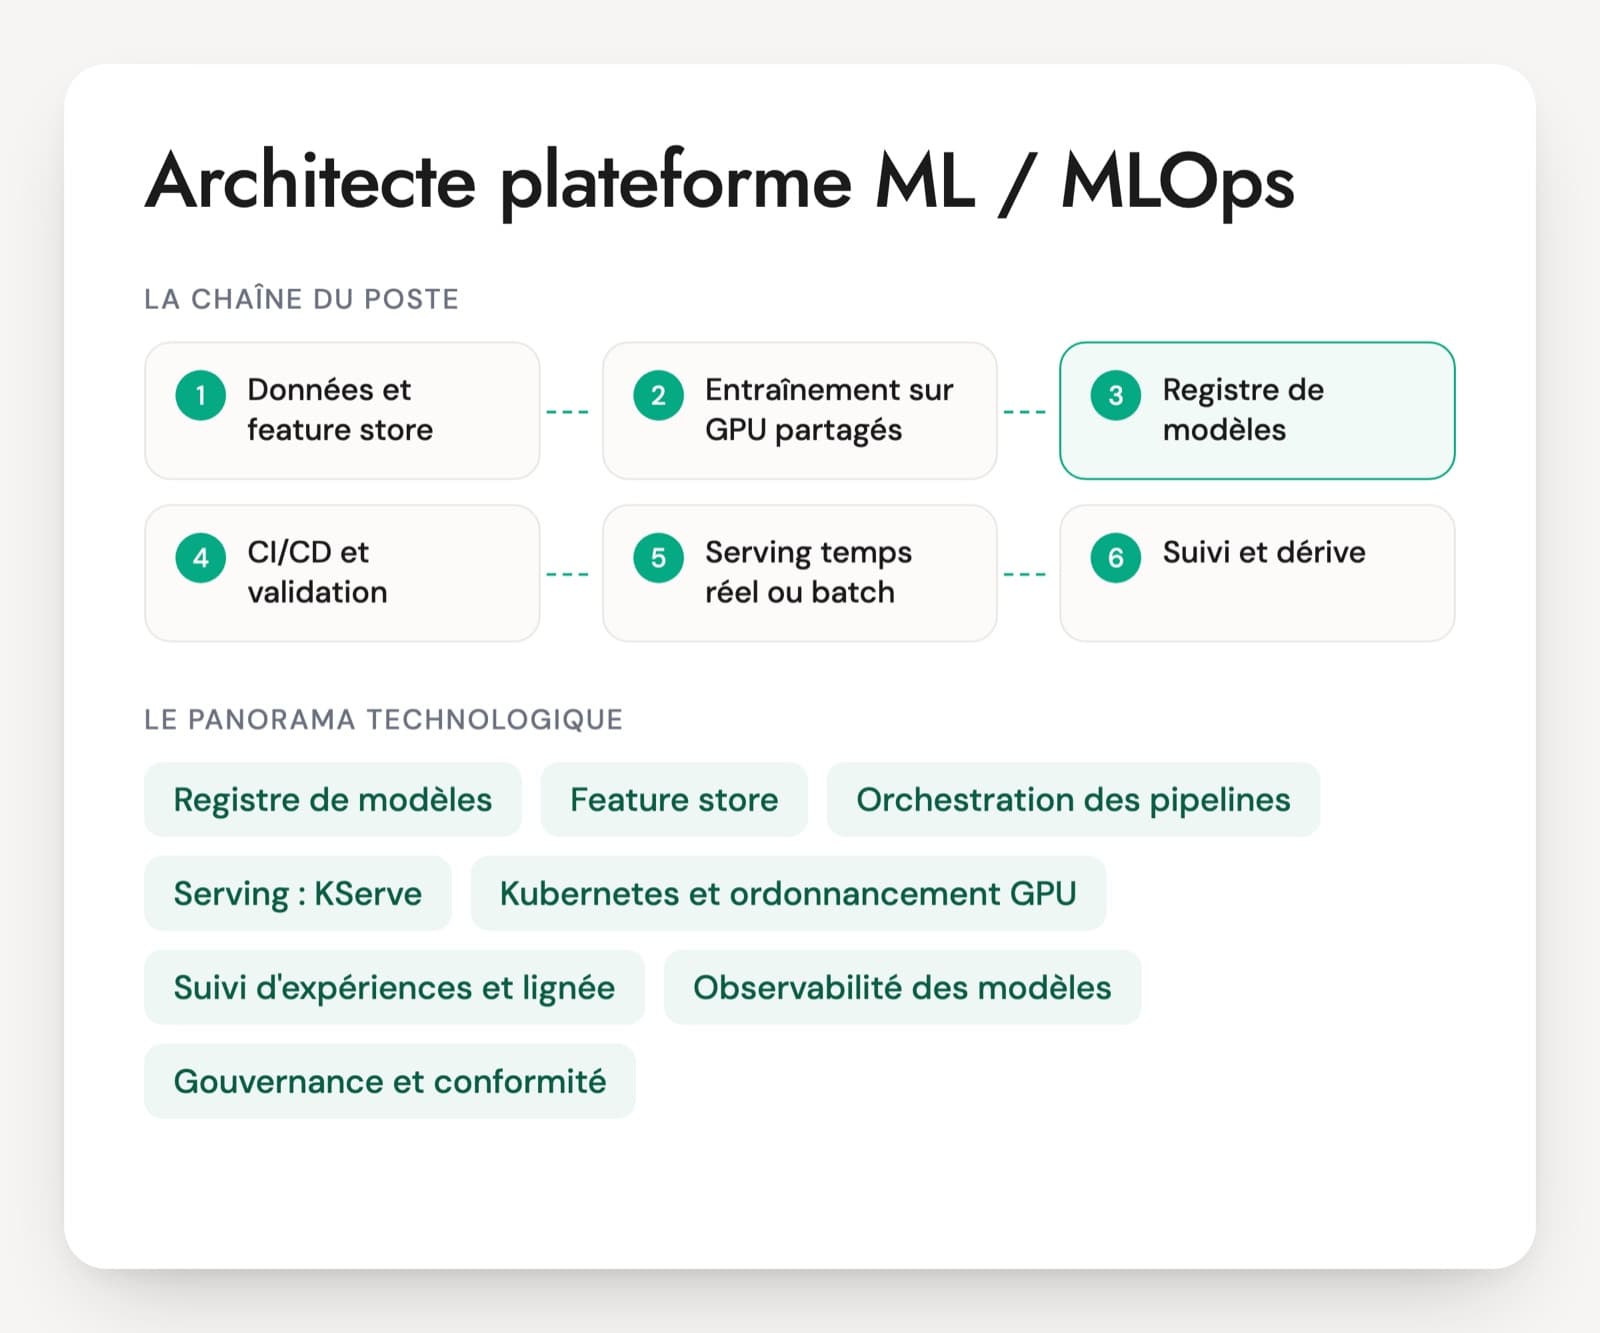
Un architecte MLOps se recrute surtout dans les grands groupes, banques, assurances et industriels, quand plusieurs équipes de data science déploient chacune à sa façon. Les questions d'entretien pour un architecte plateforme ML portent sur cette situation. Il choisit et assemble les briques communes : registre de modèles, feature store, orchestration, serving, ordonnancement des GPU, souvent sur Kubernetes ou sur Agent Platform (ex-Vertex AI), SageMaker, Azure Machine Learning ou Databricks. Il rédige les standards, accompagne les équipes et répond aux exigences de la conformité.
Beaucoup de candidats viennent d'un poste de MLOps engineer et ont industrialisé un ou deux modèles. C'est une bonne base, mais le poste demande autre chose : partager des ressources rares entre équipes, décider de ce qu'on standardise, tenir un audit sur un modèle vieux de deux ans, arbitrer entre cloud managé et auto-hébergement. Un CV chargé d'outils ne dit pas si la personne a déjà fait ces choix ni comment elle les a fait adopter.
Construire une plateforme de zéro et reprendre une plateforme contestée demandent deux profils différents. Le manager doit donc préciser avant l'entretien si elle existe déjà et combien d'équipes l'utiliseront. Le cas proposé porte sur la plateforme commune d'un groupe à cinq équipes.
Les briques d'une plateforme ML d'entreprise
Registre de modèles
Le point d'entrée de la production. Chaque version de modèle y est enregistrée avec son code, ses données, ses métriques et son statut. MLflow, Unity Catalog, le Model Registry de Gemini Enterprise Agent Platform (ex-Vertex AI) ou SageMaker Model Registry jouent ce rôle. Le déploiement lit le registre, jamais un fichier posé à la main.
Feature store
Le stockage partagé des variables calculées pour les modèles. Il sert les mêmes définitions à l'entraînement (stockage offline) et en production (stockage online, à faible latence), avec des jointures à date pour éviter les fuites d'information. Feast est la référence open source, les clouds et Databricks ont le leur.
Orchestration des pipelines
Les pipelines d'entraînement et de réentraînement s'enchaînent dans Kubeflow Pipelines, Airflow, Agent Platform Pipelines (ex-Vertex AI Pipelines) ou SageMaker Pipelines. L'architecte choisit un orchestrateur commun et fournit des modèles de pipelines que les équipes réutilisent.
Serving : KServe, Triton, vLLM
Les outils qui exposent un modèle en service. KServe déploie sur Kubernetes avec autoscaling, Triton sert plusieurs modèles et frameworks sur GPU, vLLM sert les LLM open source. Les services managés des clouds font la même chose sans cluster à gérer.
Kubernetes et ordonnancement GPU
La plupart des plateformes auto-hébergées tournent sur Kubernetes. Le GPU Operator de NVIDIA installe les pilotes, MIG découpe un GPU en morceaux isolés, Kueue ou Run:ai gèrent quotas, files d'attente et priorités entre équipes. Les GPU coûtent cher, et leur partage est souvent la première demande de la direction.
Suivi d'expériences et lignée
MLflow Tracking ou Weights & Biases gardent les paramètres et les résultats de chaque entraînement. Avec des données versionnées (Delta Lake, Iceberg, DVC), on peut dire avec quelles données un modèle a été construit et le refaire.
Observabilité des modèles
Après la mise en ligne, la plateforme suit la latence, les erreurs, la dérive des données d'entrée et la performance quand les vraies valeurs arrivent. Prometheus et Grafana pour le technique, Evidently ou les outils des clouds pour la dérive.
Gouvernance et conformité
Fiches de modèle, approbations, journaux des décisions, droits d'accès aux données. Dans la banque et l'assurance, la validation indépendante des modèles l'impose déjà. L'AI Act ajoute des obligations de documentation et de traçabilité pour les systèmes à haut risque.
Le titre recouvre des postes assez différents. Dans un grand groupe, l'architecte plateforme ML rejoint une équipe plateforme ou un centre d'expertise IA, conçoit le socle et le fait adopter par des équipes qui ont déjà leurs habitudes. En ESN ou en cabinet, il conçoit des plateformes pour des clients et doit vite comprendre leurs contraintes de sécurité et de cloud. Les offres françaises associent souvent le poste à un cloud précis (AWS, Azure, Google Cloud) ou à un hébergement interne sur Kubernetes ou OpenShift, et désormais souvent aux LLM et aux GPU. Le niveau attendu est senior : une expérience de MLOps engineer ou de platform engineer avant, et une connaissance de la conformité des modèles dans les secteurs réglementés. Les certifications des clouds attestent la connaissance d'un fournisseur. La conception d'une plateforme pour plusieurs équipes se vérifie en entretien.
Ce qu'un architecte plateforme ML doit savoir concevoir
- Architecture MLOps de référence
- Registre et cycle de vie des modèles
- Feature store et cohérence entraînement/service
- Serving et inférence à l'échelle
- Ordonnancement et partage des GPU
- Gouvernance, traçabilité et isolation des équipes
Cinq questions d'architecture pour un candidat MLOps senior
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · senior
Cinq équipes de data science travaillent chacune avec ses outils. On vous demande une plateforme commune. Que standardisez-vous d'abord, et que laissez-vous libre ?
Une bonne réponseIl standardise le contrat de sortie : format et métadonnées du modèle dans un registre unique, image de conteneur, chemin de déploiement par CI, identités et droits, journaux et métriques. Il laisse libres les notebooks, les bibliothèques et les frameworks d'entraînement, dans des images de base maintenues par la plateforme. Il commence par recenser ce qui tourne déjà et propose un chemin standard plus simple que les bricolages existants, pour que les équipes l'adoptent d'elles-mêmes.
Signal d'alerte« On installe Kubeflow pour tout le monde » sans parler de contrat ni d'adoption, ou un framework maison qui impose sa façon d'écrire chaque modèle.
Question 2 · confirmé à senior
Un modèle de scoring affiche de bons résultats en validation et se dégrade dès la mise en production. Les features temps réel sont recalculées par une autre équipe. Que soupçonnez-vous, et que proposez-vous côté plateforme ?
Une bonne réponseUn écart entre entraînement et service (training-serving skew) : deux codes différents pour la même feature, ou des données d'entraînement jointes sans respecter le temps, avec des valeurs qui n'existaient pas encore au moment de la décision. Côté plateforme : une définition unique des features dans un feature store, avec un stockage offline pour l'entraînement et online pour le service, des jointures à date (point-in-time) et une journalisation des features servies pour les comparer à celles de l'entraînement.
Signal d'alerte« Il faut réentraîner plus souvent », ou renvoyer le problème au data scientist sans regarder la chaîne de données.
Question 3 · senior
Vous avez 32 GPU pour l'entraînement et l'inférence de dix équipes. Ils sont réservés toute la journée et utilisés à 20 %. Que mettez-vous en place ?
Une bonne réponseD'abord la mesure, par pod et par équipe, avec l'exportateur DCGM. Puis des quotas par équipe avec une file d'attente (Kueue, Volcano ou Run:ai), un emprunt de capacité entre équipes et la préemption des jobs de faible priorité, qui doivent reprendre depuis un checkpoint. Le partage par MIG ou time-slicing pour les notebooks et les petits modèles. Des pools séparés pour l'inférence, sensible à la latence, et pour l'entraînement. Et un rapport de consommation par équipe.
Signal d'alerte« Il faut acheter des GPU », un GPU attribué à chaque data scientist, ou du time-slicing sur un service de production sans parler d'isolation.
Question 4 · confirmé à senior
Comment un modèle passe-t-il de l'expérimentation à la production sur votre plateforme, et qui a le droit de le promouvoir ?
Une bonne réponseUne version dans le registre qui porte sa lignée : commit du code, version des données, paramètres, métriques, image. Des contrôles automatiques avant promotion : performance sur un jeu de référence, contrat d'entrée, tests de biais si le cas l'exige. Une approbation par une autre personne que l'auteur pour les modèles sensibles, un déploiement par CI ou GitOps qui lit un alias du registre (champion, challenger), un retour à la version précédente en une opération. Tout est tracé.
Signal d'alerteUn fichier pickle copié sur un serveur, ou un data scientist qui déploie depuis son poste avec ses propres droits.
Question 5 · confirmé
Un modèle doit répondre en moins de 50 ms à 2 000 requêtes par seconde, un autre tourne une fois par nuit sur 30 millions de lignes. Les servez-vous de la même façon ?
Une bonne réponseNon. Le premier passe par un service en ligne (KServe, Triton ou équivalent managé) avec des réplicas chauds, un autoscaling sur la charge, des features lues dans le stockage online, éventuellement du batching dynamique, et un suivi de la latence au 99e centile. Le second est un job batch (Spark, Ray) qui charge le modèle depuis le registre et écrit ses prédictions dans une table, sans endpoint. Il chiffre le coût de chaque option.
Signal d'alerteUne seule API REST pour les deux usages, avec une boucle qui appelle l'API 30 millions de fois.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Recruter un architecte MLOps : vos questions
Quelle différence entre un MLOps engineer et un architecte plateforme ML ?
Le MLOps engineer met en production des modèles précis : pipeline, déploiement, suivi. L'architecte plateforme ML conçoit le socle utilisé par plusieurs équipes et décide des standards, du partage des GPU, de la gouvernance et du choix entre cloud managé et auto-hébergement. Il doit savoir faire le travail du MLOps engineer, mais l'entretien porte surtout sur ses choix d'architecture et sur la façon dont il les a fait adopter.
Quelle expérience demander pour ce poste ?
Une expérience de mise en production de modèles, comme MLOps engineer, ML engineer ou platform engineer, et au moins une plateforme conçue ou refondue pour plusieurs équipes. Demandez des détails : nombre d'équipes servies, ce qui a été standardisé, ce qui a été abandonné, l'incident le plus marquant. Un candidat qui n'a jamais partagé de ressources entre équipes aura du mal sur les questions de GPU et d'isolation.
Quel test technique pour un architecte MLOps ?
Un exercice de conception, plus utile qu'un test technique de code. Donnez un contexte réaliste (équipes, données, cloud, contraintes réglementaires) et demandez un schéma de plateforme, avec les choix et ce qui a été écarté. Une vingtaine de minutes suffit pour voir si la personne pose les bonnes questions avant de dessiner. Le cas du PDF de cette page suit ce format.
Un architecte formé sur un autre cloud peut-il convenir ?
Oui, avec une réserve si la plateforme sera entièrement sur votre cloud, car les services ML de chaque fournisseur ont leurs limites et leurs coûts. Les principes restent les mêmes d'un cloud à l'autre : registre, feature store, serving, quotas, gouvernance. Un bon profil s'adapte vite et apprend les services du nouveau fournisseur. Vérifiez surtout qu'il connaît Kubernetes si une partie restera dans votre datacenter.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.