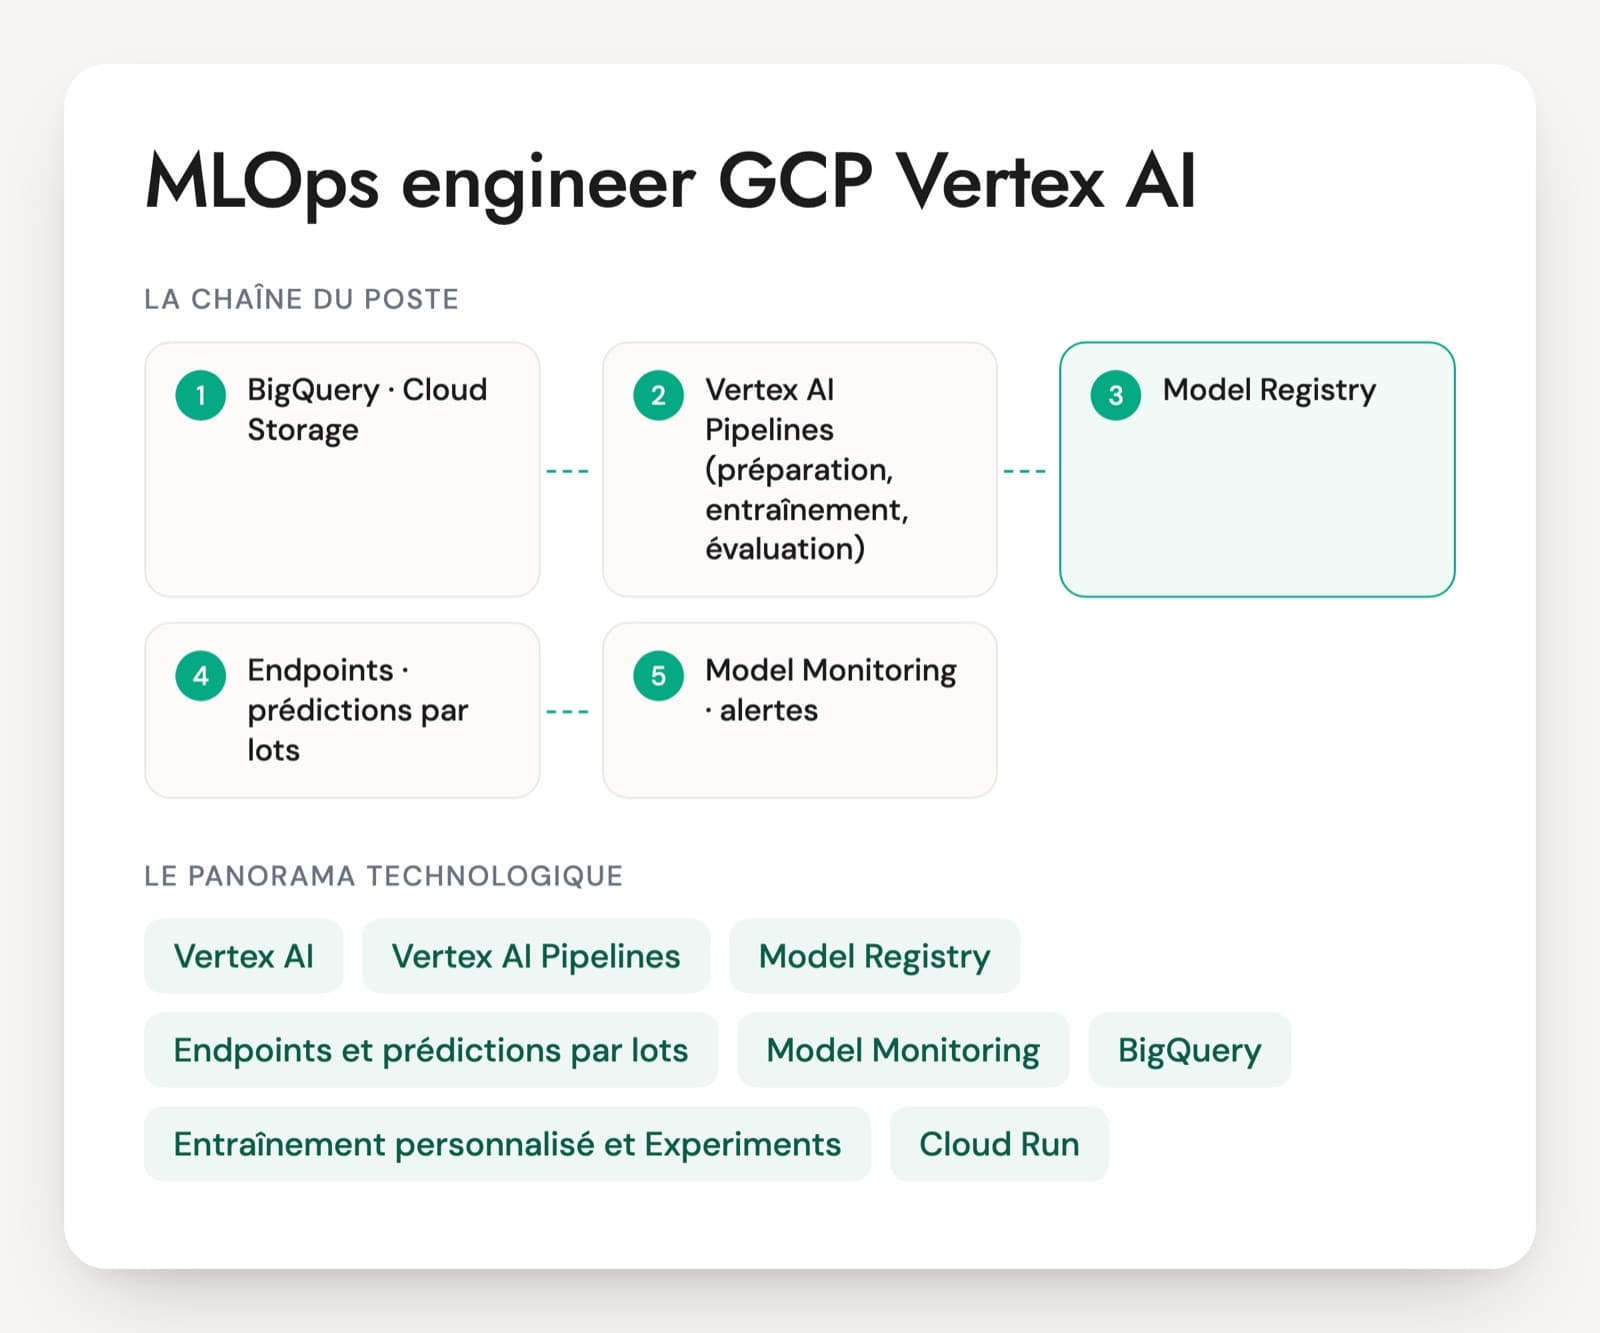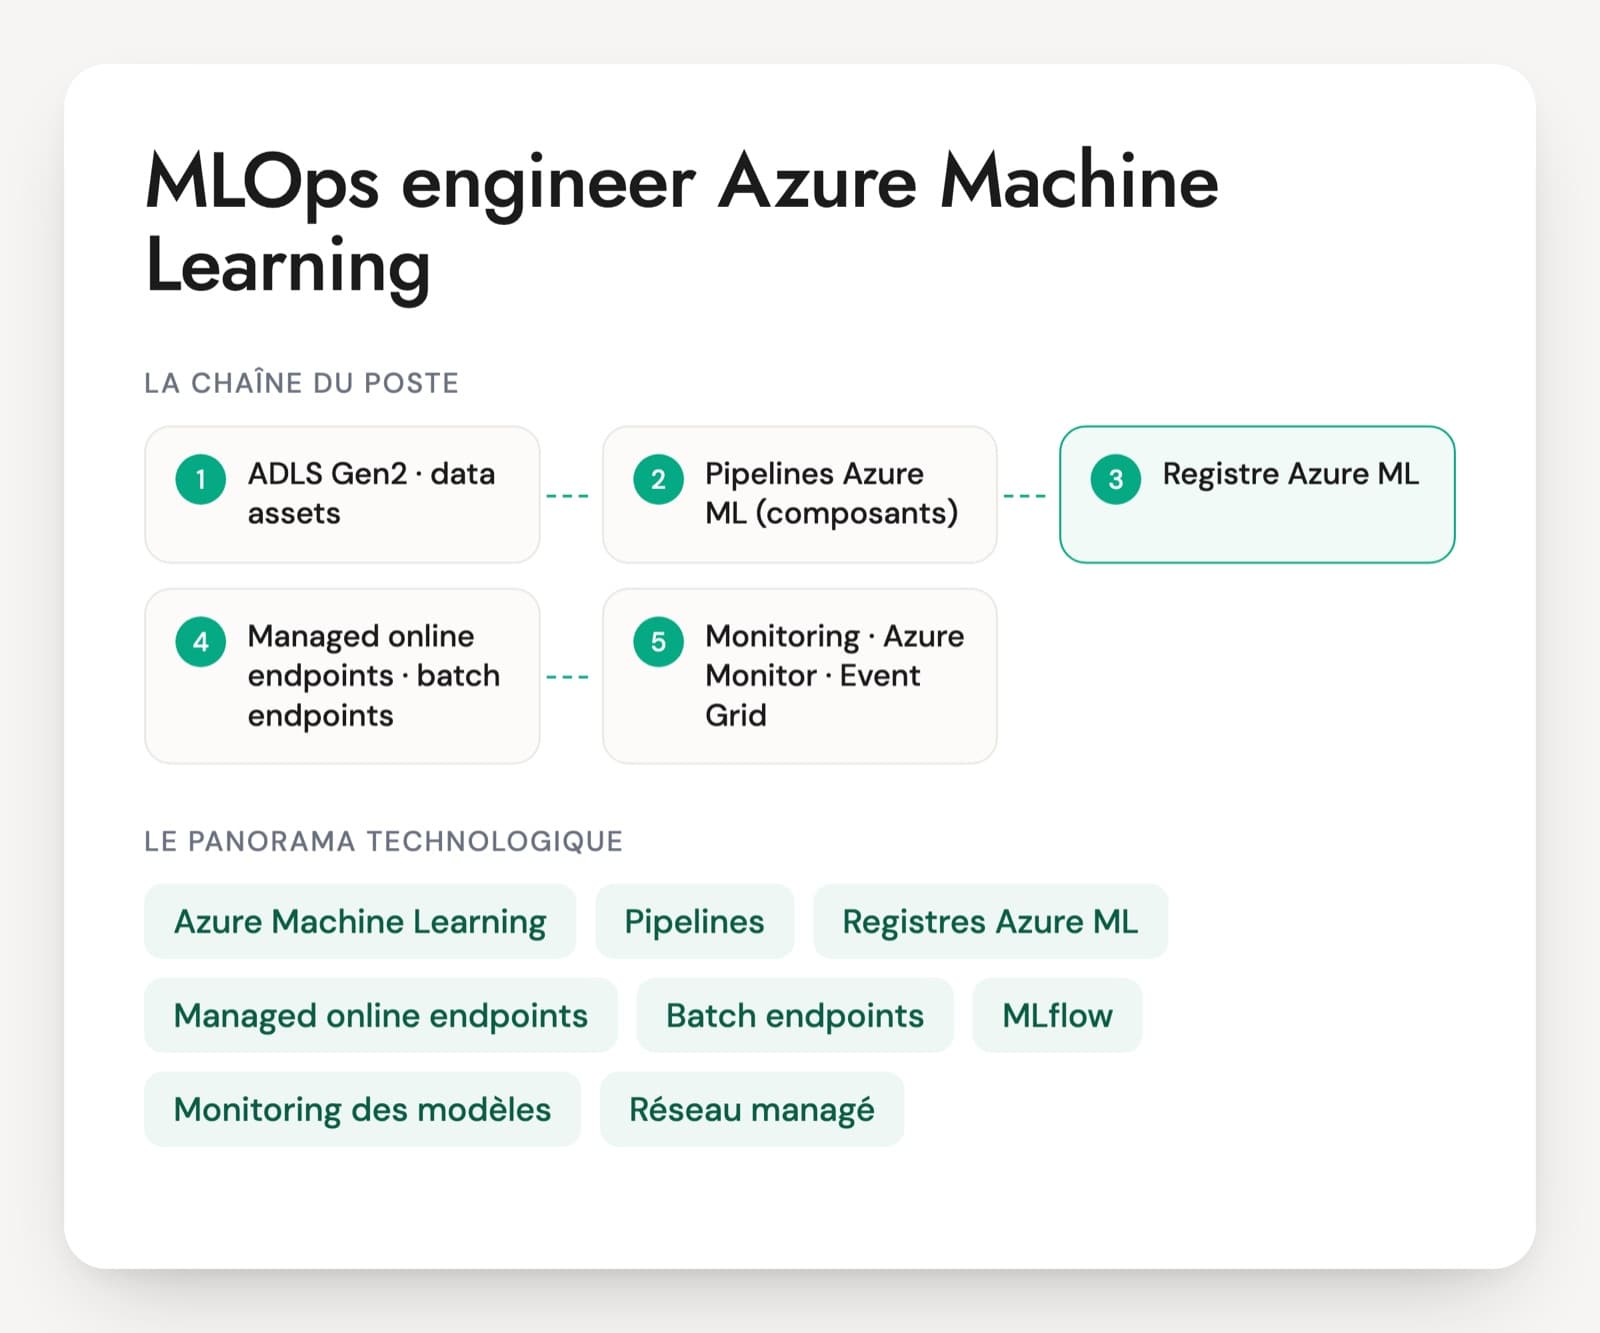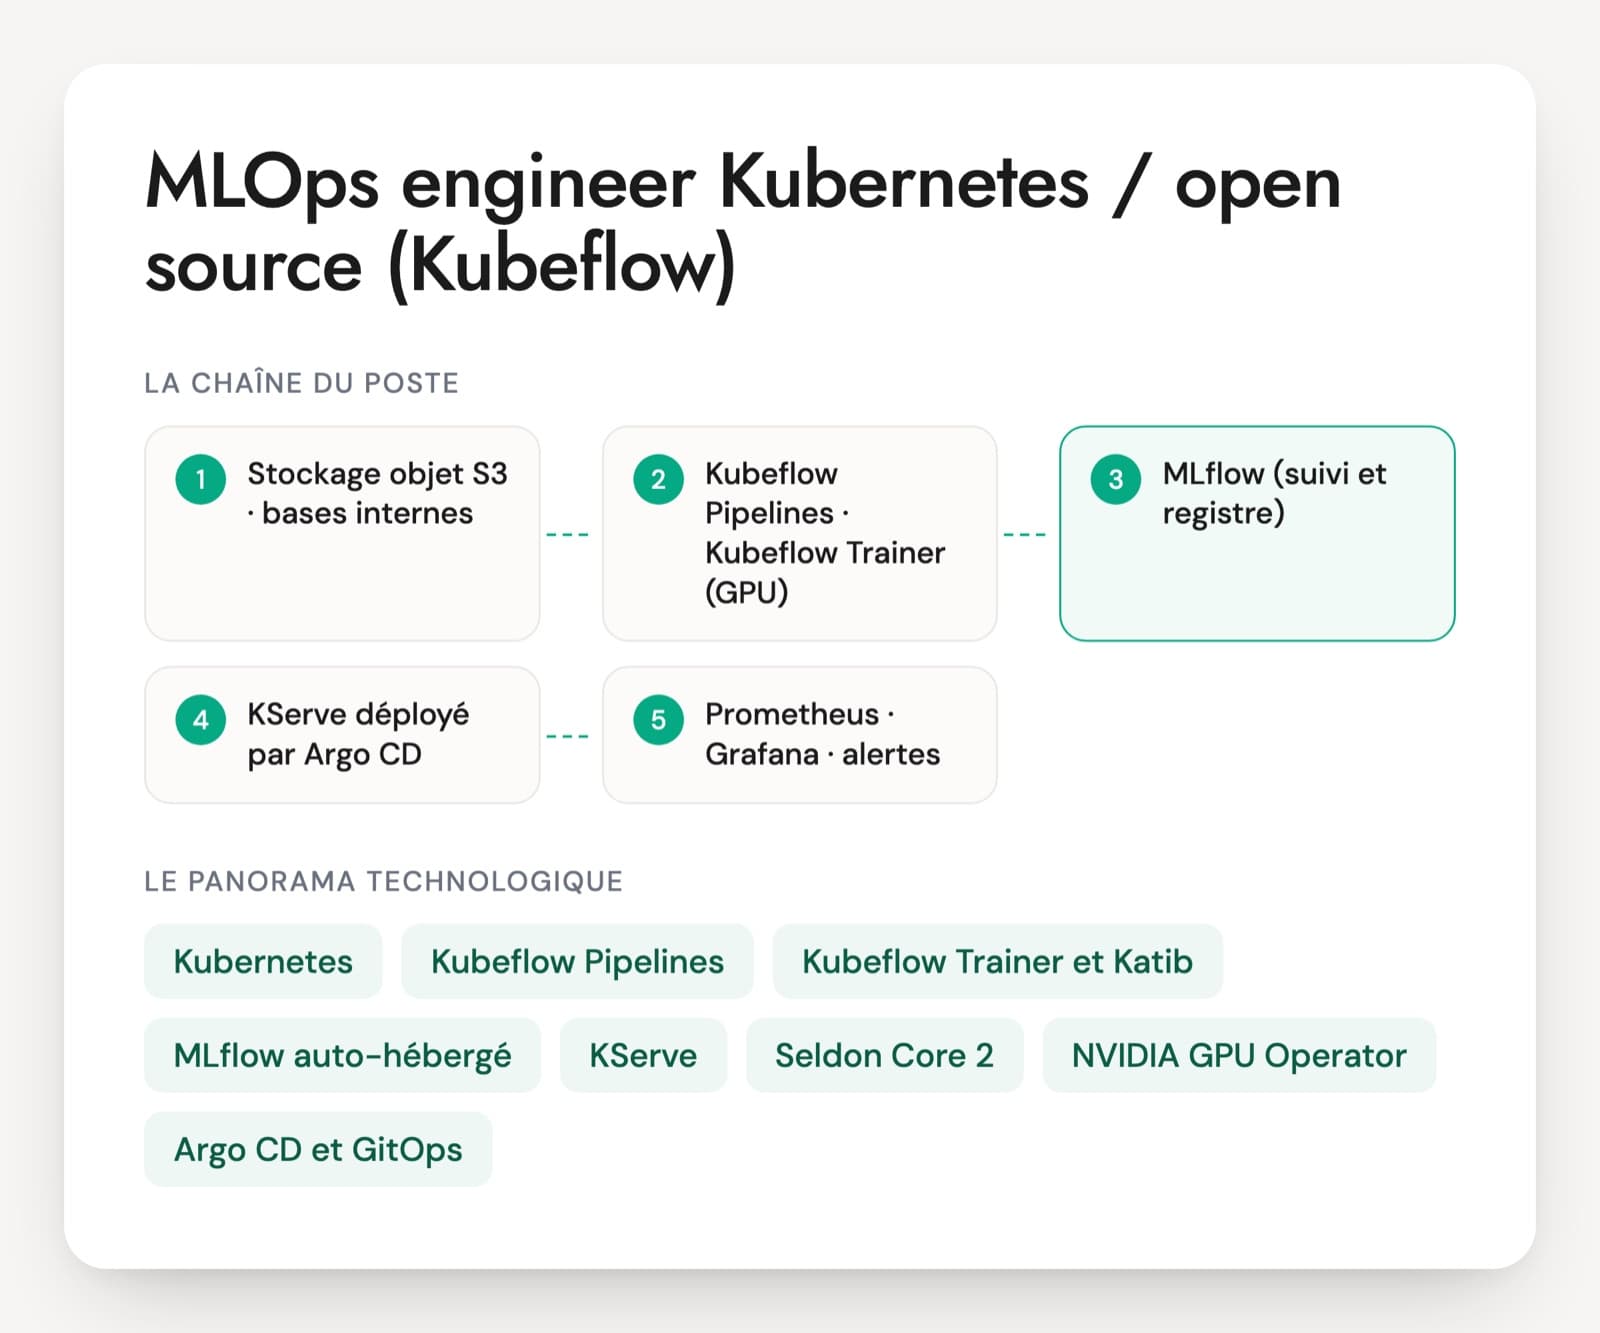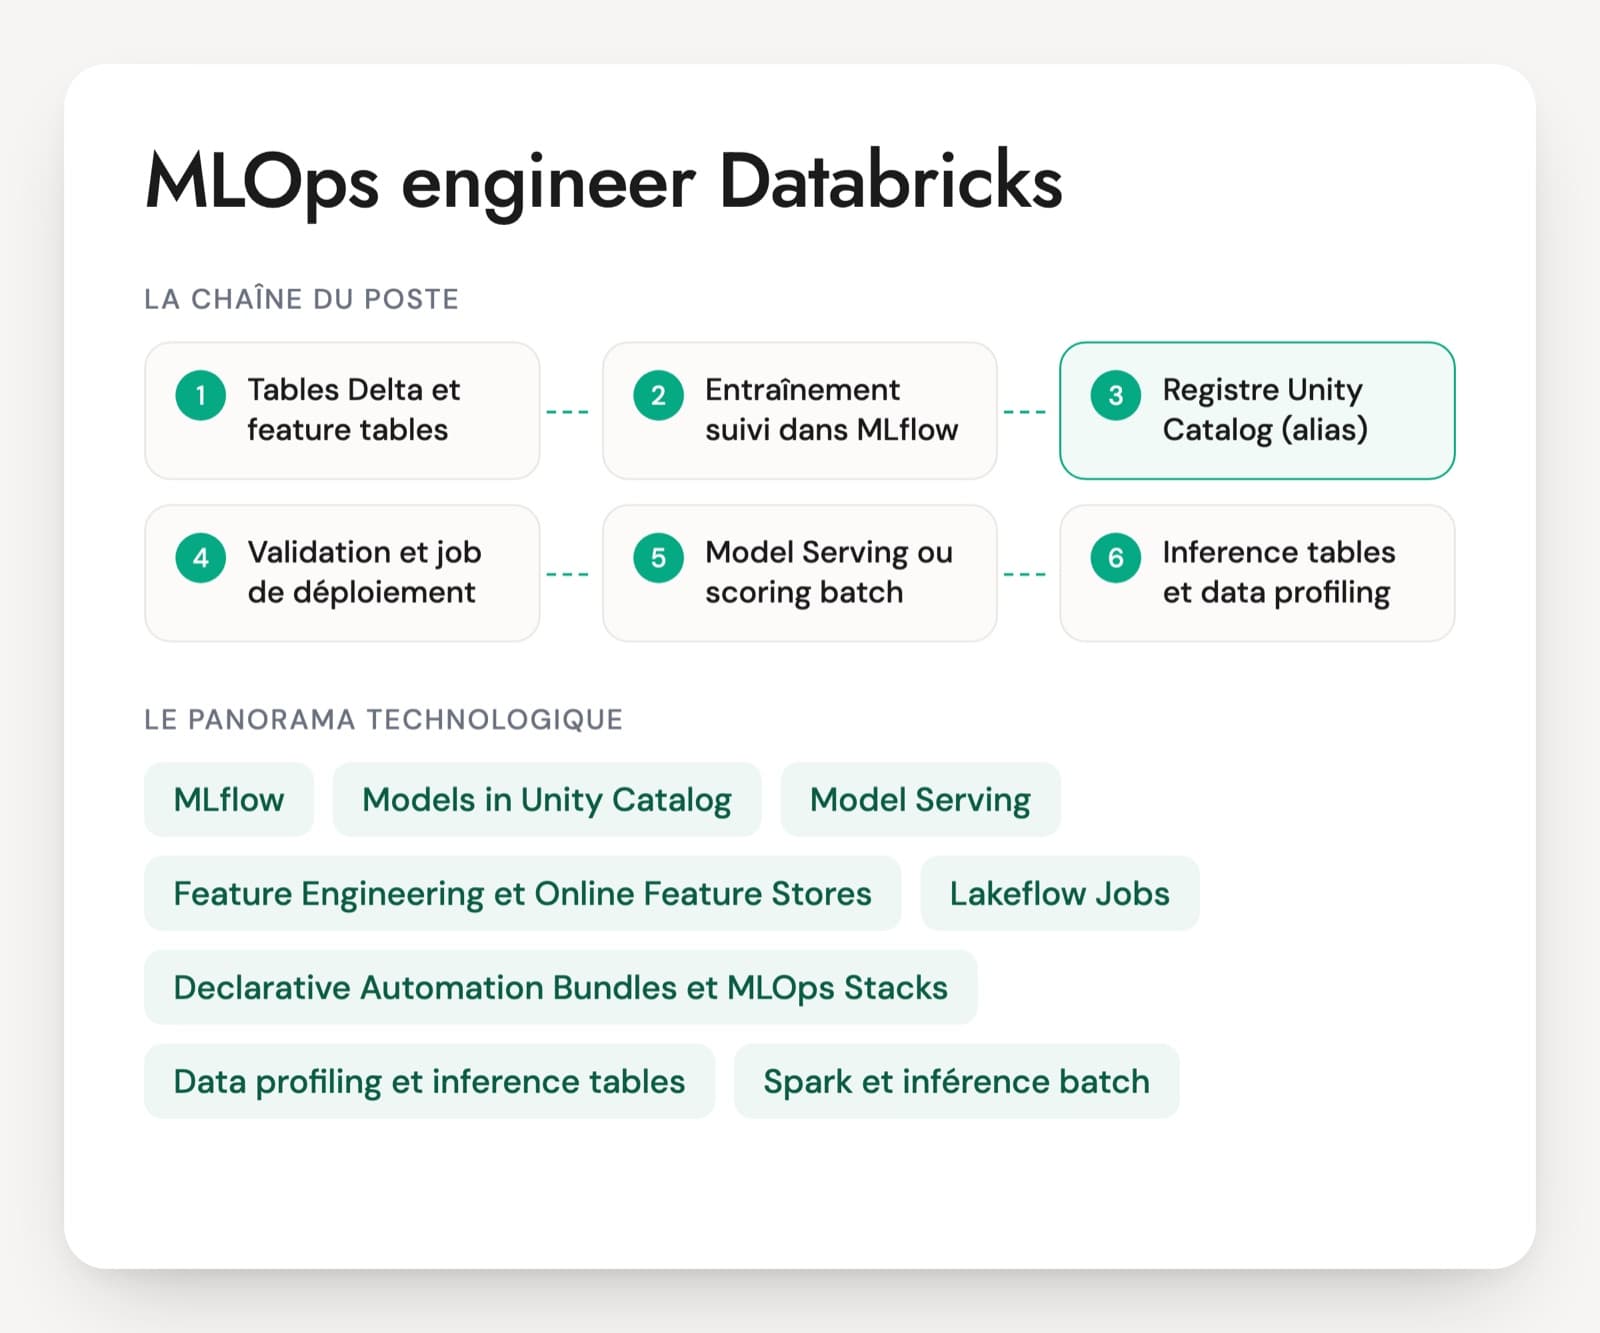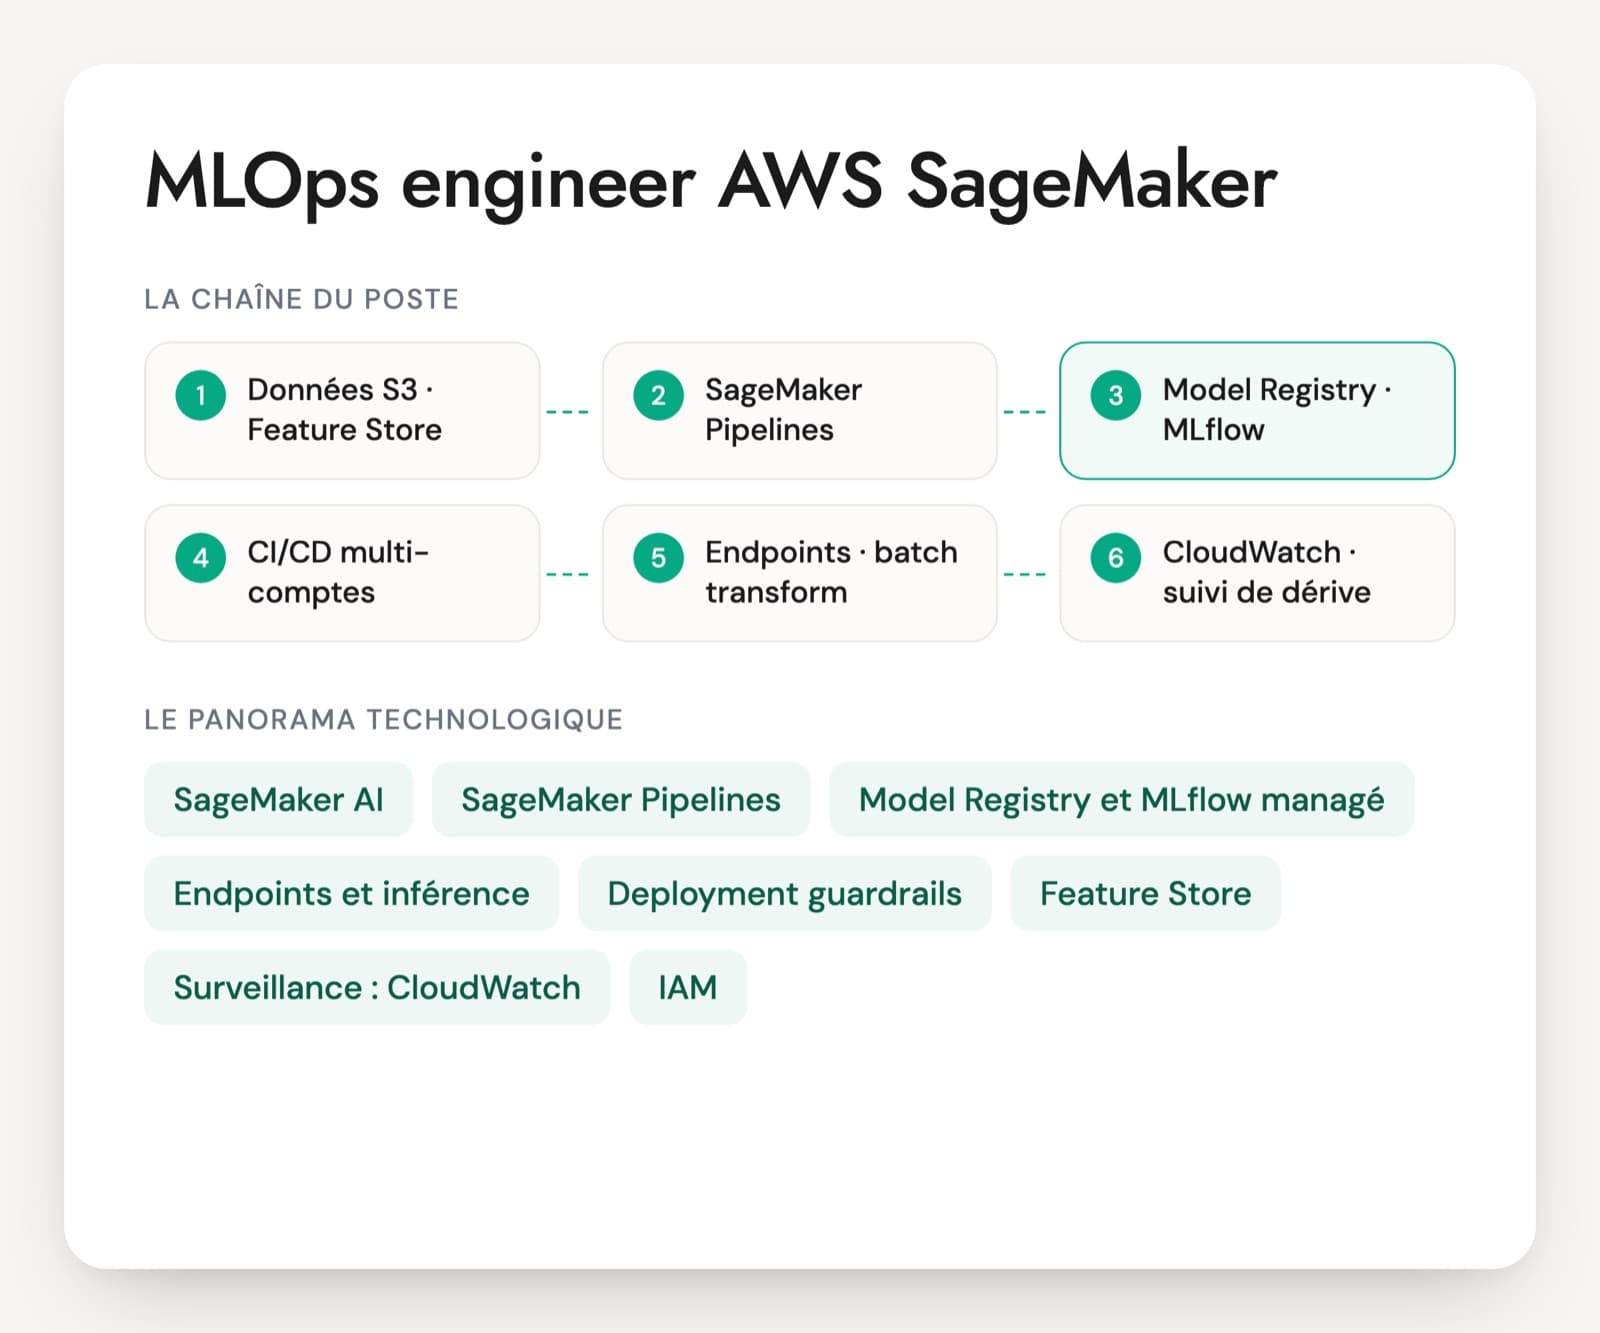
Un MLOps engineer AWS SageMaker prend le notebook d'un data scientist et en fait une chaîne rejouable : traitement des données, entraînement, évaluation, enregistrement du modèle, déploiement sur un endpoint, surveillance. Il travaille avec SageMaker Pipelines, le Model Registry, MLflow, les endpoints et le reste d'AWS (S3, IAM, Step Functions, CloudWatch), le plus souvent avec du CDK ou du Terraform.
La difficulté du recrutement tient au nom. Depuis fin 2024, Amazon SageMaker désigne une plateforme unifiée pour la donnée et l'IA, et le service de machine learning s'appelle SageMaker AI. Un CV qui cite SageMaker peut donc venir d'un data engineer sur Unified Studio. Les signes d'une vraie pratique MLOps sont ailleurs : choix argumenté d'un type d'endpoint, déploiement canary avec retour arrière, comptes AWS séparés, connaissance de la fermeture de Model Monitor aux nouveaux clients.
Le nombre de modèles en production et les comptes AWS utilisés donnent la mesure du poste : à demander au manager avant l'entretien. Un junior peut connaître les Pipelines sans avoir géré un endpoint. Un senior doit raconter un retour arrière réel et ce qui l'a déclenché. Le PDF contient un cas sur un modèle de résiliation à industrialiser.
SageMaker AI et les services AWS autour du poste
SageMaker AI
Le service de machine learning d'AWS, qui porte ce nom depuis décembre 2024. Le nom Amazon SageMaker couvre désormais une plateforme plus large (Unified Studio, Lakehouse, gouvernance des données). Les API, la console et les rôles gardent le préfixe sagemaker, d'où la confusion fréquente sur les CV.
SageMaker Pipelines
L'orchestrateur des étapes de machine learning : préparation des données, entraînement, évaluation, condition sur une métrique, enregistrement du modèle. Chaque exécution est tracée et les étapes déjà calculées peuvent être réutilisées. C'est la pièce centrale d'une chaîne d'entraînement rejouable.
Model Registry et MLflow managé
Le Model Registry range les versions de chaque modèle avec leurs métriques et un statut d'approbation qui peut déclencher le déploiement. SageMaker AI propose aussi MLflow en service managé pour suivre les expériences, avec un enregistrement automatique des modèles dans le registre. Demandez comment la personne a fait cohabiter les deux.
Endpoints et inférence
Quatre façons de servir un modèle : endpoint temps réel, serverless pour un trafic irrégulier qui tolère un démarrage à froid, asynchrone pour des requêtes lourdes (jusqu'à 1 Go et une heure de traitement), et batch transform pour les calculs de masse. Le choix pèse directement sur la facture et sur la latence.
Deployment guardrails
Les options de mise à jour d'un endpoint en production : bascule blue/green d'un coup, par palier canary ou linéaire, ou déploiement progressif par lots. Des alarmes CloudWatch surveillent la nouvelle version pendant une période d'observation et déclenchent un retour arrière automatique.
Feature Store
Un magasin de variables avec une partie en ligne, pour servir les dernières valeurs à faible latence, et une partie historique, pour construire des jeux d'entraînement à la bonne date. Il sert à éviter l'écart entre les variables calculées pour l'entraînement et celles servies en production.
Surveillance : CloudWatch, Model Monitor et ses remplaçants
CloudWatch suit la latence, les erreurs et l'usage des endpoints. Model Monitor, l'outil historique de suivi de dérive, n'est plus ouvert aux nouveaux clients. AWS oriente vers des solutions open source (Evidently, MLflow) branchées sur la capture des requêtes. Un candidat à jour le sait.
IAM, VPC et KMS
Les rôles d'exécution des pipelines et des endpoints, l'isolement réseau des entraînements dans un VPC sans accès Internet, le chiffrement des données et des modèles avec des clés KMS. Dans les grands comptes, ces sujets prennent souvent plus de temps que le modèle lui-même.
CI/CD et infrastructure as code
CDK, CloudFormation ou Terraform décrivent les ressources. GitLab CI, GitHub Actions ou CodePipeline enchaînent tests, construction des images dans ECR, exécution du pipeline et déploiement d'un compte AWS à l'autre (développement, préproduction, production).
Le poste se trouve chez des clients finaux qui ont choisi AWS comme cloud principal, dans l'industrie, la banque, l'assurance ou le e-commerce, et dans les ESN qui portent leurs projets. Dans une équipe mûre, la personne maintient une plateforme commune et des modèles de projet que les data scientists réutilisent. Ailleurs, elle industrialise elle-même les premiers modèles et pose les bases : comptes séparés, CI/CD, registre. Les offres mélangent souvent SageMaker et Bedrock, signe que la frontière entre MLOps et IA générative s'efface. Côté certifications, AWS a arrêté l'examen Machine Learning Specialty le 31 mars 2026 ; la Machine Learning Engineer Associate couvre la mise en production.
Les compétences MLOps à vérifier sur AWS
- Pipelines d'entraînement SageMaker
- Registre de modèles et traçabilité
- Choix et dimensionnement des endpoints
- Déploiement progressif et CI/CD
- Surveillance et dérive en production
- Sécurité AWS, réseau et coûts
Cinq questions pour tester un MLOps engineer SageMaker
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Un data scientist vous confie un notebook qui entraîne un modèle XGBoost. Comment en faites-vous un pipeline SageMaker rejouable ?
Une bonne réponseUn découpage en étapes : traitement des données, entraînement, évaluation qui écrit un fichier de métriques, condition qui compare la métrique à un seuil ou au modèle en place, puis enregistrement dans le Model Registry avec un statut en attente d'approbation. Les chemins S3 et les types d'instance passent en paramètres, la mise en cache des étapes évite de tout recalculer, le code vit dans Git et les images dans ECR. Il peut citer le décorateur @step pour reprendre des fonctions Python existantes.
Signal d'alertePlanifier l'exécution du notebook tel quel chaque mois, ou entraîner le modèle à l'intérieur de l'endpoint.
Question 2 · confirmé
Temps réel, serverless, asynchrone ou batch transform : que choisissez-vous pour un modèle appelé 200 fois par jour, à des heures imprévisibles ?
Une bonne réponsePour un trafic faible et irrégulier, le serverless : paiement à l'usage et démarrage à froid acceptable, dans les limites de mémoire du service et sans GPU. L'asynchrone si les requêtes sont lourdes ou longues, avec une montée à zéro instance. Le batch transform si le résultat peut être calculé la nuit. Le temps réel seulement si une latence stricte l'exige, en mesurant ce que coûte une instance allumée en permanence.
Signal d'alerteUn endpoint temps réel allumé jour et nuit par défaut, voire sur GPU, pour 200 appels quotidiens.
Question 3 · senior
Comment remplacez-vous le modèle d'un endpoint de production sans coupure, avec un retour arrière automatique ?
Une bonne réponseAvec les deployment guardrails : une bascule blue/green par palier canary ou linéaire, des alarmes CloudWatch sur la latence, les erreurs 5xx et si possible un indicateur métier pendant la période d'observation, et un retour arrière automatique si une alarme se déclenche. Le déploiement progressif par lots convient aux grosses flottes. Avant ça, un test en ombre (shadow) compare le nouveau modèle sur le trafic réel sans utiliser ses réponses.
Signal d'alerteSupprimer l'endpoint et le recréer, ou mettre à jour à la main en surveillant les logs.
Question 4 · senior
Comment surveillez-vous aujourd'hui la dérive d'un modèle déployé sur SageMaker ?
Une bonne réponseLa capture des requêtes et des réponses de l'endpoint vers S3, une référence calculée sur les données d'entraînement, des indicateurs de dérive (PSI, test de Kolmogorov-Smirnov) calculés par un job planifié, des alertes. Il sait que Model Monitor n'est plus ouvert aux nouveaux clients et que AWS oriente vers CloudWatch et des outils open source comme Evidently avec MLflow. Il rapproche les prédictions des vraies étiquettes grâce à un identifiant d'inférence pour mesurer la qualité réelle.
Signal d'alerteSurveiller seulement le CPU et la latence, ou supposer que Model Monitor est disponible pour tout nouveau projet.
Question 5 · confirmé
Le rôle d'exécution de vos pipelines a AmazonSageMakerFullAccess et s3:* sur tous les buckets. Que changez-vous ?
Une bonne réponseLe moindre privilège : un rôle par pipeline ou par environnement, des droits limités aux buckets et préfixes utiles, l'usage des clés KMS nécessaires. Entraînements et endpoints dans un VPC avec isolement réseau et des points de terminaison VPC vers S3 et les API. Des comptes AWS distincts pour le développement, la préproduction et la production, le modèle validé étant partagé ou promu d'un compte à l'autre par la CI.
Signal d'alerteGarder les droits larges « parce que c'est plus simple pour les data scientists ».
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Avant de recruter un MLOps engineer AWS : vos questions
Quelle différence entre un MLOps engineer SageMaker et un data engineer AWS ?
Le data engineer AWS construit les flux de données avec Glue, Redshift ou Athena et livre des tables propres. Le MLOps engineer prend ces données et les modèles des data scientists pour les entraîner, les versionner, les déployer et les surveiller sur SageMaker AI. Les deux partagent S3, IAM et l'infrastructure as code. Méfiez-vous des CV qui citent SageMaker Unified Studio : il s'agit souvent d'un profil data platform.
Quelle certification AWS demander pour un poste MLOps ?
La Machine Learning Engineer Associate porte sur la mise en production des modèles, c'est la plus proche du poste. L'ancienne Machine Learning Specialty n'est plus proposée depuis le 31 mars 2026, mais reste valable trois ans pour ceux qui l'ont obtenue. Une certification prouve une connaissance des services. Elle ne remplace pas un récit précis de déploiement en production, avec ses incidents et ses choix.
Un profil Vertex AI ou Azure Machine Learning peut-il prendre un poste SageMaker ?
Oui, si les principes sont là : pipelines rejouables, registre, déploiement progressif, surveillance, séparation des environnements. Le temps d'adaptation porte surtout sur IAM, le réseau AWS et les particularités des endpoints SageMaker. En entretien, demandez à la personne de transposer une chaîne qu'elle a construite sur son cloud vers AWS, service par service. Vous verrez vite si elle raisonne en principes ou en recettes.
Quel test technique proposer à un MLOps engineer AWS ?
Un exercice en direct plutôt qu'un projet à la maison qui demande un compte AWS. Par exemple, la revue d'un pipeline SageMaker volontairement défaillant (droits trop larges, pas de condition sur la métrique, endpoint surdimensionné), ou le schéma d'une chaîne CI/CD sur trois comptes. La personne commente à voix haute. Delectus propose aussi des entretiens structurés sur ces axes avec une grille commune.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.