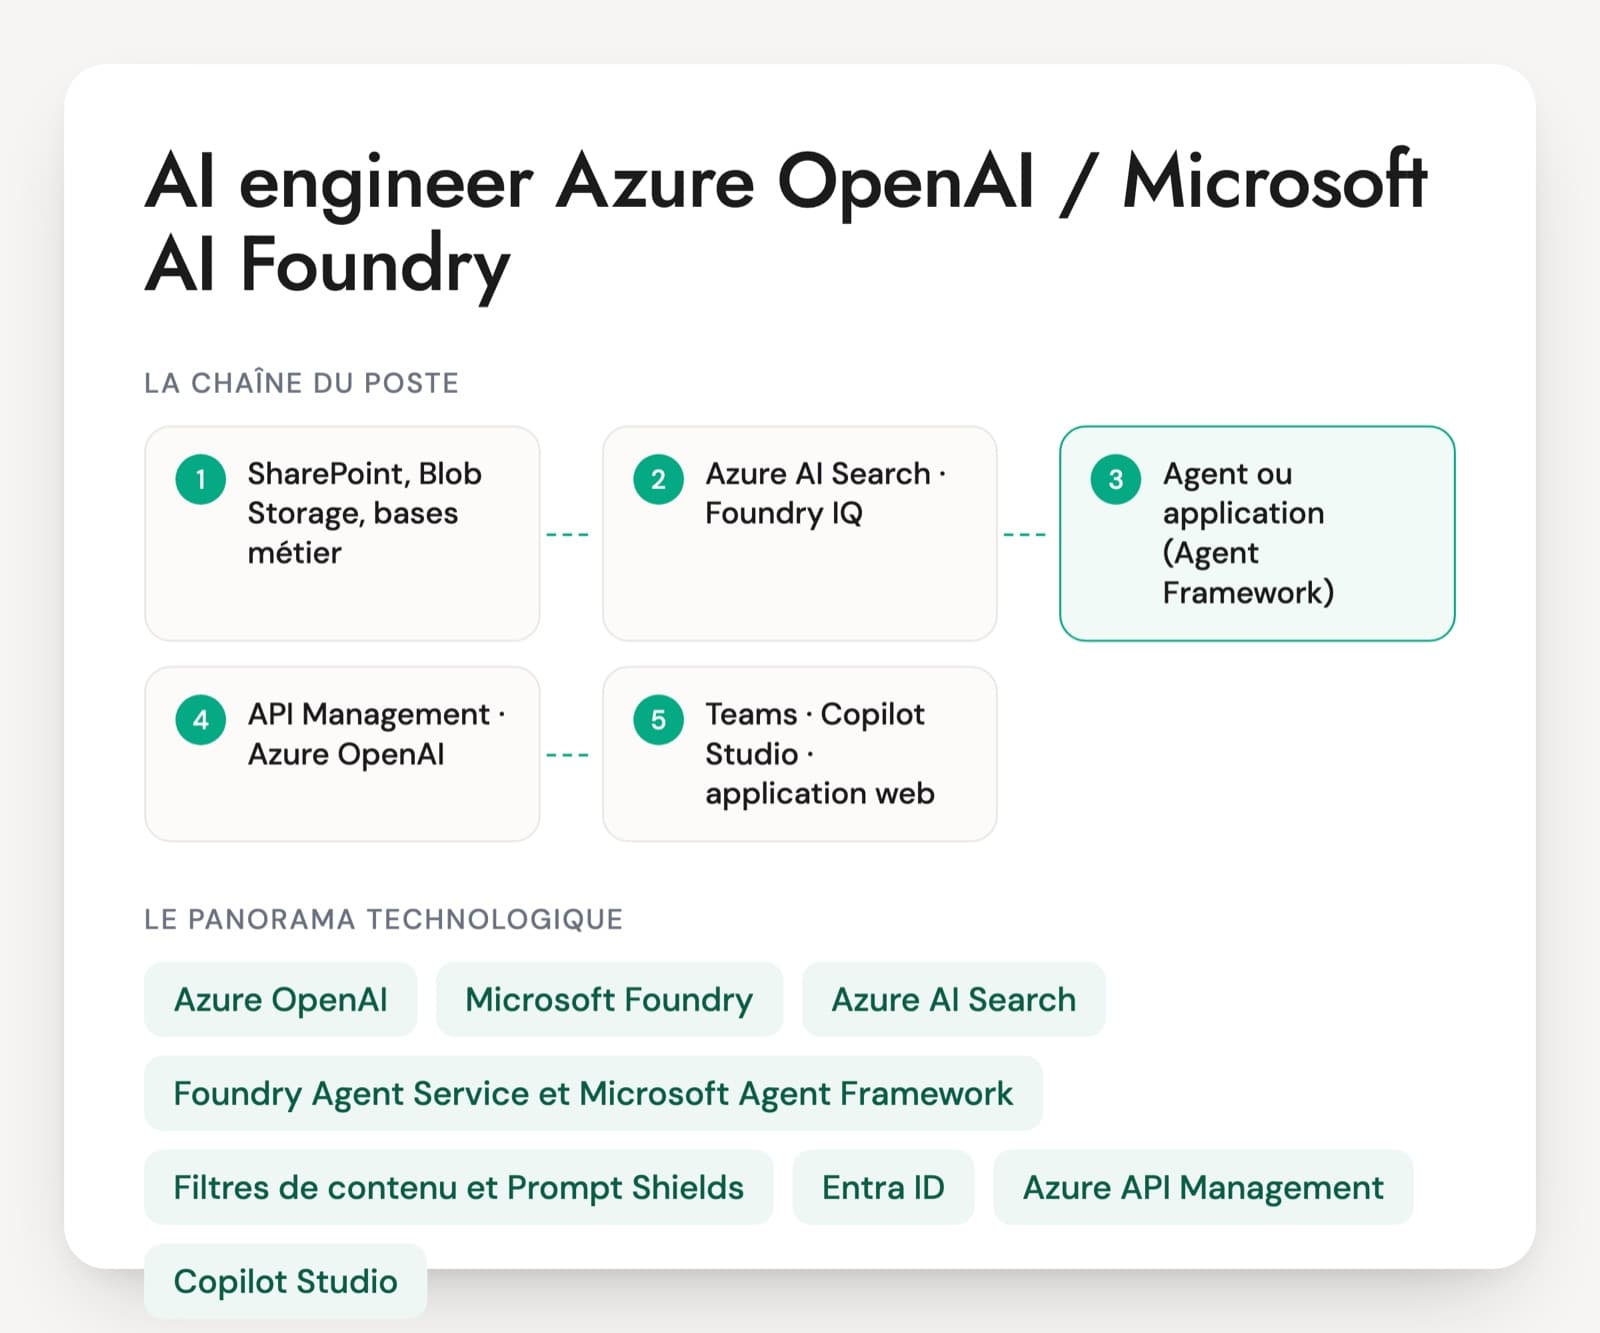
Un architecte IA générative ne conçoit pas un assistant. Il conçoit ce que tous les assistants de l'entreprise partagent. Les annonces publiées sur Free-Work pour ce poste parlent de passerelle de modèles, de RAG, de LLMOps, de FinOps, de protection contre l'injection de prompt et de cloud privé sur OpenShift, avec des missions longues chez de grands comptes. Certaines sont centrées sur Google Cloud et son Agent Platform (ex-Vertex AI), d'autres sur un hébergement maîtrisé.
Les CV mélangent deux profils. L'AI engineer a livré un ou deux projets LLM et connaît bien son framework. L'architecte a dû faire tenir plusieurs projets sur une même plateforme : il a choisi où placer les filtres, comment refacturer les tokens, quoi faire quand un modèle est retiré, quelles données peuvent partir chez quel fournisseur. Les deux parcours ne répondent pas au même besoin. Demandez une décision prise pour plusieurs équipes, avec l'option écartée et ce qu'elle a coûté.
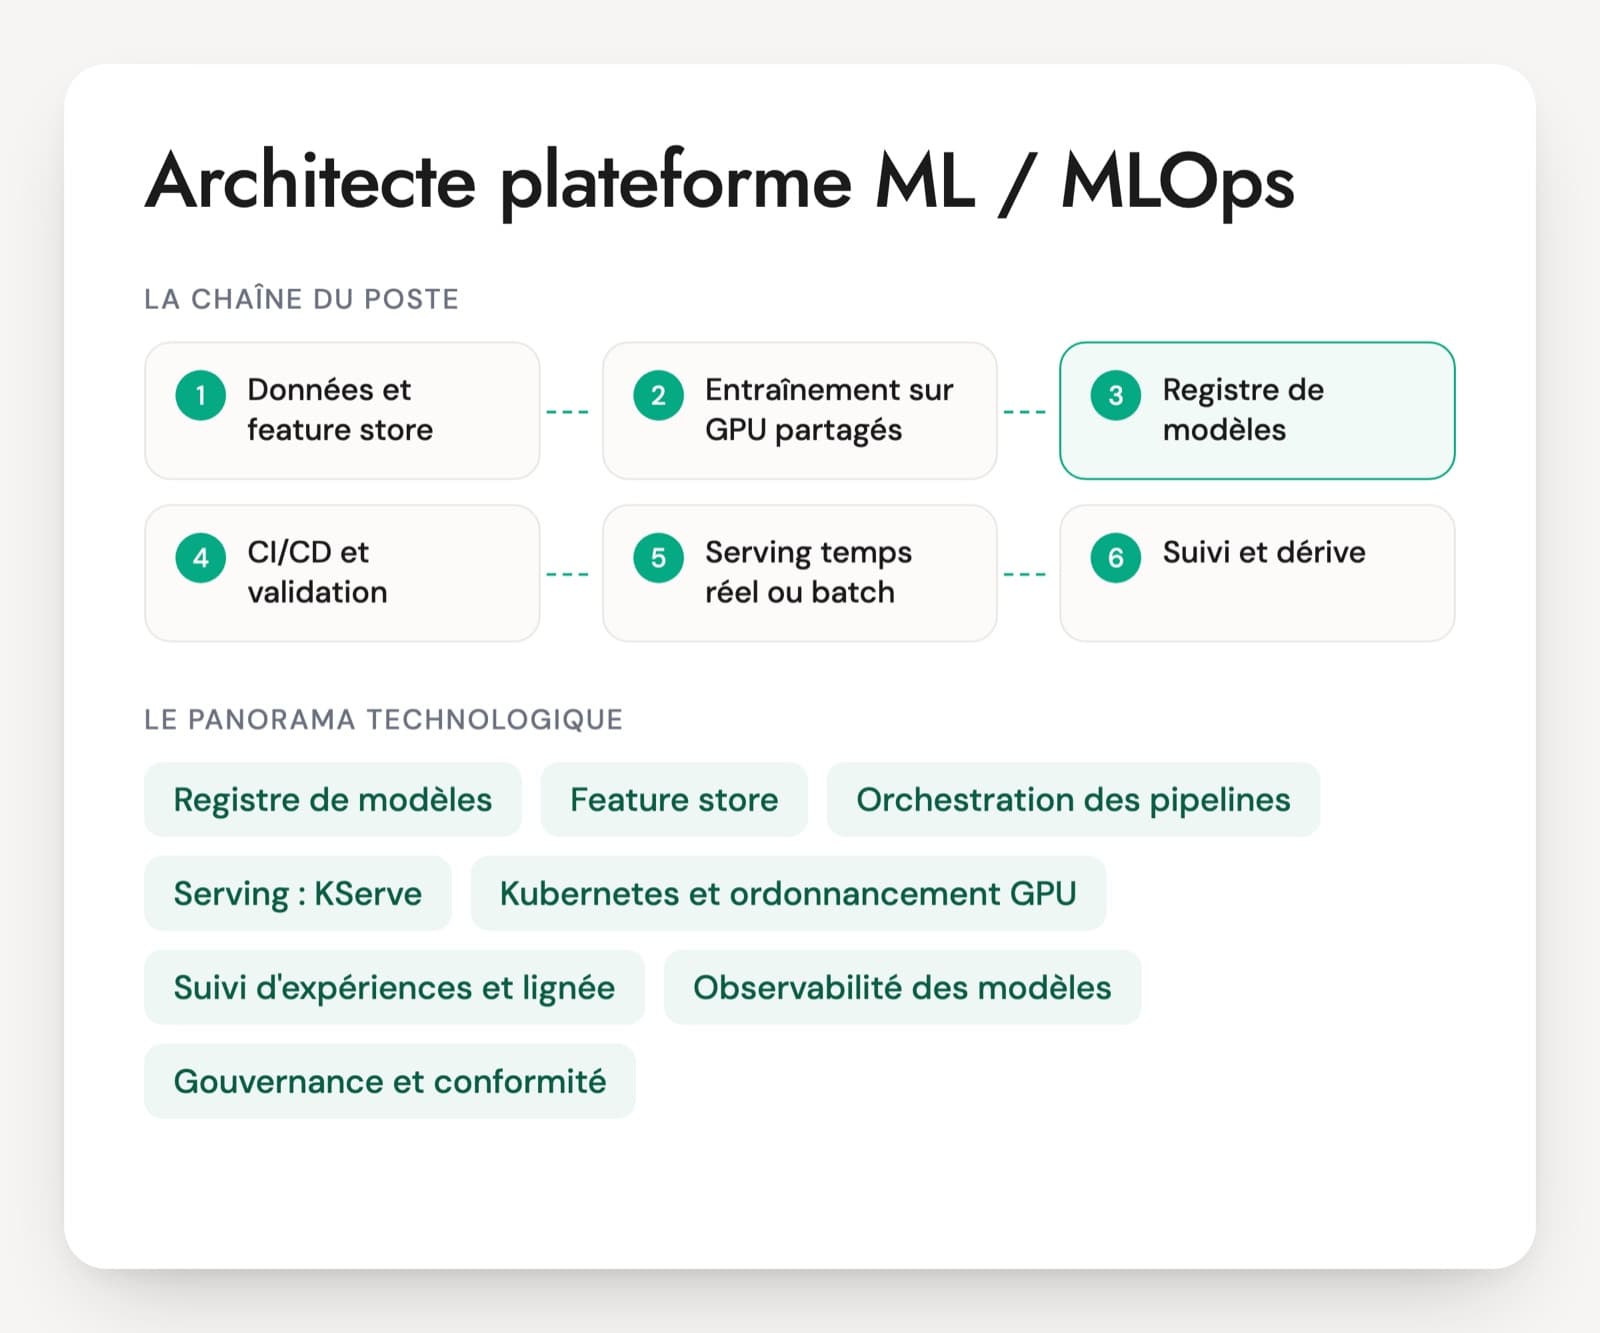
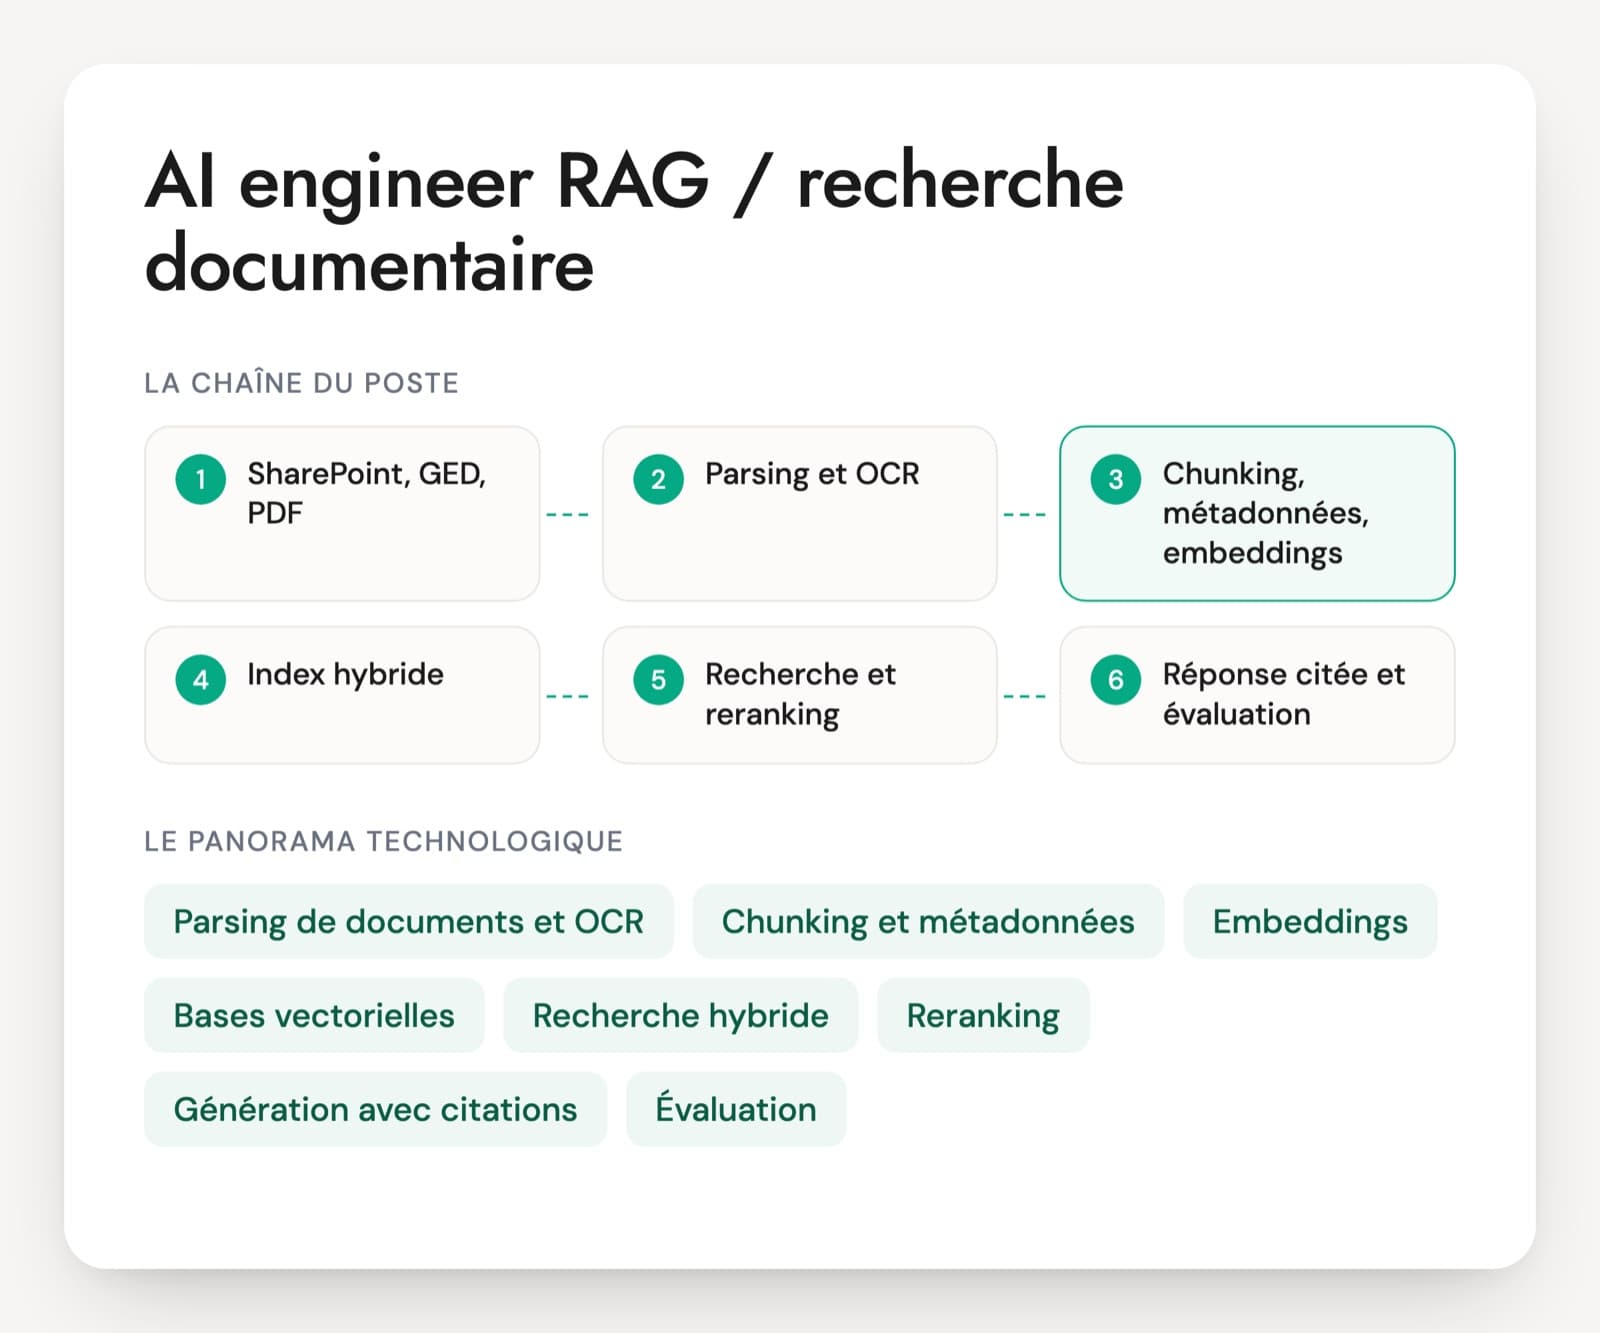
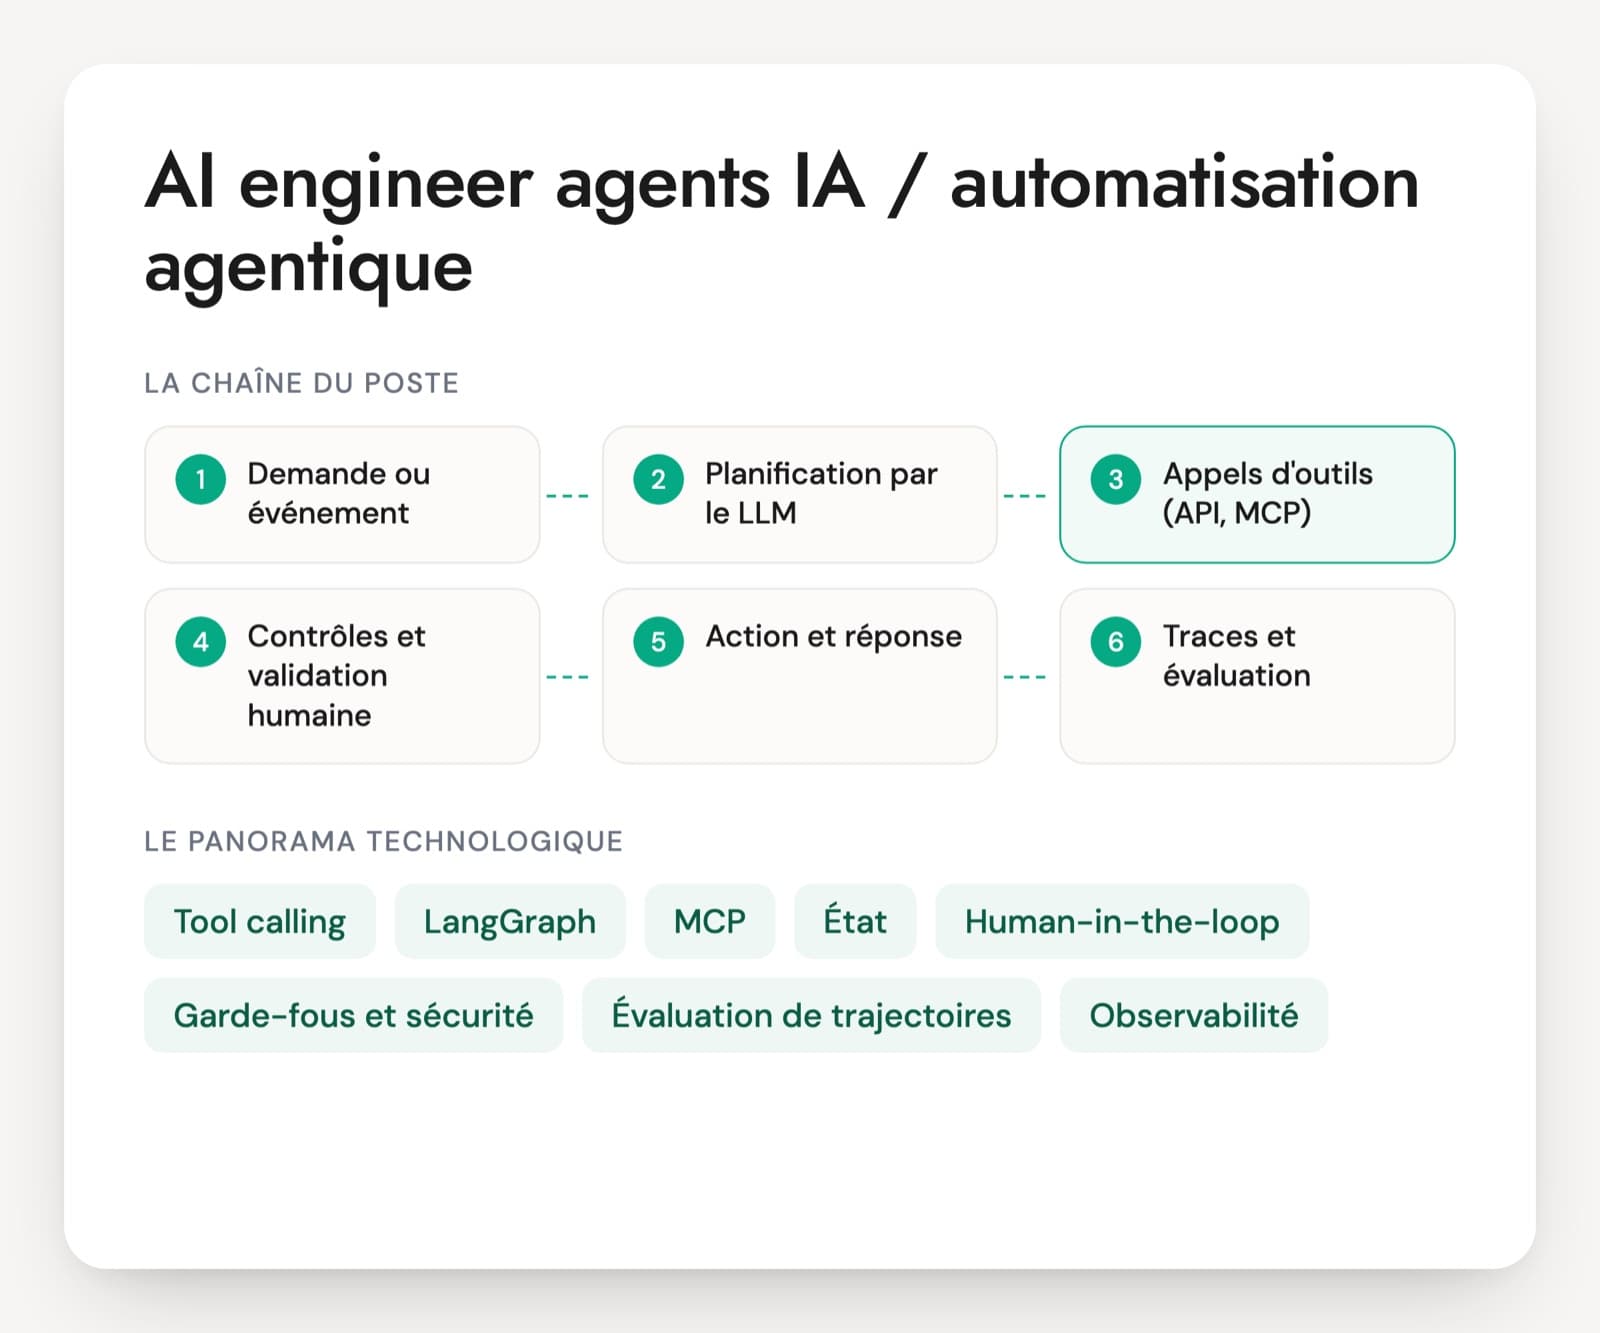
L'entretien reste au niveau de la plateforme : le chunking, le reranking ou le tool calling relèvent des fiches AI engineer RAG et AI engineer agents. Deux informations à obtenir du manager en amont : le nombre de projets GenAI qui tournent déjà, et qui paie les tokens aujourd'hui.
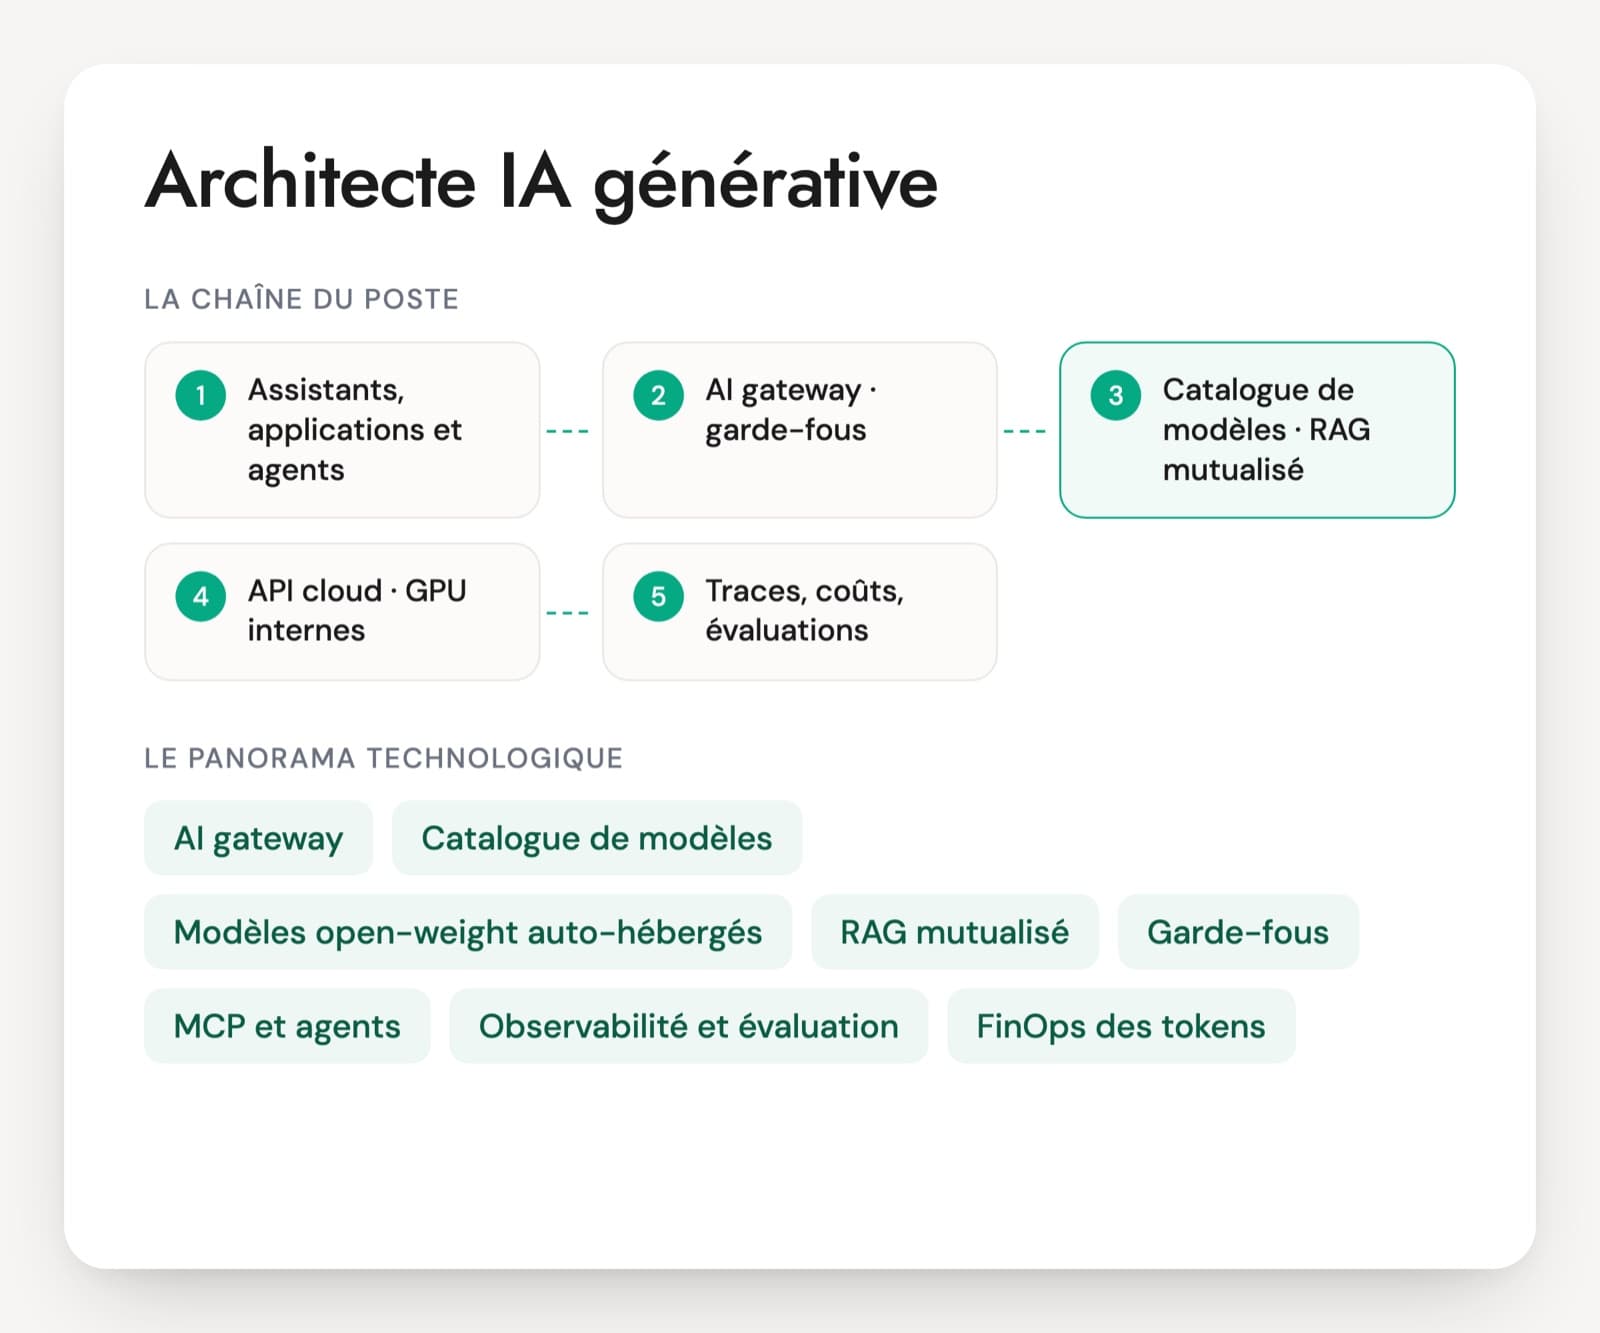
Ce qui compose une plateforme d'IA générative
AI gateway
Le point d'entrée unique vers les modèles, avec des produits comme LiteLLM, Kong AI Gateway ou Azure API Management. Elle gère l'authentification, les clés par application, les quotas et budgets, le basculement entre fournisseurs et la journalisation des coûts. C'est souvent le premier chantier de l'architecte.
Catalogue de modèles
La liste des modèles autorisés, qu'ils viennent d'Azure OpenAI, de Bedrock, de Gemini Enterprise Agent Platform (ex-Vertex AI), de Mistral ou d'un hébergement interne, avec leurs conditions d'usage, leur prix et leur date de retrait. Les fournisseurs retirent régulièrement des versions, ce qui oblige à prévoir les migrations.
Modèles open-weight auto-hébergés
Des modèles comme ceux de Mistral ou Llama, servis sur des GPU internes ou chez un hébergeur, avec des moteurs comme vLLM. Ils répondent aux besoins de confidentialité au prix d'une exploitation à assurer et d'un dimensionnement GPU à calculer.
RAG mutualisé
Les briques de recherche documentaire partagées entre projets : connecteurs aux sources, parsing, embeddings, base vectorielle, reprise des droits d'accès. L'architecte décide ce qui est commun et ce qui reste à chaque équipe.
Garde-fous
Filtres de contenu, détection des données personnelles et de l'injection de prompt, à la gateway ou dans les applications. On trouve Azure AI Content Safety, Bedrock Guardrails, NeMo Guardrails ou Llama Guard. L'OWASP Top 10 pour les applications LLM sert de grille de lecture des risques.
MCP et agents
Le Model Context Protocol permet d'exposer des outils du SI aux agents. À l'échelle d'une entreprise, il faut un registre des serveurs, une authentification par l'identité de l'utilisateur et des droits par outil.
Observabilité et évaluation
Traces de chaque appel avec tokens, latence et coût, souvent au format OpenTelemetry et dans des outils comme Langfuse. Des jeux d'évaluation par application, rejoués à chaque changement de modèle ou de prompt.
FinOps des tokens
Le suivi et la réduction du coût des modèles : attribution par équipe, cache de prompt, API batch, choix de modèles plus petits, capacité réservée face au paiement au token. Les directions financières posent ces questions dès que la facture monte.
Hébergement souverain et conformité
Qualification SecNumCloud, RGPD, AI Act et contrats fournisseurs déterminent quelles données peuvent aller vers quel modèle. L'architecte traduit ces règles en routage dans la gateway.
Le poste apparaît quand une entreprise compte déjà plusieurs projets d'IA générative et veut éviter que chacun refasse sa sécurité, ses connecteurs et son suivi des coûts. Chez un client final, l'architecte construit et fait vivre la plateforme avec une petite équipe. En ESN ou en cabinet, la mission porte souvent sur le cadrage, la mise en place d'une gateway ou d'un RAG commun, ou un audit de conformité. Les annonces s'orientent soit vers un cloud précis (Google Cloud et Agent Platform, Azure et Foundry, AWS et Bedrock), soit vers un cloud privé sur Kubernetes ou OpenShift avec des modèles auto-hébergés. Les candidats viennent de l'architecture cloud, du MLOps ou de l'AI engineering. Vérifiez qu'ils ont travaillé à l'échelle de plusieurs projets.
Les arbitrages qu'un architecte IA générative doit maîtriser
- Gateway et routage de modèles
- Catalogue, cycle de vie et choix des modèles
- RAG mutualisé et droits d'accès
- Garde-fous et sécurité des systèmes LLM
- FinOps des tokens et capacité
- Hébergement souverain et conformité
Cinq questions d'architecture GenAI
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · senior
Douze équipes appellent déjà des modèles, chacune avec sa propre clé d'API. On vous demande de placer une AI gateway devant. Que doit-elle faire, et que doit-elle laisser aux applications ?
Une bonne réponseElle authentifie les applications avec l'identité de l'entreprise et des clés virtuelles par application, applique quotas et budgets, route vers les modèles autorisés et bascule vers un autre déploiement en cas de panne. Elle trace chaque appel avec son coût et son propriétaire, et porte les filtres communs (données personnelles, contenus). Elle expose une API compatible avec plusieurs fournisseurs. La logique métier, l'orchestration des prompts et le RAG restent dans les applications. Il parle de haute disponibilité et du temps ajouté à chaque appel.
Signal d'alerte« Un reverse proxy suffit », ou une gateway qui réécrit les prompts de toutes les équipes. Aucun mot sur l'attribution des coûts ni sur la panne de la gateway elle-même.
Question 2 · senior
Un fournisseur annonce le retrait, dans six mois, de la version de modèle utilisée par quarante applications. Comment l'architecture vous permet-elle de migrer sans casse ?
Une bonne réponseLes applications appellent un alias de la gateway (« chat-standard ») et non une version précise. Les journaux de la gateway donnent l'inventaire de qui utilise quoi. Chaque application a son jeu d'évaluation, rejoué sur le modèle candidat. La bascule se fait application par application, par le routage, avec retour arrière possible. Les ajustements de prompt sont versionnés. Les propriétaires sont prévenus avec un calendrier.
Signal d'alerte« On change le nom du modèle dans la configuration et on regarde. » Aucun inventaire, aucune évaluation avant bascule.
Question 3 · senior
Pour le RAG mutualisé, vous hésitez entre un index unique filtré par les droits et un index par direction. Sur quels critères choisissez-vous ?
Une bonne réponseLa sensibilité des corpus : RH, juridique ou direction générale justifient souvent une isolation physique. Le volume et le coût, les besoins différents de découpage ou d'embedding, l'effet d'un gros corpus sur les autres, les exigences de suppression. Dans les deux cas, les droits de la source sont repris à l'ingestion et filtrés à la requête avec l'identité de l'utilisateur, avant que le modèle ne voie un extrait. Connecteurs et pipeline d'ingestion restent communs.
Signal d'alerteUn index unique avec un compte de service qui voit tout et un prompt qui demande de « ne pas répondre si l'utilisateur n'a pas le droit ».
Question 4 · senior
La plateforme sert des assistants internes, un chatbot client et des agents qui agissent dans le SI. Où placez-vous les garde-fous ?
Une bonne réponsePar couches. À la gateway, des filtres communs : détection et masquage des données personnelles, filtrage de contenu, détection d'injection de prompt, avec des seuils réglables par application. Dans chaque application, le périmètre du sujet et la validation du format de sortie. Pour les agents, l'autorisation se fait dans l'outil ou l'API appelée, avec l'identité de l'utilisateur, le moindre privilège et une validation humaine des actions irréversibles. Il sait qu'aucun filtre n'arrête toutes les injections et limite ce qu'une injection réussie peut faire. Il cite l'OWASP Top 10 pour les applications LLM.
Signal d'alerte« Le prompt système interdit au modèle de le faire. » Ou un seul filtre global réglé pour le chatbot client, qui bloque les usages internes.
Question 5 · confirmé
La facture des LLM a triplé en un trimestre et la direction financière demande qui consomme quoi. Comment répondez-vous, puis comment la faites-vous baisser ?
Une bonne réponseL'attribution vient des journaux de la gateway : tokens d'entrée et de sortie par application, équipe et cas d'usage, et surtout le coût par requête métier. Pour baisser : router les tâches simples vers des modèles plus petits, utiliser le cache de prompt des fournisseurs, réduire le contexte envoyé (nombre d'extraits, historique résumé), passer les traitements non interactifs en API batch, limiter la longueur des réponses, comparer débit réservé et paiement au token. Chaque changement est validé par une évaluation de qualité.
Signal d'alerte« On passe tout sur le modèle le moins cher », sans mesure de qualité. Ou aucune idée de qui consomme.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Architecte IA générative : ce que demandent les recruteurs
À quel moment faut-il un architecte IA générative plutôt qu'un AI engineer ?
Si vous avez un projet à livrer, un AI engineer suffit. L'architecte devient utile quand plusieurs projets tournent ou vont tourner, avec des besoins communs : accès aux modèles, sécurité, droits documentaires, coûts, conformité. Son travail se mesure sur la plateforme et les règles qu'il installe. Un bon indice dans le CV : des décisions prises pour plusieurs équipes, et pas seulement des applications livrées.
Quelle expérience exiger, alors que la GenAI est récente ?
Peu de candidats ont plusieurs années de plateformes LLM. Regardez l'expérience d'architecture qui se transpose : plateformes cloud, API management, sécurité des identités, MLOps. Ajoutez au moins un ou deux projets GenAI menés jusqu'à la production. Un candidat qui a déjà mis en place une gateway d'API ou une plateforme ML comprend vite les enjeux d'une AI gateway et d'un catalogue de modèles.
Faut-il un profil cloud, data ou sécurité pour ce poste ?
Le poste emprunte aux trois. Le cloud pour les réseaux privés, les identités et le dimensionnement, la data pour le RAG et la gouvernance des documents, la sécurité pour les garde-fous et la conformité. Choisissez selon votre plateforme actuelle et ce qui manque à l'équipe. Un architecte venu du cloud aura besoin d'appui sur l'évaluation des modèles, un profil data sur le réseau.
Étude de cas ou exercice pratique : que proposer à un architecte IA générative ?
Un test technique de code apprend peu sur ce poste. Une étude de cas de 20 à 30 minutes fonctionne bien : décrivez une entreprise avec plusieurs projets GenAI disparates et demandez la plateforme cible et l'ordre des chantiers. Observez s'il commence par les données et les usages avant de citer des produits. Delectus AI propose ce type de cas dans le PDF de la fiche, avec la grille de notation.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.