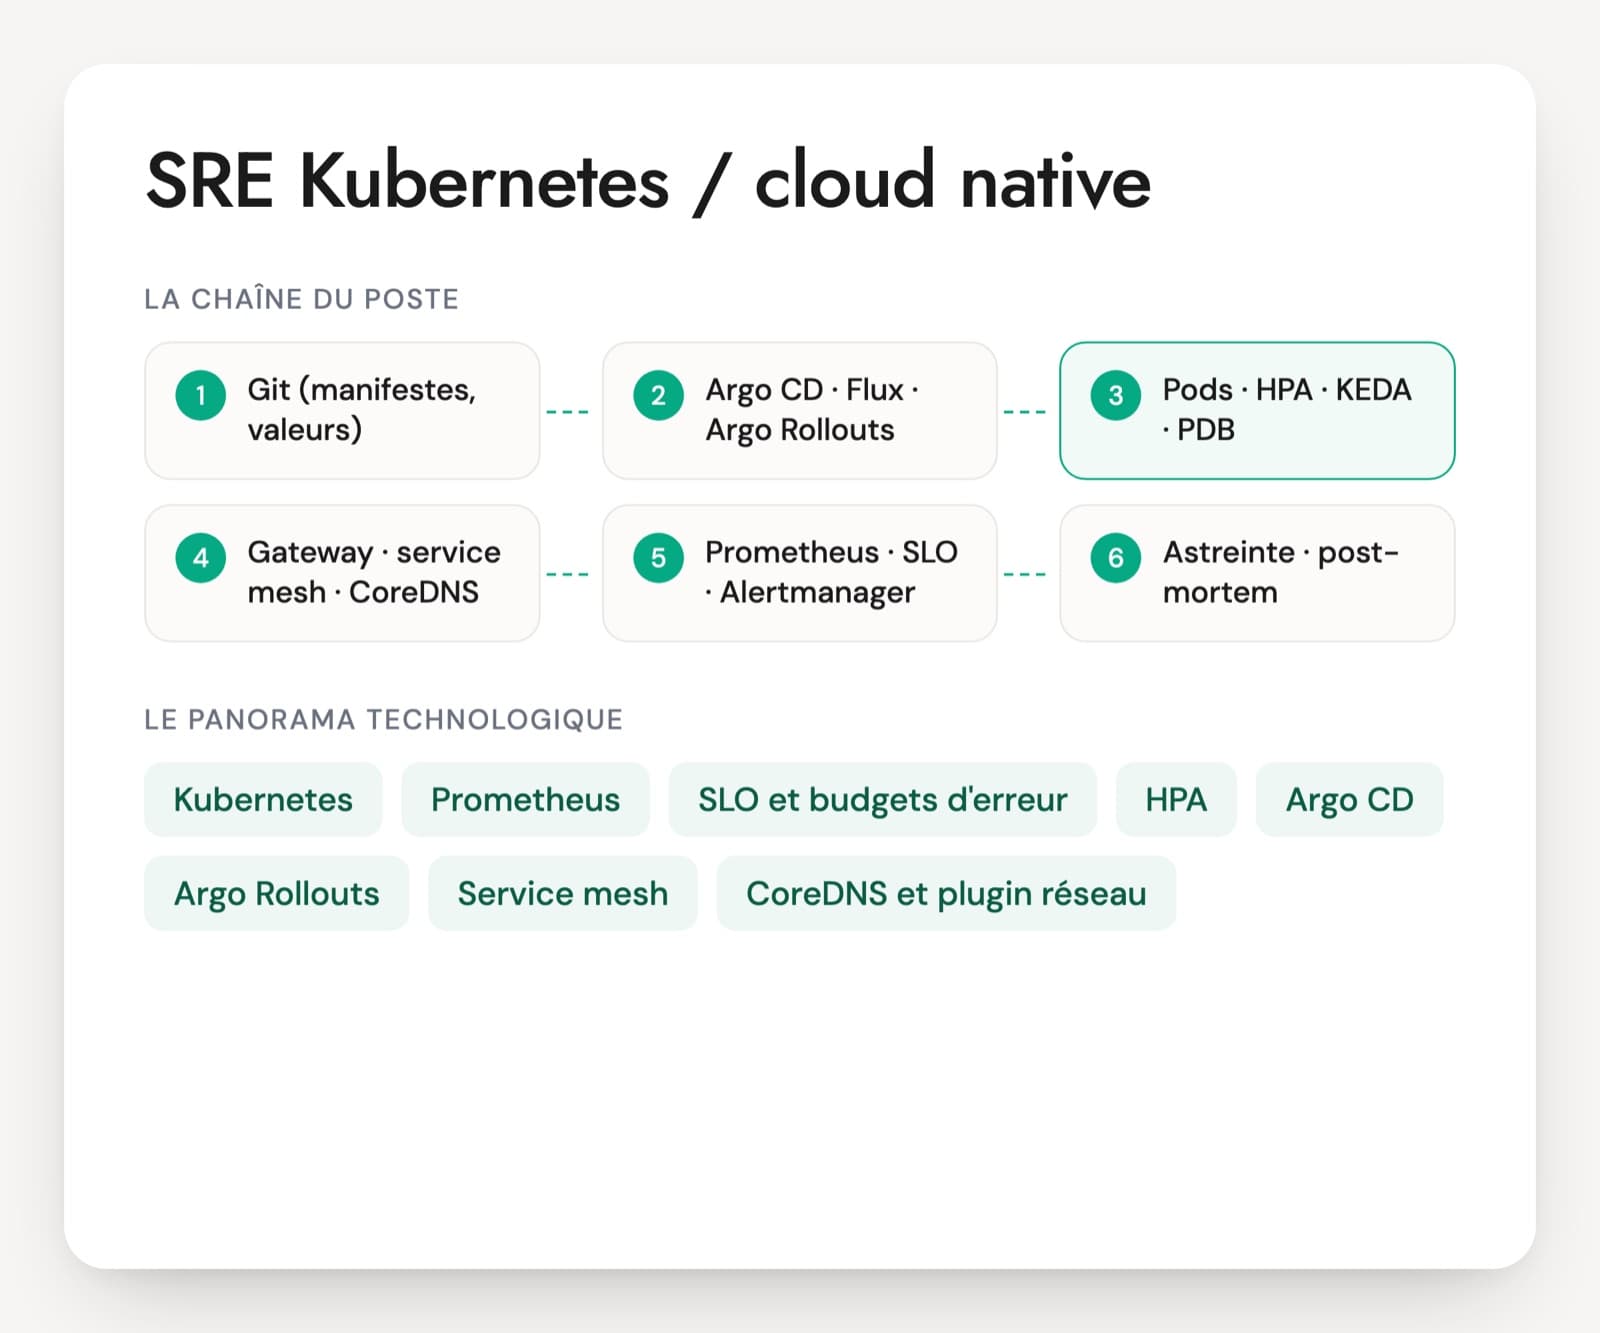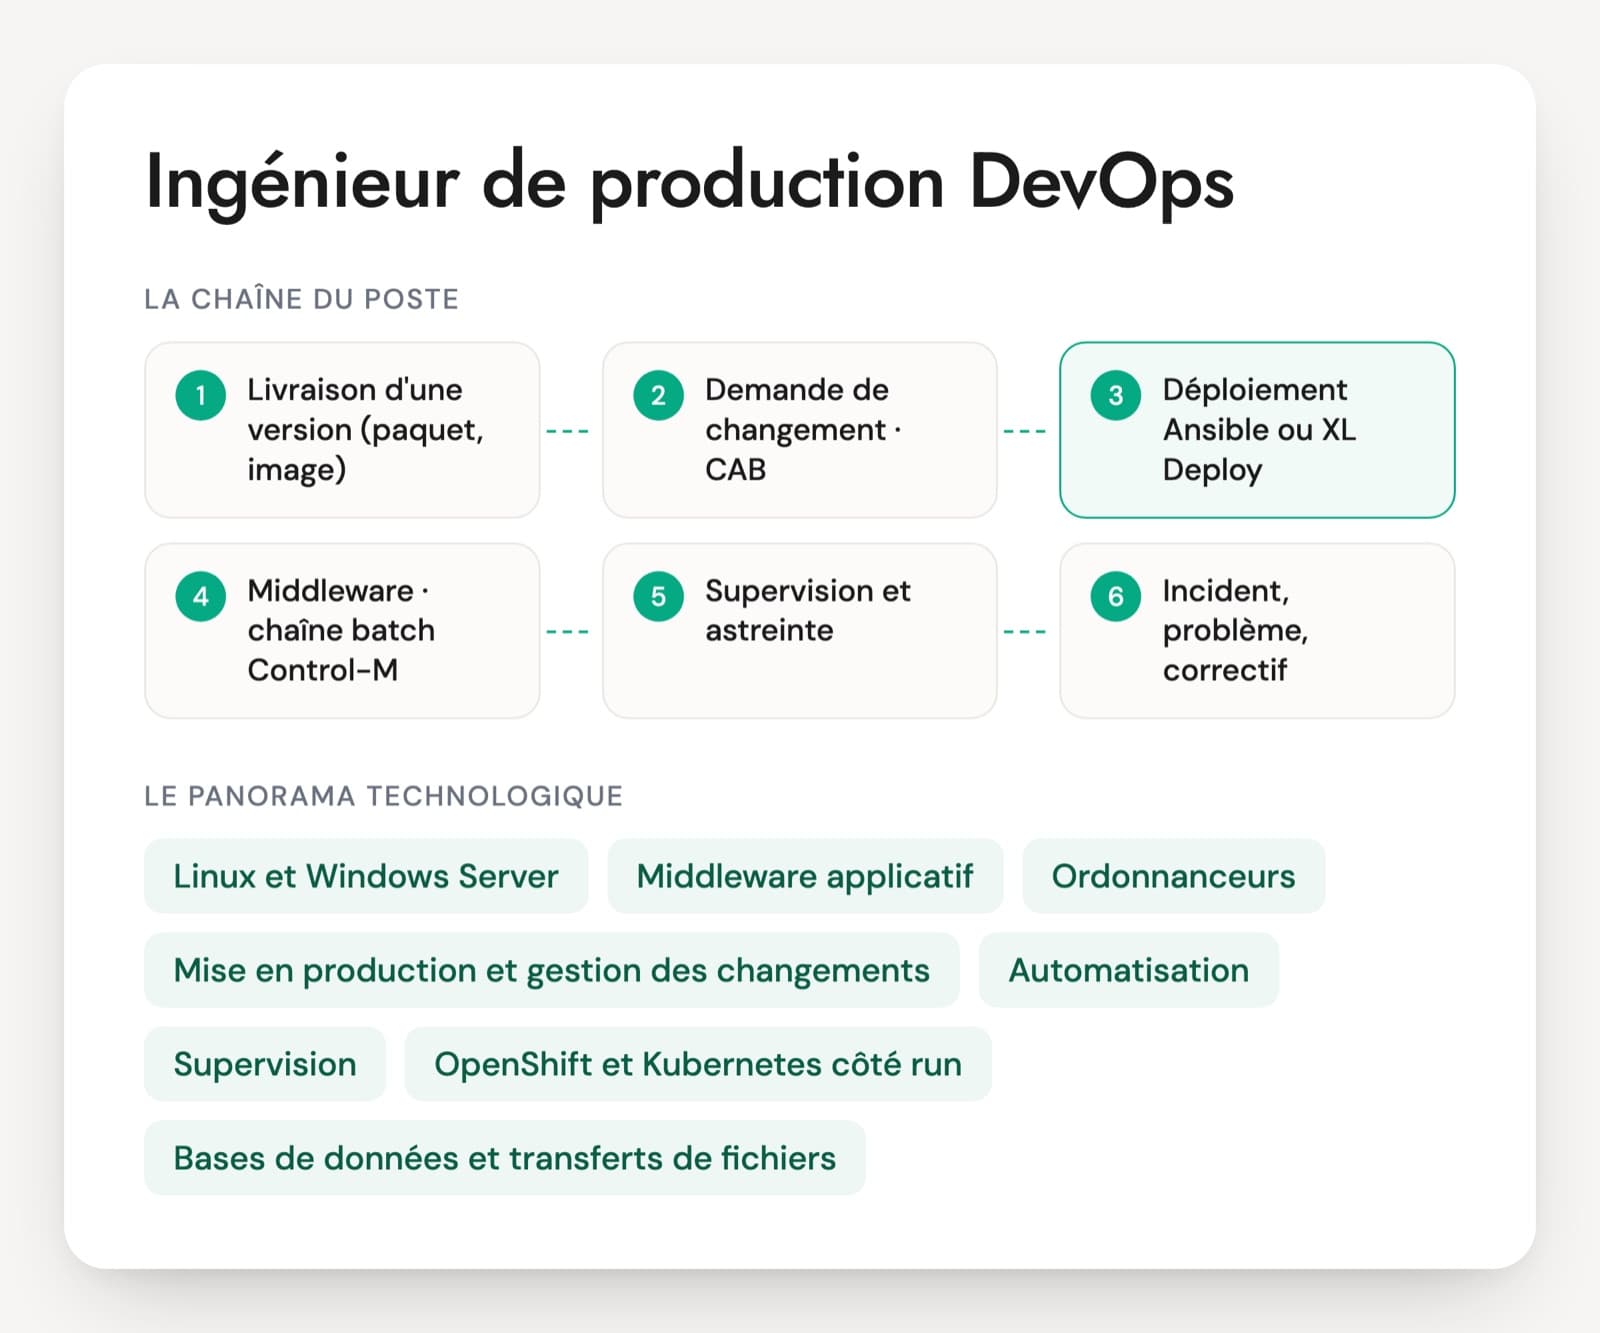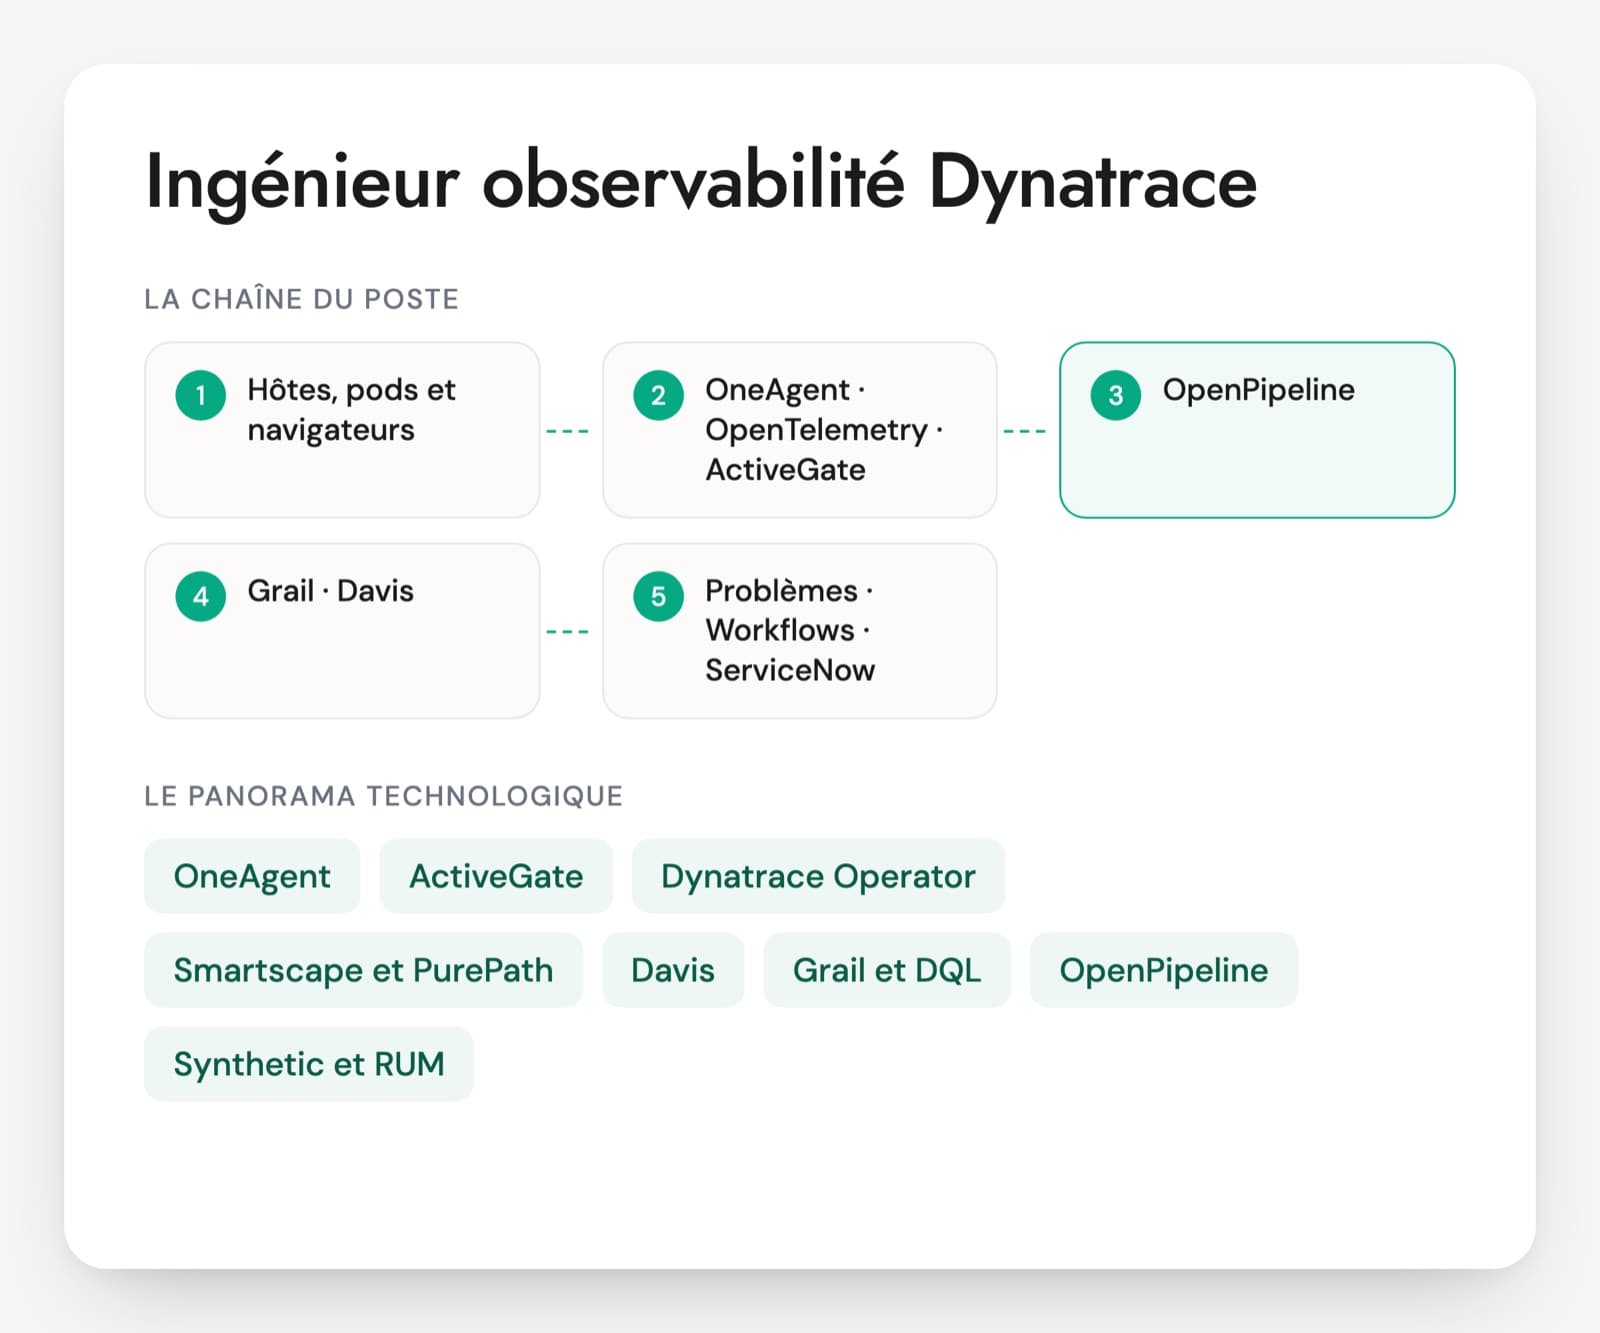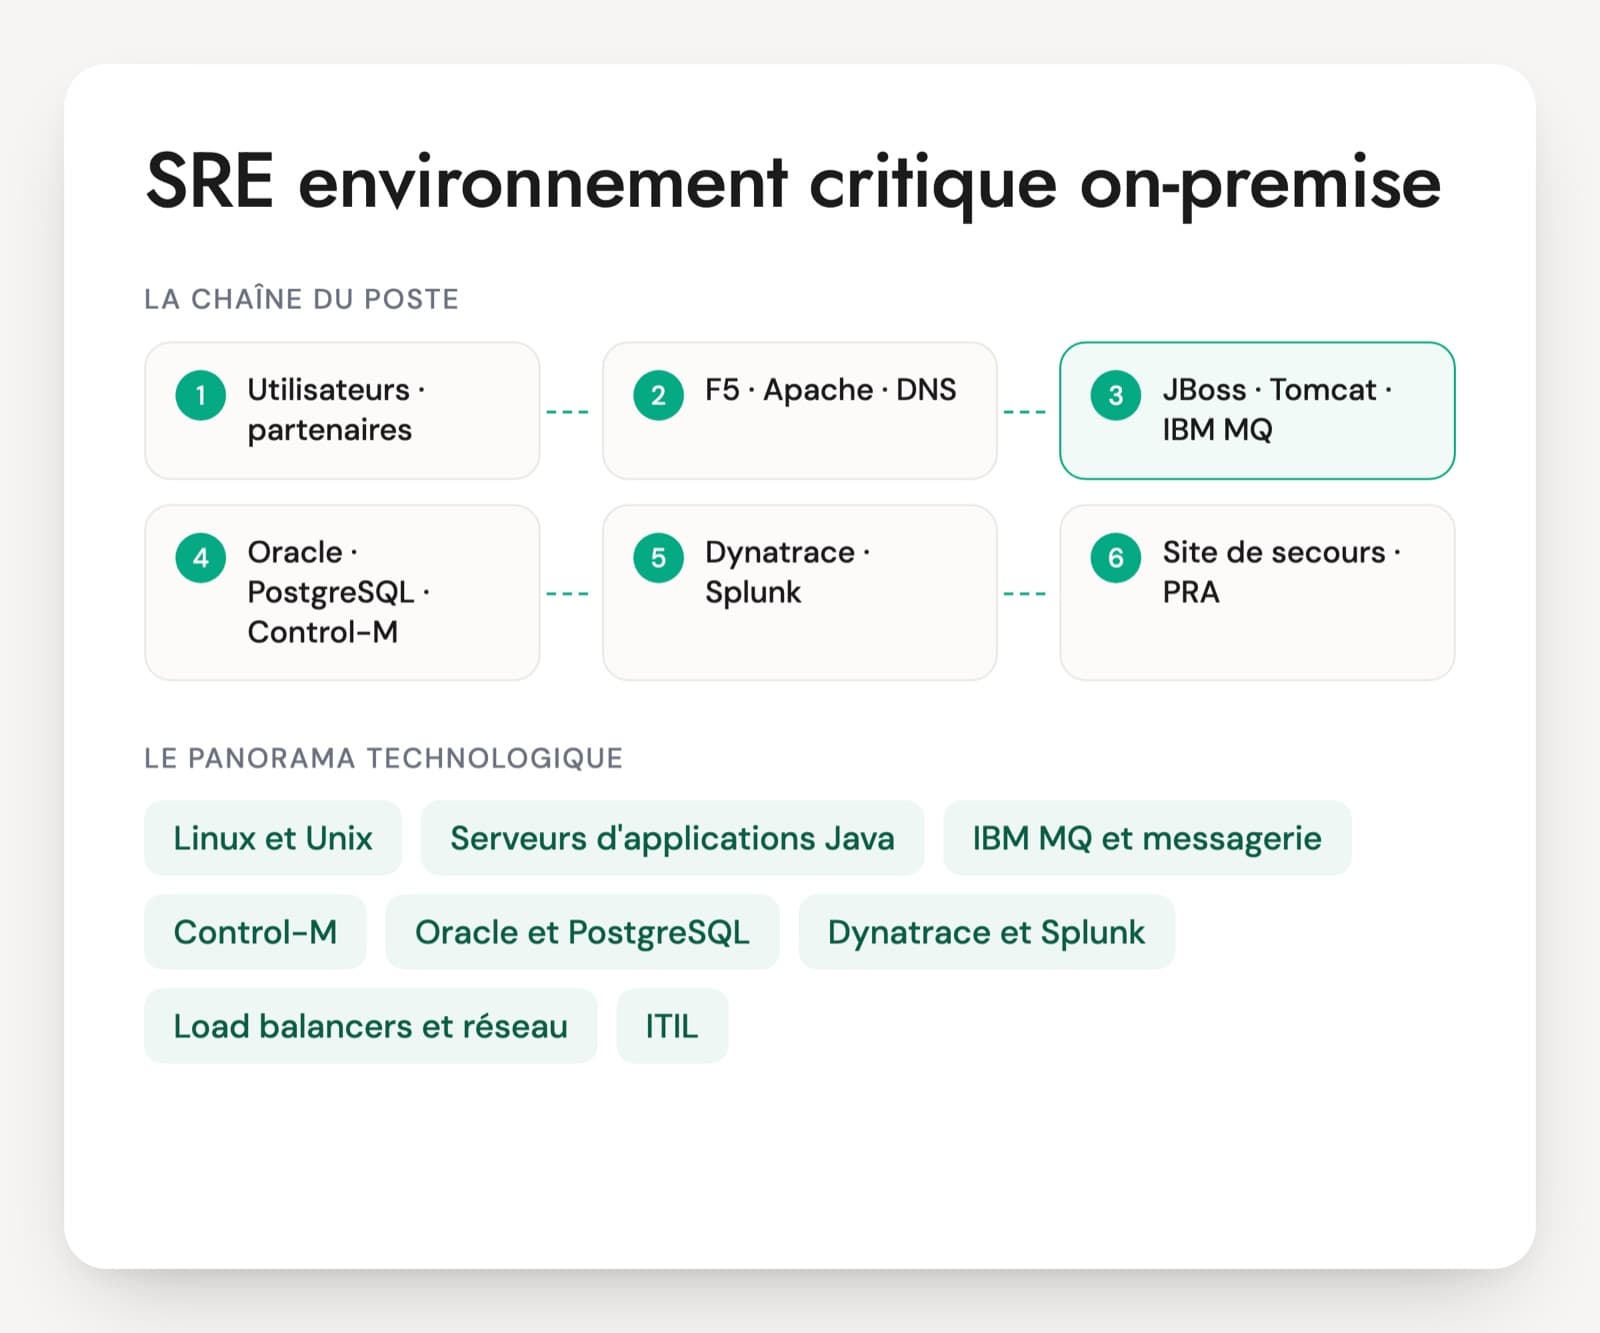
En environnement critique on-premise, un SRE part d'un SI déjà en place, souvent ancien et très dépendant de quelques composants. La personne ne choisit ni les services managés ni l'architecture. Elle pose des SLO sur des applications JBoss ou Tomcat qui n'exposent aucune métrique, suit les chaînes Control-M de nuit, garde la main sur les files IBM MQ et prépare le switchover Data Guard de l'année. Les changements passent par un processus ITIL, l'astreinte est réelle.
Le poste ressemble à celui d'un ingénieur de production, avec une différence nette dans les réponses. Un SRE chiffre : budget d'erreur, capacité d'un nœud seul au pic, durée réelle d'une reprise comparée au RTO. Il cherche à faire disparaître une intervention répétée plutôt qu'à la refaire plus vite. Les profils venus uniquement du cloud public appellent aussi la prudence : ils connaissent les SLO, beaucoup moins un pool de connexions saturé ou une destination d'archivelogs pleine.
La personne décrit la dernière bascule de site à laquelle elle a participé : ce qui était prévu, ce qui a bloqué, le temps de reprise mesuré. Les offres associent souvent Dynatrace, Splunk, Control-M et Ansible. Le PDF contient six axes et un cas de bascule de 20 minutes.
Le SI qu'un SRE on-premise doit tenir en datacenter
Linux et Unix
Le socle des serveurs, Red Hat le plus souvent, avec parfois de l'AIX ou du Solaris sur les applications anciennes. Le SRE lit la charge d'un serveur, les journaux système et l'état du réseau sans aide extérieure.
Serveurs d'applications Java (JBoss EAP, WildFly, Tomcat)
Ils portent les applications transactionnelles. Les incidents typiques : pool de connexions épuisé, JVM figée par le garbage collector, fuite mémoire. La personne doit dire ce qu'elle collecte avant de redémarrer une instance.
IBM MQ et messagerie
Les files de messages qui relient les applications entre elles et aux partenaires. Une file qui grossit sans bruit ou un message rejoué en boucle arrêtent des flux entiers. MQ se configure en gestionnaires de files, canaux et files, avec la commande runmqsc.
Control-M
L'ordonnanceur de BMC qui lance les chaînes batch, la nuit surtout, avec leurs dépendances. Le SRE s'intéresse au chemin critique, aux échéances de fin et à ce qui arrive quand un agent disparaît. D'autres sites utilisent Dollar Universe ou VTOM.
Oracle et PostgreSQL
Les bases de production, administrées par les DBA. Le SRE doit savoir lire une session bloquante, un plan d'exécution qui change, une destination d'archives pleine, et préparer la bascule Data Guard avec eux.
Dynatrace et Splunk
Dynatrace suit les transactions de bout en bout et regroupe les alertes en problèmes, avec une cause probable. Splunk centralise les journaux et sert aux recherches et aux alertes. D'autres sites utilisent Zabbix, Centreon ou ELK.
Load balancers et réseau (F5, HAProxy, DNS)
Ils répartissent le trafic entre les serveurs et portent les adresses virtuelles. Leurs moniteurs de santé décident si un serveur reçoit du trafic. En bascule de site, DNS et adresses virtuelles posent souvent plus de problèmes que l'application.
ITIL, PRA et PCA
Le cadre des changements, incidents et problèmes, et les plans de reprise et de continuité d'activité, avec leurs objectifs RTO et RPO. Le SRE doit y faire entrer ses pratiques (budget d'erreur, post-mortem) plutôt que les opposer au processus.
Ansible et AWX
L'outil d'automatisation le plus courant en datacenter. Le SRE l'utilise pour supprimer les interventions répétées, avec des playbooks testés et lancés depuis AWX pour garder la trace de chaque exécution.
Le poste se rencontre dans les SI qui gardent leurs applications critiques en datacenter, pour des raisons de réglementation, de latence ou d'historique, souvent avec deux salles et un PRA testé chaque année. L'intitulé varie : SRE, ingénieur de production SRE, ingénieur fiabilité. Le travail se partage entre l'astreinte, la supervision, la préparation des bascules et l'automatisation, au contact des DBA, des équipes middleware et des équipes applicatives. Une partie du SI passe parfois sur Kubernetes ou OpenShift, mais les bases, la messagerie et l'ordonnancement restent en VM. L'offre gagne à préciser les outils de supervision et l'ordonnanceur en place, car ils pèsent sur la prise de poste.
Les compétences de production à valider chez un SRE on-premise
- SLO et capacité sur un SI existant
- Middleware Java et messagerie MQ
- Ordonnancement et chaînes batch
- Bases de données en production
- PRA, PCA et bascules de site
- Supervision, astreinte et automatisation
Questions de fiabilité pour un SRE en environnement critique
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
On vous demande des SLO pour une application transactionnelle sur JBoss et Oracle qui n'expose aucune métrique applicative. Par où commencez-vous ?
Une bonne réponsePar les parcours utilisateurs qui comptent, puis par ce qui existe déjà : journaux d'accès d'Apache ou du load balancer (codes retour, temps de réponse), services vus par Dynatrace, tests synthétiques. Il calcule l'historique sur quelques mois pour fixer une cible tenable et la fait valider par le responsable de l'application.
Signal d'alerte« 100 % » ou une disponibilité calculée sur le ping des serveurs, qui reste bonne pendant que l'application renvoie des erreurs.
Question 2 · confirmé
Le JBoss de production se fige et l'astreinte veut le redémarrer tout de suite. Que collectez-vous dans les deux minutes avant de le faire ?
Une bonne réponsePlusieurs thread dumps espacés de quelques secondes (jstack ou jcmd), l'état du heap et les journaux GC, l'état du pool de connexions à la base par la CLI JBoss, une capture Dynatrace si l'agent est là. Un heap dump seulement si une fuite est probable et que le disque et le temps le permettent. Puis le redémarrage, et l'analyse à froid.
Signal d'alerteRedémarrer sans rien garder, ce qui garantit que l'incident reviendra sans explication. Ou un heap dump de 16 Go pris pendant que les utilisateurs attendent.
Question 3 · confirmé
Une file IBM MQ grossit depuis une heure et l'application consommatrice ne remonte aucune erreur. Que regardez-vous ?
Une bonne réponseLa profondeur de la file et le nombre de consommateurs connectés (DISPLAY QSTATUS dans runmqsc), l'état des canaux, la file de backout et la file des messages en erreur. Un message empoisonné rejoué sans fin bloque la consommation si aucun seuil de backout n'est réglé. Côté application, des threads de consommation bloqués, visibles dans un thread dump.
Signal d'alertePurger la file pour faire baisser l'alerte, sans savoir ce que contenaient les messages.
Question 4 · confirmé
Le switchover Data Guard annuel est prévu samedi. Que vérifiez-vous avant, et que faites-vous si la base de secours a du retard ?
Une bonne réponseAvant : la validation de la configuration dans le broker (VALIDATE DATABASE), le retard de transport et d'application des journaux, l'absence de trou dans les archives, et le basculement des connexions applicatives (services liés au rôle de la base, DNS, pools). Avec du retard, il attend que la base de secours rattrape ou corrige la cause. Il distingue switchover, sans perte, et failover, en cas de perte du site principal.
Signal d'alerteForcer un failover pour tenir l'horaire, ou ignorer comment les applications retrouvent la nouvelle base primaire.
Question 5 · confirmé
Dynatrace ouvre un problème qui regroupe quarante alertes à 2 h du matin. Comment vous en servez-vous pour trouver la cause ?
Une bonne réponseIl part de l'entité désignée comme cause probable, vérifie dans la topologie (Smartscape) les services touchés et leurs dépendances, cherche les événements proches (déploiement, changement de configuration, redémarrage) et confirme par les journaux et les métriques. Il garde un regard critique sur la corrélation automatique.
Signal d'alerteTraiter les quarante alertes une par une, ou prendre la cause proposée pour acquise sans vérifier.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
SRE on-premise : les points qui reviennent
SRE on-premise et ingénieur de production, est-ce le même métier ?
Les deux tiennent la production, souvent sur les mêmes outils. L'ingénieur de production exécute les mises en production, surveille et traite les incidents selon les procédures. Le SRE mesure la fiabilité par des SLO, suit un budget d'erreur, prépare et chronomètre les bascules, et cherche à supprimer par l'automatisation les interventions qui reviennent. Sur le CV, les chiffres comptent : temps de reprise mesuré, alertes supprimées, tâches automatisées.
Un SRE habitué au cloud public s'adapte-t-il à un datacenter ?
Il apporte les méthodes : SLO, post-mortems, infrastructure décrite en code. Il lui manque souvent la pratique des composants que le cloud gère à sa place, comme un cluster de bases à deux sites, un gestionnaire de files, un ordonnanceur ou un load balancer physique. L'entretien vérifie sa capacité à diagnostiquer une JVM ou une base sans service managé, et une période d'apprentissage est à prévoir sur les outils internes.
Dynatrace, Splunk, Control-M : chaque outil est-il exigé ?
La catégorie compte, pas forcément la marque. Quelqu'un qui a tenu Zabbix et ELK apprend Dynatrace et Splunk, et passer de Dollar Universe à Control-M demande quelques semaines. Les compétences de fond comptent davantage : lire une topologie, écrire une recherche dans des journaux, comprendre le chemin critique d'une chaîne. L'exigence reste stricte pour l'outil sur lequel la personne sera seule dès le premier mois.
Comment mettre la personne en situation pendant l'entretien ?
L'exercice part d'un incident réel anonymisé : un graphe de temps de réponse, un extrait de thread dump, l'état d'une file MQ, la chronologie des alertes. La personne dit ce qu'elle regarde en premier, ce qu'elle collecte et quand elle redémarre. Une demi-heure suffit. Ce test technique oral montre la méthode et le calme mieux qu'un questionnaire. Le récit d'une bascule de site vécue complète l'exercice.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.