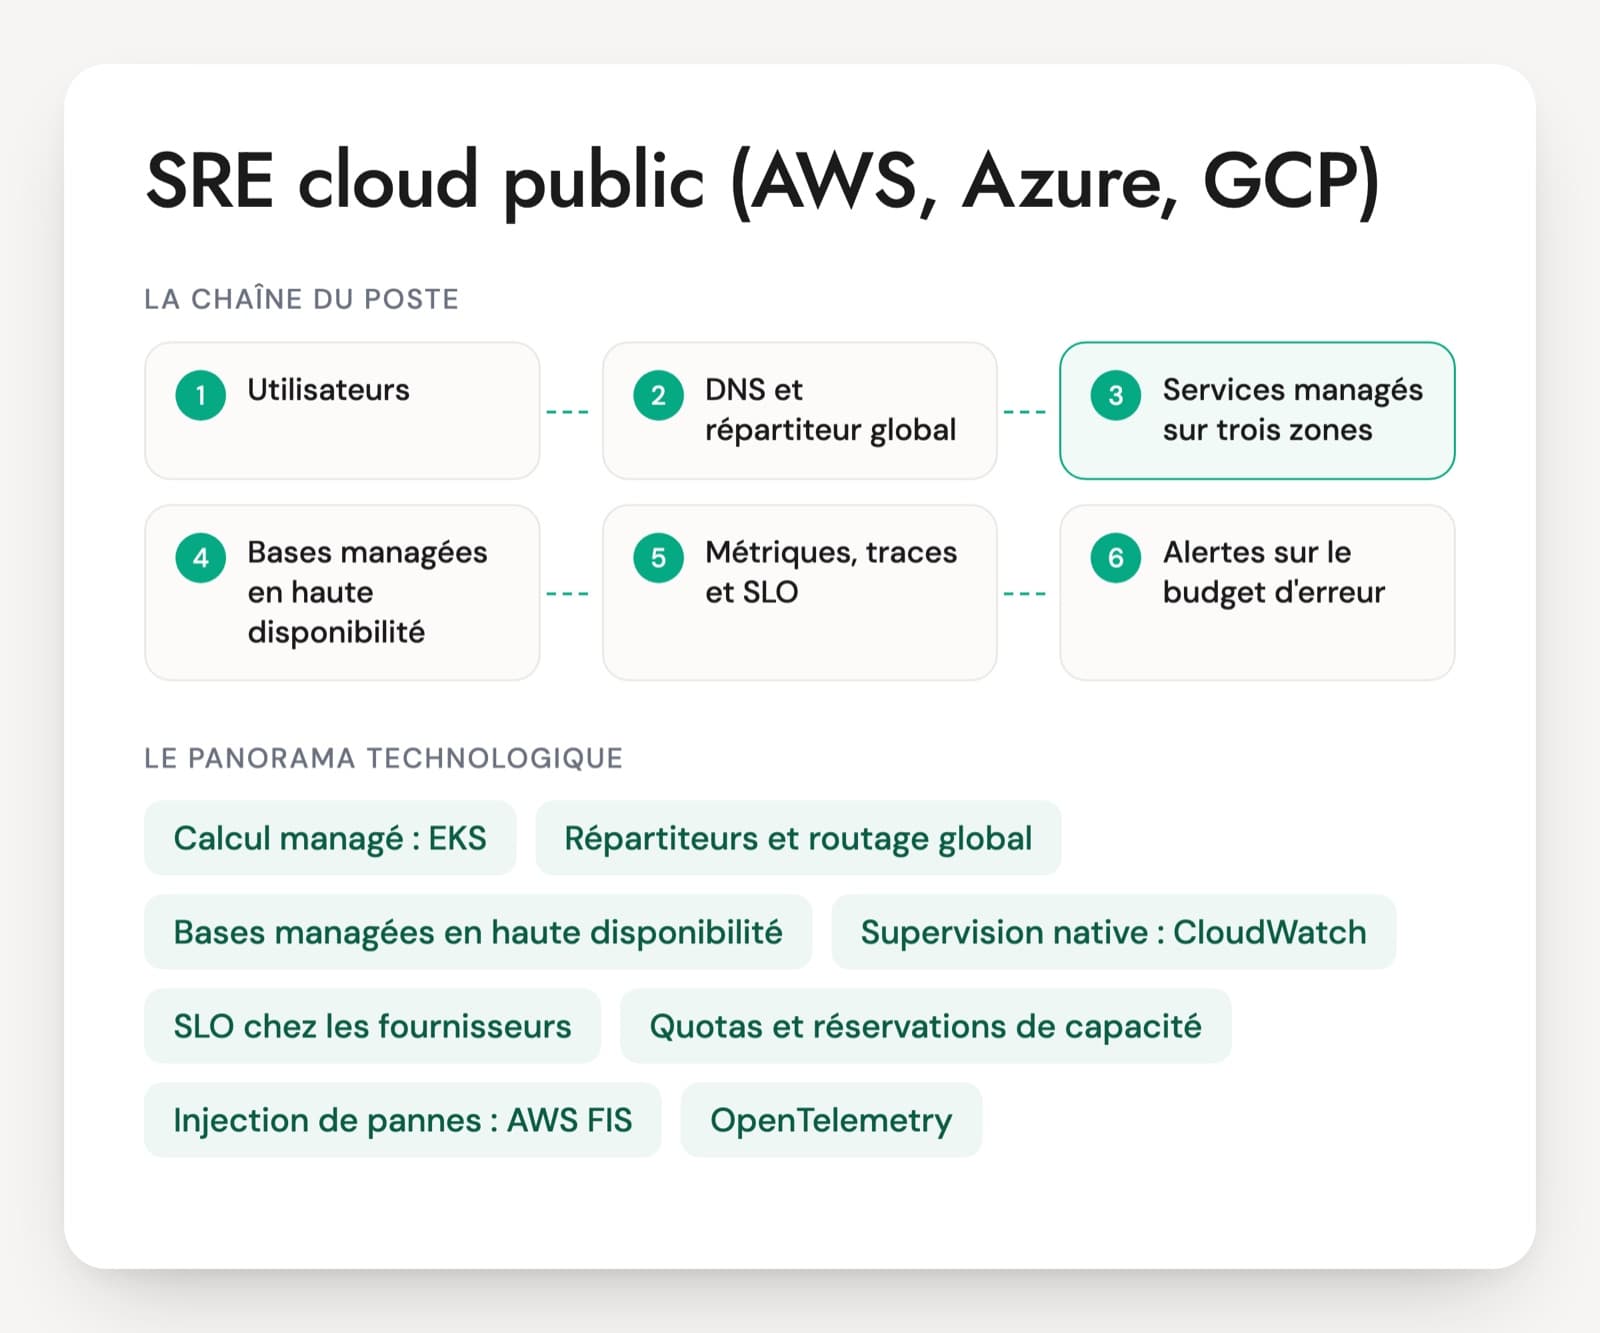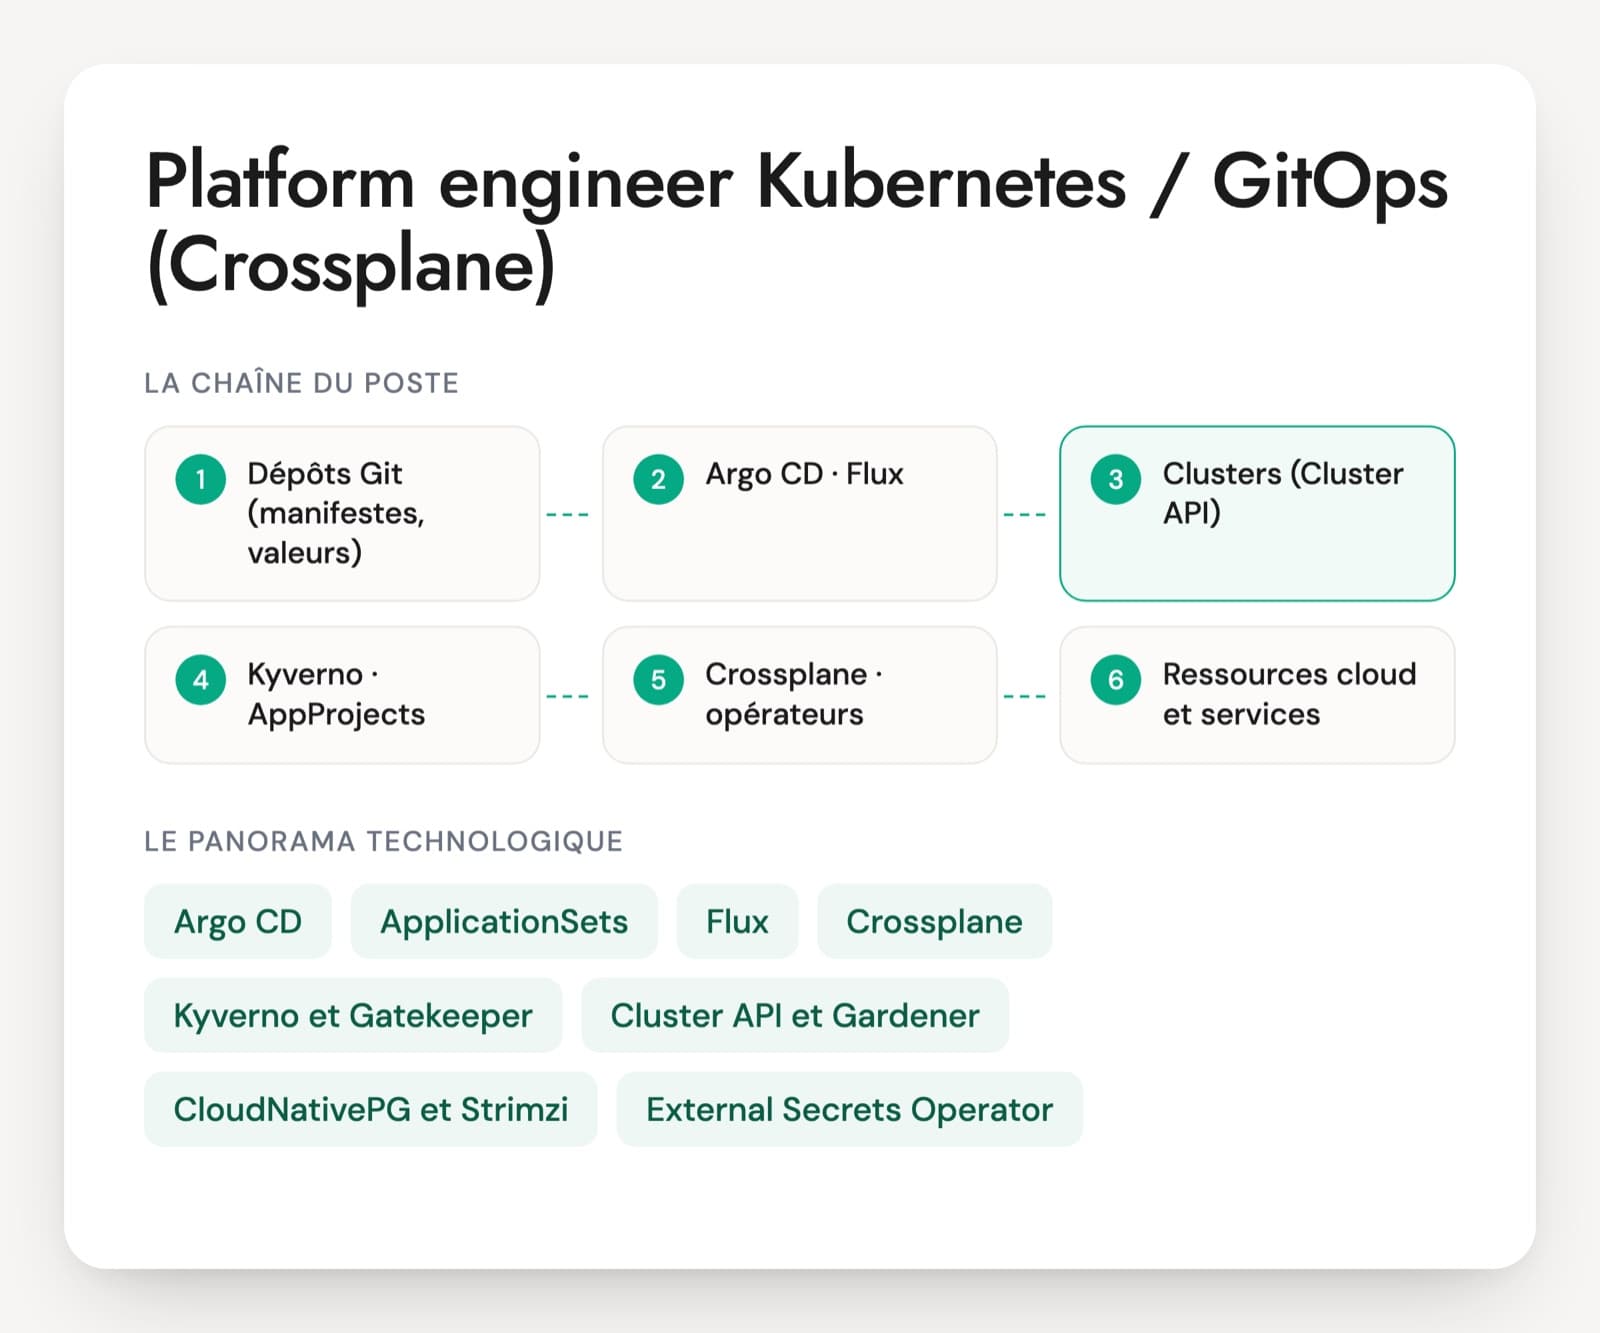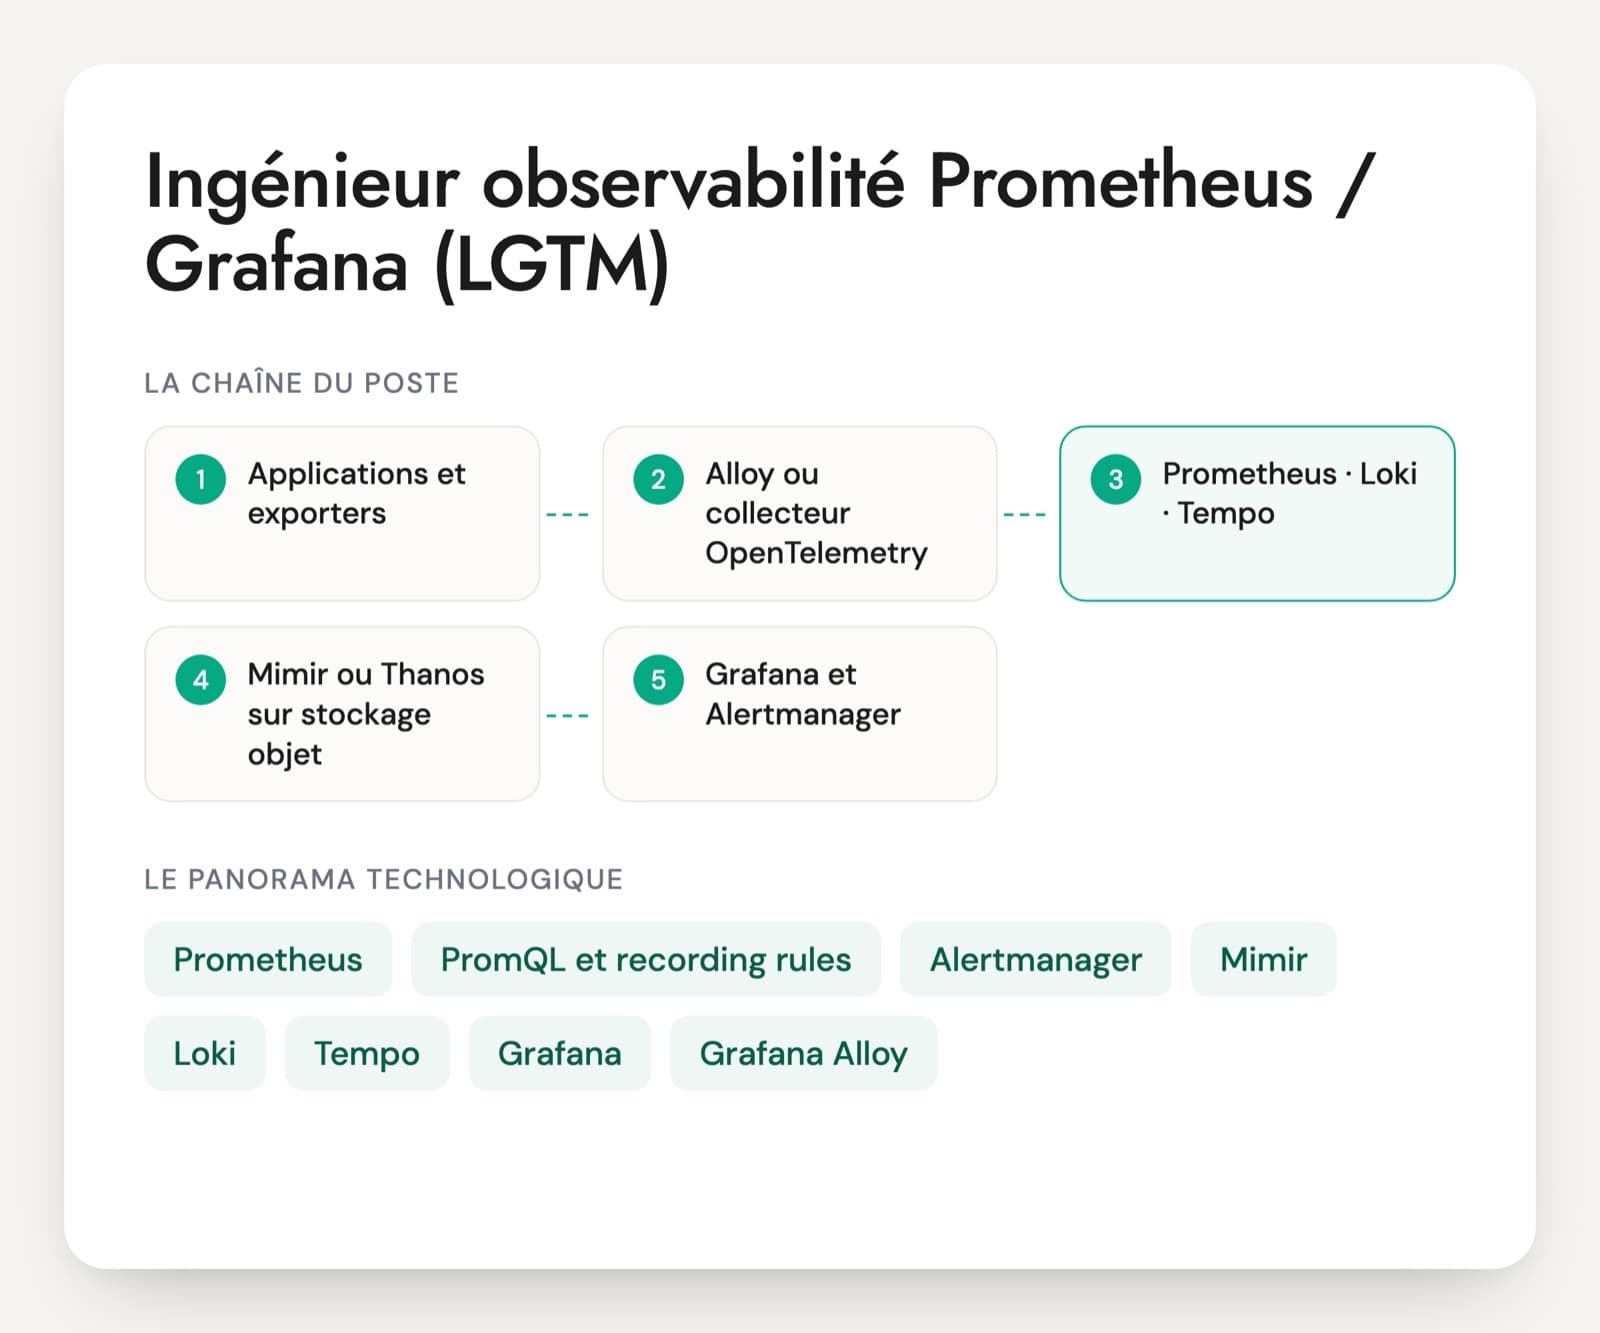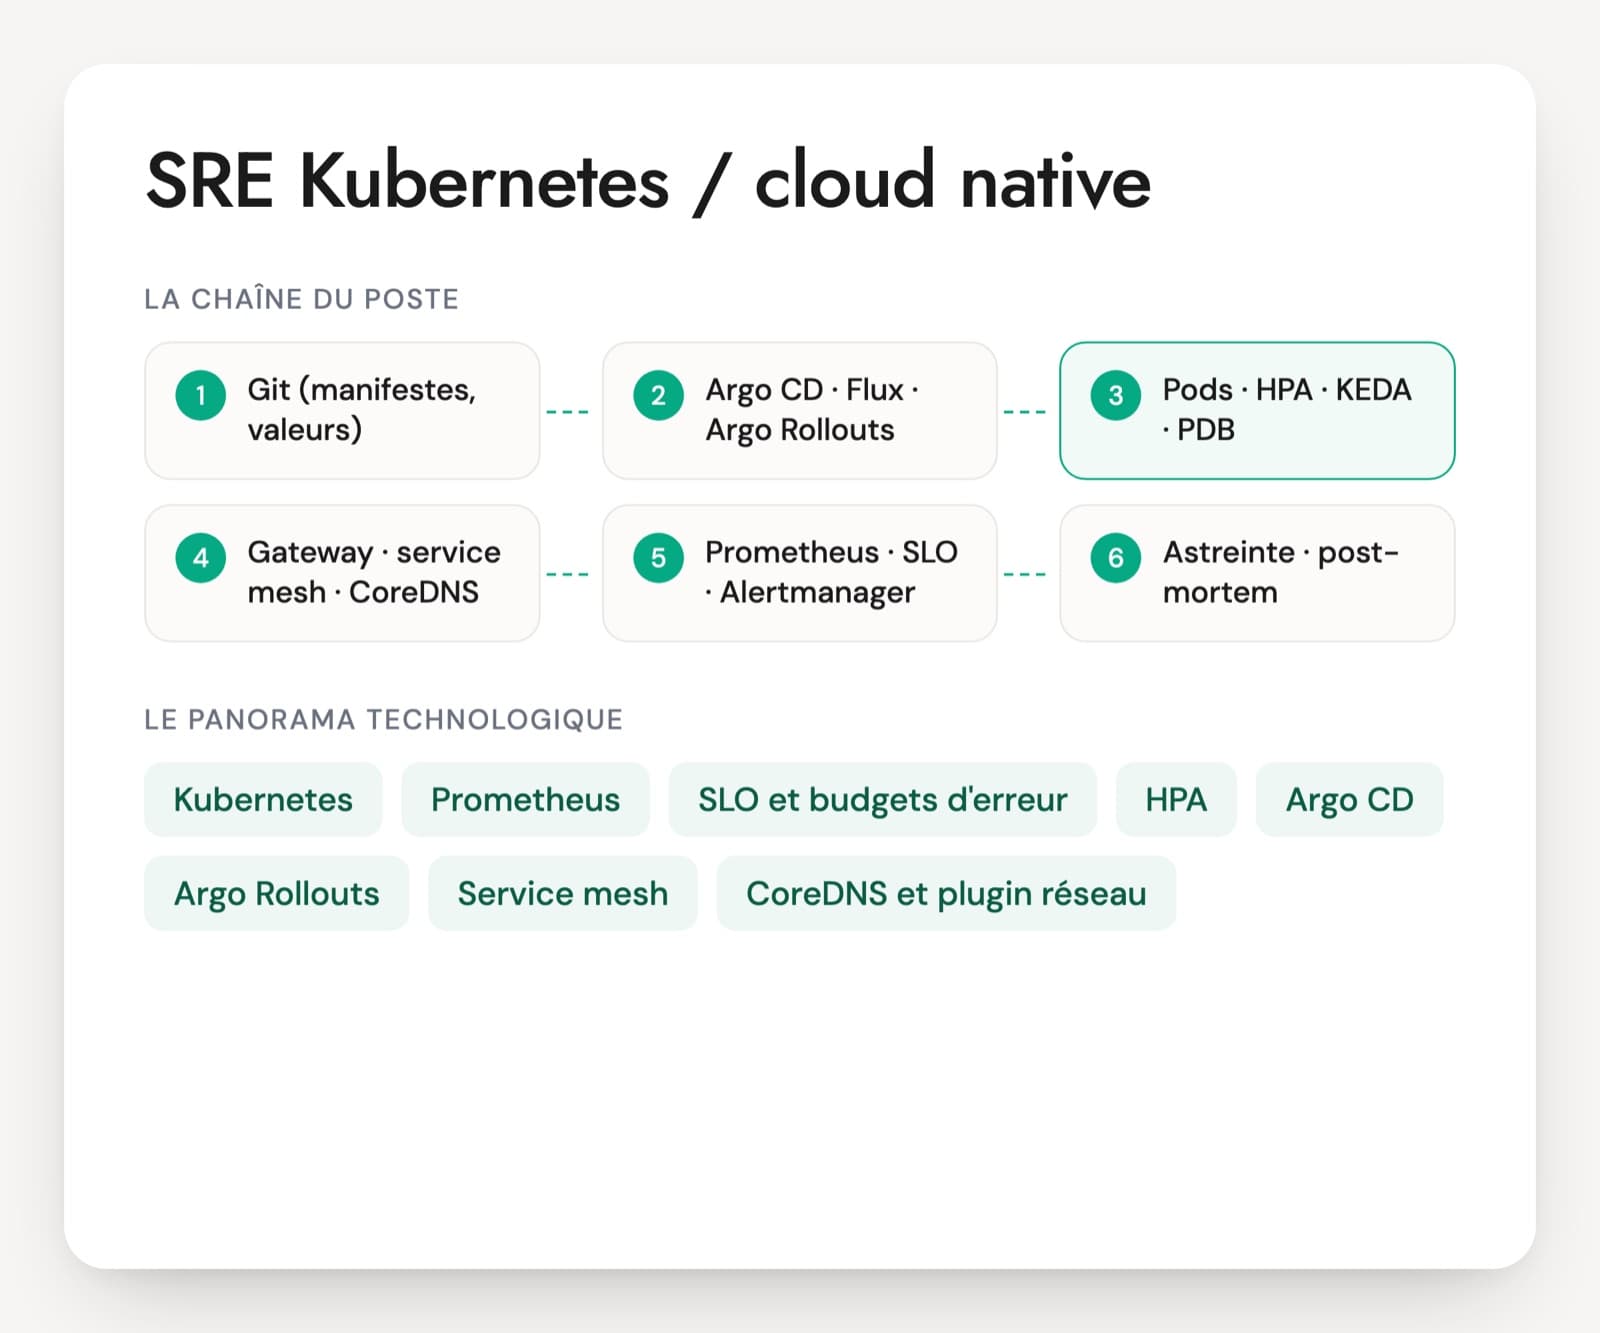
Les questions d'entretien d'un SRE Kubernetes ne sont pas celles d'un administrateur de cluster. La personne reçoit des services déjà conteneurisés et doit les garder dans leurs objectifs : SLO mesurés à l'entrée du cluster, alertes sur le budget d'erreur, requests et limits justes, HPA ou KEDA réglés, PodDisruptionBudgets en place, déploiements progressifs avec Argo CD ou Flux. Elle passe une partie de sa semaine en astreinte et l'autre à supprimer ce qui la fait sonner.
Beaucoup de CV affichent Prometheus, Istio et Argo CD. L'écart se voit sur les incidents. Un profil de production explique pourquoi un service ralentit avec 40 % de CPU, pourquoi trois réplicas sont tombés ensemble pendant un drain, ou pourquoi une option DNS par défaut double la charge de CoreDNS. Un profil qui a surtout suivi des tutoriels décrit les objets sans parler de leur comportement sous charge.
Le contexte compte : ce que l'équipe opère elle-même, clusters managés ou non, mesh en place ou à venir, astreinte partagée avec les développeurs ou non. Le niveau attendu sur le réseau et sur l'autoscaling des nœuds en dépend. Le PDF détaille 30 questions et un cas d'incident de 20 minutes.
Les outils de fiabilité d'un SRE Kubernetes
Kubernetes (services et charges)
Le SRE regarde surtout les objets qui décident du comportement d'un service : Deployment, requests et limits, sondes, PodDisruptionBudget, règles de répartition sur les nœuds et les zones. Une mauvaise valeur sur l'un d'eux suffit à provoquer une panne pendant une maintenance ordinaire.
Prometheus, Prometheus Operator et Alertmanager
La collecte des métriques et les règles d'alerte, déclarées par les équipes avec des ServiceMonitor et des PrometheusRule. Alertmanager regroupe les alertes et les envoie à la bonne astreinte. Grafana affiche les tableaux de bord, OpenTelemetry s'ajoute souvent pour les traces.
SLO et budgets d'erreur
Un SLO fixe l'objectif de fiabilité d'un service, par exemple 99,9 % de requêtes réussies sur 30 jours. Le budget d'erreur correspond à ce qui reste permis. Des outils comme Sloth ou Pyrra génèrent les règles Prometheus à partir d'une définition simple.
HPA, VPA et KEDA
Trois mécanismes d'autoscaling. L'HPA ajoute des pods, le VPA ajuste les ressources demandées par chaque pod, KEDA déclenche la montée en charge à partir d'une file ou d'un flux d'événements. Leur réglage pèse directement sur la tenue des pics et sur la facture.
Argo CD ou Flux
Les outils GitOps qui appliquent sur les clusters ce que décrit Git. Pour un SRE, la question porte sur la manière de limiter l'effet d'une erreur : déploiement par vagues, contrôles avant fusion, retour arrière.
Argo Rollouts ou Flagger
Des contrôleurs de déploiement progressif. Ils envoient une petite part du trafic vers la nouvelle version, interrogent les métriques et annulent la livraison si elles se dégradent.
Service mesh (Istio, Linkerd)
Une couche réseau qui ajoute le chiffrement mTLS entre services, des métriques par appel, des délais, des retries et des coupe-circuits. Istio propose un mode sidecar et un mode ambient, sans proxy dans chaque pod. Un mesh mal réglé peut aggraver un incident.
CoreDNS et plugin réseau (CNI)
La résolution de noms et le réseau des pods. Les timeouts DNS sous charge et les NetworkPolicy trop strictes font partie des incidents les plus fréquents sur un cluster. Cilium et Calico sont les plugins réseau qu'on croise le plus souvent.
Le poste apparaît dès qu'une part importante des applications tourne sur Kubernetes, managé (EKS, AKS, GKE) ou sur site. Le titre recouvre parfois un rôle d'administrateur de cluster : la part du travail consacrée aux services et à l'astreinte fait la différence. Le SRE Kubernetes écrit du code d'outillage, le plus souvent en Python ou en Go, et travaille avec les équipes de développement sur les SLO et les post-mortems. La certification CKA atteste la connaissance de Kubernetes, pas la pratique des SLO ni de la conduite d'incident, qui se vérifient en entretien.
Ce qui distingue un SRE Kubernetes d'un administrateur de cluster
- SLI, SLO et alertes sur le budget d'erreur
- Ressources, QoS et autoscaling
- Disponibilité des pods et déploiements progressifs
- GitOps et maîtrise des changements
- Réseau du cluster, DNS et service mesh
- Conduite d'incident et réduction du toil
Cinq cas de fiabilité sur Kubernetes, avec la réponse attendue
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Vous devez poser un SLO de disponibilité sur une API servie par Kubernetes. Quel SLI choisissez-vous, et où le mesurez-vous ?
Une bonne réponseLa part des requêtes réussies, c'est-à-dire sans erreur 5xx et sous un seuil de latence, sur une fenêtre de 28 ou 30 jours. On la mesure au plus près de l'utilisateur : à l'entrée du cluster (Gateway, ingress, load balancer) ou dans le service mesh. Les erreurs 4xx dues au client sont exclues ou traitées à part.
Signal d'alerteLe nombre de pods prêts, l'utilisation CPU ou un ping toutes les minutes : des indicateurs qui restent au vert pendant que les utilisateurs reçoivent des erreurs.
Question 2 · confirmé
Une équipe veut être alertée à chaque redémarrage de pod. Que lui proposez-vous à la place ?
Une bonne réponseUn redémarrage isolé ne dit rien de ce que vivent les utilisateurs. La page part sur une alerte de consommation du budget d'erreur, avec deux fenêtres : par exemple un burn rate de 14,4 sur une heure confirmé sur cinq minutes pour un SLO à 99,9 %. Les redémarrages répétés deviennent un ticket (hausse de kube_pod_container_status_restarts_total sur plusieurs heures) et un panneau du tableau de bord. Le tout est déclaré dans une PrometheusRule de l'équipe.
Signal d'alerteAccepter la demande, ou alerter sur un taux d'erreur instantané au-dessus de 1 %, qui réveille l'astreinte pour des pics sans conséquence.
Question 3 · confirmé
Un service ralentit à chaque pic de charge, alors que ses pods n'utilisent que 40 % de leur CPU en moyenne. Que regardez-vous ?
Une bonne réponseLe throttling CPU. La limite est appliquée par tranche de 100 ms par le noyau : un pod peut être bridé pendant les pics tout en affichant une moyenne basse. La métrique container_cpu_cfs_throttled_periods_total le montre. Selon la politique du cluster, il relève ou retire la limite CPU en gardant des requests justes, puis vérifie la cible de l'HPA.
Signal d'alerte« Le CPU est à 40 %, ce n'est pas le CPU », ou ajouter des réplicas sans diagnostic.
Question 4 · confirmé
Une maintenance des nœuds a coupé un service pendant quatre minutes alors qu'il avait trois réplicas. Comment l'expliquez-vous ?
Une bonne réponseLes trois pods étaient sur le même nœud ou la même zone, et aucun PodDisruptionBudget n'empêchait le drain de les expulser ensemble. Il ajoute un PDB (minAvailable ou maxUnavailable), des topologySpreadConstraints sur les nœuds et les zones, et vérifie que la readiness est assez rapide pour que les nouveaux pods prennent le relais.
Signal d'alerte« Il faut plus de réplicas », sans voir que trois réplicas mal répartis tombent ensemble.
Question 5 · senior
Un changement de configuration poussé dans Git a cassé la production sur tous les clusters en même temps. Que changez-vous dans la chaîne ?
Une bonne réponseLe déploiement par vagues : un cluster de production d'abord, les autres après une période d'observation, avec des répertoires ou des révisions distincts par groupe de clusters. Des contrôles dans la CI avant fusion (validation des schémas avec kubeconform, règles avec conftest), des fenêtres de synchronisation, et un retour arrière par revert.
Signal d'alerte« On interdit les déploiements le vendredi » comme seule mesure.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
SRE Kubernetes : réponses aux questions fréquentes
En quoi un SRE Kubernetes diffère-t-il d'un ingénieur Kubernetes ?
L'ingénieur Kubernetes construit et maintient les clusters : installation, montées de version, réseau, stockage, sécurité. Le SRE Kubernetes part des services qui y tournent et de leurs utilisateurs. Il définit les SLO, règle l'autoscaling et les protections des pods, conduit les incidents et réduit le travail manuel. Les deux partagent beaucoup de connaissances. Pour un premier SRE dans une équipe, mieux vaut quelqu'un qui a déjà tenu une astreinte sur des services en production.
La CKA ou la CKAD sont-elles exigées pour un SRE Kubernetes ?
Pas forcément, mais elles comptent. Ce sont des examens en ligne de commande sur un vrai cluster, qui prouvent une pratique réelle de Kubernetes. La CKA porte sur l'administration, la CKAD sur le déploiement d'applications. Aucune ne couvre les SLO, l'alerting ou la conduite d'incident. Elles forment un socle, et l'entretien porte sur des situations de production vécues.
Quel niveau de code est attendu d'un SRE Kubernetes ?
Assez pour écrire et maintenir de l'outillage : un script Python ou un petit programme Go qui interroge l'API Kubernetes, un exporter Prometheus, une automatisation d'astreinte. Il doit aussi lire le code des services pour comprendre un incident, et lire une trace d'erreur Go ou Java. Le poste ne demande pas un développeur produit, mais quelqu'un qui préfère supprimer une tâche manuelle par du code plutôt que la répéter.
Live coding, cas d'incident ou exercice à la maison : que choisir pour un SRE ?
Le cas d'incident apporte le plus. À partir des graphes et des journaux d'une panne réelle anonymisée, la personne mène l'enquête à voix haute. On voit son ordre de recherche et ses réflexes de réduction d'impact. Un test technique court sur un cluster kind avec une application mal configurée complète bien. L'exercice à la maison mesure surtout le temps libre du candidat.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.