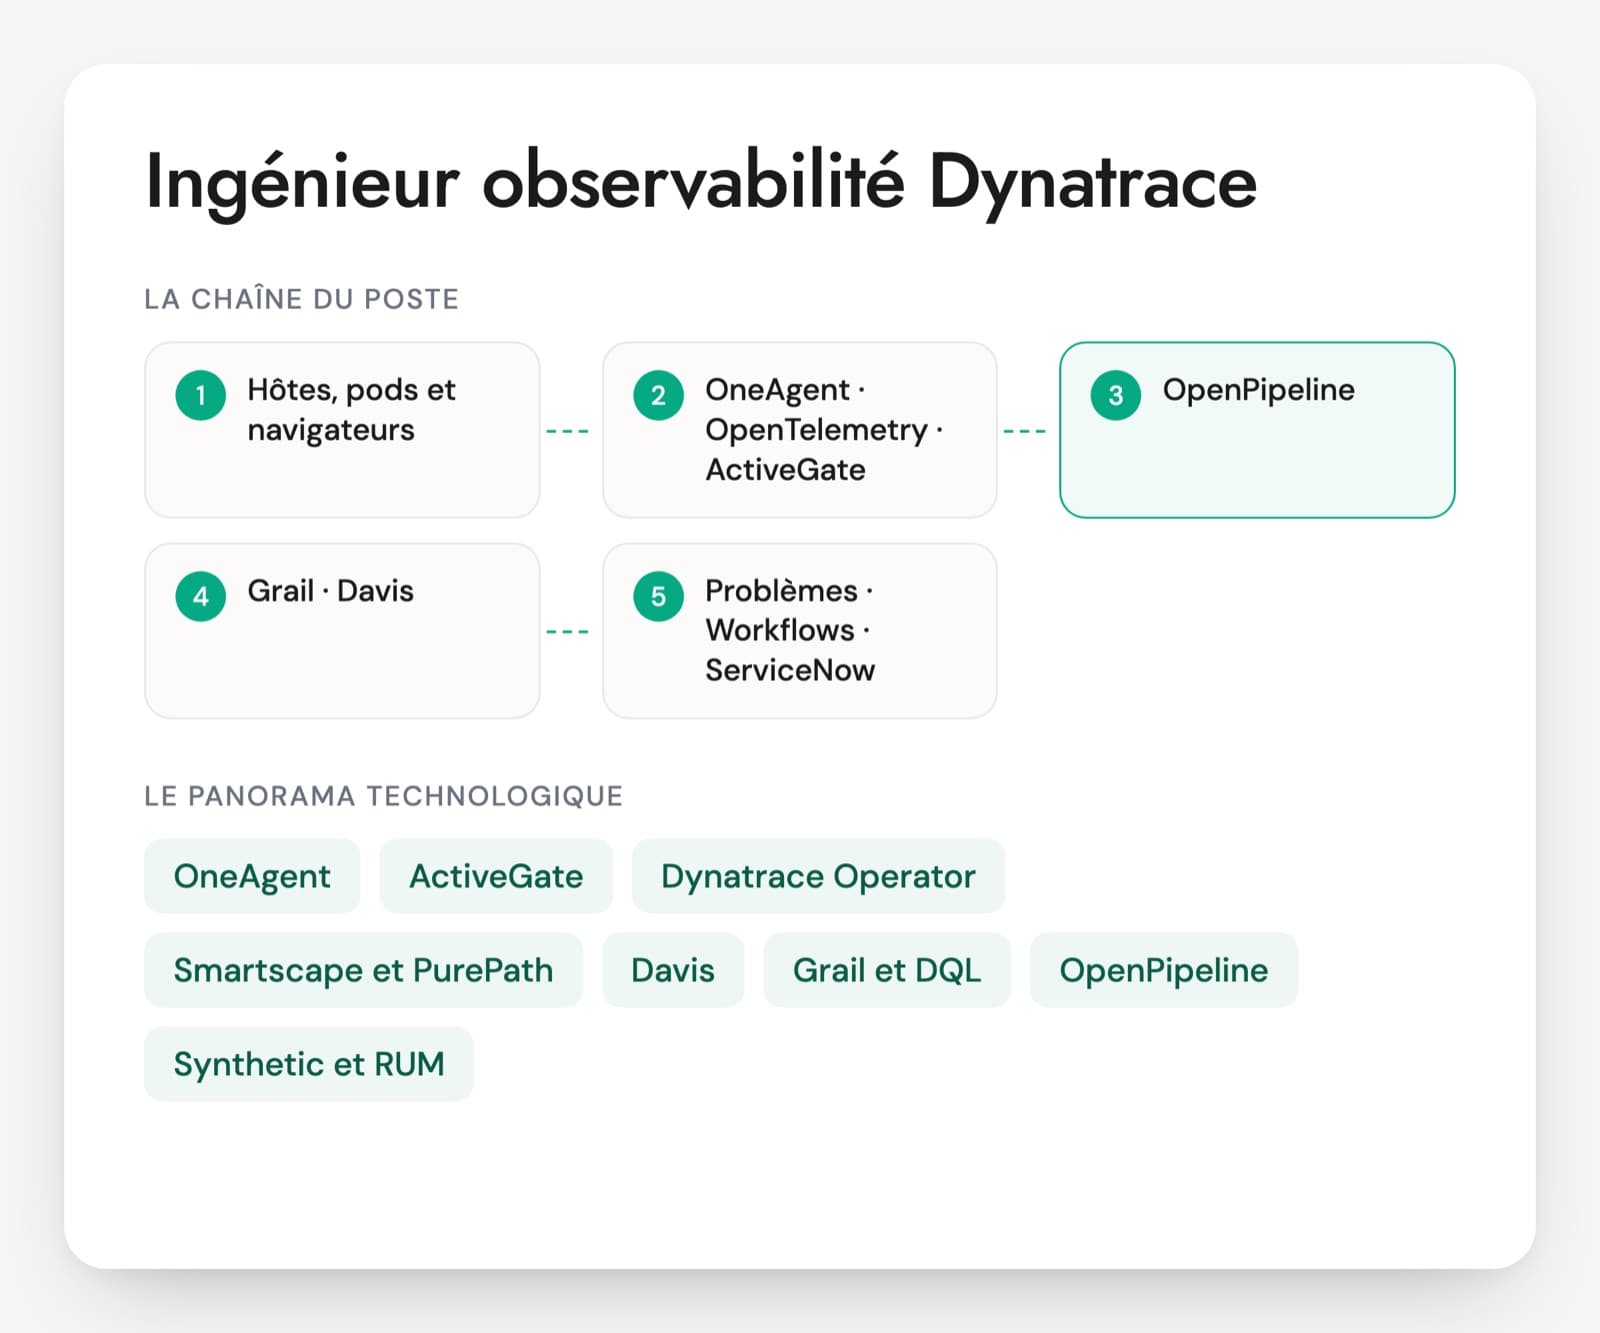
Qu'elles parlent d'ingénieur observabilité Dynatrace ou d'expert Dynatrace, les offres décrivent le même socle. Déployer OneAgent et les ActiveGate, intégrer AWS, Azure et les clusters Kubernetes, construire tableaux de bord et alertes, puis accompagner les équipes applicatives. Les missions récentes ajoutent Grail, OpenPipeline, le langage DQL, les Workflows et la configuration as code avec Monaco ou Terraform.
Deux générations de l'outil cohabitent. La version classique repose sur les management zones, le sélecteur de métriques et les anciens tableaux de bord. La plateforme actuelle stocke logs, métriques, traces et événements dans Grail et s'interroge en DQL. Un profil qui n'a connu que la première sait installer et régler, mais bute sur la migration des tableaux de bord et des droits. La version pratiquée compte, comme le mode de l'environnement, SaaS ou Managed.
Le reste se vérifie sur des cas précis : un service absent des traces, un problème ouvert par Davis que personne ne comprend, une consommation de logs qui grimpe. Quelqu'un qui a tenu la plateforme cite le réglage, l'écran ouvert et la requête lancée. Le PDF ajoute un cas de 20 minutes sur l'intégration d'une application.
Les briques Dynatrace qu'un ingénieur observabilité administre
OneAgent
L'agent installé sur chaque hôte, VM ou nœud Kubernetes. Il découvre les processus, instrumente Java, .NET, Node.js ou PHP sans modifier le code et remonte métriques, traces et logs. Les modes full-stack, infrastructure et découverte changent la couverture et la licence consommée. Reste à savoir comment la personne choisit.
ActiveGate
Le relais entre les agents et Dynatrace. Il regroupe le trafic d'un site, porte les extensions, la surveillance des API cloud et les moniteurs synthétiques privés. Sans ActiveGate bien placé, un datacenter fermé à Internet ne remonte rien.
Dynatrace Operator
Sur Kubernetes, l'opérateur déploie OneAgent et ActiveGate à partir d'une ressource DynaKube. Le mode cloud-native full-stack instrumente les pods à leur démarrage. Les pods lancés avant l'opérateur restent sans instrumentation jusqu'à leur redémarrage, un oubli fréquent.
Smartscape et PurePath
Smartscape est la carte des dépendances entre hôtes, processus, services et applications, calculée en continu. PurePath est la trace distribuée de Dynatrace, de bout en bout pour chaque requête. Deux services qui ne sont pas reliés sur la carte signalent souvent un composant non instrumenté ou un en-tête de trace perdu.
Davis (Dynatrace Intelligence)
Le moteur qui apprend le comportement normal, détecte les anomalies et regroupe les événements en un problème avec sa cause racine. La documentation actuelle le présente sous le nom Dynatrace Intelligence, mais les CV et les équipes disent encore Davis. Son réglage décide du nombre d'alertes que reçoit l'astreinte.
Grail et DQL
Grail stocke logs, métriques, traces, événements et entités dans des buckets qui ont chacun leur rétention. DQL est son langage de requête, fait de commandes enchaînées comme fetch, filter ou summarize. C'est la compétence la plus demandée dans les missions récentes, et celle qui manque aux profils restés sur la version classique.
OpenPipeline
La chaîne de traitement à l'entrée de Grail. Elle filtre, découpe et masque les données, en extrait des métriques et les range dans le bon bucket. Les données personnelles dans les logs et le coût d'ingestion se règlent ici.
Synthetic et RUM
Les moniteurs synthétiques appellent une API ou rejouent un parcours depuis des emplacements publics ou privés. Le RUM mesure ce que vivent les vrais utilisateurs dans le navigateur ou l'application mobile. Ils montrent si le parcours client fonctionne, ce que l'APM côté serveur ne dit pas.
Monaco, Terraform et API
La configuration as code. Monaco (Monitoring as Code) et le provider Terraform décrivent alertes, tableaux de bord et droits dans Git, et l'API sert aux intégrations. Avec plusieurs environnements, c'est la seule façon de garder des réglages identiques partout.
Le titre varie : ingénieur observabilité Dynatrace, expert Dynatrace, ingénieur Dynatrace ou consultant APM. Le poste se partage entre l'administration de la plateforme (agents, ActiveGate, droits, licence), l'intégration des applications et l'appui aux équipes pendant les incidents. Dynatrace existe en SaaS et en version Managed hébergée chez le client, et beaucoup de missions actuelles portent sur le passage au SaaS et à la plateforme Grail. Les offres citent aussi Kubernetes, AWS ou Azure, Python, Terraform et parfois Grafana ou Splunk à côté. Dynatrace propose des certifications de niveau Associate et Professional. Elles attestent la connaissance du produit. La tenue d'un parc en production se vérifie en entretien.
Ce qu'on attend d'un ingénieur Dynatrace sur la plateforme
- Déploiement OneAgent et ActiveGate
- Instrumentation et traces distribuées
- Détection d'anomalies et alerting
- Requêtes DQL et données dans Grail
- Droits, données sensibles et licence
- Configuration as code et automatisation
Dynatrace en entretien, cinq questions et la réponse à attendre
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Un service Java tourne sur un hôte où OneAgent est installé, mais il n'apparaît dans aucun PurePath. Que vérifiez-vous ?
Une bonne réponseLe mode de l'agent d'abord : en mode infrastructure ou découverte, le code n'est pas instrumenté. Puis le redémarrage du processus, nécessaire quand l'agent a été installé après son lancement. Ensuite la version de Java dans la matrice de support, une règle de surveillance des processus qui exclut ce groupe, et le statut d'injection affiché sur la page du processus. Sur Kubernetes, le mode de déploiement choisi dans l'opérateur et le webhook d'injection.
Signal d'alerteRéinstaller l'agent sans regarder son mode ni l'état du processus. Ou conclure que Dynatrace ne sait pas suivre ce service.
Question 2 · senior
L'astreinte reçoit chaque nuit une dizaine de problèmes Davis sur des temps de réponse, et la plupart se referment seuls en quelques minutes. Comment réduisez-vous ce bruit sans rater une vraie panne ?
Une bonne réponseIl regarde d'abord quels services ouvrent ces problèmes, à quelle heure et pour combien de temps. Puis il règle la détection d'anomalies du service : seuil fixe ou référence automatique, sensibilité, trafic minimal en dessous duquel on n'alerte pas. Les profils d'alerte ne notifient qu'au-delà d'une gravité ou d'une durée. Les traitements de nuit connus passent en fenêtre de maintenance. Les services importants gardent une alerte, de préférence sur un SLO plutôt que sur chaque pic.
Signal d'alerteDésactiver Davis sur les services bruyants, ou filtrer les notifications dans ServiceNow sans toucher à la détection.
Question 3 · confirmé
On vous demande en DQL les dix services qui ont renvoyé le plus d'erreurs HTTP 5xx sur les dernières 24 heures. Comment écrivez-vous la requête, et sur quelles données ?
Une bonne réponseIl part des spans (fetch spans) ou d'une métrique de service déjà calculée, filtre les codes de réponse à partir de 500, regroupe par service avec summarize et count(), trie avec sort et garde dix lignes avec limit. Il borne la période. Il sait que lire des spans brutes sur 24 heures coûte plus qu'interroger une série temporelle avec timeseries, et il récupère le nom lisible du service à partir de l'identifiant d'entité.
Signal d'alerteDu SQL classique, ou le sélecteur de métriques de la version classique, sans connaître fetch, filter et summarize. Ou une requête sans limite de temps.
Question 4 · confirmé
Des logs applicatifs envoyés à Dynatrace contiennent des numéros de carte et des adresses e-mail. Que mettez-vous en place ?
Une bonne réponseUn masquage au plus tôt : dans les règles de données sensibles de la collecte de logs de OneAgent, ou dans une règle de traitement OpenPipeline à l'ingestion, avant le stockage dans Grail. Un bucket dédié avec une rétention courte pour ces logs et des politiques d'accès qui limitent qui peut les lire. Il demande aussi à l'équipe de corriger la source, car un masquage ne couvre que les formats prévus. Pour ce qui est déjà stocké, il vérifie ce que la plateforme permet de supprimer et prévient le DPO.
Signal d'alerteRestreindre l'accès aux tableaux de bord en pensant que les données sont protégées, ou attendre que les développeurs corrigent leur code.
Question 5 · senior
Vous migrez un environnement classique vers la plateforme Grail. Que deviennent les management zones qui servaient à cloisonner les équipes ?
Une bonne réponseLes management zones relèvent de la version classique. Sur la plateforme actuelle, le filtrage des vues passe par les segments, et l'accès aux données de Grail par des politiques IAM, souvent écrites sur des tags ou des attributs comme le nom de l'équipe. Il inventorie les zones existantes, fixe une règle de tagging commune, réécrit les droits et teste avec un utilisateur de chaque équipe avant de couper l'ancien accès. Il prévient que les tableaux de bord classiques doivent aussi être convertis.
Signal d'alertePenser que les management zones s'appliquent telles quelles aux données Grail, ou tout ouvrir à tout le monde le temps de la migration.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Dynatrace : profil, certification, SaaS ou Managed
Un profil Datadog ou Splunk peut-il reprendre une plateforme Dynatrace ?
Les notions se transposent : traces distribuées, alertes, SLO, coût des logs. Ce qui change, c'est l'outillage propre à Dynatrace, avec OneAgent et son injection automatique, la topologie Smartscape, la façon dont Davis ouvre les problèmes et le langage DQL. Un profil solide sur un autre outil devient autonome en quelques semaines sur l'usage courant. Pour une mission de migration vers Grail ou d'administration d'un grand parc, l'expérience directe de Dynatrace fait gagner beaucoup de temps.
Faut-il exiger une certification Dynatrace ?
Elle aide à trier, sans suffire. Les certifications Associate puis Professional montrent que la personne connaît le produit et ses écrans. Elles ne disent pas si elle a déjà déployé l'opérateur sur un cluster, réduit le bruit des alertes d'une astreinte ou migré des droits vers Grail. Un exemple précis sur chacun de ces sujets, avec les réglages utilisés, pèse davantage. Une certification sans exemple concret reste à confirmer par une mise en situation.
Quel test technique est donné à un ingénieur Dynatrace ?
Un exercice court en entretien fonctionne mieux qu'un devoir à la maison. À partir d'une capture d'un problème Davis, la personne lit l'analyse et dit ce qu'elle vérifierait. Vient ensuite une requête DQL à écrire au tableau, par exemple les services les plus en erreur sur 24 heures. En vingt minutes, on voit si elle connaît la plateforme actuelle et si elle raisonne à partir des données.
Dynatrace SaaS ou Managed : le profil recherché change-t-il ?
En Managed, le client héberge les nœuds du cluster Dynatrace : l'ingénieur gère aussi leur dimensionnement, leurs mises à jour et leurs sauvegardes. En SaaS, l'éditeur s'en charge, et le travail se concentre sur les agents, la configuration, les droits et les nouvelles fonctions comme Grail ou les Workflows. Pour une migration de Managed vers SaaS, le bon profil connaît les deux et qui a déjà converti tableaux de bord et alertes.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.