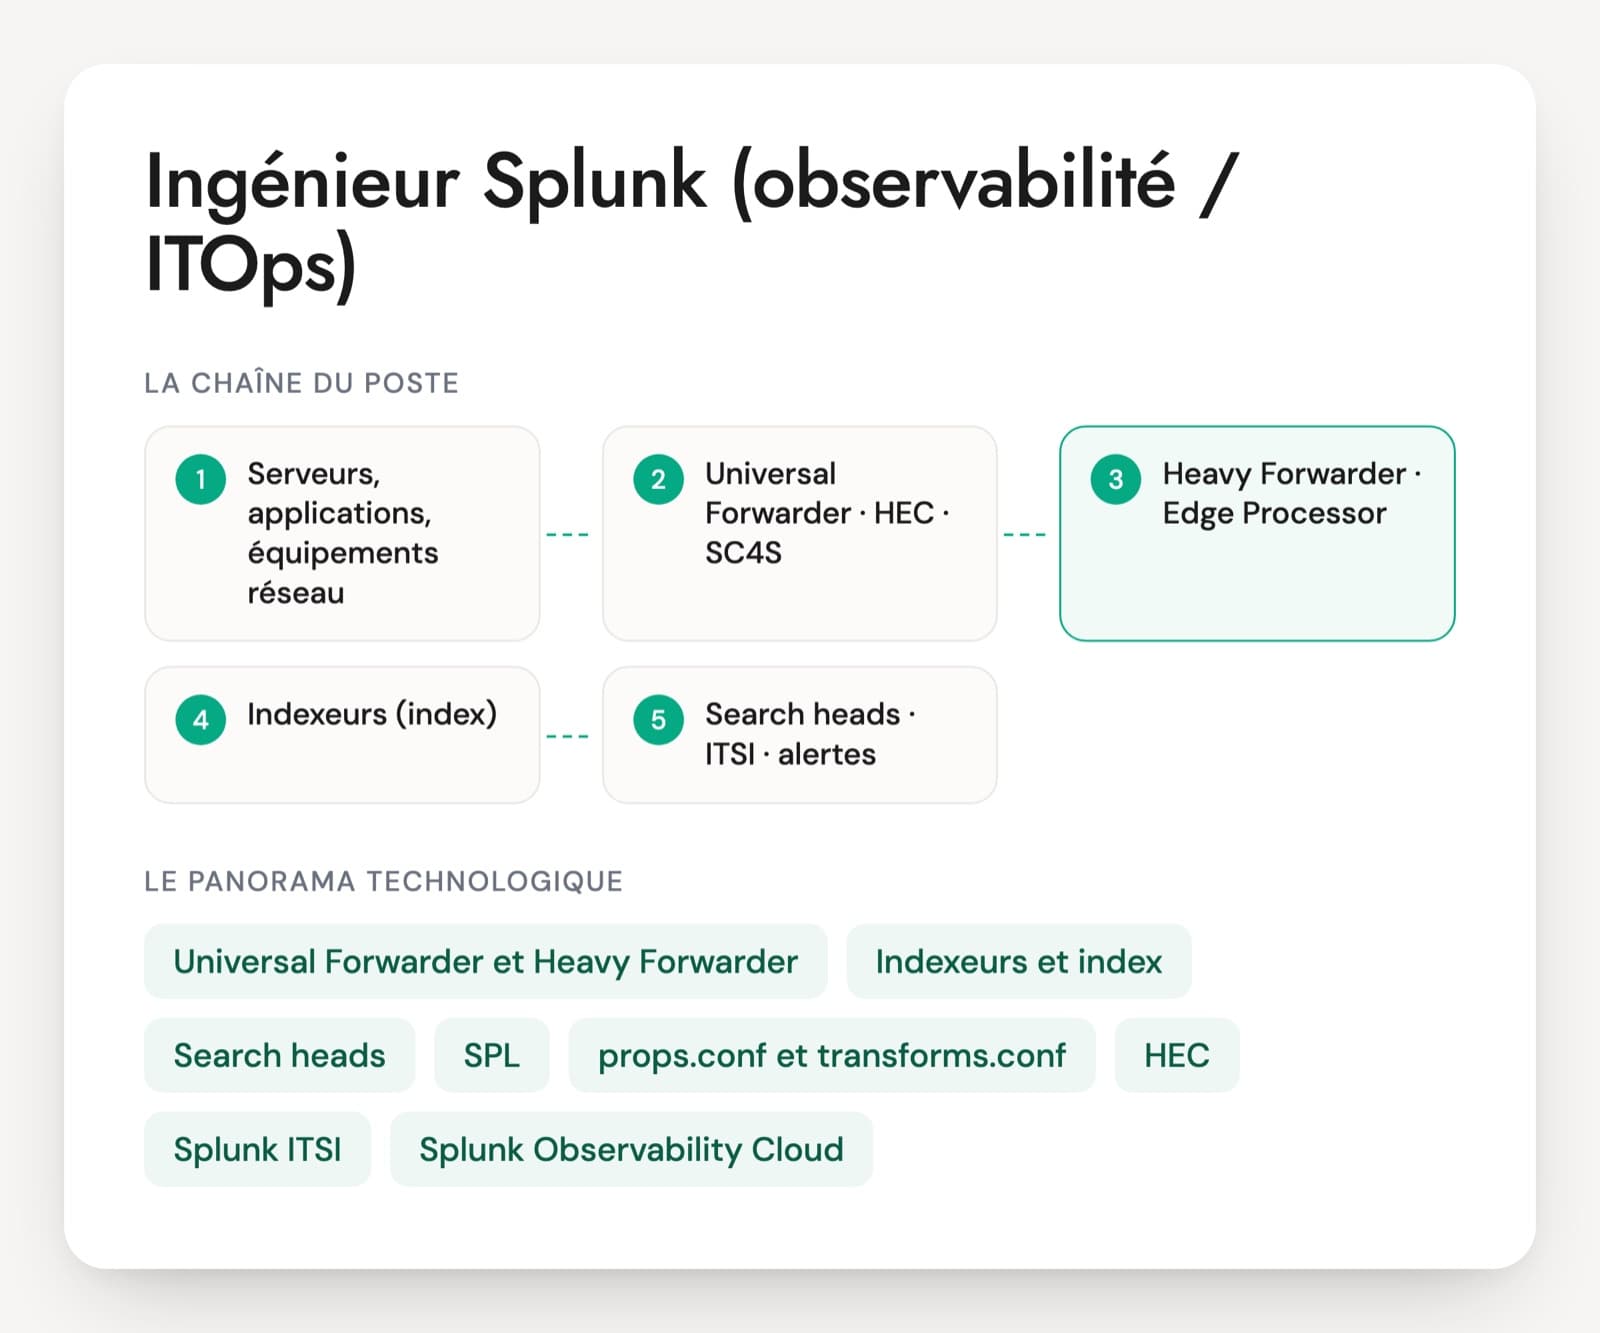
Côté exploitation, les offres parlent d'expert Splunk, d'administrateur Splunk ou d'ingénieur Splunk observabilité. On y retrouve l'architecture search heads, indexeurs et forwarders, l'intégration continue de nouvelles sources, le SPL pour les recherches et les tableaux de bord, le support de niveau 3 et l'administration Linux. Rsyslog, SC4S, le HTTP Event Collector, Ansible et Python reviennent souvent.
Le même titre recouvre deux métiers. Un profil SIEM écrit des règles de détection et connaît le CIM et Enterprise Security. Un profil ITOps suit des services, des temps de réponse et des volumes, et construit des KPI dans ITSI. Les deux partagent SPL et l'architecture, pas les cas d'usage. Le rôle de la plateforme tenue compte, et le fait qu'elle tournait sur Splunk Enterprise ou sur Splunk Cloud Platform, où l'administration n'est pas la même.
La licence pèse sur le quotidien. Selon le contrat, Splunk facture le volume ingéré par jour ou la capacité de calcul consommée, et chaque nouvelle source se discute. Un bon candidat sait dire combien de gigaoctets envoie une source et comment réduire ce volume. Le PDF contient un cas de 20 minutes sur la supervision d'une API de commande.
La plateforme Splunk vue depuis l'exploitation
Universal Forwarder et Heavy Forwarder
Le universal forwarder est un agent léger installé sur les serveurs : il lit des fichiers ou des journaux et les envoie aux indexeurs. Le heavy forwarder est une instance Splunk complète qui peut découper, filtrer, router ou masquer avant l'envoi. Un deployment server distribue leur configuration à des milliers de machines.
Indexeurs et index
Les indexeurs stockent les événements dans des index découpés en buckets, qui passent de hot à warm, cold puis frozen. En cluster, le facteur de réplication fixe le nombre de copies et le facteur de recherche le nombre de copies interrogeables. Le découpage en index règle à la fois les droits et la durée de conservation.
Search heads
Les serveurs où l'on cherche, et où tournent recherches planifiées, alertes et tableaux de bord. En cluster de search heads, les objets de connaissance (extractions, lookups, macros) sont répliqués. Une recherche planifiée mal écrite peut ralentir la plateforme pour tous les utilisateurs.
SPL
Le langage de recherche de Splunk, une suite de commandes séparées par des barres verticales : search, stats, timechart, eval, rex, lookup. Toutes les offres le demandent. La commande tstats, sur des champs indexés ou des data models accélérés, change l'ordre de grandeur des temps de réponse.
props.conf et transforms.conf
Les fichiers qui disent comment une source est découpée en événements, horodatée, extraite, filtrée ou masquée. Une erreur de coupure ou de fuseau horaire fausse toutes les recherches qui suivent. Le candidat doit savoir ce qui se fait à l'indexation et ce qui se fait à la recherche.
HEC, SC4S, Edge et Ingest Processor
Le HTTP Event Collector reçoit des événements en JSON par HTTPS, depuis une application ou un collecteur OpenTelemetry. Splunk Connect for Syslog (SC4S) reçoit le syslog des équipements réseau. Edge Processor et Ingest Processor filtrent et transforment les données avant l'indexation avec des pipelines écrits en SPL2, surtout pour réduire le volume facturé.
Splunk ITSI
IT Service Intelligence modélise des services et leurs dépendances, calcule des KPI à partir de recherches et en tire un score de santé. Les seuils adaptatifs varient selon l'heure et le jour. Les événements notables sont regroupés en épisodes par des politiques d'agrégation, pour que l'astreinte reçoive un incident au lieu de cent alertes.
Splunk Observability Cloud
Le produit SaaS de métriques et de traces : Infrastructure Monitoring, APM, RUM et monitoring synthétique. La collecte passe par la distribution Splunk du collecteur OpenTelemetry. Les logs restent dans Splunk Platform et s'y relient par Log Observer Connect. Depuis le rachat de Splunk par Cisco, finalisé en mars 2024, AppDynamics a rejoint le portefeuille Splunk Observability sous le nom Splunk AppDynamics.
Dashboard Studio
L'éditeur actuel de tableaux de bord, qui remplace peu à peu les tableaux de bord classiques en Simple XML. Une recherche de base partagée entre panneaux évite de lancer dix fois la même requête à chaque ouverture.
On trouve le poste sous les titres ingénieur Splunk, expert Splunk, administrateur Splunk ou architecte technique Splunk. Il couvre l'architecture et le maintien en conditions opérationnelles de la plateforme, l'arrivée de nouvelles sources, l'écriture de recherches et de tableaux de bord pour les équipes métier et techniques, et le support de niveau 3. Sur Splunk Cloud Platform, une partie de l'administration revient à l'éditeur, et le travail se concentre sur la collecte, les applications et les recherches. Les certifications Splunk (Core Certified Power User, Enterprise Certified Admin, Cloud Certified Admin) attestent la connaissance du produit. La tenue d'une plateforme à forte volumétrie se vérifie en entretien.
SPL, collecte, ITSI : les compétences d'un ingénieur Splunk
- Recherches SPL et performance
- Collecte et parsing des données
- Architecture indexeurs et search heads
- Services, KPI et épisodes ITSI
- Alertes et tableaux de bord
- Licence et volumétrie
Cinq questions Splunk, avec ce que répond un profil expérimenté
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · senior
Une recherche planifiée compte chaque nuit les erreurs par application sur 24 heures, avec search puis stats, et elle met 40 minutes. Comment la réécrivez-vous ?
Une bonne réponseIl ouvre d'abord l'inspecteur de recherche pour voir où passe le temps. Puis il précise l'index, le sourcetype et la période dès la première ligne, filtre au plus tôt et ne garde que les champs utiles. Si le champ d'application est indexé ou couvert par un data model accéléré, tstats lit les métadonnées au lieu des événements bruts et descend à quelques secondes. Sinon, une summary index remplie chaque heure évite de relire 24 heures d'un coup. Il remplace transaction ou join par stats quand c'est possible.
Signal d'alerteAjouter des indexeurs, ou décaler la recherche dans la nuit sans toucher au SPL. Une recherche qui commence par index=*.
Question 2 · confirmé
Une nouvelle application envoie des logs où les exceptions sont coupées en plusieurs événements et où l'heure a deux heures d'écart. Que corrigez-vous, et où ?
Une bonne réponseLe props.conf de ce sourcetype, sur la première instance qui fait le parsing : indexeur ou heavy forwarder, pas le universal forwarder. LINE_BREAKER et SHOULD_LINEMERGE pour la coupure des événements, TIME_PREFIX, TIME_FORMAT et MAX_TIMESTAMP_LOOKAHEAD pour l'horodatage, TZ quand le log n'indique pas son fuseau. Il teste sur un index de test avec un échantillon avant la production, et rappelle que les événements déjà indexés ne seront pas corrigés.
Signal d'alerteCorriger l'heure dans chaque recherche avec eval, ou modifier props.conf sur le search head en pensant changer l'indexation.
Question 3 · confirmé
Le volume ingéré dépasse la licence depuis une semaine. Comment trouvez-vous la source, et que faites-vous ?
Une bonne réponseLe rapport d'utilisation de la licence dans le Monitoring Console, ou une recherche sur license_usage.log dans l'index _internal, par index, sourcetype, source et hôte, pour voir ce qui a grossi et depuis quand. La cause est souvent un niveau de log passé en debug, une boucle d'erreurs ou une nouvelle source mal filtrée. Il corrige à la source, puis écarte ce qui n'a pas de valeur avant l'indexation : envoi vers la nullQueue par transforms.conf, ou pipeline Edge Processor ou Ingest Processor. Il connaît les conséquences d'un dépassement prévues par son type de licence.
Signal d'alerteSupprimer des index pour faire de la place sur la licence, alors qu'elle compte ce qui est ingéré et non ce qui est stocké.
Question 4 · senior
Dans ITSI, vous modélisez un service de commande en ligne qui dépend d'une API, d'une base et d'un service de paiement. Comment construisez-vous ses KPI et son score de santé ?
Une bonne réponseUn service par composant, reliés dans l'arbre des services avec des dépendances pondérées selon leur poids réel. Des KPI qui mesurent ce que voit l'utilisateur, comme le taux d'erreur, la latence et le nombre de commandes, plutôt que le seul CPU. Des recherches de base partagées entre KPI pour limiter la charge, des entités pour séparer les instances, et des seuils adaptatifs appris sur plusieurs semaines quand le trafic varie selon l'heure. Les KPI qui doivent à eux seuls faire chuter le score reçoivent l'importance maximale.
Signal d'alerteUn KPI par métrique système disponible, avec les mêmes seuils fixes le jour et la nuit.
Question 5 · confirmé
Une alerte se déclenche à chaque erreur dans les logs d'une application, et l'équipe reçoit 300 e-mails par jour. Que proposez-vous ?
Une bonne réponseUne alerte sur un nombre ou un taux par fenêtre de temps plutôt que sur chaque événement, avec un seuil tiré de l'historique. La suppression des déclenchements répétés (throttling) par application ou par hôte pendant une durée. Une action vers l'outil d'astreinte ou de ticketing plutôt qu'un e-mail. Avec ITSI, des événements notables regroupés en épisodes par une politique d'agrégation. Et le tri des erreurs connues avec l'équipe applicative.
Signal d'alerteUne règle de messagerie qui range les e-mails dans un dossier, ou la désactivation de l'alerte.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Splunk en exploitation : les questions fréquentes
Un profil Splunk orienté SIEM peut-il tenir un poste Splunk ITOps ?
Il apporte presque tout le socle : SPL, architecture, collecte, parsing, gestion des index. Il lui manque souvent la logique de service : KPI, seuils adaptatifs, épisodes ITSI, lien avec l'astreinte et les outils de ticketing. Un bon profil SIEM s'y met en quelques semaines si la plateforme est déjà en place. Pour construire la supervision ITSI de zéro, mieux vaut l'avoir déjà fait, car les erreurs de modélisation des services coûtent cher à reprendre.
Splunk Enterprise ou Splunk Cloud Platform : le profil change-t-il ?
Sur Splunk Enterprise, l'équipe gère tout : serveurs, clusters d'indexeurs et de search heads, montées de version, stockage. Sur Splunk Cloud Platform, l'éditeur gère l'infrastructure, et l'ingénieur se concentre sur la collecte, les applications, les recherches et la consommation. Un profil venu du cloud n'a parfois jamais dimensionné ni réparé un cluster. Pour une plateforme installée sur site, une panne d'indexeur ou une montée de version déjà vécue fait la différence.
Quel test technique pour un ingénieur Splunk ?
À partir d'un extrait de logs, la personne écrit trois recherches SPL de difficulté croissante : un comptage par hôte, une comparaison avec la semaine précédente, puis une version rapide avec tstats ou une summary index. Reste un props.conf avec une erreur d'horodatage à trouver. Un exercice de trente minutes en entretien, commenté à voix haute, suffit à voir si la personne a écrit du SPL en production et sait où se fait le parsing.
Quelles certifications Splunk regarder sur un CV ?
Core Certified Power User montre une bonne pratique du SPL. Enterprise Certified Admin et Enterprise Certified Architect visent l'administration et la conception des clusters. Pour un poste ITOps, la certification ITSI, classée legacy par Splunk, reste un plus. Aucune ne remplace des exemples : la volumétrie de la plateforme tenue, une recherche optimisée, une source intégrée de bout en bout. Sans exemple de production, la certification ne suffit pas à trancher.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.