Sur AWS, Azure ou GCP, un SRE s'occupe moins des serveurs que des services managés et de leurs limites. La personne fixe les SLO avec le produit, mesure les SLI au bon endroit, prévoit la capacité et les quotas, et prépare l'application à la perte d'une zone. Dans beaucoup d'offres françaises, l'intitulé se mélange avec celui de DevOps et comprend l'astreinte.
Le cloud ne change pas la méthode SRE, il change les pannes. Un candidat qui a tenu une production cloud parle d'une zone dégradée, d'API du fournisseur en throttling, d'une bascule de base managée qui coupe les connexions, d'un quota refusé la veille d'un pic. Celui qui a surtout construit l'infrastructure cite les services sans dire ce qui casse.
Les trois clouds proposent des briques équivalentes, et un bon SRE transpose vite ses réflexes d'un fournisseur à l'autre. La personne répond sur le cloud qu'elle a pratiqué, puis donne l'équivalent sur celui de l'entreprise. Le PDF contient 30 questions sur six axes, un cas de 20 minutes et une grille de 1 à 4.
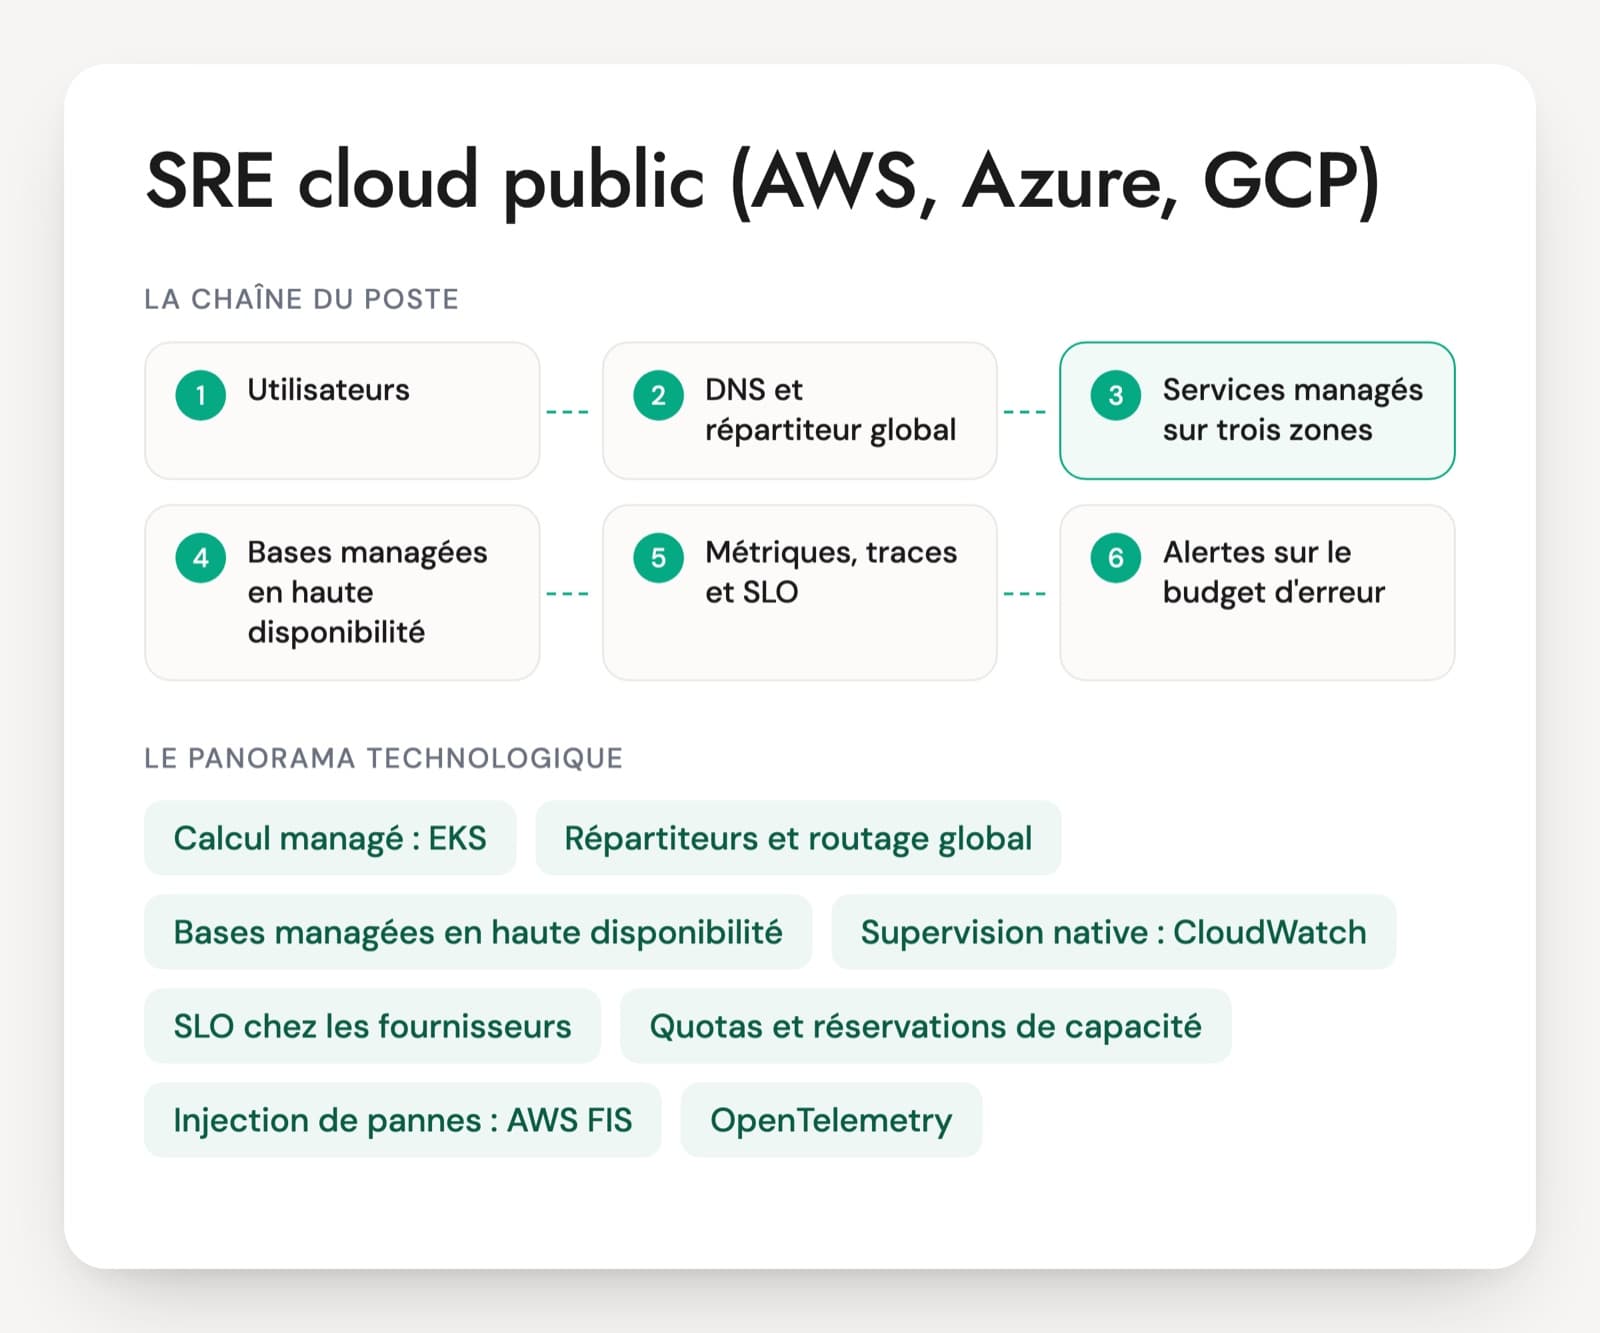
Services managés et outils de fiabilité d'un SRE cloud
Calcul managé : EKS, AKS, GKE, Cloud Run, App Service
Les applications tournent sur un Kubernetes managé ou sur des services plus simples comme Cloud Run, App Service ou Lambda. Le fournisseur gère le plan de contrôle, le SRE répond de la répartition sur plusieurs zones, des probes de santé et de la mise à l'échelle. Reste à savoir ce qui se passe quand une zone disparaît.
Répartiteurs et routage global
Elastic Load Balancing et Route 53 sur AWS, Azure Front Door et Traffic Manager, Cloud Load Balancing sur Google Cloud. Ces services retirent une zone ou une région du trafic. Le SRE doit savoir le faire vite, et connaître ce dont dépend la bascule.
Bases managées en haute disponibilité
RDS et Aurora, Azure SQL, Cloud SQL, Spanner. La haute disponibilité repose sur un secondaire dans une autre zone et une bascule automatique qui coupe les connexions quelques instants. L'application doit s'en remettre seule, et c'est souvent là que les SLO se perdent.
Supervision native : CloudWatch, Azure Monitor, Cloud Monitoring
Chaque cloud a son outil de métriques, de journaux et d'alertes, avec Application Insights côté Azure. Sur AWS, X-Ray cède la place à OpenTelemetry depuis la mise en maintenance de ses SDK en février 2026. Un SRE lit ces outils sans se perdre et sait ce qu'ils facturent.
SLO chez les fournisseurs
Cloud Monitoring et CloudWatch Application Signals calculent des SLO, le budget d'erreur restant et son rythme de consommation (burn rate), avec des alertes dessus. Côté Azure, on passe souvent par des requêtes sur Application Insights ou par Prometheus managé. Le SLO lui-même reste un choix à discuter avec le produit.
Quotas et réservations de capacité
Chaque compte, abonnement ou projet a des quotas par région : vCPU, adresses IP, répartiteurs, appels aux API. Ils se demandent à l'avance. Une réservation de capacité garantit les machines dans une zone, ce qu'un quota seul ne fait pas.
Injection de pannes : AWS FIS, Azure Chaos Studio
AWS Fault Injection Service propose des scénarios prêts, comme la coupure de courant d'une zone ou la perte de connexion entre régions. Azure Chaos Studio passe à un nouveau modèle par Workspaces et Scenarios, encore en préversion. Sur Google Cloud, on utilise plutôt Chaos Mesh ou Litmus sur GKE.
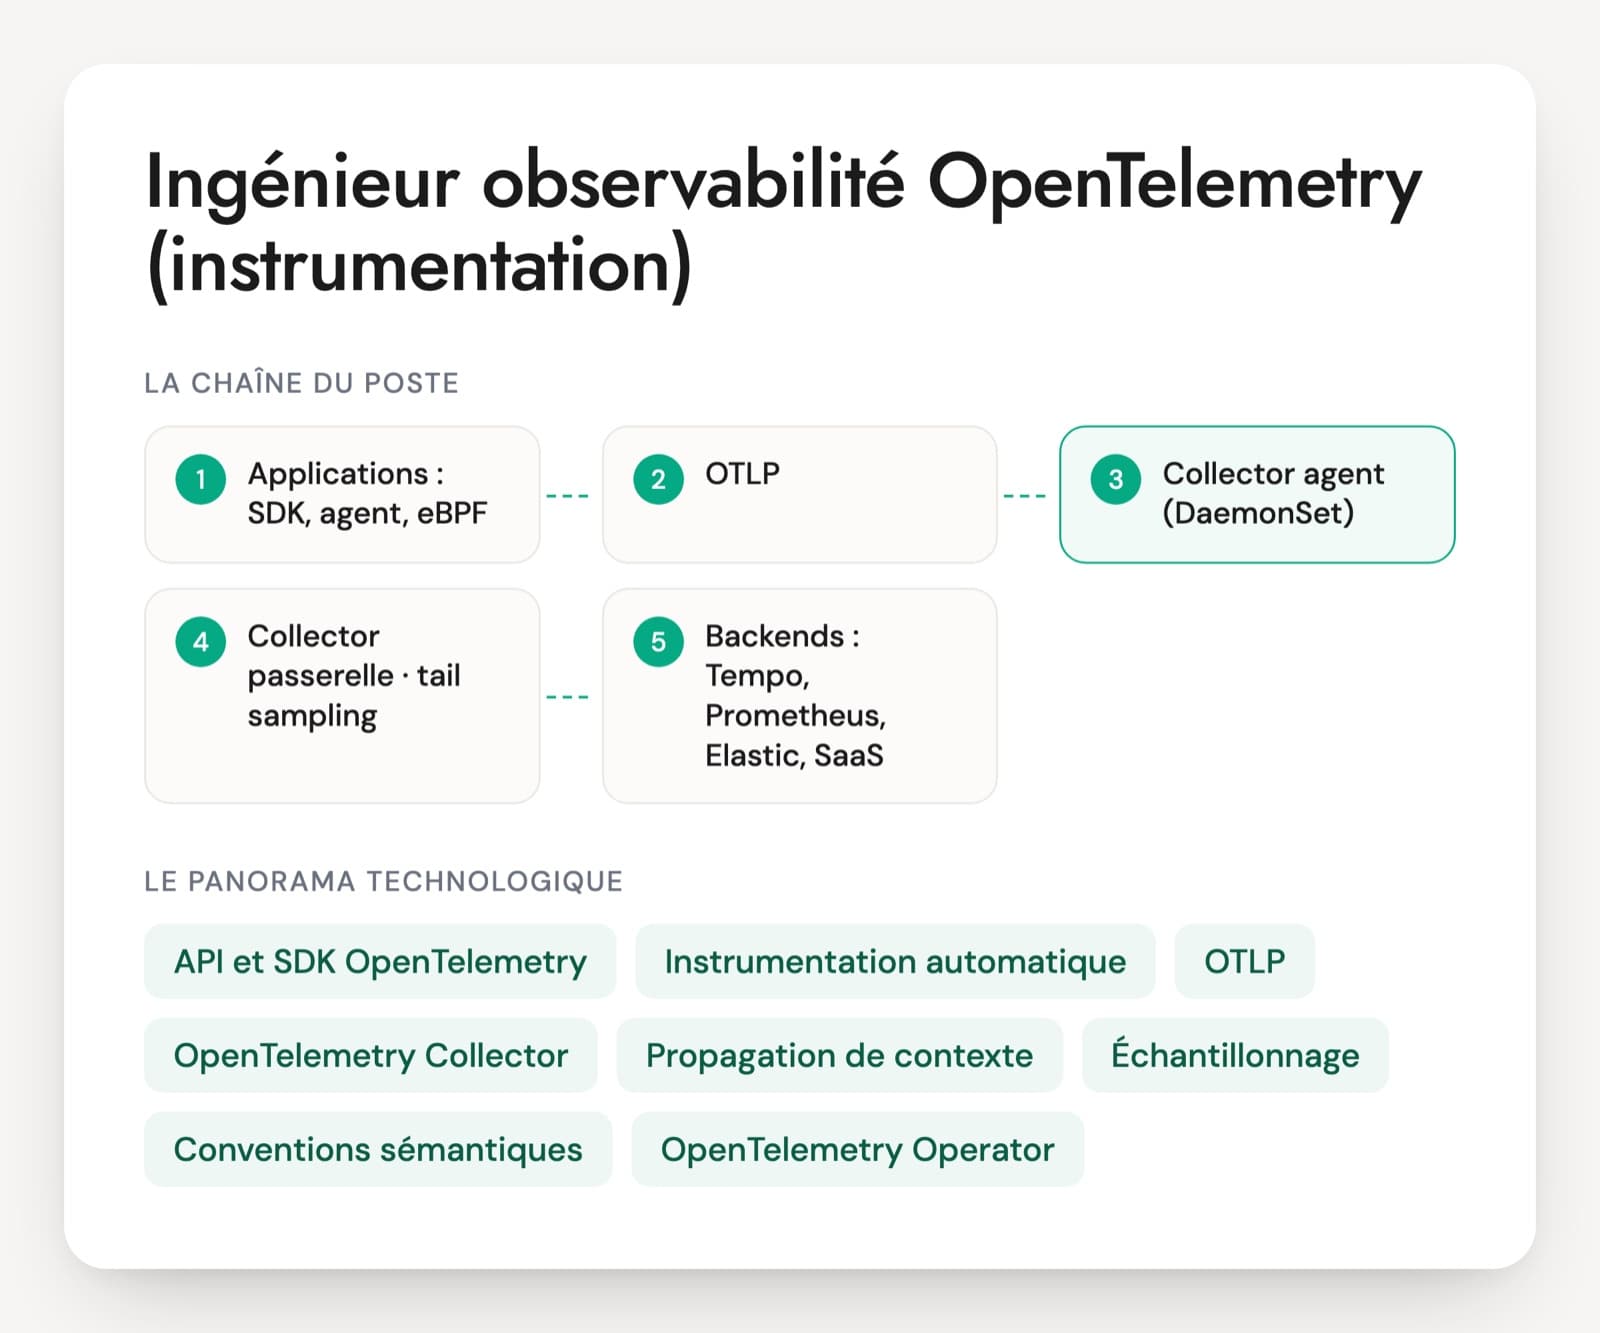
OpenTelemetry
Le standard ouvert pour instrumenter traces, métriques et journaux. Il permet de garder la même instrumentation quel que soit le cloud et de l'envoyer vers CloudWatch, Azure Monitor, Cloud Monitoring ou un outil tiers.
Terraform et déploiements progressifs
L'infrastructure est décrite en code, et chaque changement passe par un plan relu. Les nouvelles versions sortent progressivement, par pourcentage de trafic, avec un retour arrière automatique si le SLI se dégrade.
Le SRE cloud public travaille rarement seul : il partage la plateforme avec les équipes DevOps, cloud et applicatives, et porte la mesure de la fiabilité plus que la construction. Le poste s'ouvre souvent après une panne marquante, quand la direction veut des objectifs chiffrés et une astreinte organisée. Les offres françaises le confondent volontiers avec un poste DevOps ; la différence se voit aux SLO, au budget d'erreur et aux post-mortems. Un fournisseur principal est la règle, et la maîtrise d'un deuxième cloud est un plus. Google propose la certification Professional Cloud DevOps Engineer, la plus proche des pratiques SRE ; AWS et Microsoft ont leurs certifications DevOps. L'expérience d'incidents réels se vérifie en entretien.
Fiabilité sur AWS, Azure et GCP : six compétences à contrôler
- SLO, SLI et budget d'erreur
- Résilience multi-zone et multi-région
- Capacité, quotas et mise à l'échelle
- Supervision native et OpenTelemetry
- Diagnostic et gestion d'incident
- Déploiements progressifs et injection de pannes
Cinq pannes de cloud public en entretien de SRE
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Votre API tourne sur trois zones d'une même région. Le fournisseur annonce une dégradation sur une seule zone et votre taux d'erreur monte à 8 %. Que faites-vous dans la première demi-heure ?
Une bonne réponseD'abord confirmer que la zone en cause est bien celle où se concentrent les erreurs, avec des métriques ventilées par zone et l'événement publié par le fournisseur (AWS Health, Azure Service Health, Personalized Service Health sur Google Cloud). Ensuite retirer la zone du trafic plutôt que d'attendre : zonal shift d'Application Recovery Controller sur un répartiteur AWS, backends de la zone vidés ou mis hors service côté Azure et GCP, autoscaling empêché de recréer des instances dans cette zone. Puis vérifier que les deux zones restantes tiennent la charge, et prévenir les équipes.
Signal d'alerteAttendre que le fournisseur règle le problème, basculer toute l'application dans une autre région pour une panne d'une seule zone, ou redémarrer les instances au hasard.
Question 2 · confirmé
Le produit veut un SLO de 99,95 % sur une API qui dépend d'une base managée garantie à 99,95 % et d'une file de messages garantie à 99,9 %. Que répondez-vous ?
Une bonne réponseDeux dépendances appelées en série sans solution de repli plafonnent la disponibilité théorique autour de 99,85 % (0,9995 × 0,999), sous l'objectif demandé. Pour viser 99,95 %, il faut sortir la file du chemin synchrone (écriture différée, reprise), prévoir un mode dégradé, ou accepter un objectif plus bas. Un bon profil rappelle aussi que le SLA du fournisseur est un engagement de remboursement, pas une mesure de ce que vivent vos utilisateurs, et que le SLI se mesure côté client ou au répartiteur.
Signal d'alerteReprendre le SLA du fournisseur comme SLO, ou promettre 99,99 % sans regarder les dépendances.
Question 3 · confirmé
Le pic annuel arrive dans trois semaines. Le test de charge montre qu'il faudra 600 vCPU supplémentaires dans la région. Qu'est-ce qui peut vous bloquer côté fournisseur, et quand vous en occupez-vous ?
Une bonne réponseLes quotas d'abord : Service Quotas sur AWS, quotas de vCPU par famille et par région sur Azure, quotas par projet et par région sur Google Cloud. La demande part tout de suite, car une augmentation n'est pas toujours immédiate. Un quota accordé ne garantit pas que les machines seront disponibles dans la zone le jour du pic : pour la capacité critique, une réservation (capacity reservation sur les trois clouds). La personne vérifie aussi les autres plafonds : adresses IP des sous-réseaux, limites d'appels aux API, connexions à la base, quotas des répartiteurs.
Signal d'alerte« L'autoscaling s'en occupe », sans connaître les quotas ni les limites des dépendances.
Question 4 · senior
Vous devez alerter sur le budget d'erreur d'une API à 99,9 % sur 30 jours. Quelle règle posez-vous pour être réveillé à temps, sans l'être pour rien ?
Une bonne réponseDes alertes sur le taux de consommation du budget (burn rate), sur deux fenêtres. Une alerte rapide qui réveille, par exemple 14,4 fois le rythme normal sur une heure, ce qui consomme 2 % du budget mensuel, confirmée par une fenêtre courte de cinq minutes. Une deuxième alerte qui réveille aussi, 6 fois sur six heures (5 % du budget). Une alerte lente qui ouvre un ticket, 1 fois sur trois jours. Elle sait où le faire : alertes de burn rate de Cloud Monitoring, alarmes de burn rate des SLO de CloudWatch Application Signals, requête sur Application Insights ou sur Prometheus managé côté Azure.
Signal d'alerteUne alerte à chaque erreur 5xx, ou un seuil fixe sur un nombre d'erreurs qui sonne chaque nuit sur un service peu utilisé.
Question 5 · confirmé
Une mise en production coïncide avec une panne annoncée par le fournisseur. Comment établissez-vous la cause avant de décider d'un retour arrière ?
Une bonne réponseUne chronologie à la minute : début des erreurs, heure du déploiement, début de l'événement fournisseur. Puis des métriques ventilées par version, par zone et par région : si seules les instances de la nouvelle version échouent, c'est le déploiement. Si des services qui n'ont pas été livrés souffrent aussi, c'est plutôt le fournisseur. Quand le retour arrière est rapide et sans risque, le faire d'abord, car rétablir le service passe avant l'explication.
Signal d'alerteAccuser le fournisseur et laisser la nouvelle version en place, ou chercher la cause racine pendant une heure avant de mitiger.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
SRE cloud : les questions fréquentes
Un ingénieur DevOps qui fait de l'astreinte est-il déjà un SRE ?
Pas forcément. Le DevOps construit surtout la chaîne de livraison et l'infrastructure. Le SRE part d'objectifs de fiabilité chiffrés, les SLO, et décide avec le produit de ce que l'on fait quand le budget d'erreur fond. Beaucoup d'offres françaises mélangent les deux intitulés. Pour trancher, le candidat cite le SLO d'un service qu'il a suivi, comment il le mesurait et la dernière décision prise à cause de lui.
Faut-il un SRE qui connaît AWS, Azure et GCP ?
Rarement. Un poste tourne en général sur un fournisseur principal, parfois deux. Les réflexes se transposent bien : SLO, conception multi-zone, quotas, bascule de base, alertes sur le budget d'erreur. Le détail des services, des droits et du réseau prend plus de temps. Un profil solide sur un cloud et curieux du vôtre vaut mieux qu'un CV qui aligne trois noms sans production derrière.
Que valent les certifications cloud pour un poste de SRE ?
Elles montrent une connaissance des services du fournisseur. Google propose la Professional Cloud DevOps Engineer, centrée sur les pratiques SRE ; AWS et Microsoft ont chacun une certification DevOps Engineer. Aucune ne prouve qu'une personne a déjà mené un incident ou tenu un SLO. Elles servent à trier les CV, puis l'entretien vérifie avec un incident réel, raconté avec ses heures et ses chiffres.
Quelle forme donner au test technique d'un SRE cloud ?
Un exercice de diagnostic en direct fonctionne bien. À partir de quelques graphes d'un incident (taux d'erreur par zone, latence, heure des déploiements, événement du fournisseur), la personne raisonne à voix haute jusqu'à la mitigation. S'y ajoute une question de conception courte, comme le SLO d'une API et son alerte. Le cas de 20 minutes du PDF suit ce format, avec une grille de notation commune.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.