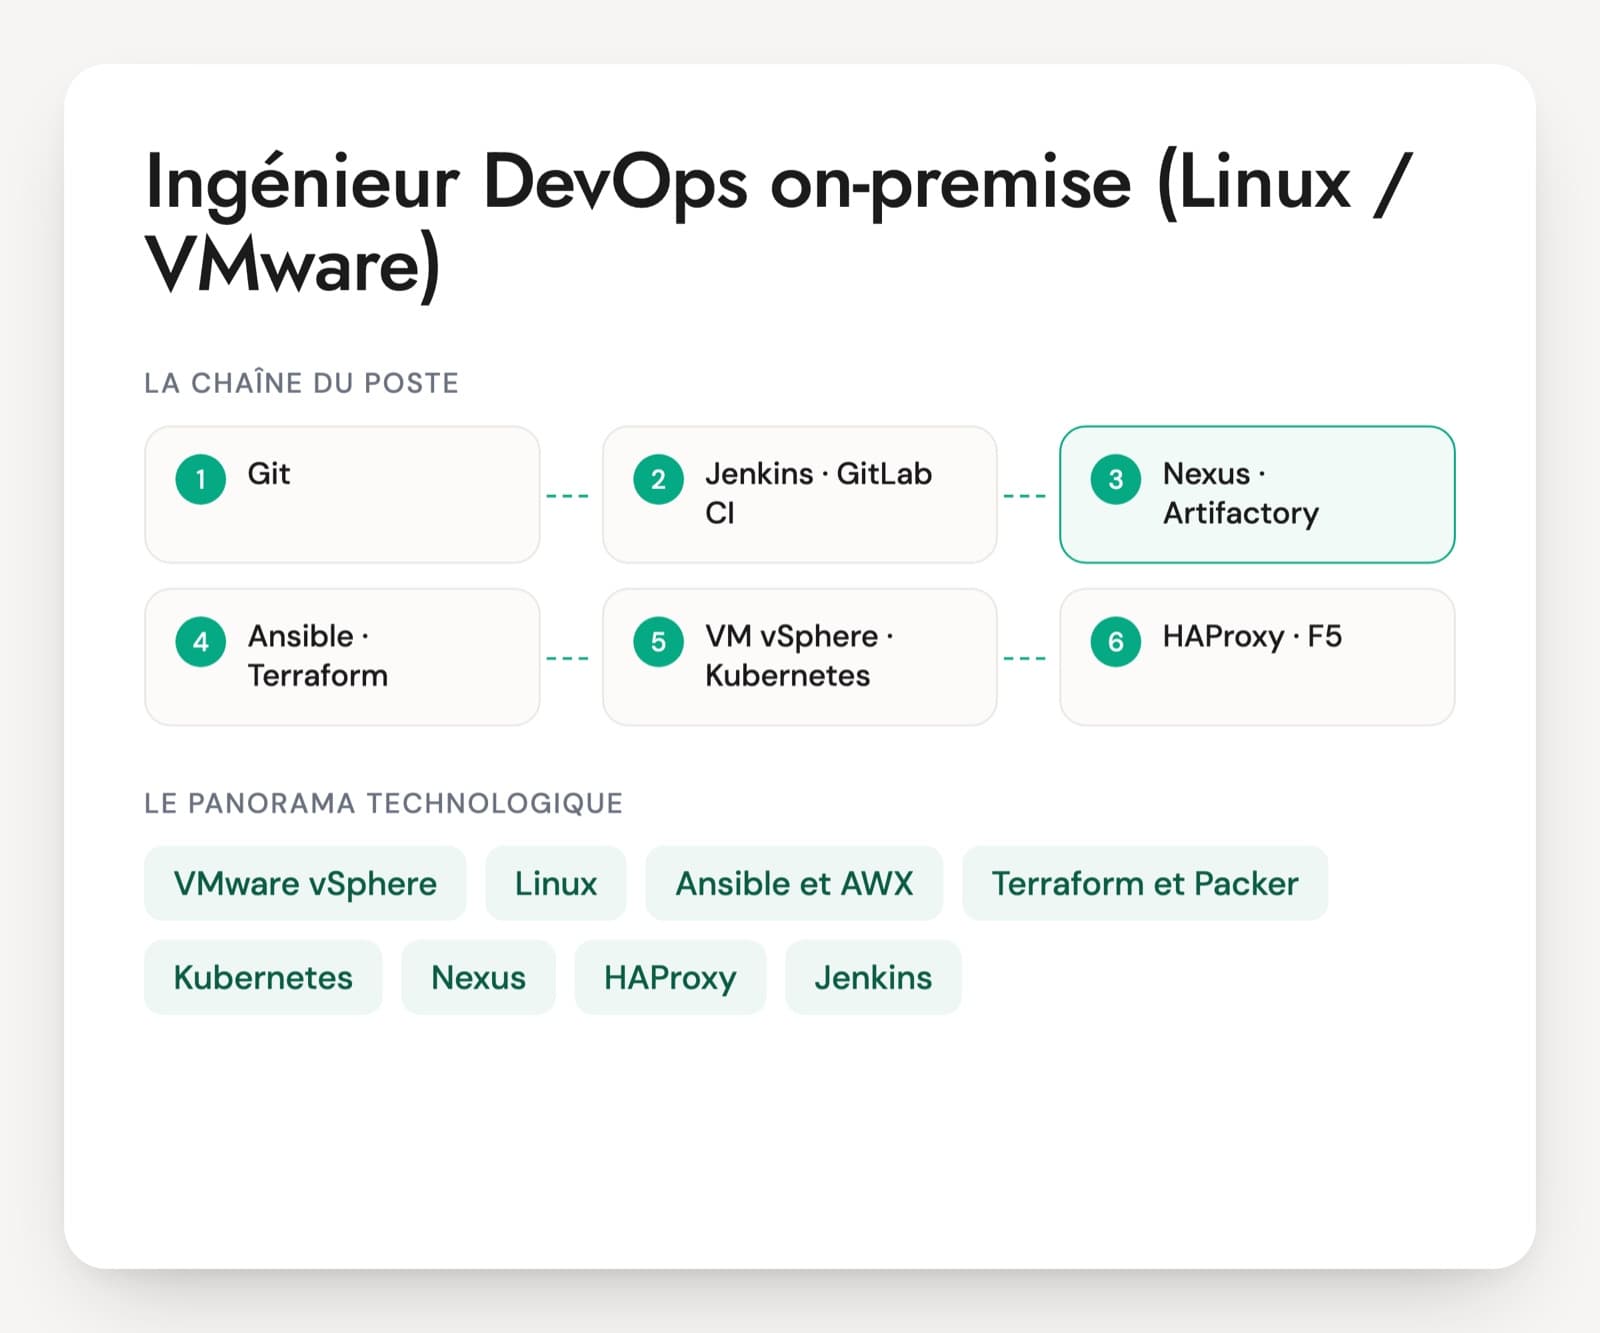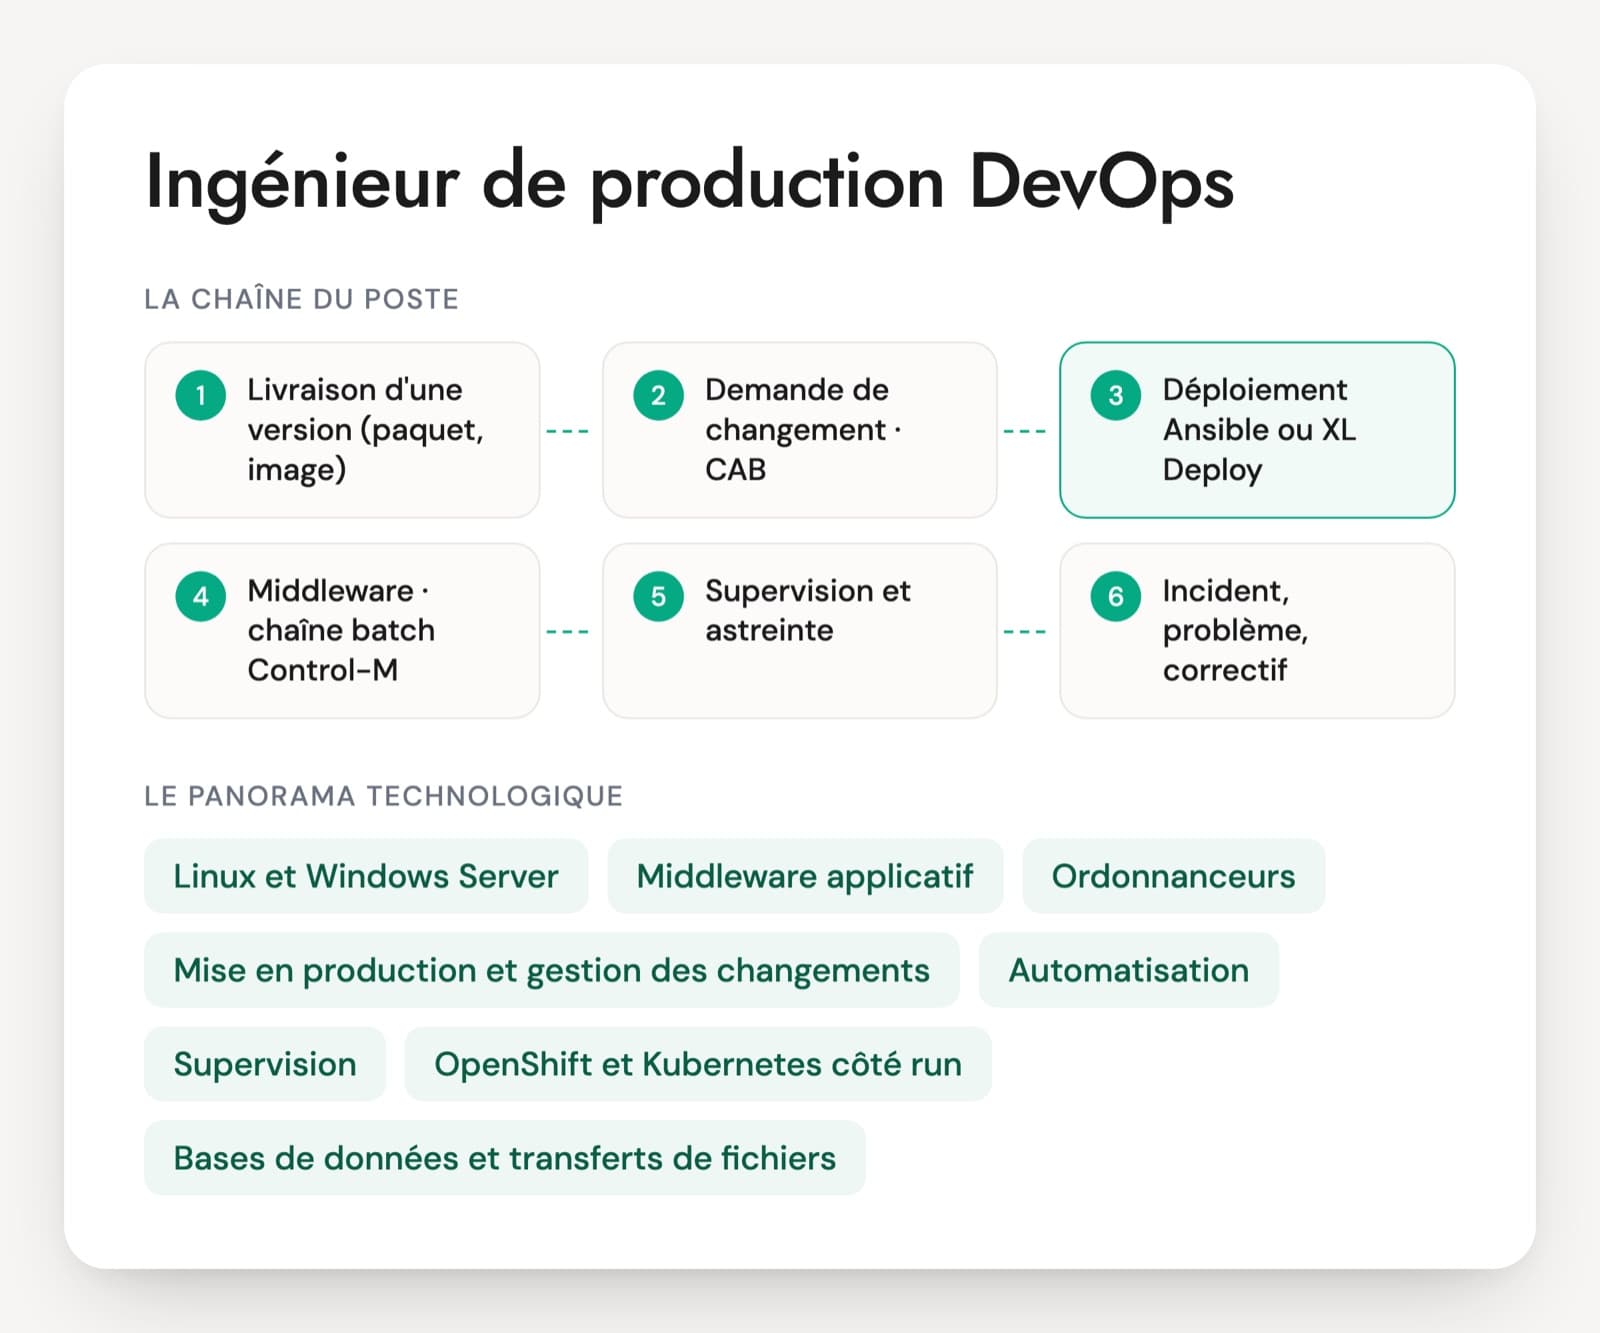
Un ingénieur de production DevOps garde les applications en état de marche une fois livrées. Il prépare et réalise les mises en production, souvent le soir ou le week-end, sur des serveurs Linux et Windows qui portent Tomcat, JBoss, Apache ou IIS. Il suit les chaînes batch dans Control-M, Autosys, VTOM ou Dollar Universe, traite les alertes de Centreon, Zabbix ou Dynatrace, et automatise avec Ansible, Jenkins, GitLab CI ou XL Deploy.
Ce poste se distingue de l'ingénieur DevOps orienté build par son rapport au run. Les offres parlent d'astreinte, de changements à suivre au sens ITIL, de procédures à rédiger, et souvent d'OpenShift ou de Kubernetes côté exploitation. Un CV peut aligner Ansible et Kubernetes sans que la personne ait jamais repris une chaîne batch plantée à 3 heures du matin.
Le diagnostic passe en premier. Quelqu'un qui a tenu une production cite des commandes précises, l'ordre dans lequel il regarde les choses et ce qu'il écrit dans le ticket. Le PDF ajoute 30 questions sur six axes, un cas d'incident de 20 minutes et une grille de 1 à 4.
Les outils du quotidien d'un ingénieur de production DevOps
Linux et Windows Server
Le socle du poste. Sous Linux : processus, systemd, espace disque et inodes, droits, journaux, réseau avec ss, curl ou tcpdump. Sous Windows : services, observateur d'événements, IIS, PowerShell. La plupart des incidents se diagnostiquent avec ces commandes avant de sortir un outil.
Middleware applicatif (Tomcat, JBoss, Apache, IIS)
Les serveurs qui font tourner les applications Java et web. L'exploitant déploie les WAR ou EAR, règle la JVM et les pools de connexions, lit les logs, renouvelle les certificats et redémarre proprement. JBoss EAP est la version de WildFly supportée par Red Hat.
Ordonnanceurs (Control-M, Autosys, VTOM, Dollar Universe)
Ils lancent les traitements batch dans l'ordre, selon un calendrier et des conditions entre jobs. L'ingénieur de production suit les chaînes de nuit, relance un job en échec, en force un autre, et sait quand il ne faut pas relancer. Le produit change d'une entreprise à l'autre, les notions de dépendance, de calendrier et de reprise restent proches.
Mise en production et gestion des changements (ITIL)
Chaque intervention en production passe par un changement : demande, analyse d'impact, plan de retour arrière, passage en CAB pour un changement normal, changement standard préapprouvé pour les gestes répétitifs. L'outil est souvent ServiceNow ou un équivalent, et ITIL sert de vocabulaire commun : ITIL 4 dans la plupart des équipes, la version 5 publiée par PeopleCert en 2026 chez les plus récemment certifiés.
Automatisation (Ansible, Jenkins, GitLab CI, XL Deploy et XL Release)
Les gestes répétés, comme un déploiement, un redémarrage, une purge ou un renouvellement, passent dans des playbooks Ansible ou des pipelines. XL Deploy et XL Release, vendus aujourd'hui sous la marque Digital.ai, orchestrent encore beaucoup de mises en production.
Supervision (Centreon, Zabbix, Dynatrace, Prometheus et Grafana)
Les sondes et les seuils qui déclenchent les alertes, les tableaux de bord, l'APM. L'exploitant crée des contrôles, règle des seuils qui ne réveillent pas l'astreinte pour rien et relie chaque alerte à une procédure.
OpenShift et Kubernetes côté run
Quand les applications passent en conteneurs, l'exploitation change d'outils : pods qui redémarrent, quotas, routes, logs centralisés, déploiement par image. On attend surtout de savoir lire l'état d'un déploiement et diagnostiquer un pod en échec, pas d'administrer le cluster.
Bases de données et transferts de fichiers
Sauvegardes et restaurations, suivi de l'espace, requêtes de contrôle après une MEP sur Oracle, PostgreSQL ou SQL Server. Les échanges de fichiers passent souvent par CFT ou SFTP, avec des reprises à gérer quand un transfert échoue.
Le poste existe surtout là où un service de production est séparé des équipes de développement. Il va du niveau 2 qui applique des procédures jusqu'au profil senior qui automatise les mises en production et conçoit la supervision. Les intitulés voisins sont ingénieur d'exploitation, ingénieur intégration et exploitation, ou ingénieur production DevOps RUN. Avant l'entretien, il faut préciser la part d'astreinte, les ordonnanceurs et middlewares en place, et si l'automatisation fait partie du poste ou reste à une équipe DevOps distincte.
Le run qu'un ingénieur de production DevOps doit maîtriser
- Mise en production et retour arrière
- Ordonnancement et reprise de batch
- Diagnostic Linux et Windows Server
- Middleware Java et web
- Automatisation Ansible et scripts
- Supervision et gestion des incidents
Des situations de production et les réponses attendues
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
La MEP de cette nuit a échoué à mi-parcours : deux serveurs sur quatre ont la nouvelle version. Que faites-vous ?
Une bonne réponseIl s'arrête, prévient le responsable du changement et applique le plan prévu dans la demande : finir si la cause est connue et corrigée dans la fenêtre, sinon remettre les deux serveurs sur la version précédente. Il vérifie l'état réel (version installée sur chaque serveur, santé de l'application, schéma de base), ne laisse pas deux versions servir ensemble derrière le load balancer, note chaque action dans le ticket et ouvre un incident.
Signal d'alerteImproviser des corrections en production sans prévenir personne, ou laisser tourner les deux versions jusqu'au matin.
Question 2 · junior à confirmé
Un job Control-M de la chaîne de nuit est en échec et les suivants attendent. Vous le relancez ?
Une bonne réponsePas avant d'avoir lu la sortie du job et compris la cause : fichier absent, base indisponible, données en double. Il vérifie que le job peut être rejoué sans effet de bord (une écriture partielle à nettoyer, un fichier déjà envoyé), suit la consigne d'exploitation, relance ou force en accord avec l'astreinte applicative, et mesure le retard sur l'heure de fin de la chaîne.
Signal d'alerteRelancer trois fois de suite, ou forcer le job en OK pour débloquer la suite sans prévenir.
Question 3 · junior
Une alerte signale /var plein à 100 % sur un serveur applicatif. Quelles commandes lancez-vous ?
Une bonne réponsedf -h et df -i pour l'espace et les inodes, du -xsh sur les sous-dossiers pour trouver ce qui occupe la place, lsof +L1 pour repérer des fichiers supprimés mais encore ouverts par un processus. Il libère proprement (rotation, compression, purge selon la règle de rétention), ne supprime pas un log ouvert, puis traite la cause : logrotate absent, niveau de log resté en DEBUG, application qui boucle.
Signal d'alerteUn rm -rf sur le dossier de logs, ou un redémarrage du serveur.
Question 4 · confirmé
Après une MEP, un Tomcat répond de plus en plus lentement, puis renvoie des erreurs 500. Comment remontez-vous à la cause ?
Une bonne réponseIl compare avec l'état d'avant la MEP : logs catalina et applicatifs, OutOfMemoryError, pool de connexions à la base saturé, threads bloqués vus dans un thread dump (jstack), activité du garbage collector, temps de réponse dans l'APM. Il regarde aussi les changements de configuration livrés avec la version. Si l'impact est fort, retour arrière d'abord, analyse ensuite à partir des dumps récupérés.
Signal d'alerteAugmenter la mémoire de la JVM à chaque incident de ce type.
Question 5 · confirmé
Vous refaites chaque semaine la même procédure de déploiement à la main sur six serveurs. Comment l'automatisez-vous avec Ansible ?
Une bonne réponseUn inventaire par environnement et un rôle qui reprend les étapes : arrêt du service, sauvegarde de la version en place, copie de l'artefact depuis Nexus, configuration par template, démarrage, test de santé. serial pour traiter les serveurs par lots, des handlers pour les redémarrages, --check et --diff avant la production, et un second passage qui ne change rien pour vérifier l'idempotence. Les mots de passe sont dans Ansible Vault ou un coffre.
Signal d'alerteUn playbook qui enchaîne des tâches shell copiées de la procédure et qu'on ne peut pas relancer sans risque.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Ingénieur de production DevOps : questions fréquentes
Ingénieur de production DevOps ou ingénieur DevOps : où passe la frontière ?
L'ingénieur DevOps construit surtout la chaîne de livraison et l'infrastructure : pipelines, conteneurs, infrastructure as code. L'ingénieur de production DevOps part du run : il installe les versions, tient le batch et la supervision, traite les incidents et automatise ces gestes. Les deux se recoupent sur Ansible, les pipelines et Kubernetes. Pour un poste avec astreinte, la grille donne plus de poids aux questions de diagnostic et de mise en production.
Faut-il exiger une certification ITIL pour un ingénieur de production ?
Rarement. La certification ITIL Foundation, en version 4 ou 5, montre que la personne connaît le vocabulaire des incidents, des problèmes et des changements, ce qui aide dans une équipe qui suit ces processus. Elle ne dit rien de la pratique. Compte plutôt la façon dont la personne a rédigé un plan de retour arrière, classé un changement ou documenté un incident de nuit. Une réponse précise sur ces points vaut plus qu'un certificat.
Comment évaluer un ingénieur de production junior qui n'a jamais fait d'astreinte ?
L'entretien part de ce qu'il a fait en stage ou en alternance, avec des situations simples : un disque plein, un service qui ne démarre pas, un job batch en échec. Comptent l'ordre des vérifications et les commandes citées plutôt que la solution finale. Un junior qui sait dire ce qu'il vérifierait, ce qu'il ne toucherait pas sans accord et qui il préviendrait a les bons réflexes pour apprendre le reste.
Un test technique est-il utile pour un ingénieur de production DevOps ?
Oui, s'il ressemble au poste. Un serveur Linux de test avec deux ou trois pannes préparées, comme un disque plein, un service arrêté ou un certificat expiré, apprend beaucoup en une demi-heure. À défaut, un extrait de logs et une sortie d'ordonnanceur à commenter suffisent. Les questionnaires sur la syntaxe des commandes servent peu, la méthode de diagnostic compte davantage que la mémoire des options.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.