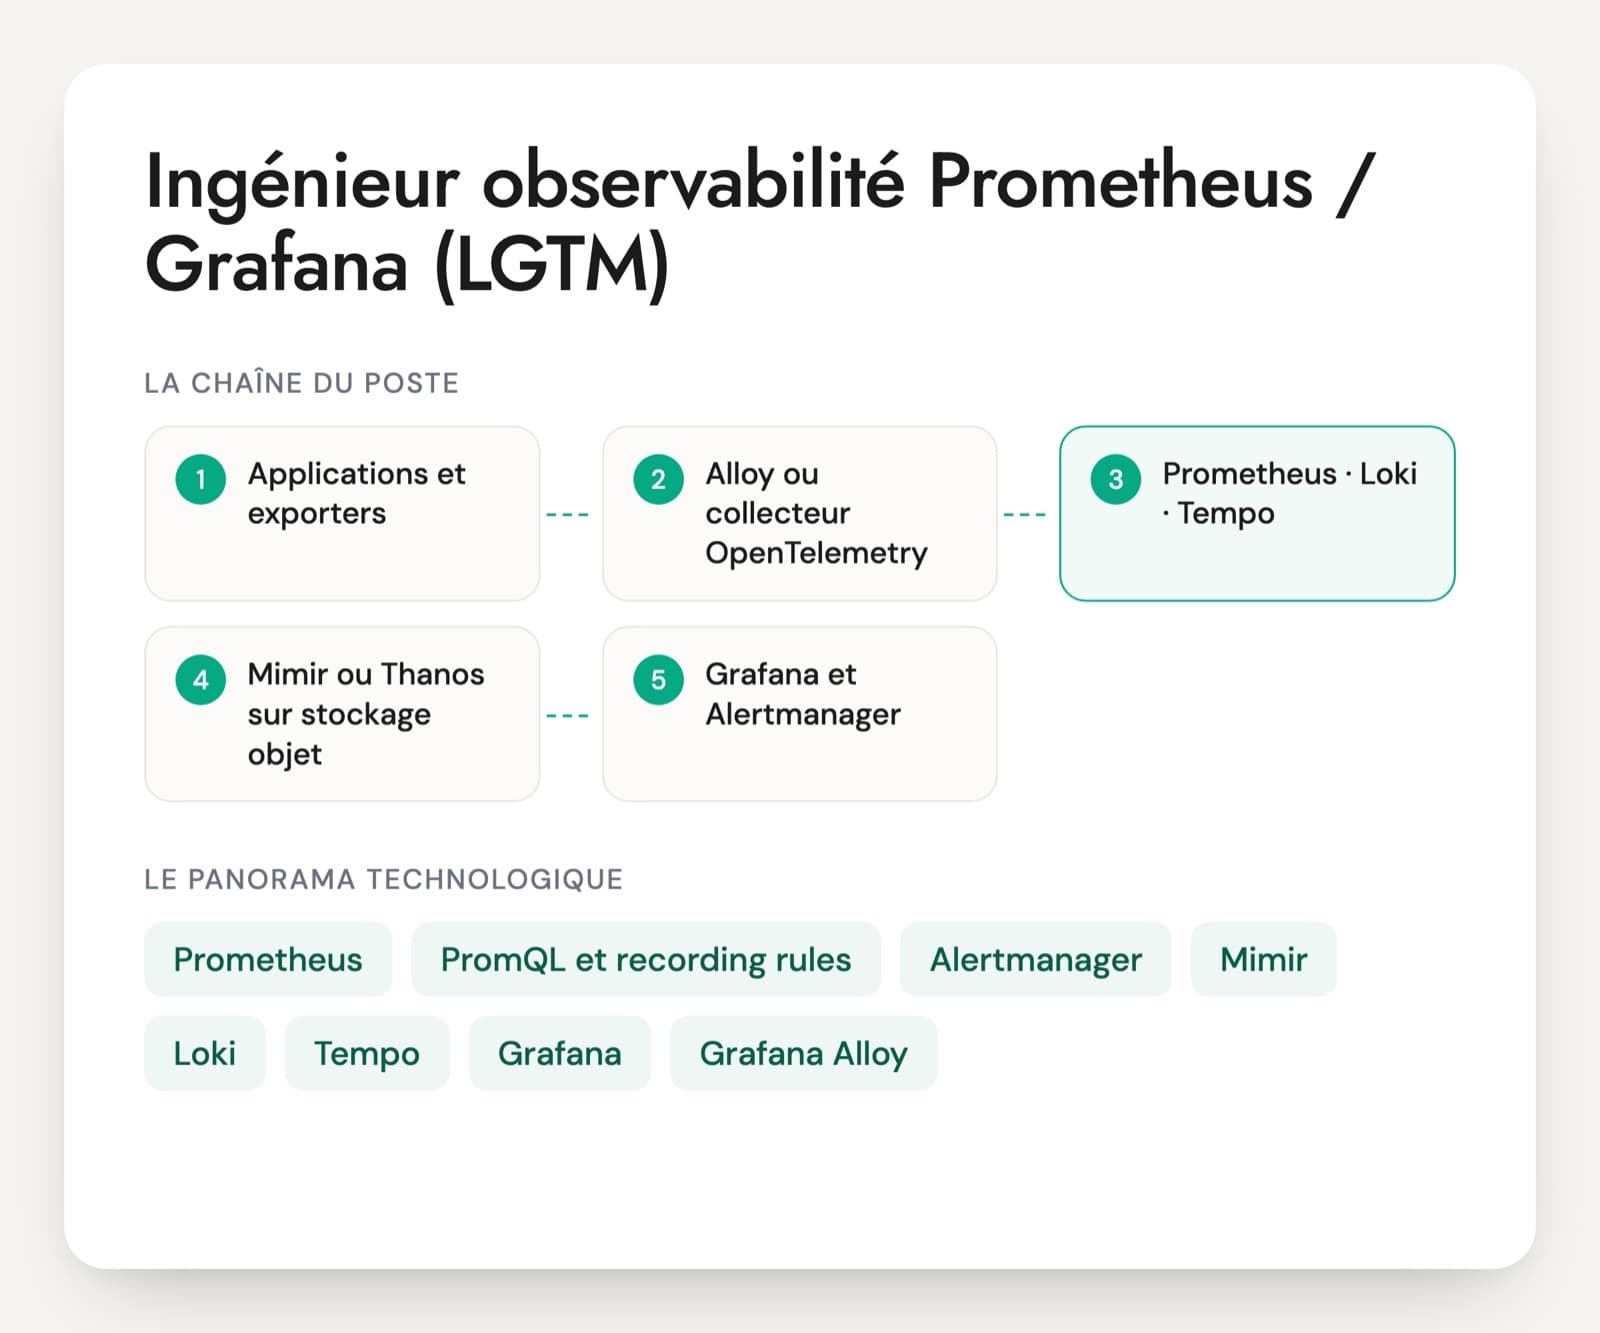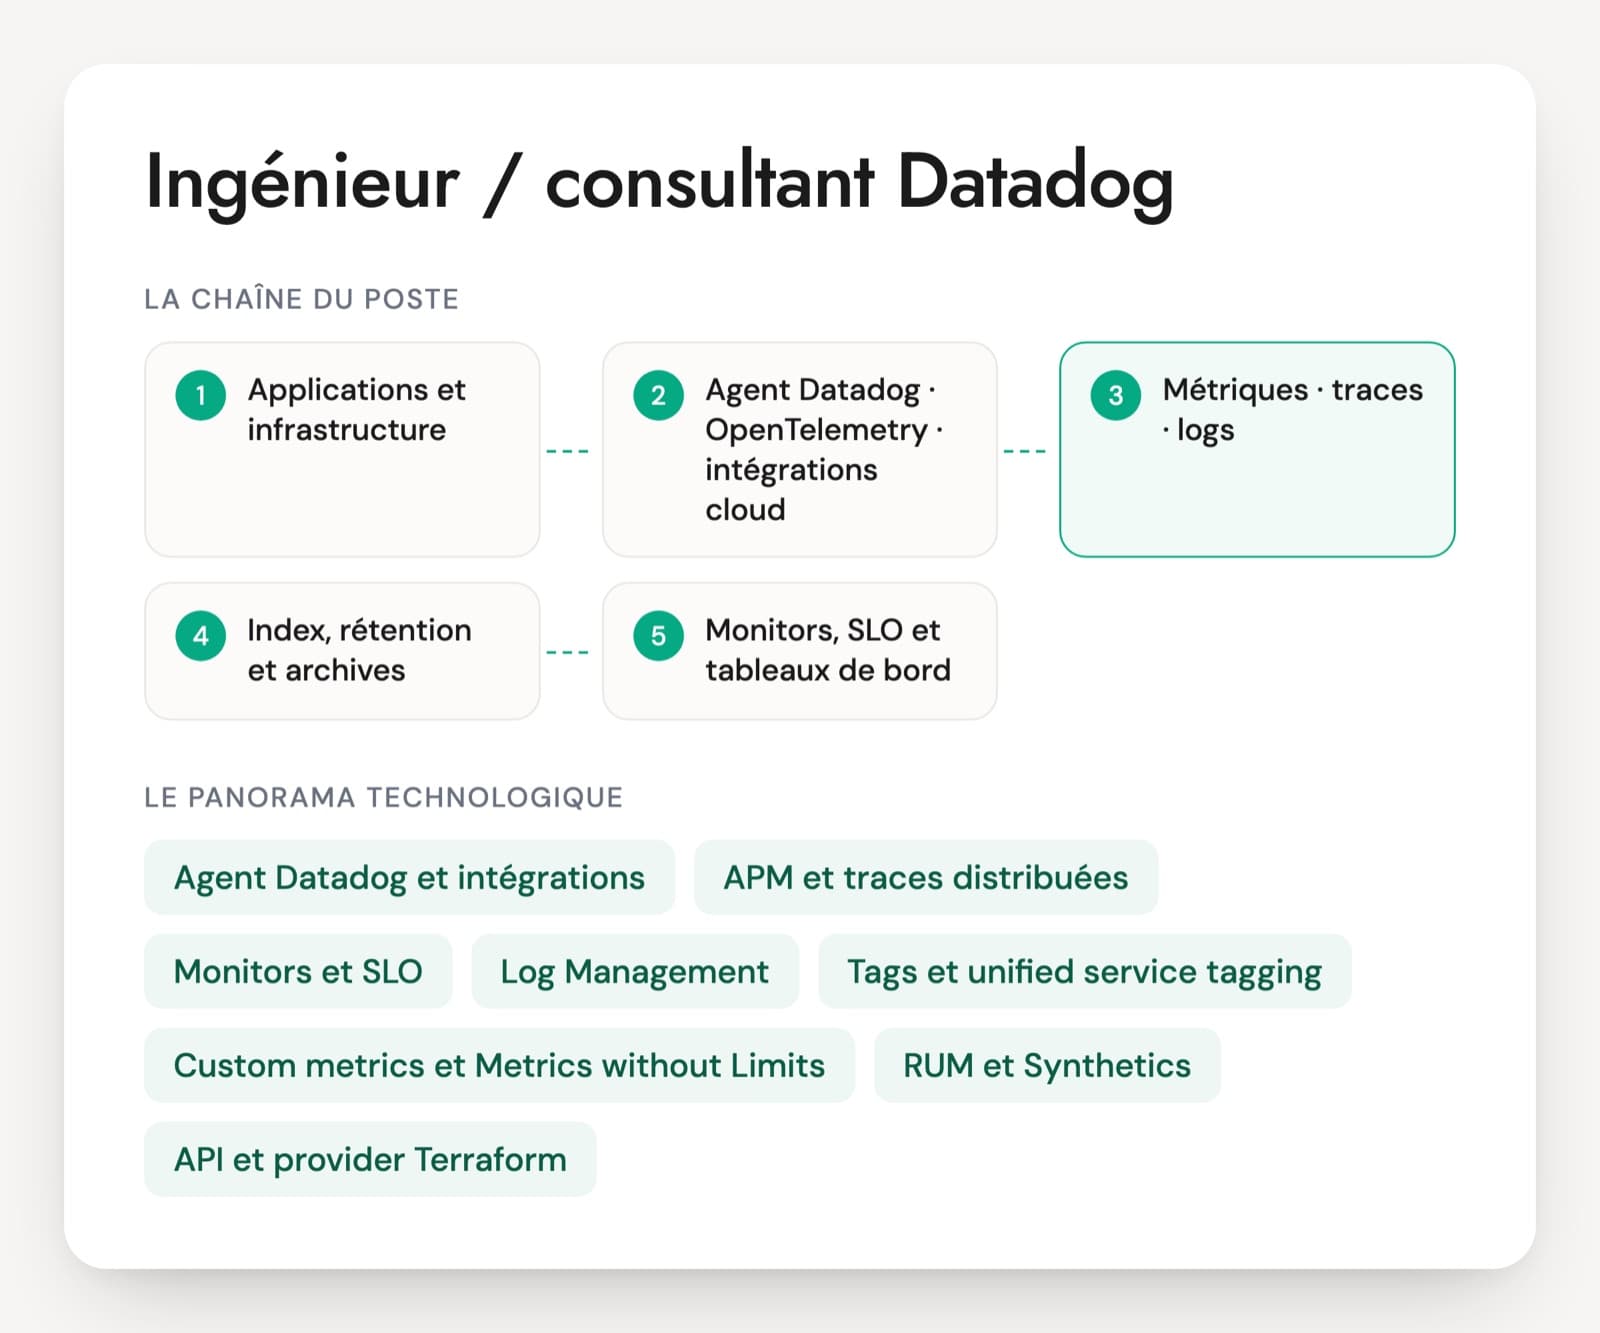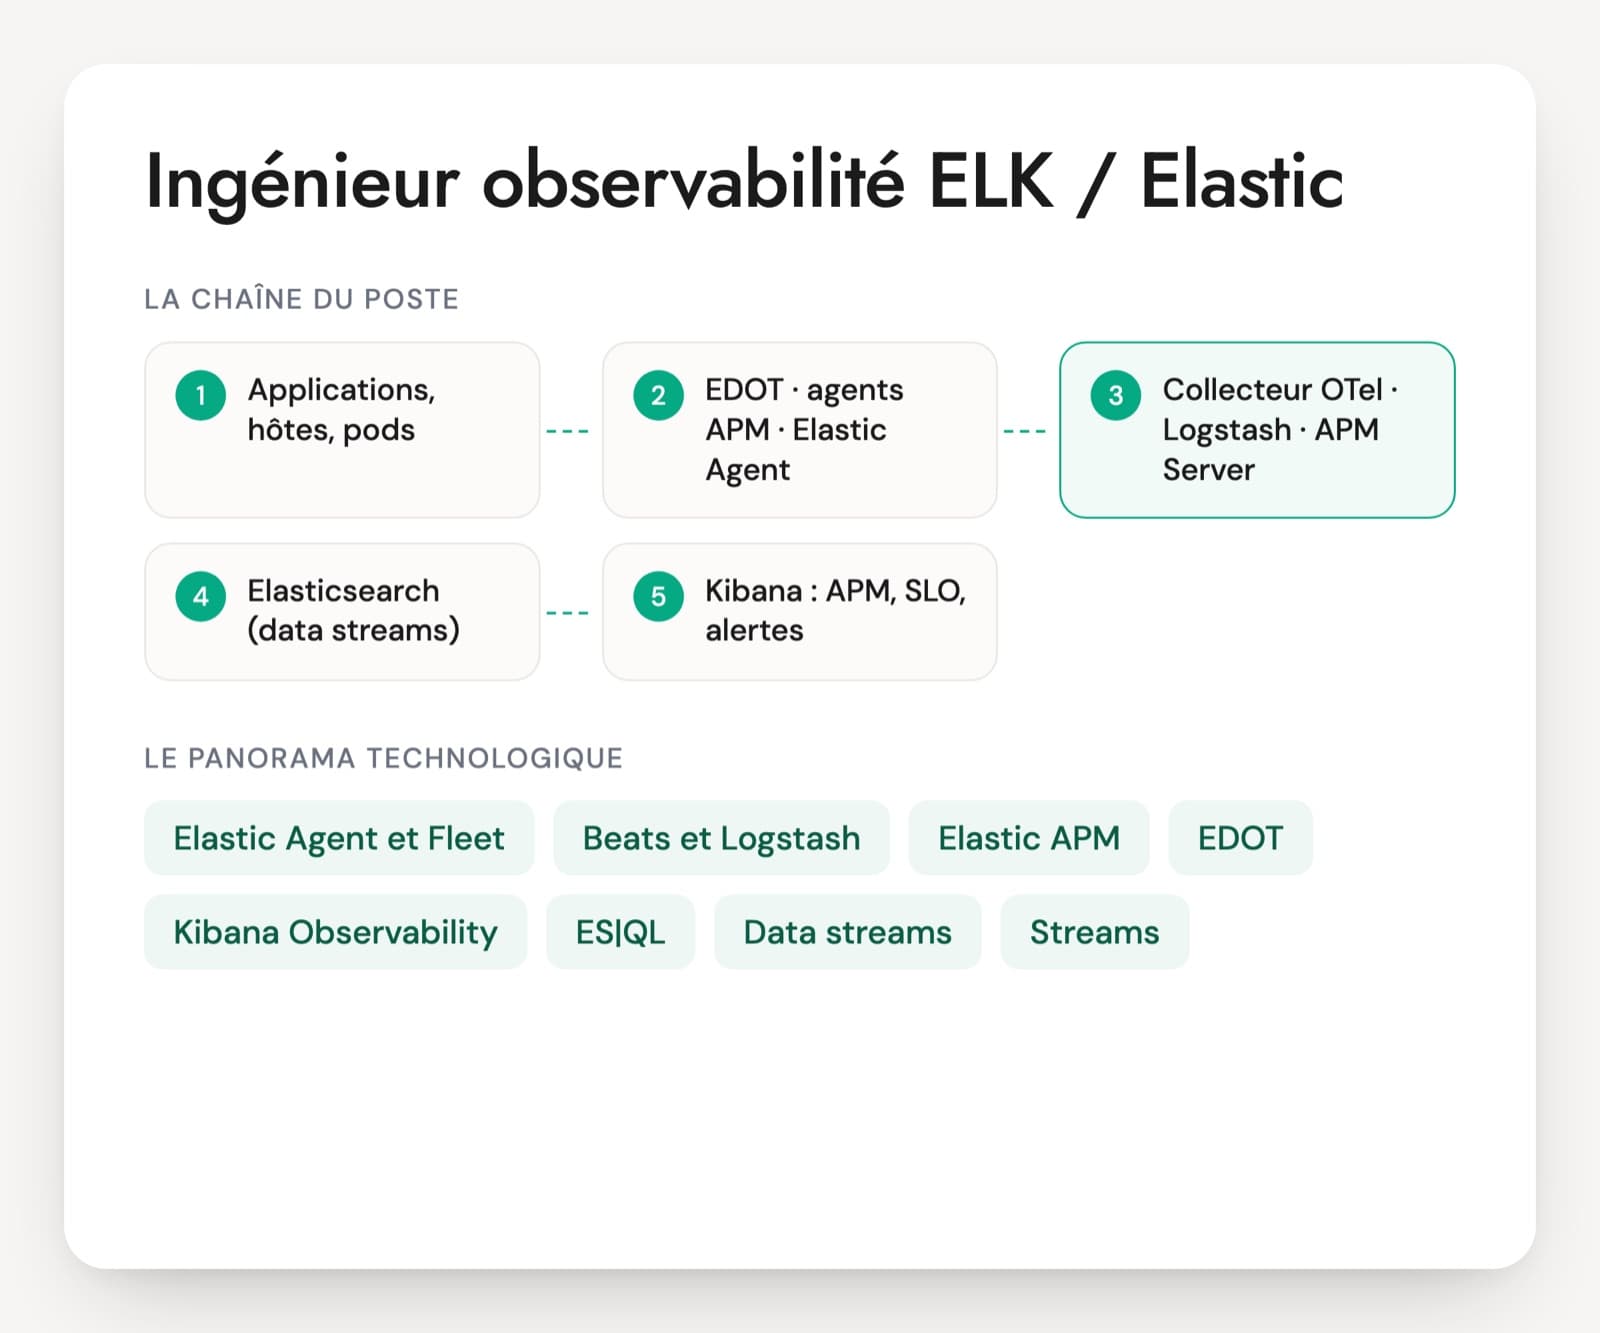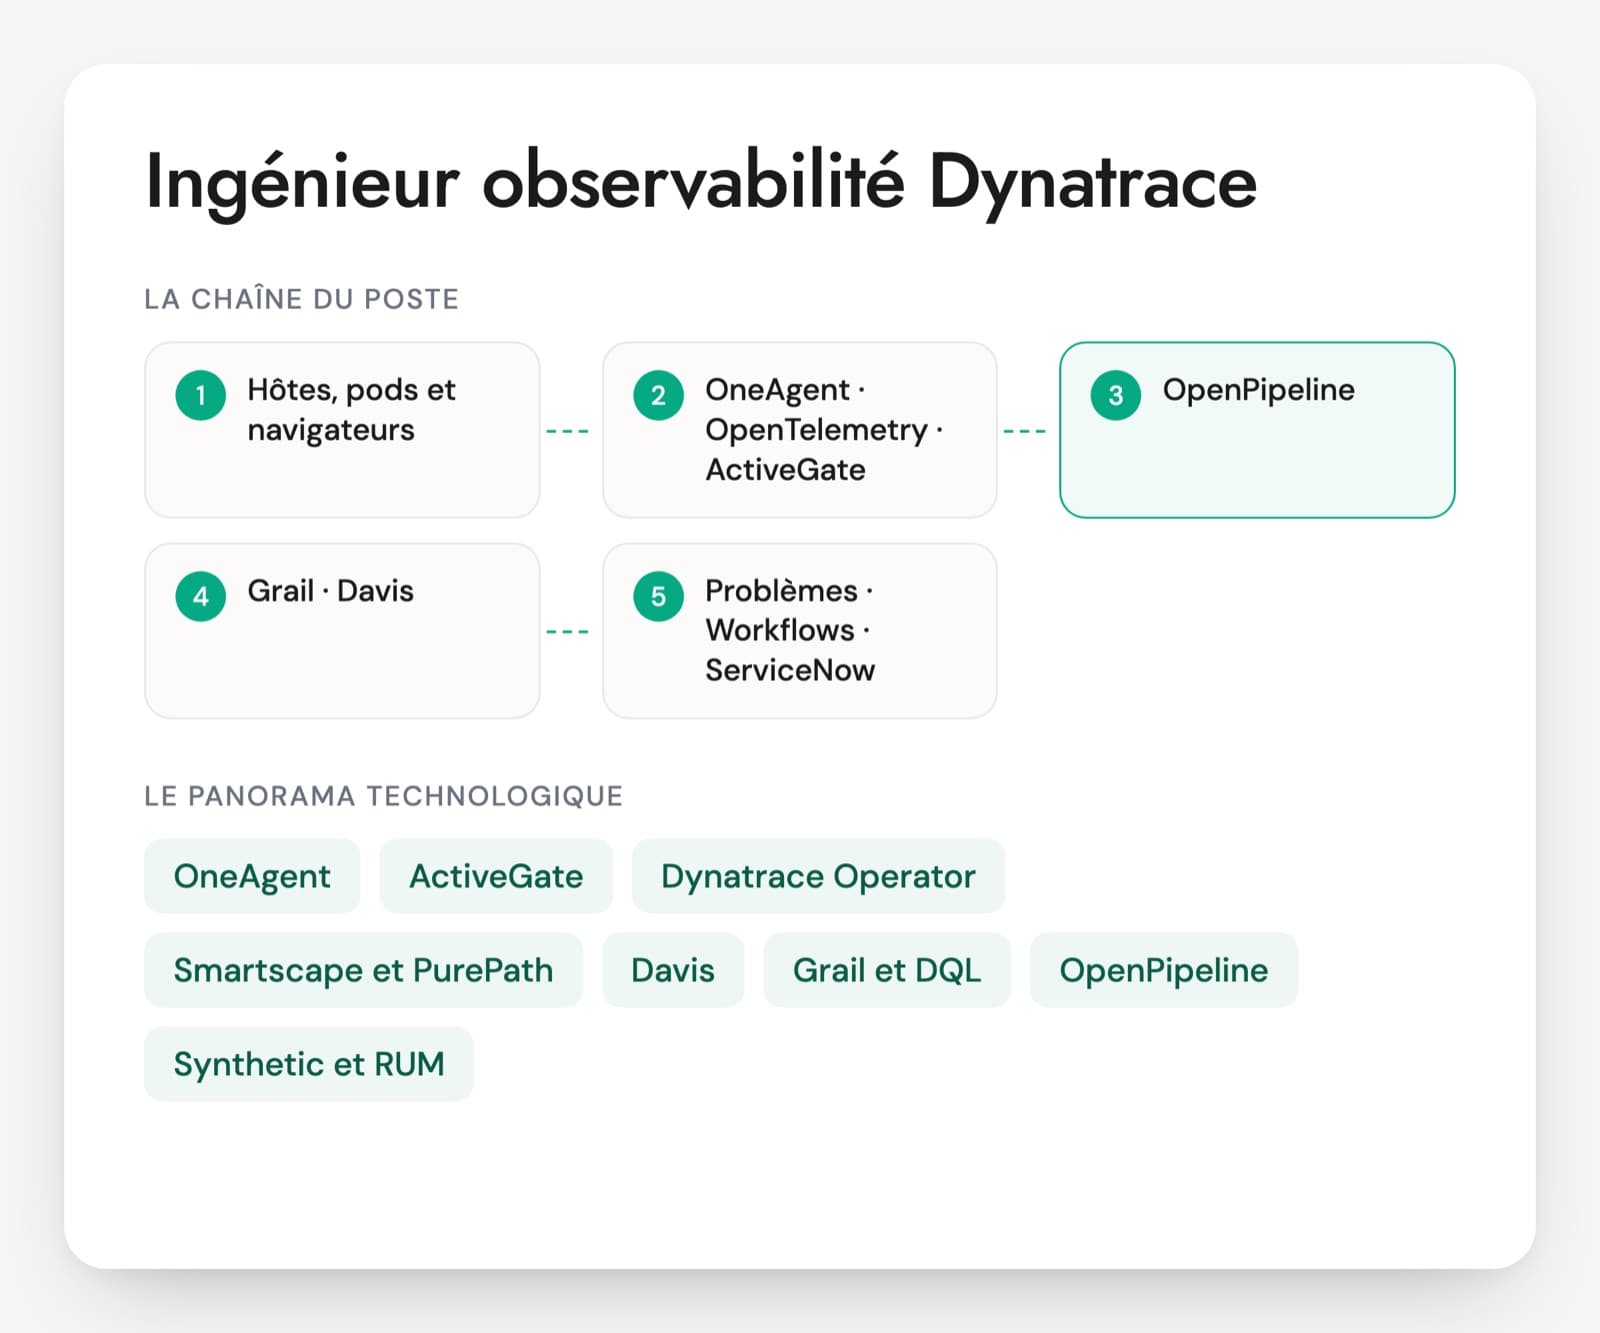
Les postes d'ingénieur OpenTelemetry apparaissent quand une équipe veut sortir d'un agent propriétaire, envoyer ses données à deux outils pendant une migration, ou imposer les mêmes règles de télémétrie à toutes les équipes. Sur Free-Work, les intitulés vont de « Senior SRE Engineer Observabilité OpenTelemetry Kubernetes » aux missions de plateforme qui citent OTel à côté de Datadog ou de Splunk.
Beaucoup de CV mentionnent OpenTelemetry parce que leur outil accepte l'OTLP. Ce n'est pas le même travail. Le profil recherché a déjà suivi une trace qui se coupe entre deux threads, vu un Collector tomber faute de memory_limiter, monté un tail sampling sur deux couches de Collectors et migré des tableaux de bord vers les conventions sémantiques stables. Il lit le code Java, Go ou Python des équipes, parce que l'instrumentation manuelle s'écrit dans leurs dépôts.
Le backend qu'il connaît ne compte pas dans la note. Tout l'intérêt d'OpenTelemetry est de changer d'outil en remplaçant un exporter, et c'est cette indépendance que le poste doit garantir. La certification OTCA de la Linux Foundation, valable deux ans, couvre l'API, le SDK et le Collector. Le PDF contient 30 questions, un cas de 20 minutes et une grille de 1 à 4.
SDK, OTLP, Collector : l'outillage OpenTelemetry du poste
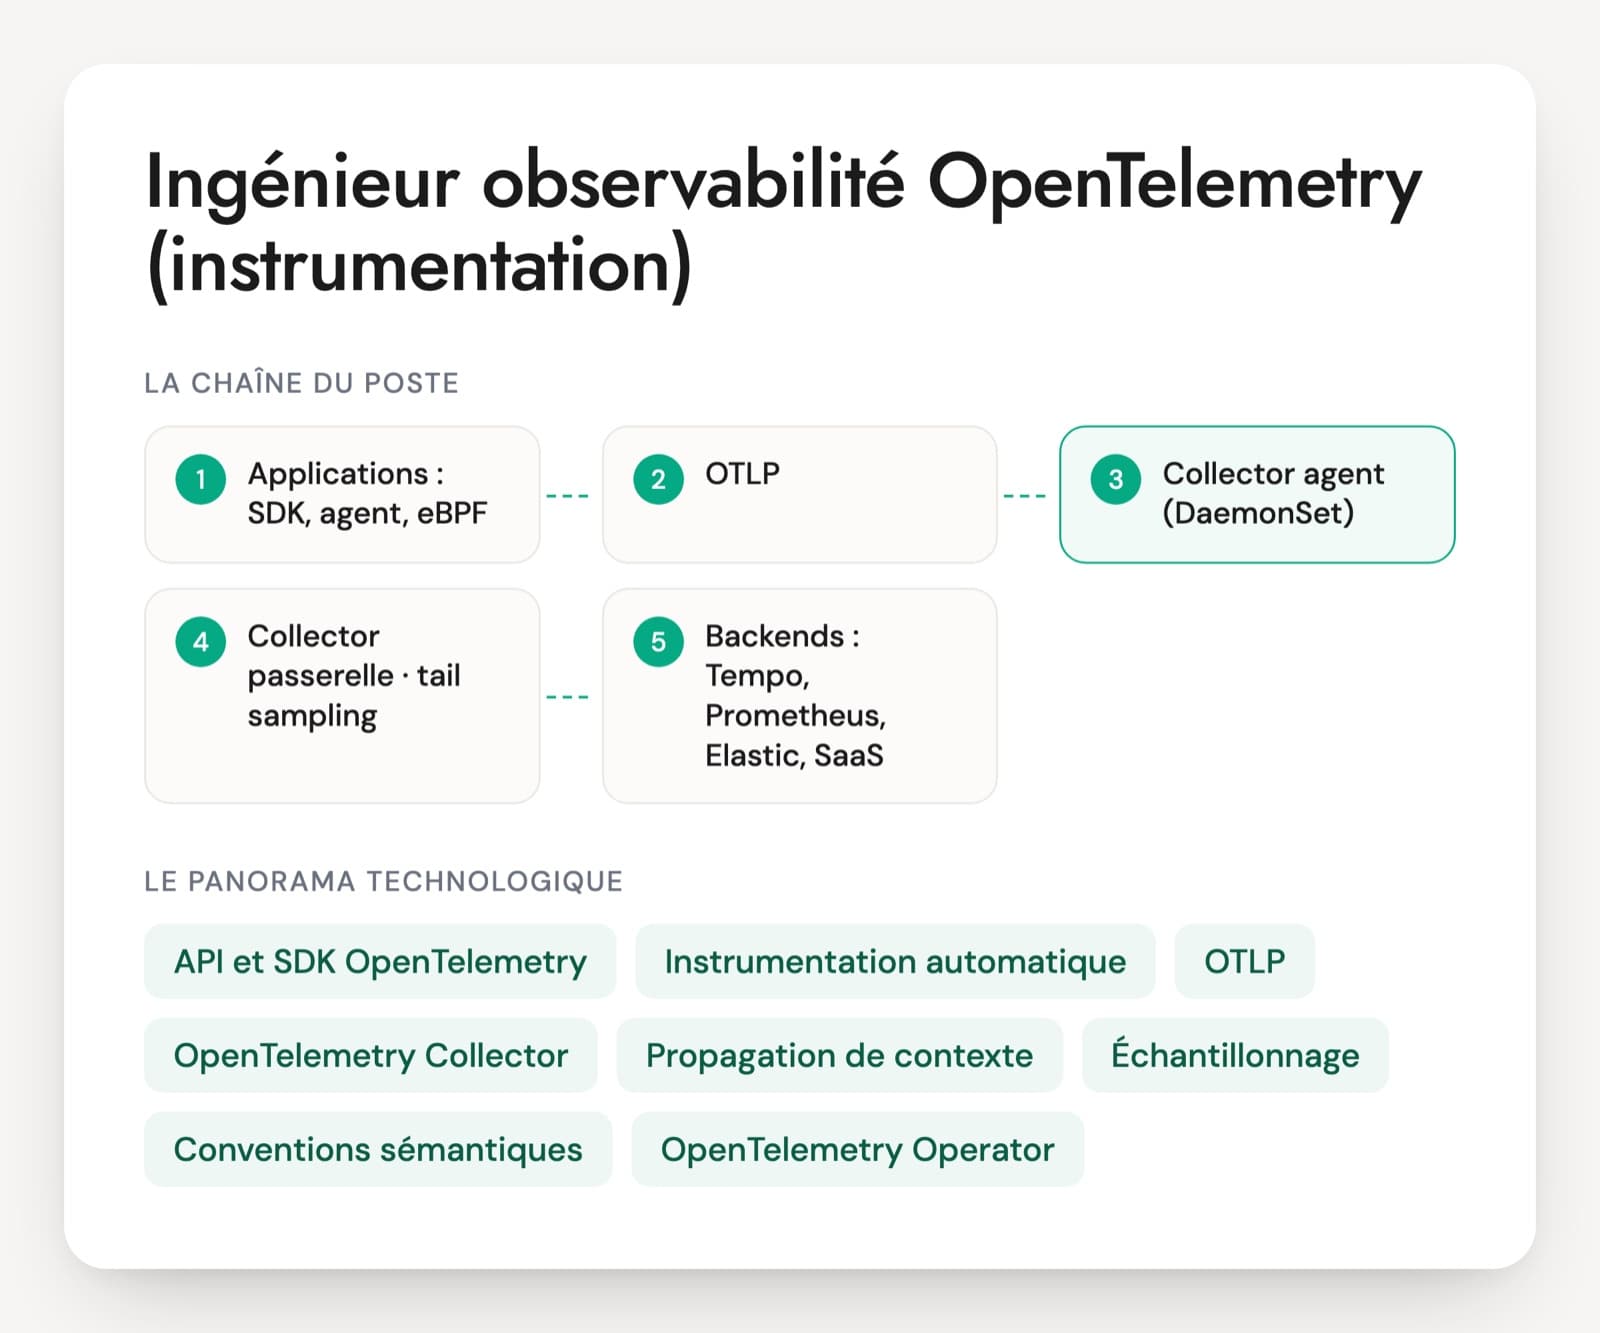
API et SDK OpenTelemetry
L'API sert à créer des spans, des métriques et des logs dans le code. Le SDK, choisi par l'application, décide de l'échantillonnage, du regroupement et de l'envoi. Les traces et les métriques sont stables dans les principaux langages, les logs dans une partie d'entre eux. Le candidat doit savoir lequel des deux une bibliothèque doit importer.
Instrumentation automatique
L'agent Java, opentelemetry-instrument en Python ou les paquets Node.js tracent les frameworks courants sans modifier le code. C'est le point de départ de la plupart des déploiements. Les attributs métier et les étapes internes demandent ensuite de l'instrumentation manuelle.
OTLP
Le protocole d'échange d'OpenTelemetry, en gRPC ou en HTTP. Les SDK l'émettent, le Collector le reçoit et la plupart des backends l'acceptent aujourd'hui, qu'ils soient open source ou commerciaux.
OpenTelemetry Collector
Le service qui reçoit, transforme et renvoie la télémétrie. Sa configuration enchaîne des receivers, des processors, des exporters et des connectors dans des pipelines. Il tourne en agent sur chaque nœud, en passerelle centrale, ou les deux. Une équipe sérieuse construit sa propre distribution avec l'outil ocb.
Propagation de contexte
Le mécanisme qui relie les spans d'une même requête entre services, par l'en-tête W3C traceparent, et parfois B3 sur des systèmes plus anciens. Le baggage transporte des valeurs supplémentaires. Les traces coupées viennent presque toujours de là.
Échantillonnage
En tête de trace (head sampling), dans le SDK, la décision est prise au premier span. En fin de trace (tail sampling), dans le Collector, on garde selon le résultat, par exemple toutes les erreurs. Le second demande une architecture à deux couches de Collectors.
Conventions sémantiques
Les noms communs des attributs : service.name, http.request.method, db.system.name et des centaines d'autres. Elles sont versionnées, et le passage des conventions HTTP au statut stable a renommé des attributs. La variable OTEL_SEMCONV_STABILITY_OPT_IN pilote la migration.
OpenTelemetry Operator
L'opérateur Kubernetes qui déploie les Collectors et injecte l'instrumentation automatique dans les pods par annotation. Son Target Allocator répartit le scraping des métriques Prometheus entre plusieurs Collectors.
eBPF : OBI et Pixie
OpenTelemetry eBPF Instrumentation, issue de Grafana Beyla, observe le trafic depuis le noyau Linux et produit des spans et des métriques sans toucher au code. Pixie sert au diagnostic en direct dans un cluster. Ni l'un ni l'autre ne remplace l'instrumentation dans le code.
Le poste porte plusieurs noms : ingénieur observabilité, SRE observabilité, platform engineer, parfois expert OpenTelemetry en mission. Dans une équipe plateforme, il fournit aux développeurs une instrumentation prête à l'emploi, une bibliothèque de conventions et des Collectors gérés. En mission de conseil, il cadre souvent une sortie d'agent propriétaire ou la rationalisation de plusieurs outils. Il travaille au contact du code des équipes, en Java, Go, Python ou Node.js, et de Kubernetes, où tourne la plupart des Collectors. La certification OpenTelemetry Certified Associate de la Linux Foundation, examen de 90 minutes valable deux ans, vérifie les connaissances. L'exploitation d'un pipeline en production se vérifie en entretien.
Ce qu'un ingénieur OpenTelemetry doit savoir faire seul
- Instrumentation automatique et manuelle
- Propagation de contexte et traces distribuées
- Architecture et exploitation du Collector
- Échantillonnage et maîtrise du volume
- Conventions sémantiques et attributs de ressource
- Kubernetes, Operator et eBPF
Le code, le contexte, le Collector : cinq questions OpenTelemetry
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Dans un service Java, les spans créés dans un pool de threads maison apparaissent comme des traces séparées, sans parent. Pourquoi, et que corrigez-vous ?
Une bonne réponseLe contexte OpenTelemetry est attaché au thread courant. Quand le travail passe à un autre thread, le contexte ne suit pas, sauf si l'exécuteur est enveloppé. La correction consiste à envelopper l'ExecutorService avec Context.taskWrapping, ou à capturer Context.current() avant l'envoi puis à le rendre actif dans la tâche avec makeCurrent(). Avec l'agent Java, les exécuteurs standard sont déjà instrumentés ; un pool maison ou une bibliothèque réactive mal couverte demande ce travail à la main.
Signal d'alerte« Il faut augmenter l'échantillonnage », ou créer un nouveau trace id à la main pour recoller les morceaux. Une réponse qui ne parle jamais du contexte courant.
Question 2 · confirmé
Le Collector passerelle est tué pour dépassement de mémoire (OOMKilled) dès que le trafic double. Comment le configurez-vous pour qu'il tienne ?
Une bonne réponseLe processor memory_limiter en premier dans chaque pipeline, réglé sous la limite du conteneur, avec GOMEMLIMIT aligné, pour refuser les données avant la saturation plutôt que de tomber. Ensuite la file d'envoi des exporters (sending_queue) dimensionnée, éventuellement persistée sur disque avec l'extension file_storage, et des réessais bornés. Le Collector passe à l'échelle horizontalement derrière un load balancer. Un bon profil surveille ses métriques internes : données refusées par les receivers, taille de file et échecs d'envoi des exporters.
Signal d'alerte« On lui donne plus de mémoire » comme seule réponse, ou un memory_limiter placé en fin de pipeline. Aucune idée de ce que deviennent les données quand le backend ralentit.
Question 3 · senior
Vous voulez garder toutes les traces en erreur et 5 % des autres. Où prenez-vous cette décision, et qu'est-ce que cela impose à l'architecture ?
Une bonne réponseUne décision en fin de trace (tail sampling), donc dans le Collector avec le processor tail_sampling, puisqu'au premier span on ne sait pas encore si la trace échouera. Tous les spans d'une même trace doivent arriver sur la même instance : une première couche de Collectors utilise l'exporter loadbalancing, routé par trace id, vers une seconde couche qui échantillonne. Il faut régler le temps d'attente avant décision et la mémoire qui en découle. Les métriques de taux d'erreur et de latence se calculent avant l'échantillonnage, par exemple avec le connector spanmetrics.
Signal d'alerteUn ratio fixe dans le SDK de chaque service, présenté comme capable de garder les erreurs. Ou un tail sampling sur plusieurs replicas sans routage par trace id.
Question 4 · confirmé
Après une mise à jour de l'instrumentation HTTP, les tableaux de bord construits sur l'attribut http.method sont vides. Que s'est-il passé, et comment migrez-vous sans trou dans les courbes ?
Une bonne réponseL'instrumentation est passée aux conventions sémantiques HTTP stables, qui renomment plusieurs attributs : http.request.method, http.response.status_code, url.full, server.address. Pendant la transition, la variable OTEL_SEMCONV_STABILITY_OPT_IN=http/dup fait émettre les anciens et les nouveaux noms. On met à jour les requêtes et les alertes, puis on coupe l'ancien format. Un profil expérimenté sait aussi recopier un attribut dans le Collector avec le processor transform quand certaines applications ne peuvent pas être mises à jour tout de suite.
Signal d'alerte« Le backend a perdu les données », ou un retour à l'ancienne version de l'agent sans plan. Une réponse qui ignore qu'il existe des conventions versionnées.
Question 5 · confirmé
L'agent automatique couvre les appels HTTP et SQL, mais l'équipe veut savoir quel type de commande et quel client ralentissent. Qu'ajoutez-vous dans le code, et où vous arrêtez-vous ?
Une bonne réponseDes attributs métier sur le span courant (type de commande, canal), et quelques spans manuels autour des étapes qui comptent, écrits avec l'API OpenTelemetry. L'identifiant client peut aller sur un span, pas sur une métrique, où il ferait exploser le nombre de séries. Pas de données personnelles en clair. Les noms suivent une convention commune à l'équipe, et une bibliothèque partagée ne dépend que de l'API, jamais du SDK.
Signal d'alerteUn span par fonction, ou l'e-mail du client en attribut de métrique. Ou l'idée qu'il faut abandonner l'agent pour tout réécrire à la main.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Poste OpenTelemetry, les questions fréquentes
OpenTelemetry remplace-t-il Datadog, Dynatrace ou Grafana ?
Non. OpenTelemetry produit, transporte et transforme la télémétrie, mais ne la stocke pas et ne fournit ni tableaux de bord ni alertes. Il faut toujours un backend : Prometheus et Tempo, Elastic, ou un SaaS. La plupart des éditeurs acceptent désormais l'OTLP. L'intérêt est de pouvoir changer d'outil sans réinstrumenter les applications, à condition que le pipeline ait été conçu de façon neutre dès le départ.
Un ingénieur OpenTelemetry doit-il savoir coder ?
Oui, au moins lire et modifier le code des services. L'instrumentation manuelle, la propagation du contexte dans du code asynchrone et l'initialisation du SDK se font dans les dépôts des équipes. Un profil purement exploitation saura opérer des Collectors, mais aura du mal à expliquer pourquoi une trace se coupe. Les langages instrumentés comptent, et un extrait de code réel à commenter le confirme.
Comment organiser le test technique d'un ingénieur OpenTelemetry ?
Le support est une configuration de Collector avec deux ou trois défauts : memory_limiter absent ou mal placé, k8sattributes derrière une passerelle, tail sampling sur plusieurs replicas sans routage. La personne les trouve et les explique en 20 minutes. S'y ajoute un extrait de code où le contexte se perd dans un thread. Cet exercice court montre mieux l'expérience qu'un projet à rendre à la maison.
Que vaut la certification OTCA sur un CV ?
L'OpenTelemetry Certified Associate de la Linux Foundation est un QCM surveillé de 90 minutes, valable deux ans. Près de la moitié porte sur l'API et le SDK, un quart sur le Collector. Elle montre que la personne connaît les concepts et le vocabulaire. Elle ne prouve pas qu'elle a exploité un pipeline en production. Un candidat certifié doit encore raconter un incident de télémétrie qu'il a diagnostiqué.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.