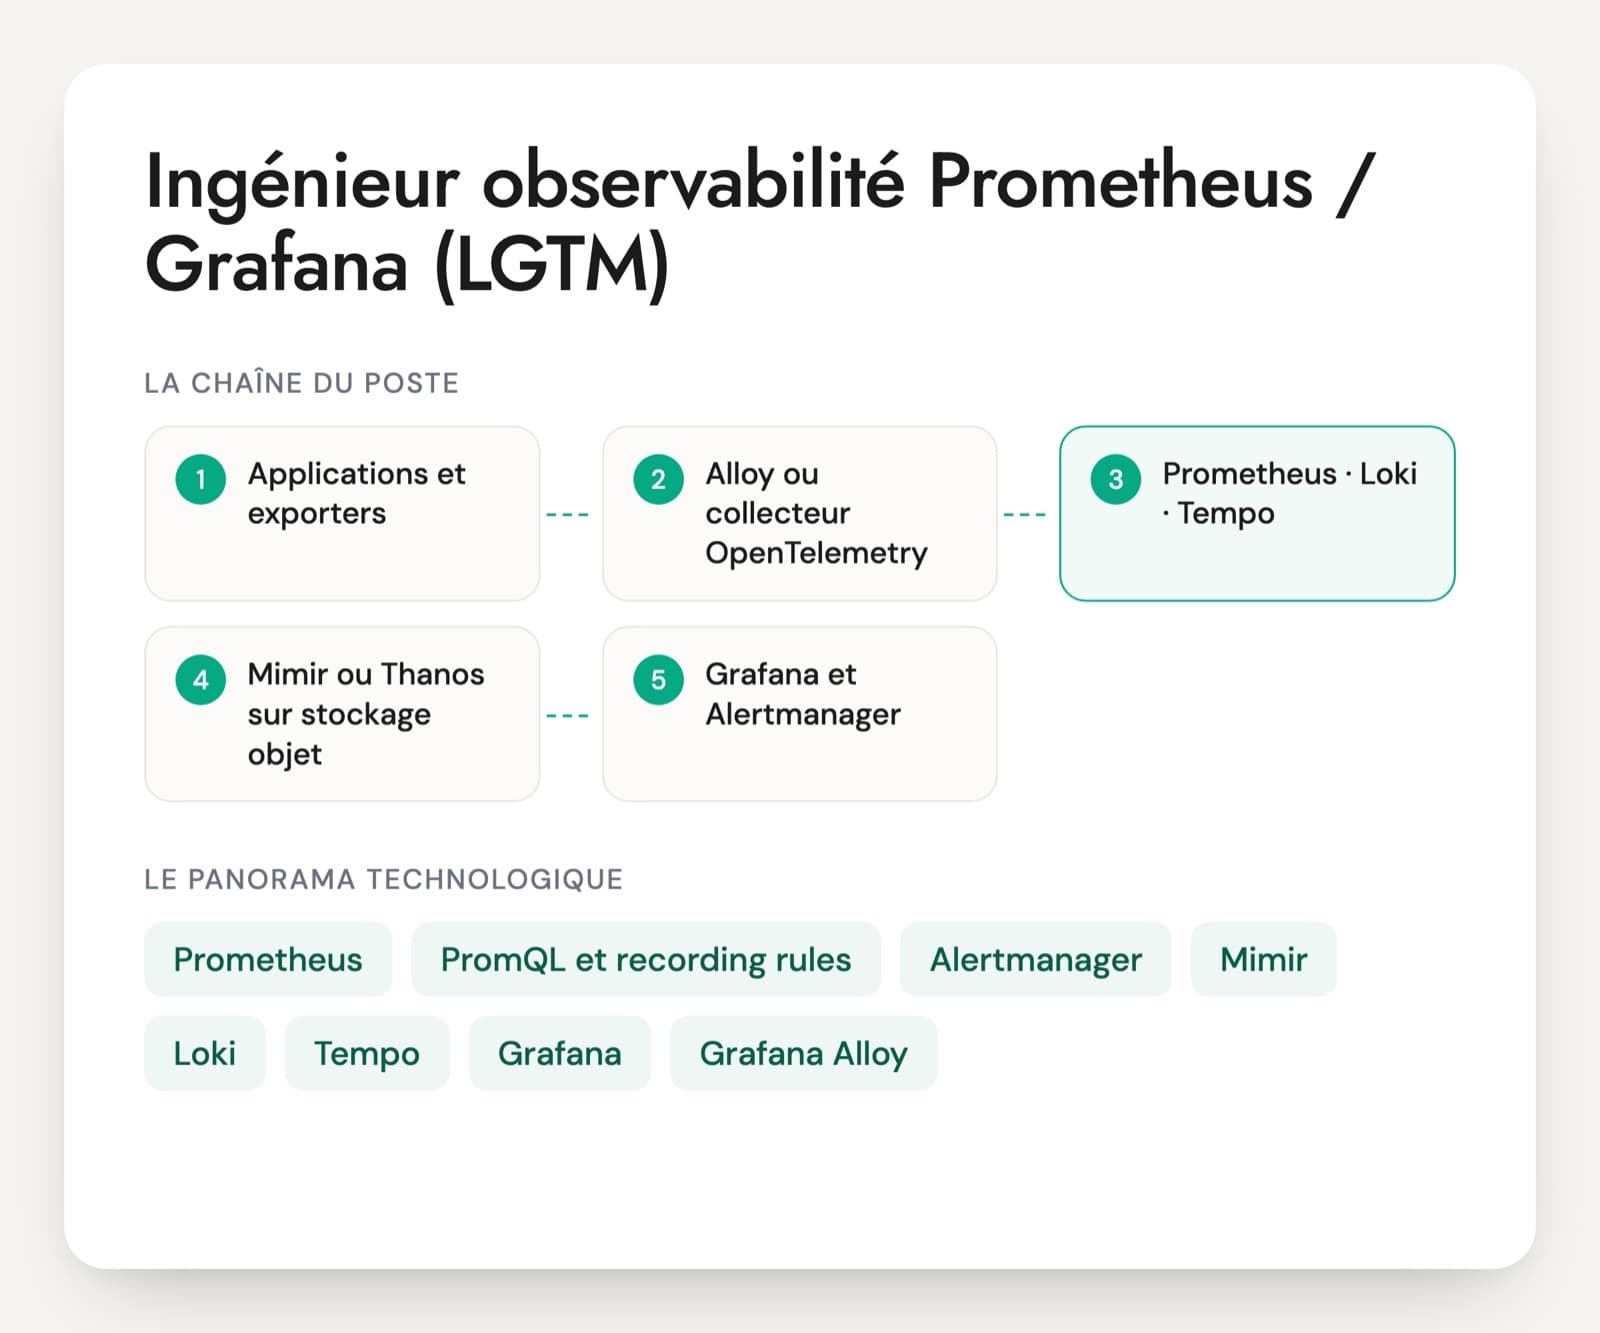
Un ingénieur observabilité Prometheus / Grafana construit et exploite la pile open source que les équipes ouvrent pendant leurs incidents. Il écrit les règles d'enregistrement et d'alerte, règle Alertmanager, choisit le stockage long terme et déploie les collecteurs, aujourd'hui Grafana Alloy ou le collecteur OpenTelemetry. Sur Kubernetes, il passe par le Prometheus Operator et ses ServiceMonitor.
Presque tous les CV citent Grafana, parfois pour avoir seulement monté des tableaux de bord. L'expérience d'exploitation se reconnaît à d'autres sujets : une mémoire de Prometheus qui explose à cause d'un label, un remote_write en retard, une alerte restée muette pendant une panne, des streams Loki trop nombreux.
Les versions récentes modifient quelques réponses attendues. Promtail est en fin de vie depuis le 2 mars 2026 au profit d'Alloy, et les histogrammes natifs sont stables depuis Prometheus 3.8. Une personne qui suit la pile le sait sans qu'on le lui demande. Le PDF détaille 30 questions sur six axes, un cas de 20 minutes et une grille de 1 à 4.
Prometheus, Grafana, Loki, Tempo, Mimir : à quoi sert chaque brique
Prometheus
La base de métriques open source. Elle va chercher (scrape) les métriques exposées par les applications et les exporters, les stocke localement et évalue les règles d'alerte. Un Prometheus garde en général quelques semaines de données ; au-delà, il faut un stockage long terme.
PromQL et recording rules
Le langage de requête de Prometheus, repris par Mimir, Thanos et VictoriaMetrics. Les recording rules précalculent les requêtes lourdes. C'est la compétence de base du poste : une requête s'écrit pendant l'entretien.
Alertmanager
Il reçoit les alertes de Prometheus, les regroupe, les route vers la bonne équipe (Slack, PagerDuty, e-mail) et applique silences et inhibitions. Une mauvaise configuration produit soit du bruit, soit des alertes qui n'arrivent jamais.
Mimir, Thanos ou VictoriaMetrics
Trois façons de garder les métriques des mois sur du stockage objet et de les interroger depuis plusieurs clusters. Mimir et VictoriaMetrics reçoivent les données en remote_write, Thanos se branche à côté de Prometheus. Chacun a ses composants à dimensionner et à surveiller.
Loki
Le stockage de logs de Grafana Labs. Il n'indexe que les labels, pas le texte, ce qui le rend économique tant que les labels restent peu nombreux. Le langage LogQL ressemble à PromQL.
Tempo
Le stockage de traces distribuées, alimenté par OpenTelemetry. Il se relie aux métriques par les exemplars et aux logs par le trace_id. La question du volume et de l'échantillonnage arrive vite.
Grafana
L'interface de visualisation et d'exploration, qui gère aussi des alertes. Les équipes matures décrivent leurs tableaux de bord en code et les déploient comme le reste de l'infrastructure.
Grafana Alloy
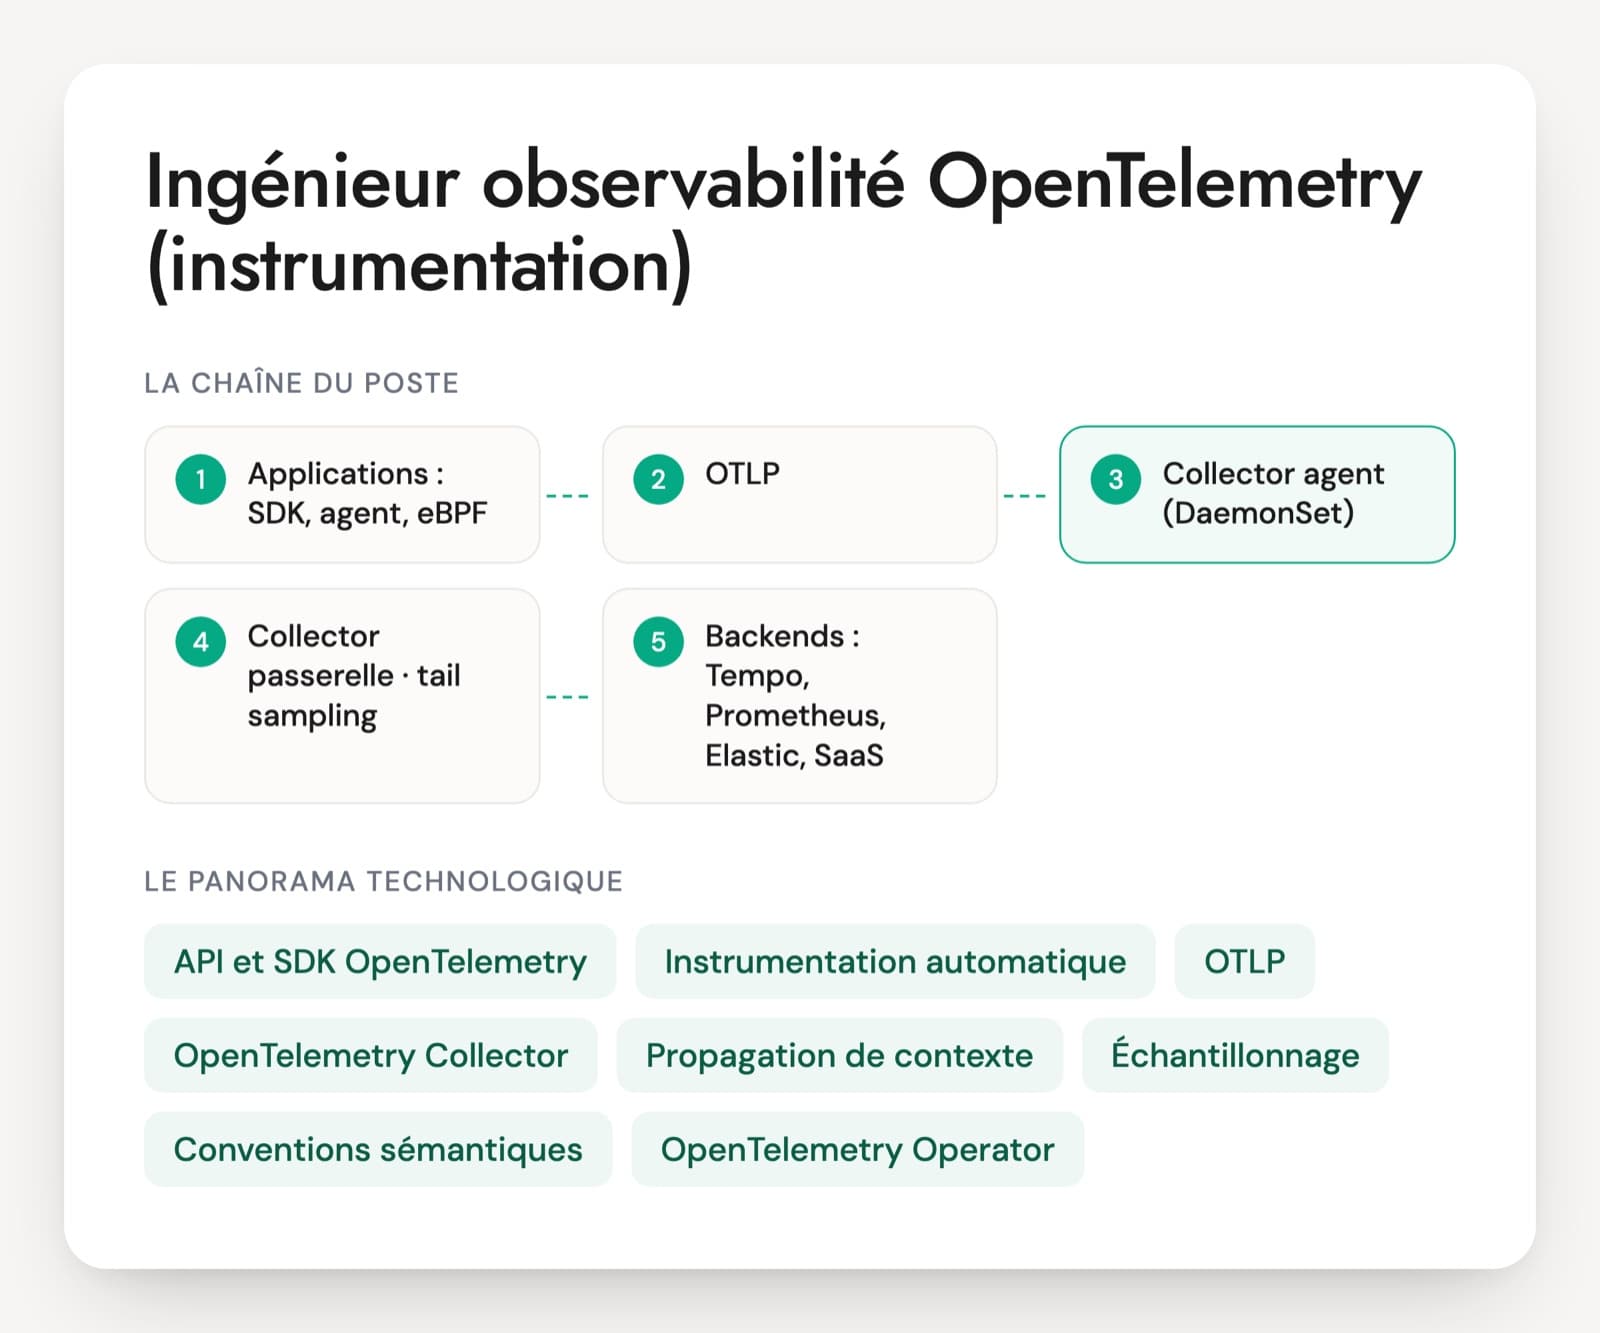
Le collecteur de Grafana Labs, une distribution du collecteur OpenTelemetry qui remplace Grafana Agent et Promtail. Il collecte métriques, logs et traces et les envoie vers la pile ou vers Grafana Cloud.
Prometheus Operator
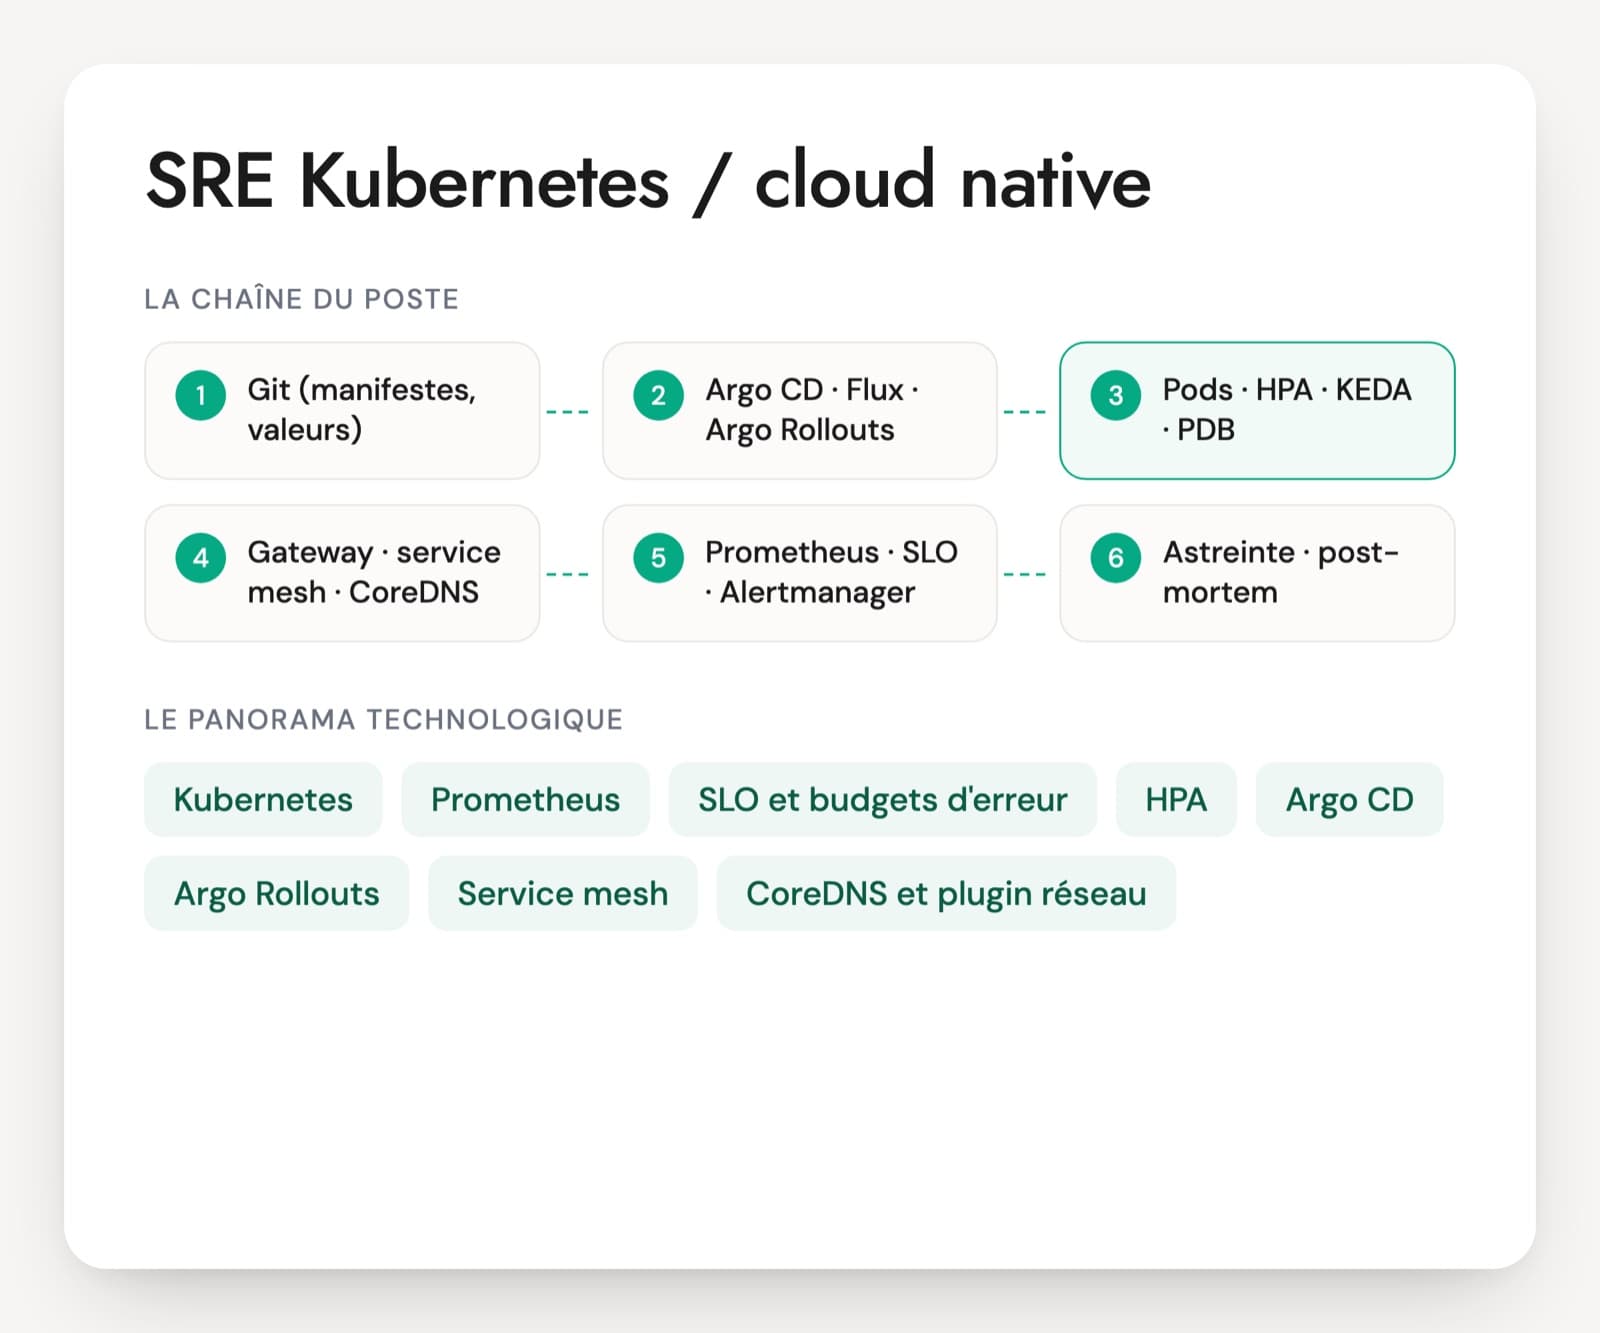
Il pilote Prometheus et Alertmanager sur Kubernetes avec des ressources dédiées : ServiceMonitor, PodMonitor, PrometheusRule. Il est installé par le chart kube-prometheus-stack dans la plupart des clusters.
Le poste existe surtout là où l'entreprise a choisi d'opérer elle-même son observabilité, souvent sur Kubernetes, parfois pour des raisons de coût ou de maîtrise des données. Les missions publiées en France vont du simple outillage de supervision, avec Prometheus, Grafana et Alertmanager à côté d'un outil historique comme Centreon, jusqu'à l'exploitation complète d'une pile LGTM (Loki, Grafana, Tempo, Mimir) avec Alloy, OpenTelemetry et du GitOps. Sur Grafana Cloud, l'éditeur opère le stockage et le poste se concentre sur la collecte, la cardinalité et les alertes. La certification CKA aide pour la partie Kubernetes ; il n'existe pas de certification Prometheus aussi répandue, et l'expérience d'exploitation se vérifie en entretien.
Les savoir-faire d'un ingénieur Prometheus / Grafana à noter
- PromQL et modèle de données
- Cardinalité et dimensionnement
- Règles d'alerte et Alertmanager
- Stockage long terme : Mimir, Thanos, VictoriaMetrics
- Logs et traces : Loki, Tempo, Alloy
- Prometheus sur Kubernetes et tableaux de bord en code
Cinq questions d'exploitation Prometheus / Grafana, avec la bonne réponse
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Un collègue a écrit sum(rate(http_requests_total[1m])) avec un scrape toutes les 30 secondes, et le graphe montre des trous et des pics. Qu'est-ce qui ne va pas ?
Une bonne réponseAvec un scrape à 30 secondes, une fenêtre d'une minute ne contient parfois qu'un seul échantillon, et rate() en demande au moins deux : d'où les trous. La règle pratique est une fenêtre d'au moins quatre fois l'intervalle de scrape, ou la variable $__rate_interval dans Grafana. La personne sait que rate() gère les remises à zéro des compteurs et qu'irate() ne regarde que les deux derniers points, ce qui donne un graphe nerveux.
Signal d'alerteRemplacer rate par increase sans comprendre, ou accuser Grafana.
Question 2 · confirmé
La mémoire de Prometheus a doublé en une semaine sans nouveau service. Comment trouvez-vous la cause ?
Une bonne réponseLe nombre de séries actives (prometheus_tsdb_head_series) et la page TSDB Status, ou promtool tsdb analyze, pour voir les métriques et les labels qui portent le plus de séries. Une requête du type topk(10, count by (__name__) ({__name__=~".+"})) donne aussi les métriques en tête. La cause habituelle est un label à valeurs illimitées : identifiant d'utilisateur, URL avec des identifiants, nom de pod qui change à chaque déploiement. On corrige l'instrumentation et, en attendant, on supprime le label ou la métrique avec metric_relabel_configs.
Signal d'alerteAjouter de la mémoire à la machine sans chercher la série responsable.
Question 3 · confirmé
Une alerte est restée muette pendant une panne de vingt minutes. Où cherchez-vous ?
Une bonne réponseL'expression d'abord : si la cible est tombée, la série n'existe plus et une alerte sur un seuil ne renvoie rien, il faut une règle sur up ou absent(). Puis un for trop long, des erreurs d'évaluation des règles (prometheus_rule_evaluation_failures_total), une route d'Alertmanager qui ne correspond pas, une inhibition ou un silence oublié, un receiver en échec (alertmanager_notifications_failed_total). Et Prometheus lui-même : s'il tombe, plus rien n'alerte, d'où une alerte Watchdog toujours active envoyée à un service externe qui sonne quand elle s'arrête.
Signal d'alerteBaisser tous les seuils pour que « ça sonne plus ».
Question 4 · senior
Prometheus garde quinze jours de données. L'équipe en veut treize mois, sur quatre clusters, avec une vue commune. Que proposez-vous ?
Une bonne réponseUn stockage long terme sur stockage objet : remote_write vers Mimir ou VictoriaMetrics, ou Thanos avec un sidecar à côté de chaque Prometheus, un compactor et un store gateway. Une rétention par tenant ou par type de données, et une vue globale qui interroge tous les clusters. Le candidat signale la déduplication des paires de Prometheus en haute disponibilité et le sous-échantillonnage, que Thanos propose pour accélérer les requêtes longues.
Signal d'alertePasser la rétention locale à treize mois sur un gros disque, sans vue entre clusters.
Question 5 · confirmé
Dans Loki, une équipe a mis trace_id et user_id en labels. Quelles conséquences, et que proposez-vous ?
Une bonne réponseChaque combinaison de labels crée un stream : l'index gonfle, les chunks deviennent minuscules, les limites d'ingestion sautent et les requêtes ralentissent. La documentation de Loki conseille des labels statiques et peu nombreux (cluster, namespace, application, environnement) et de garder un tenant sous environ 100 000 streams actifs. Les valeurs à forte cardinalité vont en structured metadata ou restent dans la ligne, filtrées à la requête.
Signal d'alerteAjouter des ingesters pour absorber le volume.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Les questions fréquentes sur les postes Grafana
Prometheus seul suffit-il, ou faut-il déjà Mimir ou Thanos ?
Un Prometheus par cluster suffit tant que la rétention locale couvre le besoin et qu'une vue par cluster convient. Mimir, Thanos ou VictoriaMetrics deviennent utiles pour garder les métriques plusieurs mois, interroger plusieurs clusters à la fois ou servir plusieurs équipes avec des limites séparées. Si la pile en compte déjà un, l'expérience sur ce composant précis est exigée : son dimensionnement et ses pannes ne s'apprennent pas en lisant la documentation.
Un profil Datadog peut-il prendre en main une pile Grafana ?
Il connaît les signaux, l'instrumentation et la conception d'alertes, qui forment une bonne partie du métier. Il lui manque souvent l'exploitation : dimensionner un Prometheus, opérer un stockage objet, monter un Loki, gérer les montées de version. PromQL et la cardinalité font la différence. S'il raisonne juste sur ces deux sujets, l'écart se comble sur un poste où il est accompagné.
Qu'écrit le candidat pendant le test technique ?
Trois requêtes PromQL suffisent à situer un niveau : un taux d'erreur par service, un percentile de latence calculé sur un histogramme, une alerte qui reste juste sur un service sans trafic. S'y ajoute une configuration Alertmanager à corriger, par exemple un regroupement qui envoie une notification par pod. Le candidat commente à voix haute : les erreurs de raisonnement apparaissent plus vite qu'à l'écrit.
Grafana Cloud ou pile auto-hébergée : le poste change-t-il ?
Oui, en partie. Sur Grafana Cloud, l'éditeur opère Mimir, Loki et Tempo, et l'ingénieur se concentre sur la collecte, la cardinalité, les alertes, les tableaux de bord et la facture, qui suit les séries actives et les volumes ingérés. En auto-hébergé, il opère aussi les composants, leur stockage objet et leurs montées de version. L'offre le précise, car les CV attendus ne sont pas les mêmes.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.