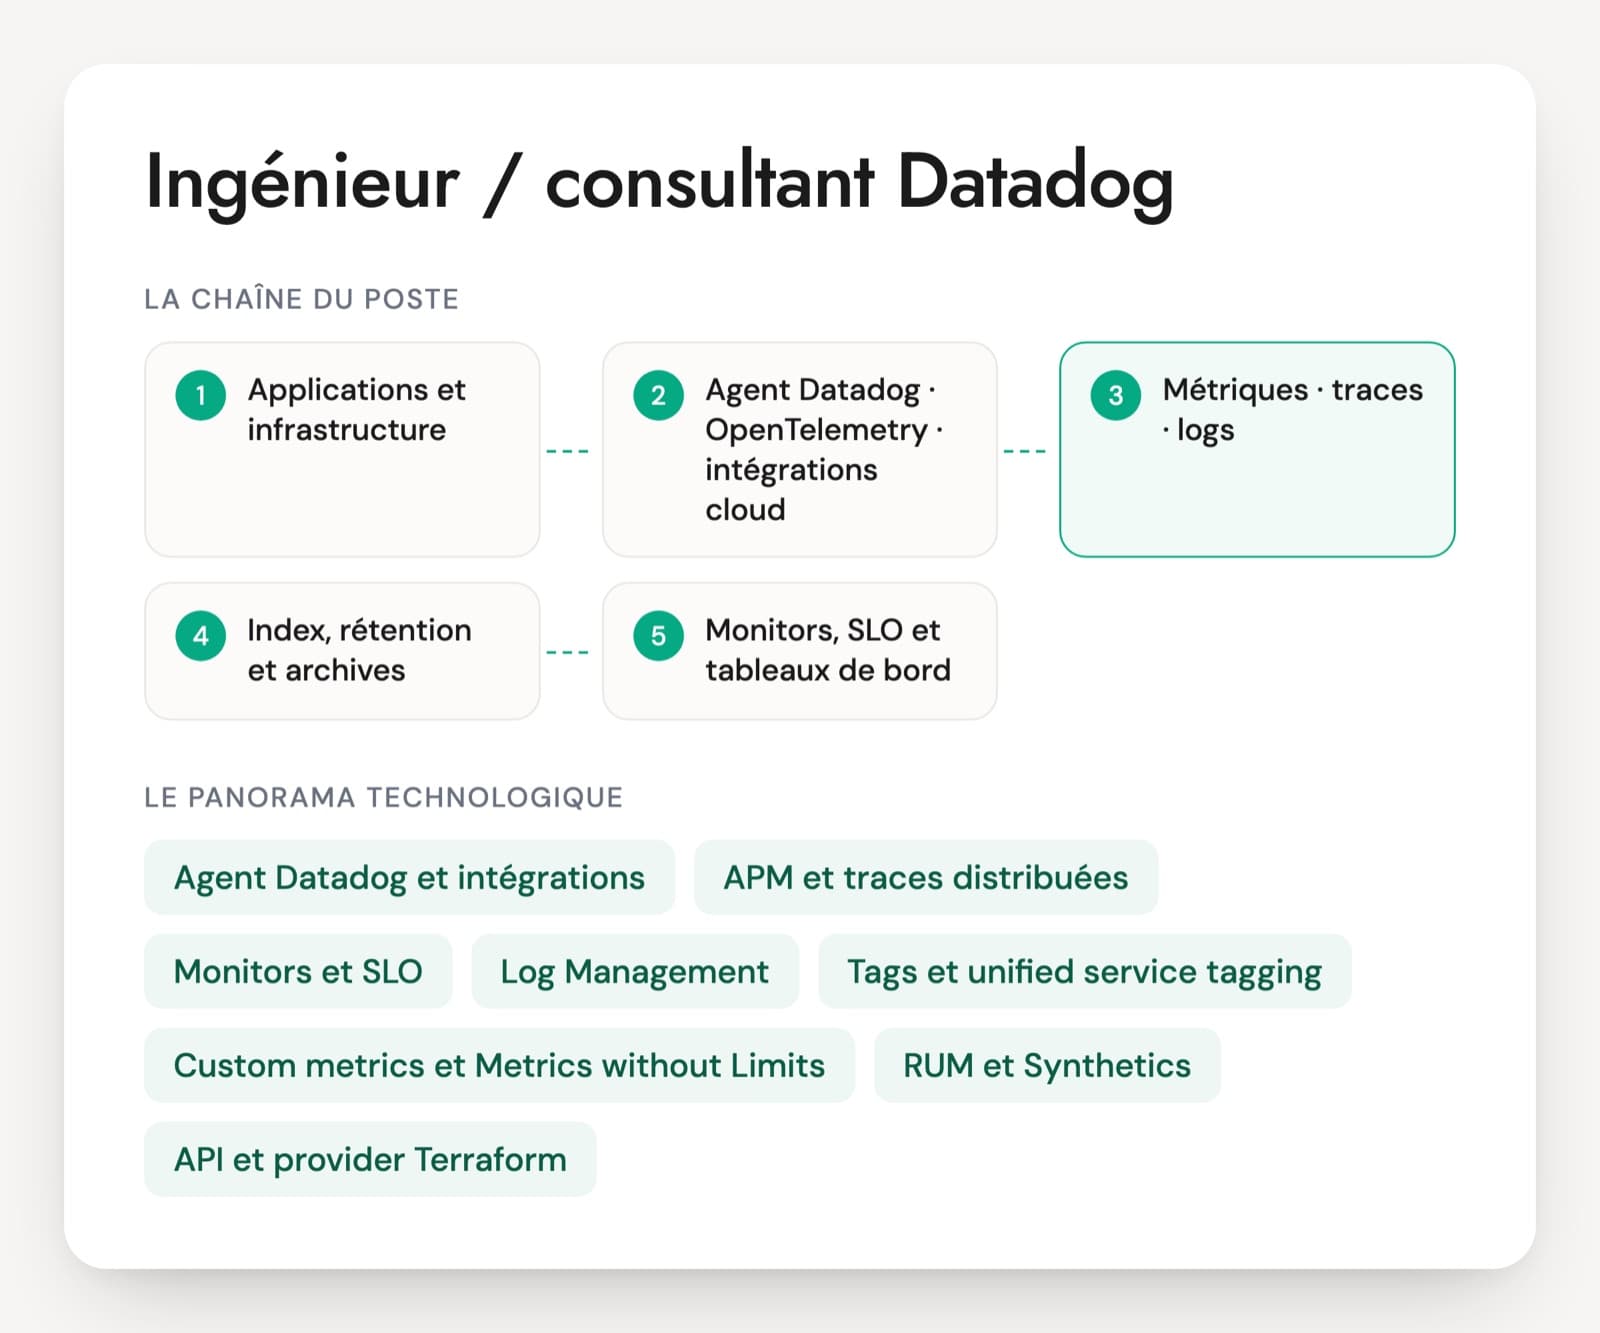
Un consultant Datadog arrive souvent sur un compte déjà ouvert : agents installés à la main, monitors sans propriétaire, facture qui grimpe. Ses missions vont du déploiement des agents sur Kubernetes et sur les VM à l'APM, aux pipelines de logs, aux SLO et à l'automatisation par l'API ou par Terraform. Les offres françaises demandent aussi RUM et Synthetics.
Un profil qui a seulement consulté des tableaux de bord connaît les écrans. Celui qui a administré la plateforme sait qu'une custom metric se compte par combinaison de tags, qu'un log exclu de l'index peut encore alimenter une métrique, et que l'échantillonnage de l'APM explique la plupart des traces manquantes.
Le plan souscrit change certaines réponses. L'allocation de custom metrics passe de 100 à 200 par hôte entre les offres Pro et Enterprise, et toutes les fonctions de suivi de l'usage par équipe ne sont pas disponibles partout. Le site compte aussi : chaque site Datadog, dont le site européen hébergé en Allemagne, est indépendant des autres. Le PDF reprend 30 questions sur six axes, un cas de 20 minutes et une grille de 1 à 4.
Ce que recouvre Datadog dans le quotidien du poste
Agent Datadog et intégrations
L'agent tourne sur chaque hôte ou nœud et collecte métriques, logs et traces. Plusieurs centaines d'intégrations couvrent bases, middlewares et clouds. Sur Kubernetes, il se déploie avec le Datadog Operator ou le chart Helm, avec un Cluster Agent en plus.
APM et traces distribuées
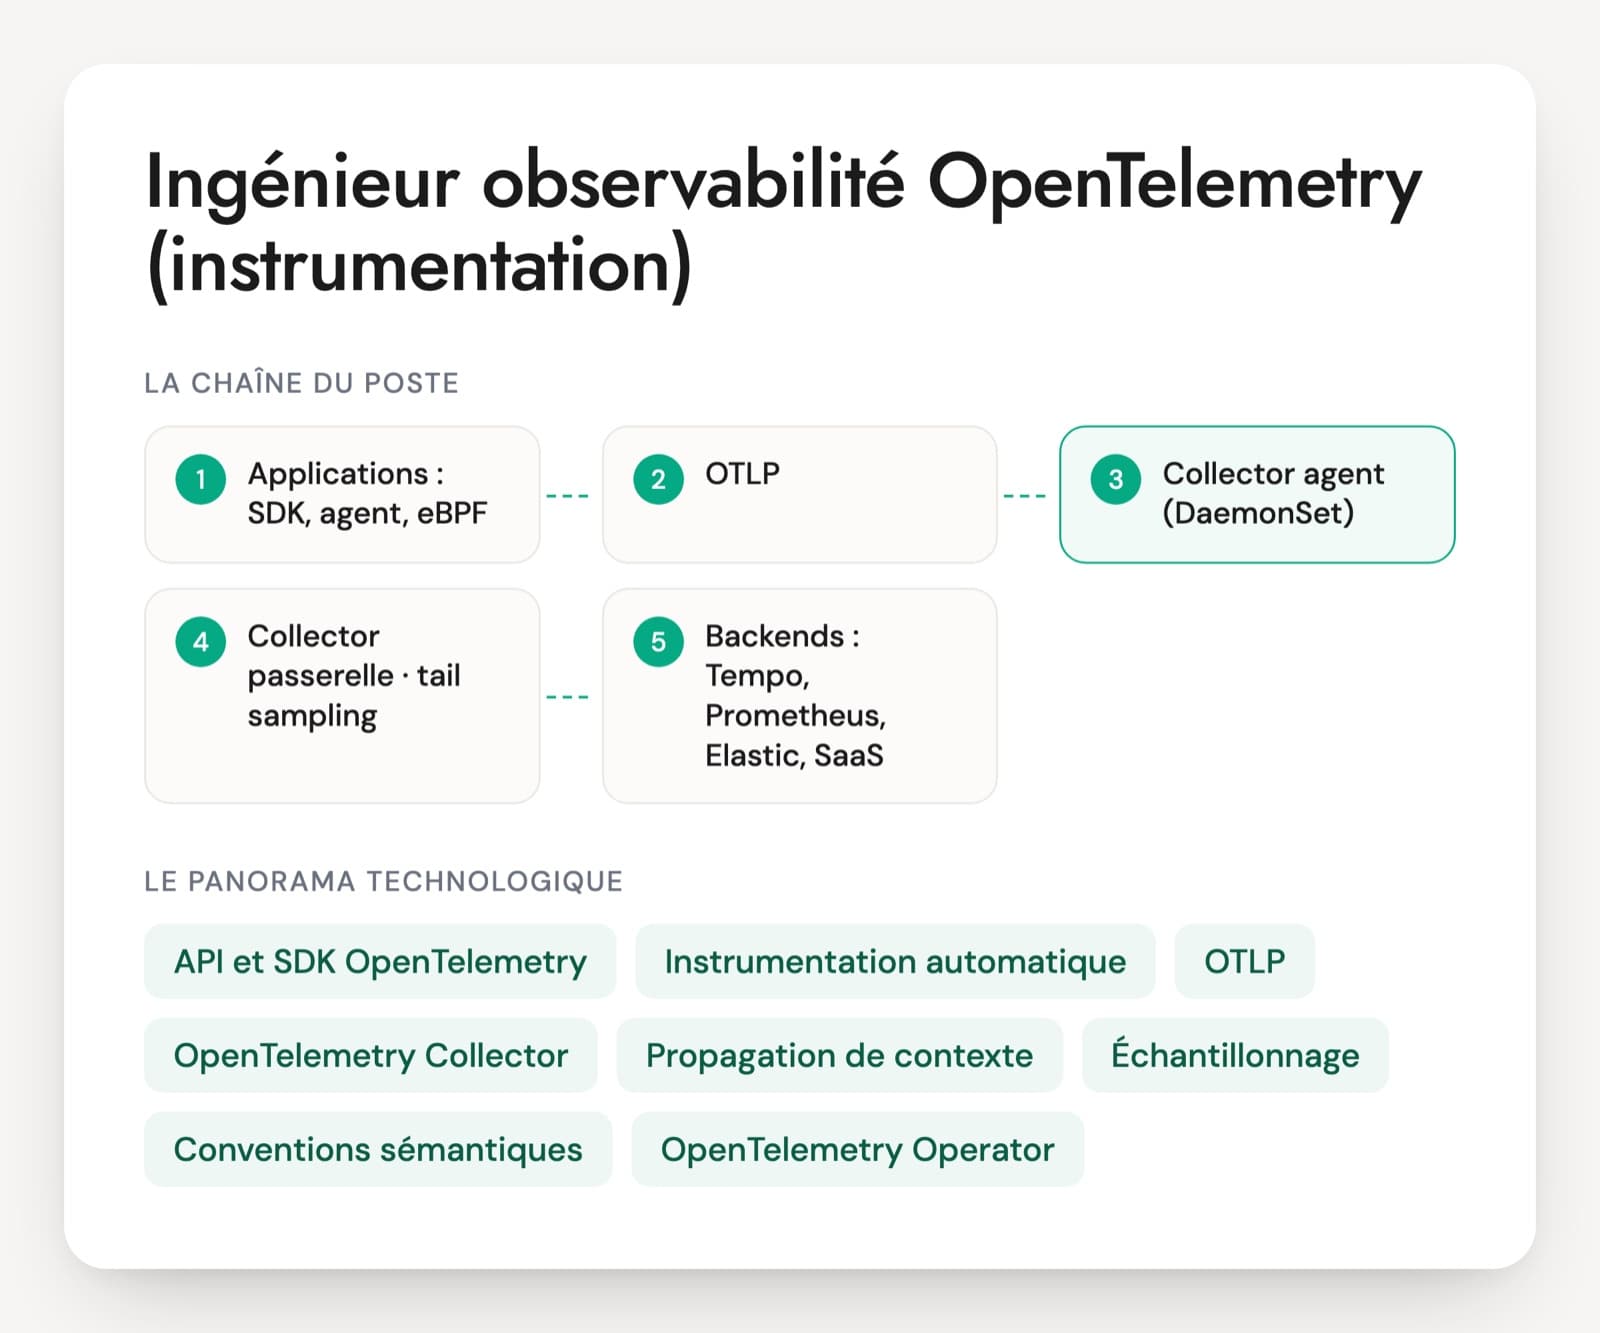
Les traceurs Datadog, ou OpenTelemetry, suivent chaque requête d'un service à l'autre. L'agent échantillonne les traces pour tenir les volumes, puis des filtres de rétention décident lesquelles restent consultables. Un bon profil sait expliquer pourquoi une trace manque.
Monitors et SLO
Les monitors déclenchent les alertes sur des métriques, des logs, des traces ou des tests. Les SLO se calculent à partir de métriques, de monitors ou de tranches de temps, avec des alertes sur le budget d'erreur. Les messages et le routage vers les équipes font la différence entre une alerte utile et du bruit.
Log Management
Les logs passent par des pipelines qui les découpent en attributs, puis vers des index payants à la ligne indexée. Les filtres d'exclusion, les archives sur stockage objet, la réhydratation et Flex Logs servent à garder longtemps sans tout indexer.
Tags et unified service tagging
Les tags relient tout : env, service et version identifient un service dans les métriques, les logs et les traces. Ils servent aussi à filtrer, à router les alertes et à répartir les coûts. Mal gérés, ils multiplient les séries facturées.
Custom metrics et Metrics without Limits
Chaque combinaison unique d'un nom de métrique et de valeurs de tags compte comme une custom metric. Metrics without Limits sépare ingestion et indexation pour ne garder dans l'index que les tags utiles. C'est le premier poste de dérive de la facture à surveiller.
RUM et Synthetics
RUM mesure l'expérience réelle des utilisateurs dans le navigateur ou l'application mobile. Synthetics lance des tests programmés sur des API et des parcours web. Plusieurs offres françaises les demandent explicitement.
API et provider Terraform
Tableaux de bord, monitors, SLO et pipelines se décrivent en code avec le provider Terraform de Datadog, ou s'automatisent par l'API. Sur un compte partagé par plusieurs équipes, c'est la seule façon de garder une configuration cohérente.
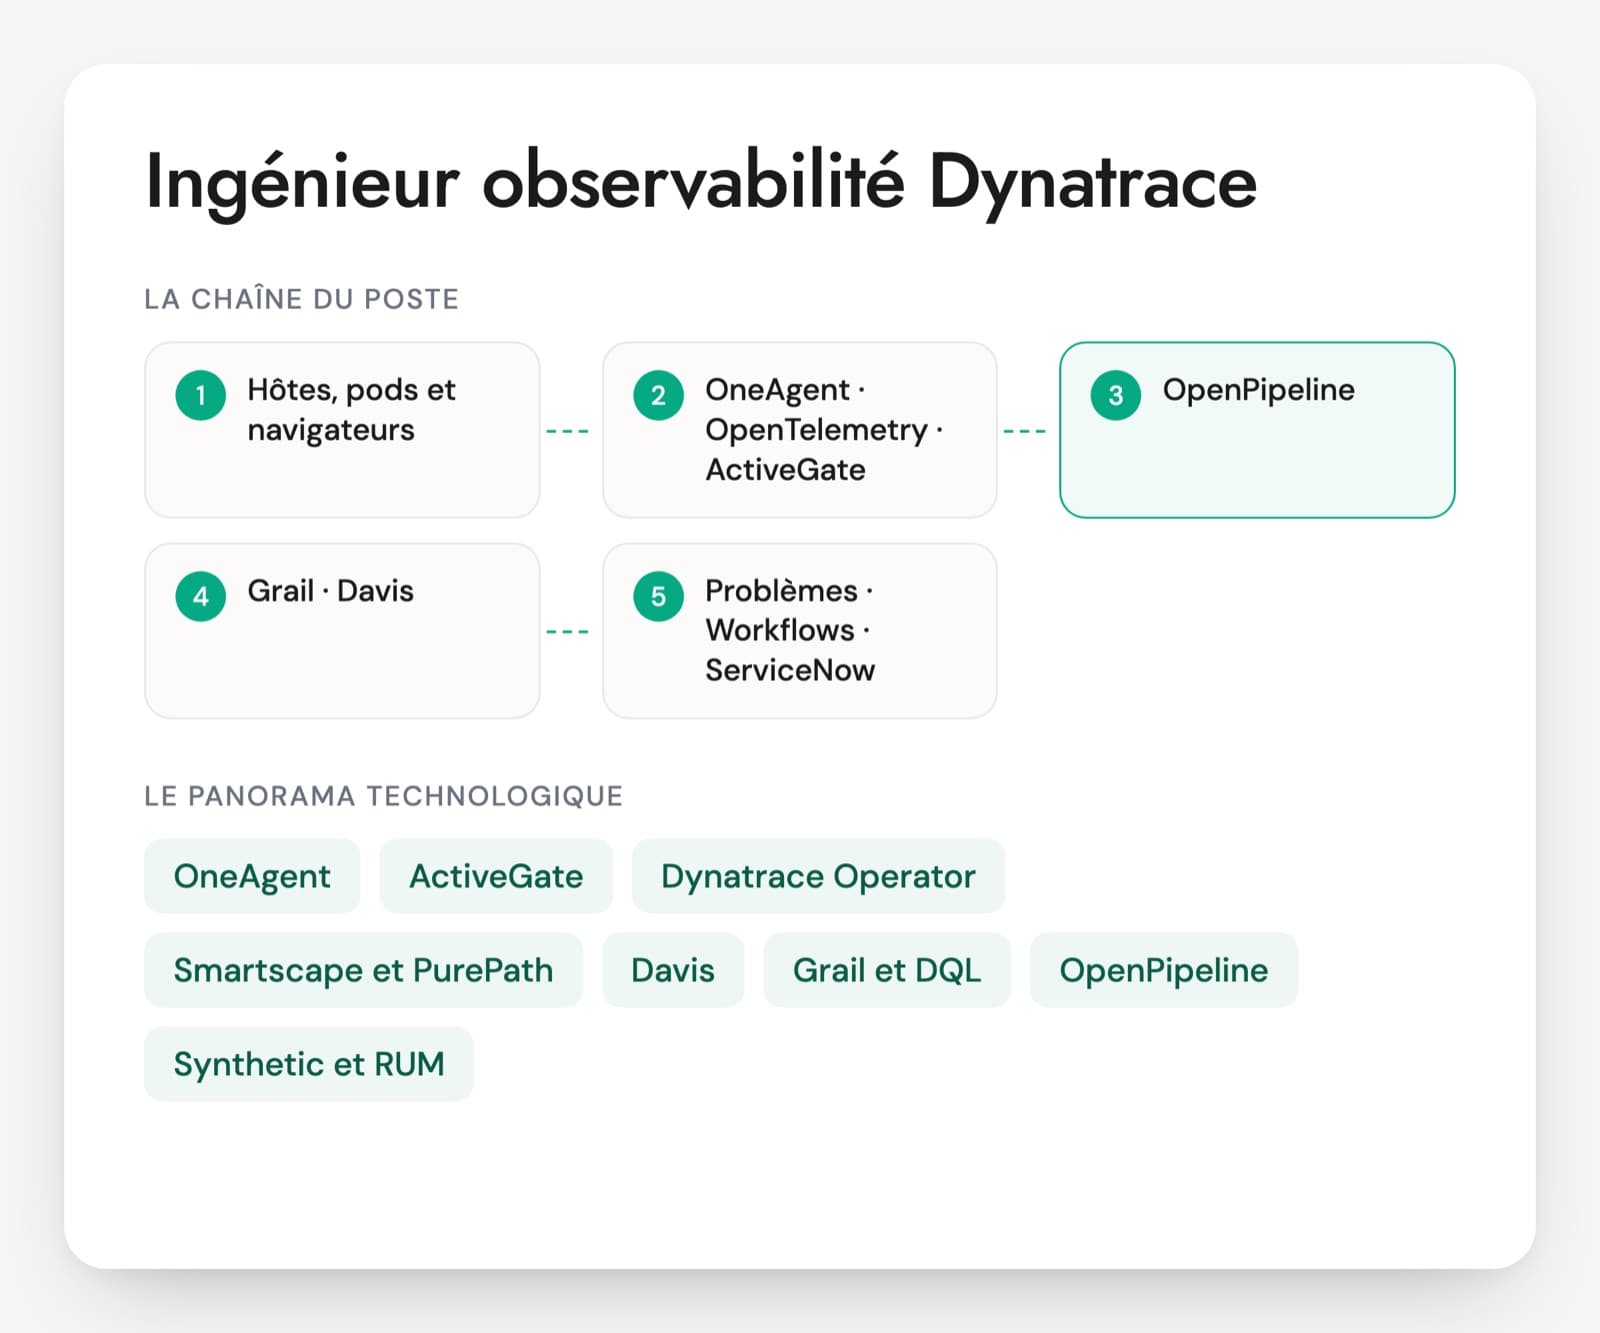
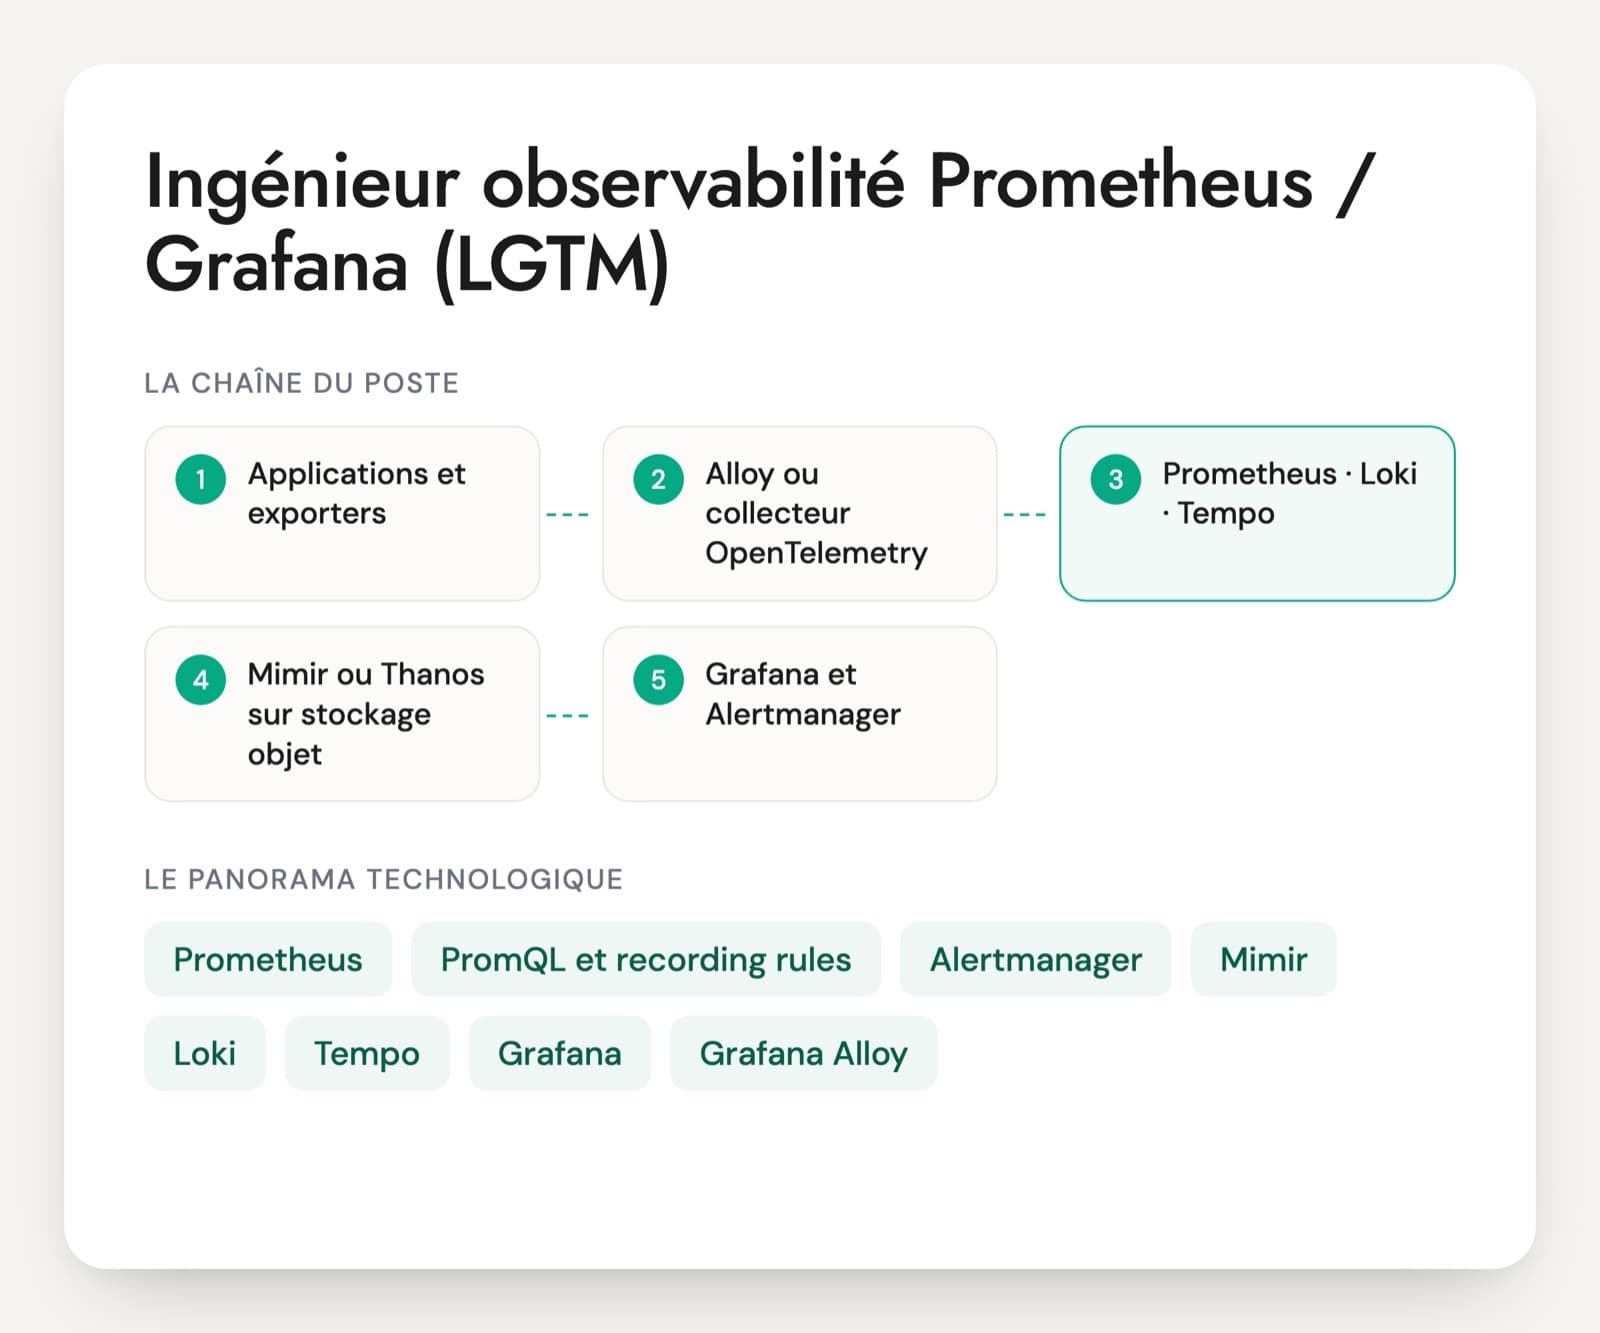
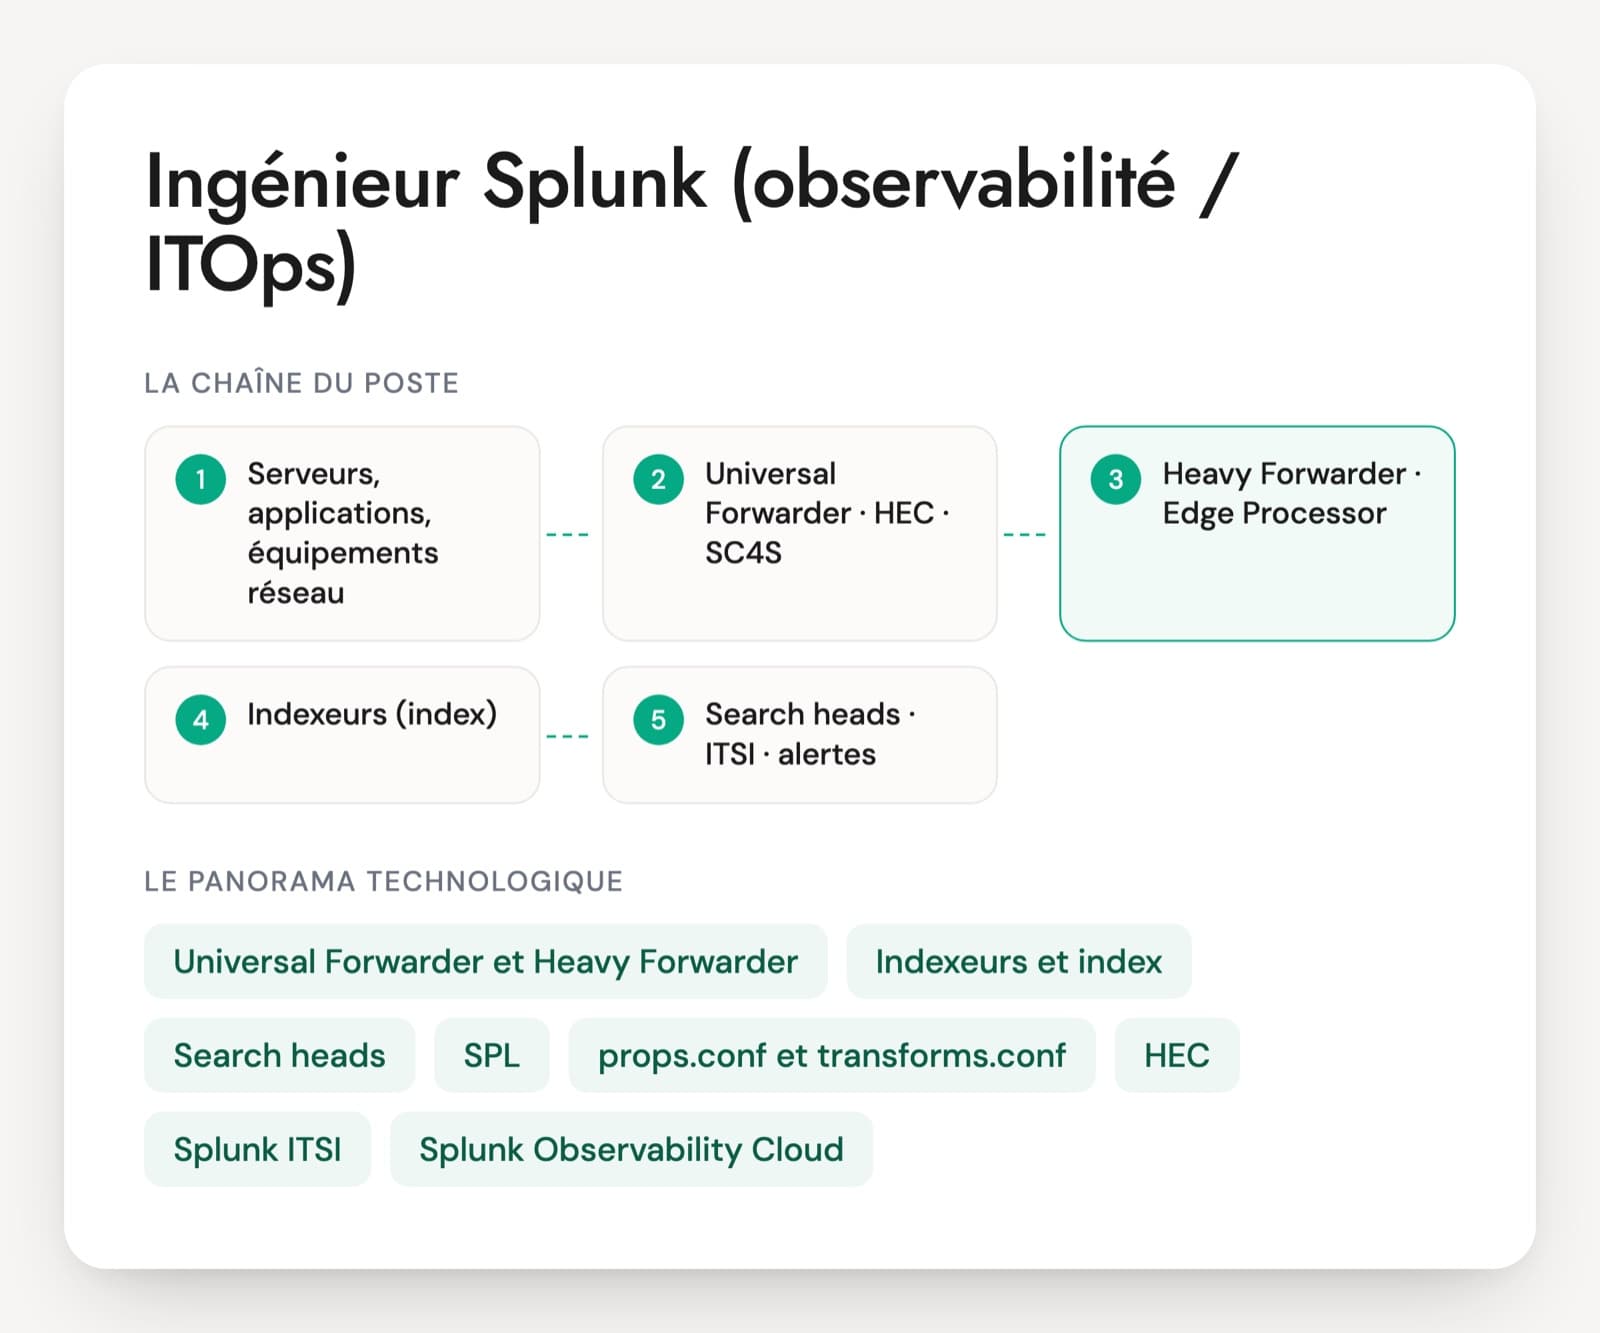
Les annonces françaises distinguent plusieurs profils sous le même outil. L'administrateur Datadog, souvent associé à Linux, tient les agents, les intégrations et les droits. Le consultant ou l'expert cadre un déploiement, standardise tableaux de bord et monitors, et accompagne les équipes applicatives, parfois en anglais et sur un environnement hybride avec Azure. Les missions combinent souvent Datadog avec Dynatrace, ELK ou Prometheus et Grafana, et demandent de l'automatisation en Python ou avec Terraform. La maîtrise du coût revient partout dès que le compte dépasse quelques dizaines d'hôtes. Datadog propose des certifications sur ses fondamentaux, ses logs et son APM ; elles attestent la connaissance du produit, pas l'administration d'un compte en production.
Datadog : six points techniques à faire démontrer
- Déploiement de l'agent et intégrations
- APM, traces et échantillonnage
- Monitors, SLO et routage des alertes
- Logs : pipelines, index et archives
- Tags et unified service tagging
- Maîtrise de la facture et configuration en code
Cinq cas Datadog à faire résoudre en entretien
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
La facture de custom metrics a triplé en deux mois. Comment trouvez-vous la métrique responsable ?
Une bonne réponseUne custom metric se compte par combinaison unique du nom et des valeurs de tags, host compris, en moyenne horaire sur le mois. La page d'usage liste les métriques qui pèsent le plus (accès avec le rôle admin ou la permission usage_read), et les métriques d'usage estimé permettent de suivre l'évolution. La cause habituelle est un tag à valeurs illimitées (identifiant d'utilisateur, de requête, URL complète) ou une distribution à qui l'on a ajouté des percentiles, ce qui double le nombre de séries. On corrige l'instrumentation, et Metrics without Limits permet de n'indexer que les tags réellement interrogés.
Signal d'alerteEnvoyer la métrique moins souvent, ou supprimer des tableaux de bord pour faire baisser la facture.
Question 2 · confirmé
Les traces d'un service ne sont reliées ni à ses logs ni aux métriques de ses conteneurs. Que vérifiez-vous ?
Une bonne réponseL'unified service tagging : les trois tags réservés env, service et version, posés par les labels tags.datadoghq.com/env, /service et /version sur le Deployment et sur le modèle de pod, et par les variables DD_ENV, DD_SERVICE et DD_VERSION côté traceur (downward API ou injection par l'admission controller du Cluster Agent). Puis l'injection du trace_id dans les logs et un pipeline de logs qui le reconnaît, et le même nom de service partout.
Signal d'alerteRenommer le service à la main dans l'interface, ou ajouter un tag différent par signal.
Question 3 · confirmé
Un monitor sur le taux d'erreur passe en alerte puis revient à la normale une quinzaine de fois chaque nuit. Comment le corrigez-vous ?
Une bonne réponseUne fenêtre d'évaluation plus longue, l'option qui attend une fenêtre complète de données, un seuil de rétablissement distinct du seuil d'alerte, et une condition de trafic minimum dans la formule pour qu'une erreur sur trois requêtes ne réveille personne. Un monitor par service (multi alert) plutôt qu'un monitor global. Pour un service à SLO, une alerte sur le rythme de consommation du budget d'erreur remplace avantageusement le seuil fixe.
Signal d'alerteMettre le monitor en sourdine, ou relever le seuil jusqu'à ce qu'il ne sonne plus jamais.
Question 4 · senior
Le volume de logs indexés dépasse le budget, mais la sécurité veut tout garder un an. Comment organisez-vous les logs dans Datadog ?
Une bonne réponsePlusieurs index selon l'usage, chacun avec sa rétention et un quota journalier avec seuil d'avertissement. Des filtres d'exclusion qui échantillonnent les logs sans valeur de diagnostic, par exemple les accès réussis, en gardant toutes les erreurs. Les logs exclus de l'index restent disponibles pour les métriques générées depuis les logs et partent dans les archives (S3, Azure Blob Storage ou Google Cloud Storage) gardées un an, avec réhydratation en cas de besoin. Flex Logs pour ceux qu'on garde longtemps et qu'on interroge rarement.
Signal d'alerteTout indexer un an en standard, ou couper les logs INFO dans l'agent sans archive.
Question 5 · confirmé
Dans l'APM, il manque des traces pour un endpoint peu appelé qui échoue une fois par jour. Pourquoi, et comment les retrouvez-vous ?
Une bonne réponseL'échantillonnage en tête : l'agent ajuste le taux des traceurs pour viser environ dix traces par seconde au total (DD_APM_TARGET_TPS), et un endpoint rare passe à travers. L'error sampler garde les traces en erreur jusqu'à un plafond par agent, le rare sampler, désactivé par défaut depuis la version 7.41, attrape les combinaisons peu fréquentes. La page de contrôle de l'ingestion montre les taux appliqués. Il faut aussi distinguer ingestion et indexation : une trace ingérée n'est gardée 15 jours que si un filtre de rétention la retient, l'intelligent retention filter en gardant un échantillon varié 30 jours.
Signal d'alertePasser l'échantillonnage à 100 % sur tous les services sans regarder le coût.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Questions fréquentes sur les profils Datadog
Ingénieur, consultant ou administrateur Datadog : est-ce le même poste ?
Les intitulés se recoupent. L'administrateur tient la plateforme au quotidien : agents, droits, intégrations, avec souvent une forte part de Linux. Le consultant cadre un déploiement, standardise les tableaux de bord et les monitors et accompagne les équipes applicatives. L'ingénieur observabilité fait les deux sur une plateforme interne. Dans tous les cas, la maîtrise des tags et de la facture compte, qui revient sur chaque mission.
Les certifications Datadog sont-elles un bon filtre ?
Datadog propose des certifications sur les fondamentaux de la plateforme, la gestion des logs et l'APM. Elles montrent que la personne connaît les écrans et les concepts. Elles ne disent rien de l'administration d'un compte en production, ni de la réduction d'une facture. Un compte qu'elle a géré parle davantage : nombre d'hôtes, règles de tags, monitors en code, et une dérive de coût qu'elle a corrigée.
Un expert Dynatrace ou Prometheus peut-il passer sur Datadog ?
Oui, la conception des alertes, l'instrumentation et le diagnostic se transposent. Les points à vérifier sont propres à Datadog : le comptage des custom metrics, l'indexation séparée de l'ingestion pour les logs et les spans, l'unified service tagging et le réglage de l'échantillonnage dans l'agent. Un profil Prometheus apprend vite la partie métriques. Un profil Dynatrace, habitué à une instrumentation très automatique, doit souvent progresser sur les tags.
Peut-on faire passer le test technique sur un vrai compte Datadog ?
Oui, s'il existe un compte de démonstration avec quelques données. La personne cherche pourquoi un monitor bascule sans cesse, corrige un pipeline de logs qui ne reconnaît pas le code HTTP, puis explique la page d'usage des custom metrics. Sans compte, des captures d'écran et un extrait de configuration Terraform suffisent. La même grille sert à tous les candidats, pour comparer les résultats.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.