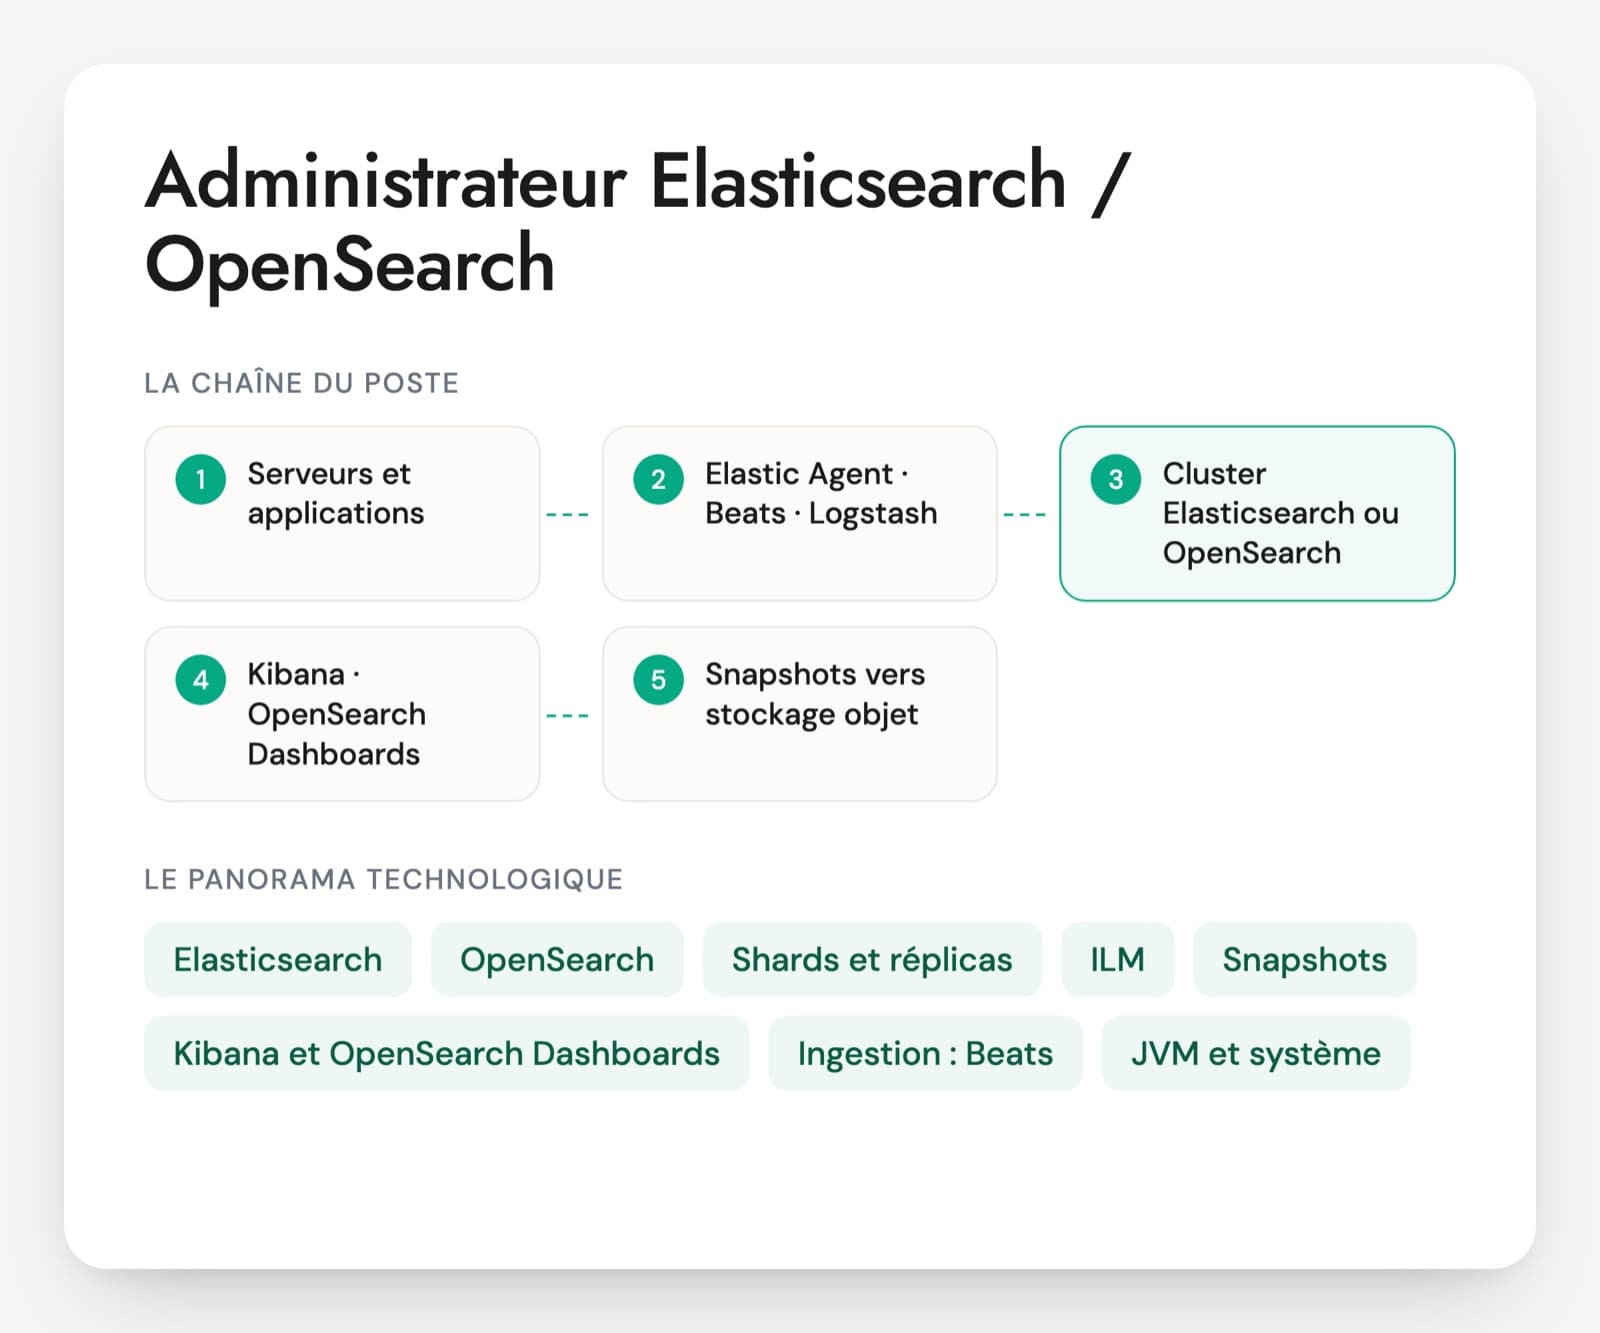
Un search engineer Elasticsearch ou OpenSearch fait en sorte que l'utilisateur trouve ce qu'il cherche, même quand sa requête est vague ou contient une faute. Le moteur peut servir la recherche d'un site, une base documentaire, un intranet, des petites annonces ou le catalogue d'un site e-commerce. Le travail reste le même : analyse du texte en français, synonymes, construction des requêtes, classement qui mêle pertinence textuelle et signaux métier, facettes, autocomplétion, mesure. On le trouve chez les éditeurs de logiciels, les sites à fort trafic et dans les ESN qui reprennent un moteur chez un client.
Les CV mêlent deux mondes. Beaucoup de profils Elasticsearch viennent des logs et de la stack ELK : ils savent faire tourner un cluster, moins expliquer pourquoi un document sort en vingtième position. D'autres ont intégré Algolia ou un moteur SaaS sans toucher à un analyseur. La pratique de la pertinence s'entend quand la personne parle de requêtes sans résultat, de listes de jugements, de NDCG ou de test A/B.
Demandez tôt au candidat comment il mesurait la pertinence sur son dernier moteur. Une réponse sans liste de requêtes ni indicateur suivi signale un profil plus proche de l'exploitation que de la recherche. Le PDF inclut aussi un cas sur la recherche d'un centre d'aide.
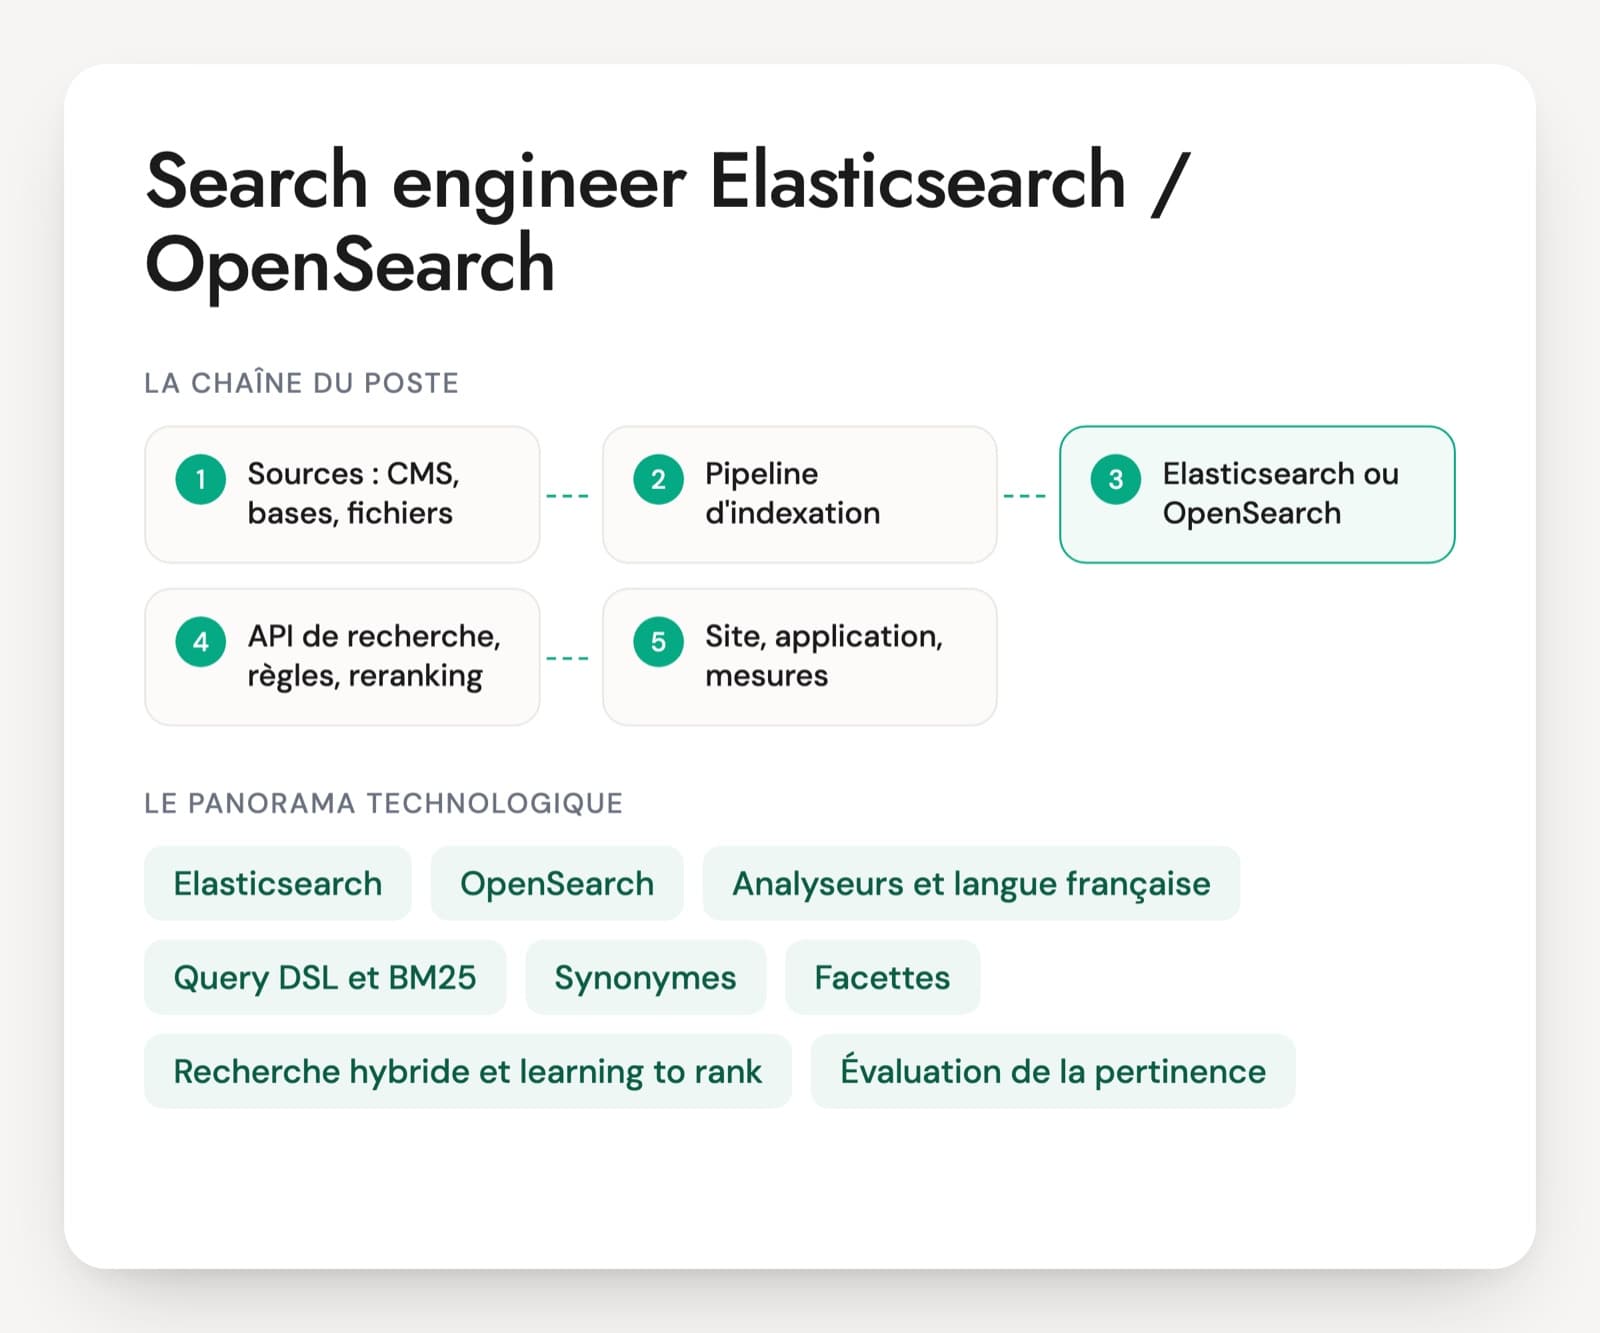
De l'analyseur au reranker, l'outillage d'un search engineer
Elasticsearch
Le moteur de recherche le plus répandu, édité par Elastic et aujourd'hui en version 9. Les contenus y sont indexés sous forme de documents JSON, et chaque recherche renvoie des résultats classés par score. Une partie des fonctions de pertinence avancées, comme le learning to rank, dépend du niveau d'abonnement, ce qui compte dans le choix des outils.
OpenSearch
Le fork open source d'Elasticsearch, lancé par AWS en 2021 et confié depuis à une fondation sous l'égide de la Linux Foundation. L'API de recherche reste proche, mais les deux produits ont divergé. OpenSearch a ses propres modules de pertinence : Search Relevance Workbench, plugin de learning to rank, collecte du comportement des utilisateurs avec UBI. Un profil passe de l'un à l'autre s'il connaît ces écarts.
Analyseurs et langue française
Avant d'être indexé, chaque texte passe par un analyseur qui le découpe en mots, le met en minuscules, retire les accents et ramène les mots à une racine commune, pour que « contrat » et « contrats » se rejoignent. En français, il faut aussi traiter l'élision (« l'assurance ») et protéger les codes et références du découpage. C'est là que naissent la plupart des requêtes sans résultat.
Query DSL et BM25
Le langage JSON des requêtes : requêtes bool avec clauses de score et filtres, multi_match sur plusieurs champs pondérés, requêtes de phrase. Le score par défaut, BM25, tient compte de la fréquence d'un mot, de sa rareté et de la longueur du champ. Un bon profil sait lire le détail d'un score avec l'API explain.
Synonymes
Une liste qui fait correspondre « RTT » et « réduction du temps de travail », ou « tv » et « téléviseur ». Appliqués au moment de la recherche avec le filtre synonym_graph, ils se mettent à jour sans réindexer, et Elasticsearch fournit une API pour les gérer. Une liste mal tenue fait remonter des résultats hors sujet : demandez qui la maintient et comment l'effet d'un ajout est vérifié.
Facettes, filtres et autocomplétion
Les filtres latéraux (type de document, auteur, date, catégorie) avec le nombre de résultats en face de chaque valeur, calculés par des agrégations. L'autocomplétion propose des suggestions dès les premières lettres, la recherche floue retrouve un mot mal tapé. Chaque approche a un coût en taille d'index et en latence.
Recherche hybride et learning to rank
La recherche vectorielle, fondée sur des embeddings, retrouve un document sans mot commun avec la requête, et se combine à la recherche lexicale par fusion RRF ou combinaison linéaire. Le learning to rank entraîne un modèle de classement, souvent avec XGBoost, sur des jugements ou des clics, puis l'applique en second passage. Sur un CV, vérifiez qu'il y a eu une mesure avant et après.
Évaluation de la pertinence
Des listes de jugements (des requêtes et les résultats notés bons ou mauvais), des métriques hors ligne comme le NDCG ou le MRR, puis des tests A/B sur le taux de clic, le taux de requêtes sans résultat et l'indicateur métier du site. Sans cet outillage, un réglage de pertinence se décide à l'impression.
Shards, réplicas et dimensionnement
Un index est découpé en shards répartis sur les nœuds, et chaque shard a des copies, les réplicas, qui servent aussi la lecture. Leur nombre et leur taille décident de la latence en période de pic. Un search engineer n'administre pas toujours le cluster, mais il doit savoir dimensionner un index de recherche à partir d'un test de charge.
Le poste change selon l'employeur. Chez un éditeur de logiciel ou un site à fort trafic, le search engineer suit les métriques de recherche dans la durée et travaille avec l'équipe produit. Sur une base documentaire ou un intranet, il gère des droits d'accès, plusieurs langues et des formats variés. En ESN ou en cabinet, il intervient sur une migration (depuis Solr, Exalead ou une ancienne version d'Elasticsearch), un audit de pertinence ou la reprise d'un moteur mal réglé. Certaines équipes ont choisi un moteur SaaS comme Algolia : la pratique de la pertinence se transpose, la connaissance d'Elasticsearch beaucoup moins. Les certifications Elastic portent sur le fonctionnement du moteur plus que sur la pertinence, qui se vérifie en entretien.
Les savoir-faire de pertinence à contrôler en entretien
- Analyse de texte et synonymes en français
- Query DSL et scoring BM25
- Recherche hybride et learning to rank
- Évaluation de la pertinence (NDCG, jugements, A/B)
- Facettes, filtres et autocomplétion
- Dimensionnement et performance du cluster de recherche
Cinq problèmes de pertinence à soumettre au search engineer
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Sur le moteur de recherche d'un site, 8 % des requêtes ne renvoient aucun résultat. Comment faites-vous baisser ce chiffre ?
Une bonne réponsePar les journaux de recherche : la liste des requêtes sans résultat, classées par fréquence. Il les range par cause (faute de frappe, synonyme manquant, terme absent de l'index, référence découpée par l'analyseur, filtre trop strict) et applique à chacune sa réponse : fuzziness, synonyme, correction orthographique, champ dédié aux codes et références, page de repli avec des suggestions. Il suit le taux après chaque changement et vérifie que la correction n'a pas fait remonter des résultats hors sujet.
Signal d'alerteActiver la recherche floue partout, ou ajouter des synonymes au fil de l'eau sans regarder les requêtes réelles. Une réponse qui ne mesure rien après coup.
Question 2 · confirmé
Dès qu'un utilisateur coche un auteur dans la facette, les autres auteurs disparaissent de la liste. Comment construisez-vous une facette à choix multiples ?
Une bonne réponseLes filtres choisis dans les facettes passent dans un post_filter, appliqué aux résultats après le calcul des agrégations, au lieu de la requête principale. Pour que chaque facette compte les documents en tenant compte des autres filtres sauf du sien, il ajoute des agrégations filtrées facette par facette. Il sait aussi que les comptes d'une agrégation terms sont approximatifs quand l'index a plusieurs shards, et règle size en conséquence.
Signal d'alerteMettre tous les filtres dans la requête, puis reconstruire la liste des auteurs côté front à partir de la première page de résultats.
Question 3 · senior
L'équipe produit veut faire remonter les documents récents et les plus consultés, sans qu'une page populaire mais hors sujet passe en tête. Comment intégrez-vous ces signaux au classement ?
Une bonne réponseLa pertinence textuelle reste le filtre d'entrée : seuls les documents qui correspondent à la requête sont classés. Les signaux s'ajoutent avec un poids limité, par function_score (une décroissance gauss sur la date, field_value_factor avec un modificateur log sur la popularité) ou par rank_feature. Les mises en avant ponctuelles passent par des règles attachées à une requête plutôt que par un boost global. Il vérifie l'effet sur une liste de jugements avant de livrer, puis par un test A/B.
Signal d'alerteMultiplier le score par le nombre de vues sans plafond, ce qui écrase la pertinence. Ou changer les poids en production à la demande, sans mesure.
Question 4 · confirmé
Avant de modifier le classement, comment savez-vous si la nouvelle version est meilleure que l'ancienne ?
Une bonne réponseIl procède en deux temps. Hors ligne, une liste de jugements : quelques centaines de requêtes représentatives, des plus fréquentes aux plus rares, avec des résultats notés par des personnes ou déduits des clics. Il compare le NDCG ou le MRR des deux versions, ce que permettent l'API rank_eval d'Elasticsearch ou le Search Relevance Workbench d'OpenSearch. En ligne, un test A/B sur le taux de clic, le taux de requêtes sans résultat, le taux de reformulation et l'indicateur métier du site, avec une durée fixée à l'avance.
Signal d'alerte« On regarde quelques requêtes et on voit bien que c'est mieux », ou un test A/B arrêté dès que la courbe paraît favorable.
Question 5 · senior
Un index de 30 millions de documents doit répondre en moins de 200 ms au 99e percentile, avec des pics de trafic. Comment dimensionnez-vous shards, réplicas et nœuds ?
Une bonne réponseIl part d'une mesure, pas d'une règle : un test de charge sur un nœud avec des requêtes réelles, pour connaître le débit d'un shard à la latence visée. Les shards restent dans la fourchette conseillée par Elastic (de 10 à 50 Go), en nombre suffisant pour paralléliser sans multiplier le travail de fusion. Les réplicas servent la lecture et la tolérance aux pannes : on en ajoute pour absorber les pics. Il garde assez de mémoire pour le cache du système de fichiers, sépare si besoin les nœuds de recherche de l'indexation et surveille les files d'attente de recherche.
Signal d'alerteUn shard par nœud « par principe », ou cinquante shards de quelques centaines de mégaoctets chacun. Aucune mesure avant de commander des machines.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Profil search engineer : les points à éclaircir avant l'embauche
Quelle différence entre un administrateur Elasticsearch et un search engineer ?
L'administrateur fait tourner le cluster : shards, mémoire, sauvegardes, montées de version. Le search engineer travaille sur ce que voit l'utilisateur : analyseurs, synonymes, scoring, facettes, mesure de la pertinence. Les deux savoirs se recoupent, mais un très bon profil ELK issu des logs n'a pas forcément réglé un classement. Sur un CV, cherchez le vocabulaire de la pertinence (jugements, NDCG, A/B test, requêtes sans résultat) plutôt que la seule mention d'Elasticsearch.
Un profil Algolia peut-il reprendre un moteur Elasticsearch ?
Une partie des réflexes se transpose : synonymes, règles par requête, tolérance aux fautes, lecture des statistiques de recherche. Algolia prend pourtant en charge beaucoup de choses à la place de l'équipe, comme l'analyse du texte, le classement par critères successifs et l'hébergement. Sur Elasticsearch ou OpenSearch, il faut écrire les analyseurs, composer les requêtes et dimensionner le cluster. Interrogez la personne sur l'analyse du français et sur function_score pour situer l'écart.
Quel test technique proposer à un search engineer ?
Un exercice court pendant l'entretien fonctionne bien : un mapping et une requête qui donnent de mauvais résultats sur une poignée de recherches réelles, à corriger en commentant à voix haute. Vous voyez si la personne commence par regarder les tokens et le détail du score, ou si elle ajoute des boosts au hasard. Un exercice à la maison sur un petit jeu de documents public reste possible, à condition de demander aussi comment le résultat serait mesuré.
Faut-il exiger le learning to rank et la recherche vectorielle ?
Pas pour tous les postes. Sur un index de taille moyenne, un moteur lexical bien réglé, avec de bons synonymes et une mesure sérieuse, couvre déjà la plupart des besoins. Le learning to rank suppose assez de trafic pour apprendre et une équipe capable d'entretenir un modèle. La recherche hybride aide surtout sur les requêtes formulées en langage courant. Si le poste les demande, vérifiez que la personne a mesuré le gain obtenu après la mise en place.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.