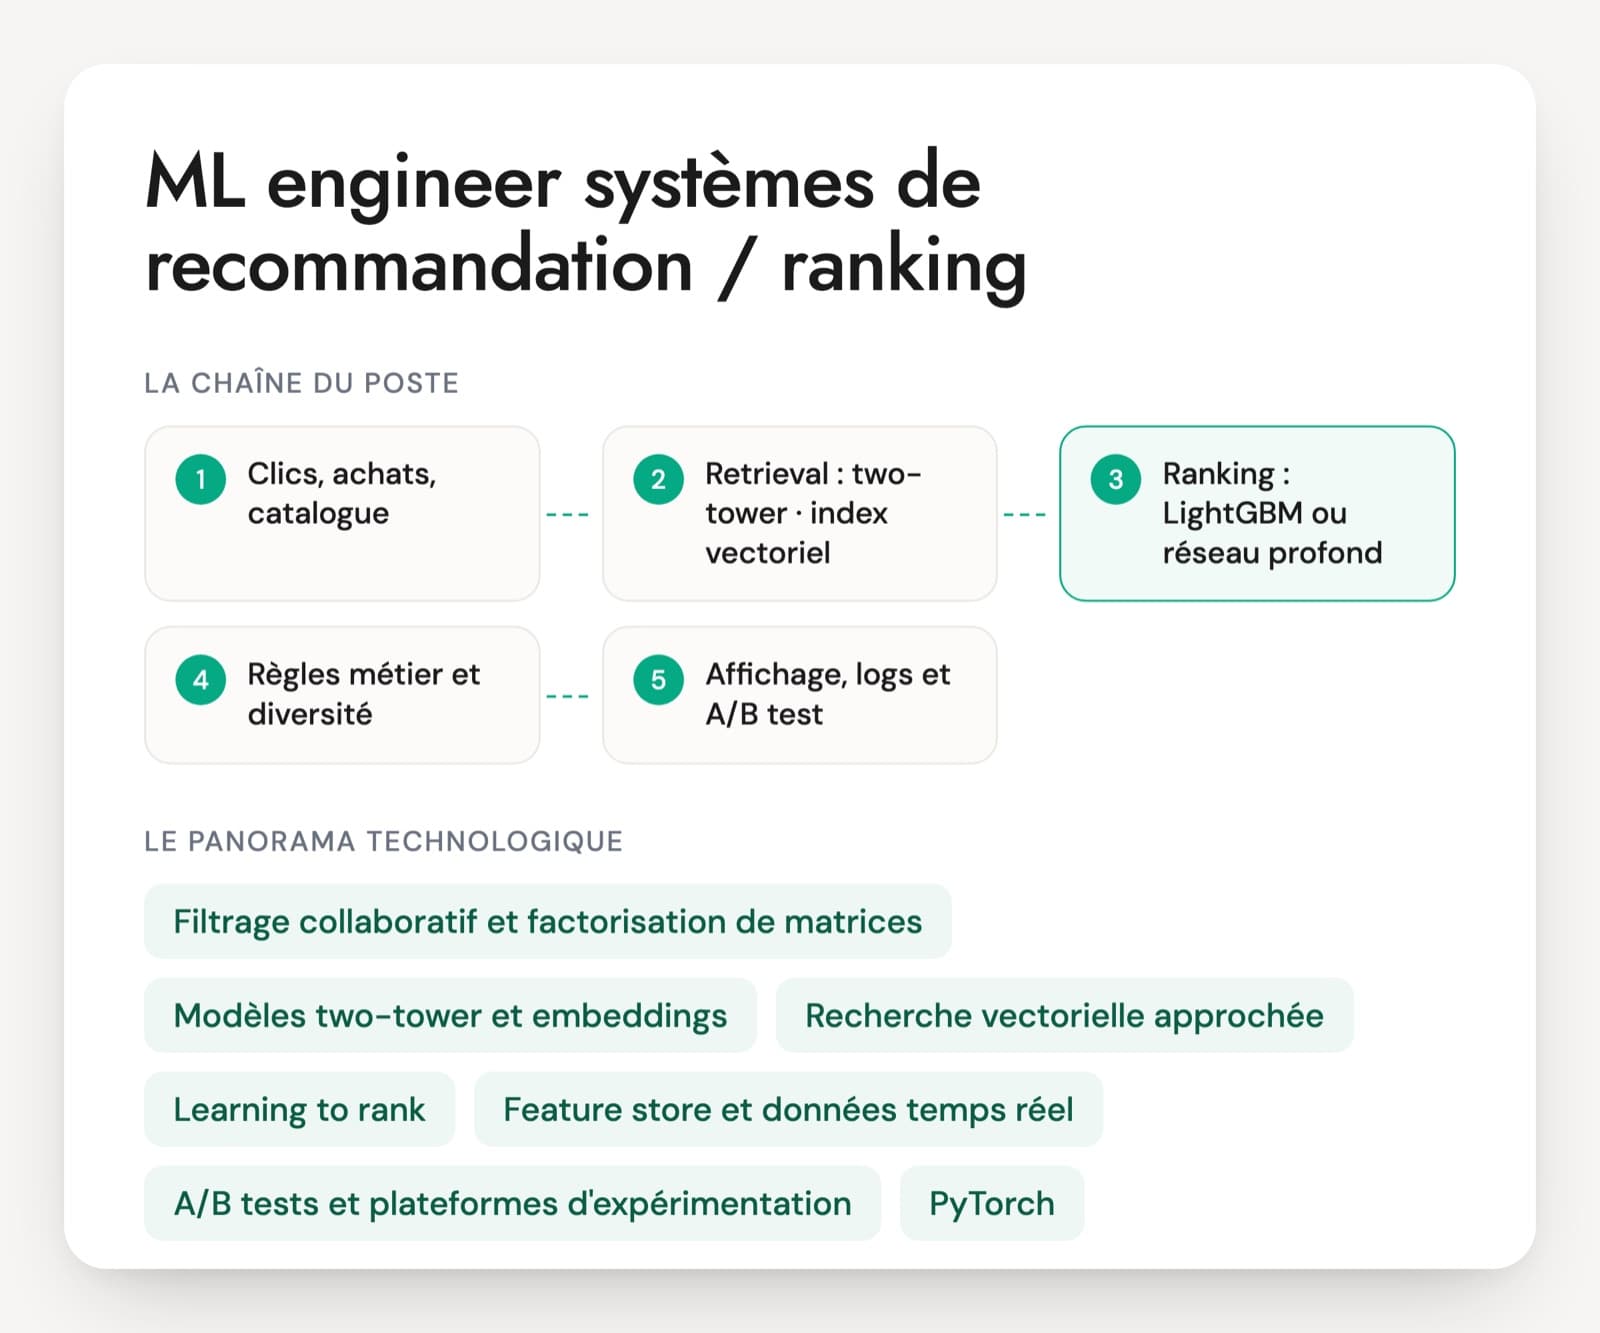
Un système de recommandation tient en deux étages. Le premier, le retrieval, réduit un catalogue qui peut compter des millions d'éléments à quelques centaines de candidats. Le second, le ranking, les classe pour un utilisateur précis. Entre les deux s'ajoutent des règles métier : stock, diversité, contenus interdits. Le ML engineer recommandation entraîne ces modèles, les sert avec une latence très faible et mesure leur effet réel par des A/B tests. On le recrute dans l'e-commerce, le streaming, les médias, les places de marché et les sites d'emploi.
Sur le papier, beaucoup de data scientists ont « fait de la reco ». En pratique, l'écart se voit vite entre quelqu'un qui a entraîné une factorisation de matrices dans un notebook et quelqu'un qui a vécu le décalage entre métriques hors ligne et résultats en ligne, le biais des clics sur les premières positions ou la boucle qui pousse toujours les mêmes produits.
Avec un senior, faites raconter un A/B test qui a contredit les métriques hors ligne, et la décision prise ensuite. Un junior peut ne jamais avoir mis de modèle en production, mais il doit savoir pourquoi un bon rappel à 10 ne garantit rien en ligne. En pièce jointe, un cas sur le fil d'accueil d'une plateforme de vidéo à la demande.
Comment se construit un moteur de recommandation
Filtrage collaboratif et factorisation de matrices
L'approche historique : recommander à un utilisateur ce qu'ont aimé des utilisateurs qui lui ressemblent. La factorisation de matrices (ALS, par exemple) apprend un vecteur par utilisateur et par article à partir des clics ou des achats. Elle reste une bonne base de comparaison, et un candidat sérieux sait en expliquer les limites face aux nouveaux articles.
Modèles two-tower et embeddings
Deux réseaux de neurones, l'un pour l'utilisateur, l'autre pour l'article, produisent des vecteurs comparables. C'est l'architecture la plus répandue pour l'étage de retrieval, parce que les vecteurs des articles se calculent à l'avance. Le choix des exemples négatifs pendant l'entraînement fait une grosse partie de la qualité.
Recherche vectorielle approchée
Pour trouver en quelques millisecondes les articles les plus proches d'un vecteur parmi des millions, on utilise des index approchés : FAISS, ScaNN, HNSW, ou une base vectorielle comme Qdrant, Milvus ou les fonctions vectorielles d'Elasticsearch et d'OpenSearch. L'index échange un peu de rappel contre beaucoup de vitesse, et ce réglage se discute en entretien.
Learning to rank
Les modèles qui classent les candidats retenus. Les arbres de gradient boosting comme LightGBM ou XGBoost, avec un objectif de type LambdaMART, restent très utilisés ; les réseaux profonds prennent le relais à grande échelle. Un bon profil connaît les approches par point, par paire et par liste, et sait pourquoi l'ordre compte plus que le score.
Feature store et données temps réel
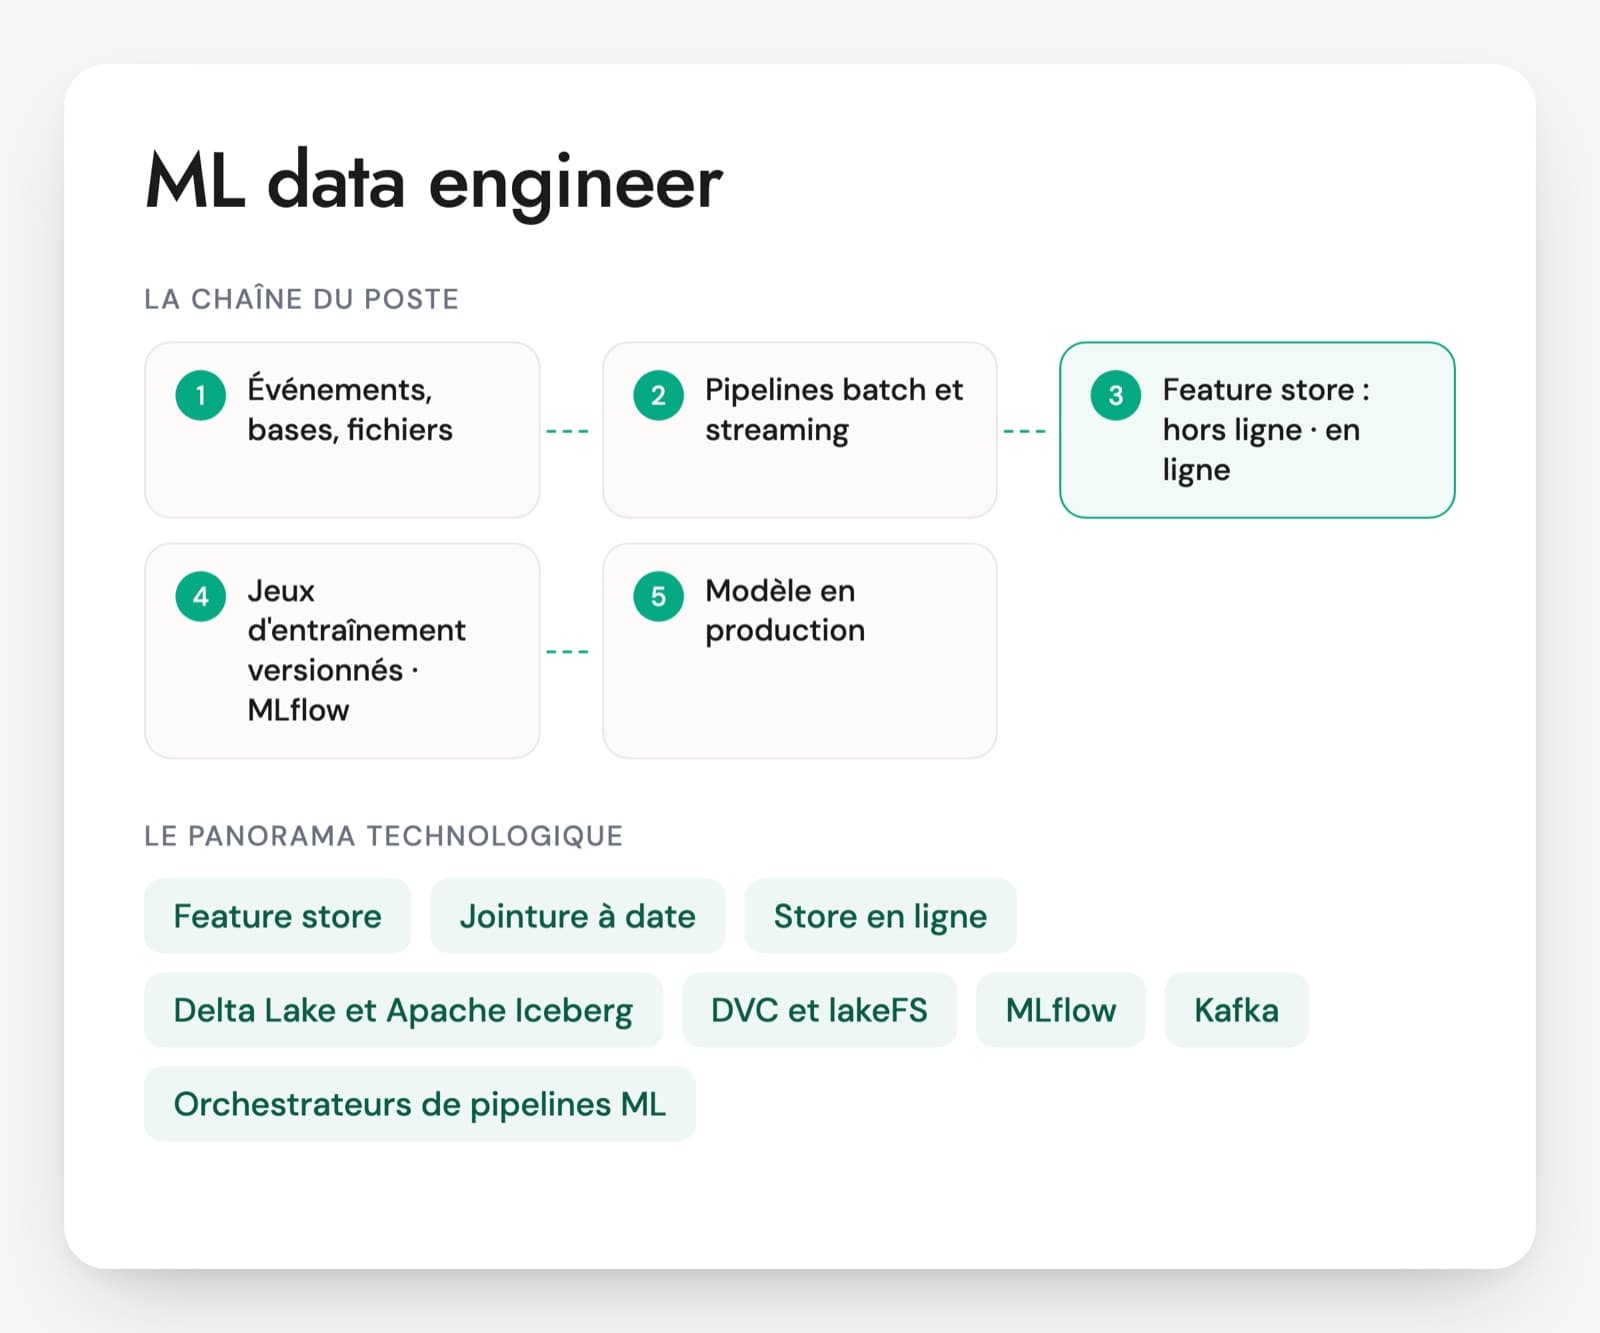
Les caractéristiques de l'utilisateur et de l'article (derniers clics, prix, popularité du jour) doivent être identiques à l'entraînement et au moment de servir. Un feature store comme Feast, adossé à Redis ou à une base clé-valeur, et un flux d'événements Kafka assurent cette cohérence. Les écarts entre les deux sont une cause fréquente de modèles qui déçoivent en production.
A/B tests et plateformes d'expérimentation
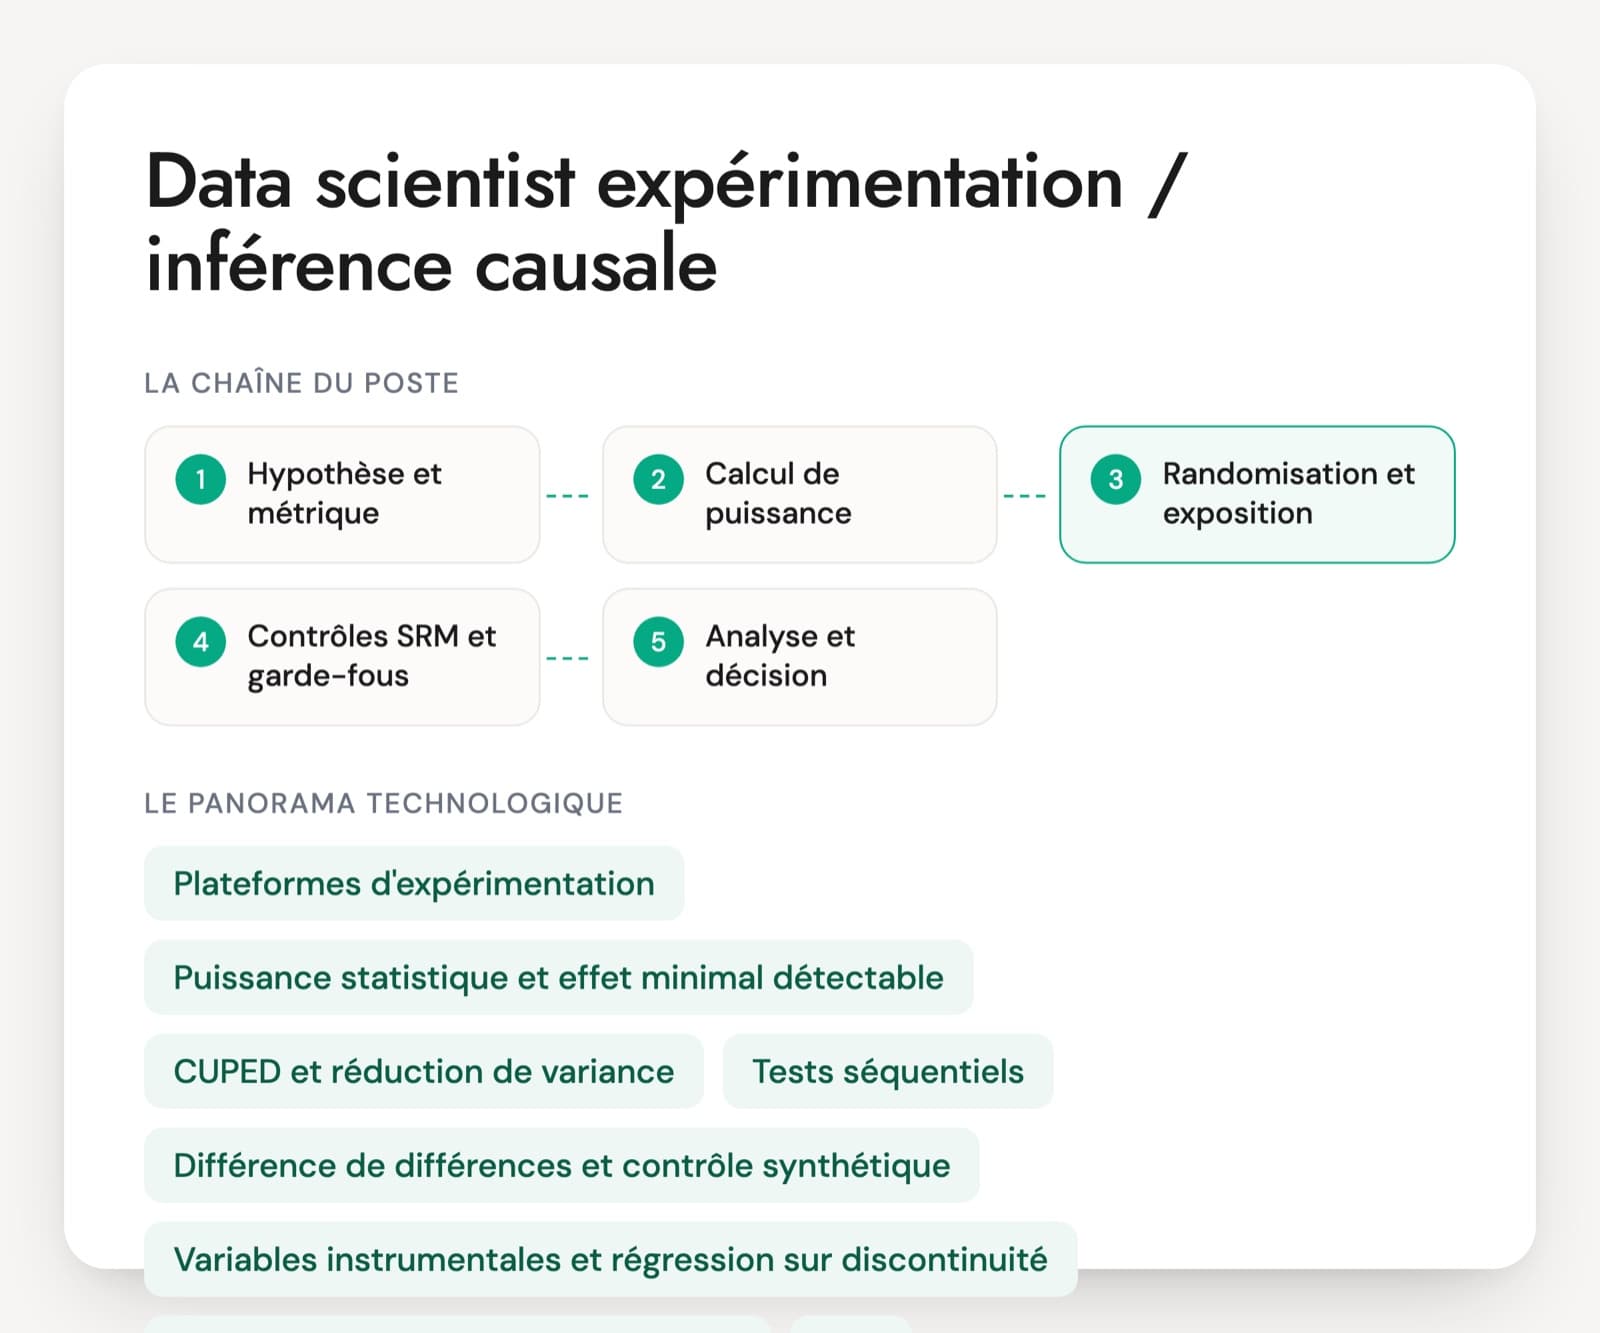
Ce qui tranche, c'est l'effet mesuré sur les utilisateurs réels (clics, achats, temps passé, désabonnements). Les équipes utilisent une plateforme interne ou un outil comme GrowthBook. Le ML engineer recommandation doit savoir choisir la métrique principale, les métriques de garde et la durée d'un test.
PyTorch, TorchRec et l'outillage d'entraînement
Les modèles profonds de recommandation s'entraînent le plus souvent avec PyTorch ; TorchRec gère les très grandes tables d'embeddings réparties sur plusieurs GPU. Côté données, Spark ou BigQuery préparent les historiques d'interactions, qui peuvent atteindre des milliards de lignes.
Le poste n'a pas le même périmètre partout. Dans une grande plateforme, l'équipe est découpée : certains travaillent sur le retrieval, d'autres sur le ranking ou sur l'infrastructure d'expérimentation. Dans une entreprise de taille moyenne, une seule personne porte souvent toute la chaîne, des données d'interaction jusqu'à l'API. Les titres varient : ML engineer, data scientist search et recommandation, ingénieur ranking, ingénieur pertinence. La frontière avec la recherche (moteur de recherche interne, résultats de requête) est fine, et beaucoup d'offres mêlent les deux. Cherchez dans le parcours un système servi à de vrais utilisateurs et au moins un A/B test mené jusqu'à la décision.
Les compétences qui font un bon ML engineer recommandation
- Architecture retrieval et ranking
- Modèles et données d'interaction
- Évaluation hors ligne
- A/B tests et mesure en ligne
- Serving faible latence et production
- Démarrage à froid, boucles de rétroaction et règles métier
Questions de retrieval et de ranking pour un ML engineer recommandation
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Votre catalogue compte deux millions de produits et la page doit afficher ses recommandations en moins de 50 ms. Comment organisez-vous le calcul ?
Une bonne réponseDeux étages. Un retrieval rapide, par exemple un modèle two-tower dont les vecteurs d'articles sont précalculés et rangés dans un index approché, plus quelques sources simples (populaires, déjà vus, similaires), ramène quelques centaines de candidats. Un modèle de ranking plus riche les classe avec des caractéristiques temps réel. Des règles métier filtrent ensuite le stock et assurent la diversité. La personne répartit le budget de latence entre les étapes.
Signal d'alerteCalculer un score pour chacun des deux millions de produits à chaque affichage, ou tout précalculer la nuit sans tenir compte de ce que l'utilisateur vient de faire.
Question 2 · senior
Votre nouveau modèle gagne 8 % de NDCG hors ligne, mais l'A/B test ne montre aucun effet sur les achats. Quelles pistes examinez-vous ?
Une bonne réponseLe jeu hors ligne vient des logs de l'ancien modèle et ne contient que ce qu'il a montré, donc il favorise ce qui lui ressemble. Il peut aussi y avoir un écart entre caractéristiques d'entraînement et de production, une métrique hors ligne mal alignée avec l'achat, un test trop court ou sans assez de puissance, un effet dilué parce que la zone de recommandation est peu vue. La personne vérifie d'abord que le test lui-même est sain (répartition des groupes, logs) avant de conclure.
Signal d'alerte« Le test s'est mal passé, on le relance » sans hypothèse, ou conclure que le NDCG prouve que le modèle est meilleur.
Question 3 · confirmé
Comment découpez-vous un historique de clics pour évaluer un modèle de recommandation hors ligne ?
Une bonne réponseUn découpage dans le temps : on entraîne sur les interactions avant une date et on évalue sur celles d'après, ce qui reproduit la situation réelle. Les caractéristiques sont calculées avec ce qui était connu à chaque date. La personne cite les métriques (rappel à k pour le retrieval, NDCG pour le ranking) et compare toujours à des bases simples comme les articles populaires.
Signal d'alerteUn découpage aléatoire des clics, qui laisse le modèle voir le futur, ou une évaluation sans comparaison à la popularité.
Question 4 · junior à confirmé
Un utilisateur arrive pour la première fois, sans aucun historique. Que lui recommandez-vous, et comment ?
Une bonne réponseDes éléments populaires, filtrés par le contexte disponible : pays, appareil, page d'arrivée, source de trafic, heure. Puis une adaptation rapide dès les premiers clics de la session, avec un modèle séquentiel ou des similarités entre articles. Un questionnaire d'accueil quand le produit le permet. Pour un nouvel article, la réponse symétrique utilise ses caractéristiques de contenu.
Signal d'alerte« On ne lui recommande rien », ou appliquer tel quel un modèle de filtrage collaboratif qui n'a aucun vecteur pour cet utilisateur.
Question 5 · senior
Les utilisateurs cliquent surtout sur les premiers résultats affichés. Quel problème cela pose-t-il pour entraîner votre modèle de ranking ?
Une bonne réponseUn clic en première position ne veut pas dire la même chose qu'un clic en dixième : le modèle apprend en partie l'ordre de l'ancien système. On corrige avec la position comme caractéristique à l'entraînement, fixée à une valeur neutre au moment de servir, ou avec une pondération par la probabilité d'être vu (inverse propensity). Un peu d'exploration, comme de petites permutations aléatoires, aide à estimer ce biais.
Signal d'alerteTraiter tous les clics comme équivalents, quelle que soit leur position, et les non-clics comme des rejets certains.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Les passerelles vers un poste de recommandation
Quel intitulé chercher pour construire un moteur de recommandation ?
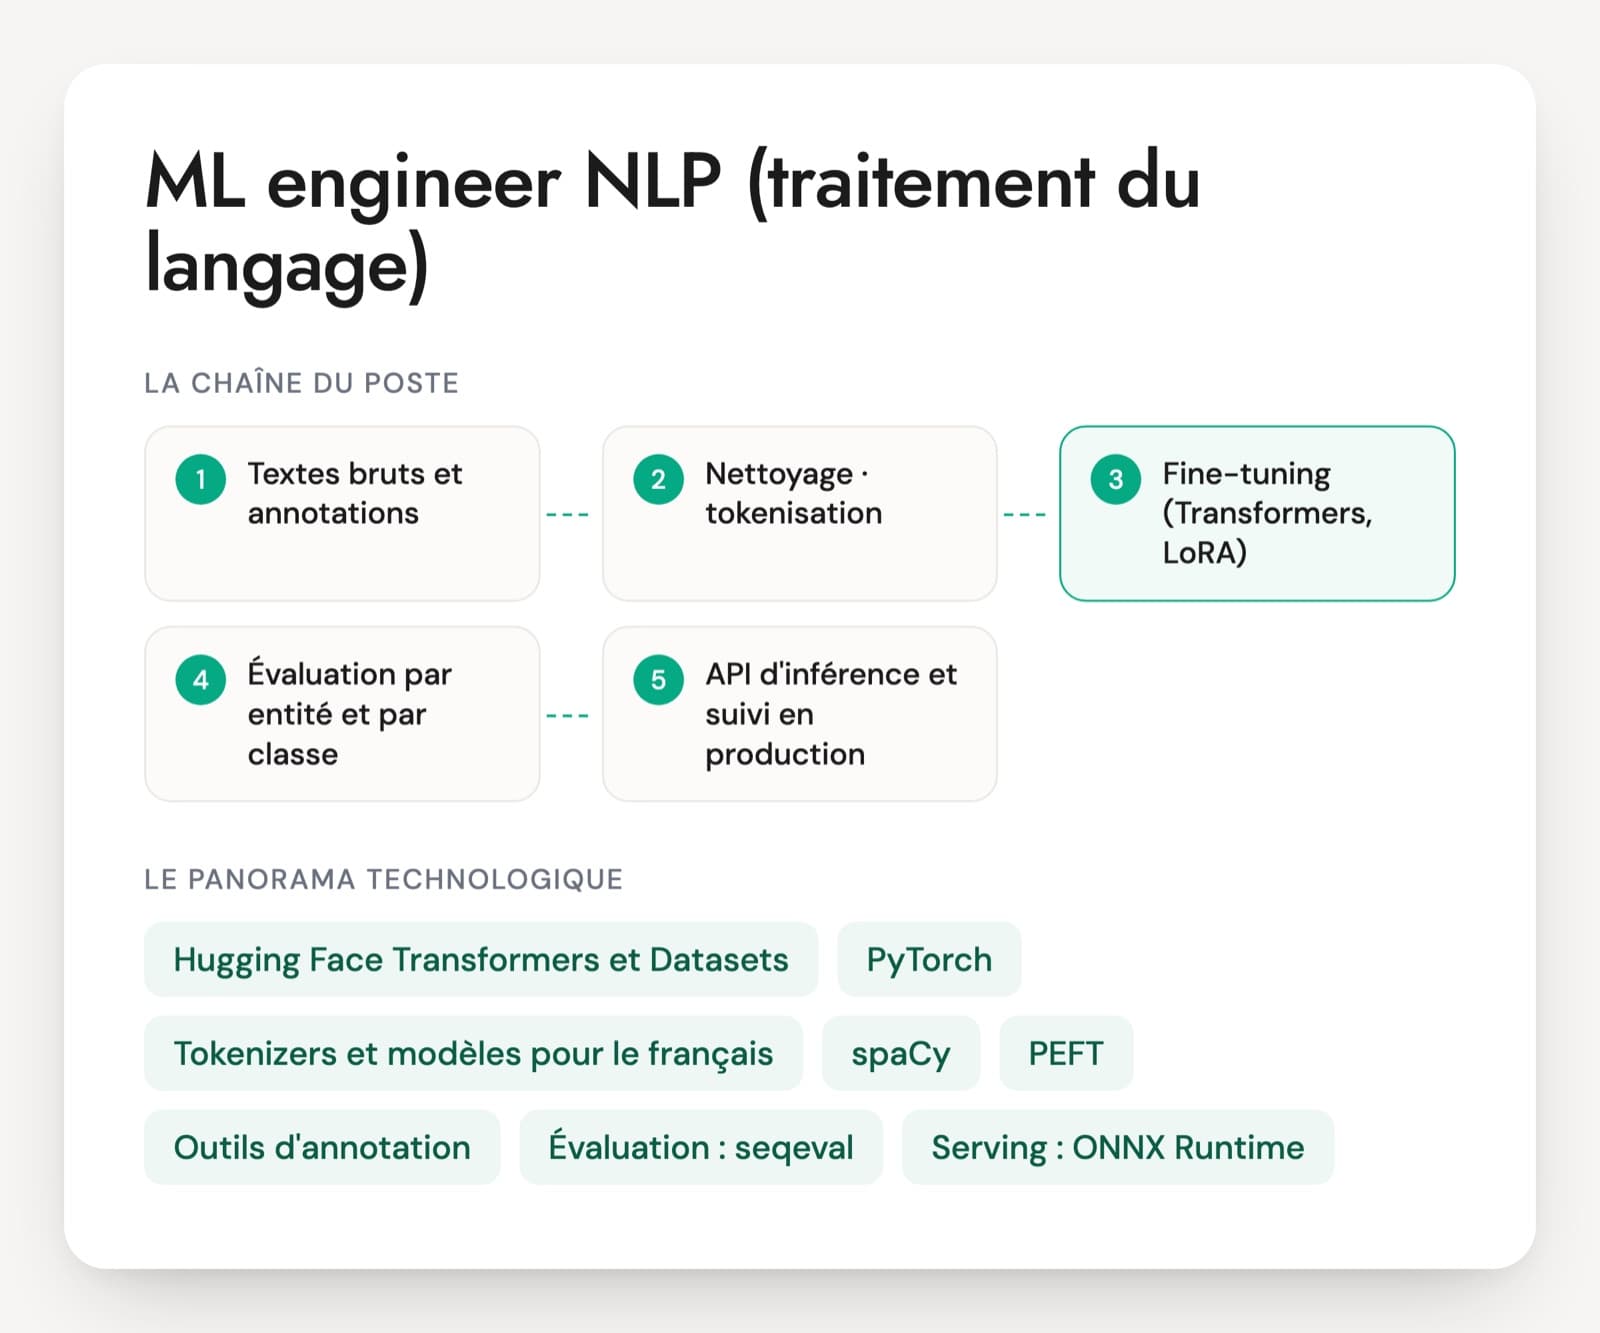
Data scientist et ML engineer désignent souvent le même travail. La différence tient au poids de la production. Si vous avez déjà des données propres et cherchez surtout à améliorer la pertinence, un data scientist expérimenté en ranking peut convenir. S'il faut servir les recommandations en temps réel, maintenir un index vectoriel et brancher une plateforme d'A/B test, cherchez un ML engineer. Dans les deux cas, demandez un système réellement servi à des utilisateurs.
Quels signes d'expérience réelle chercher sur un CV en recommandation ?
Des chiffres de volume (taille du catalogue, nombre d'utilisateurs, latence), un A/B test cité avec sa métrique principale, et un problème vécu : démarrage à froid, biais de position, écart entre hors ligne et en ligne. Un CV qui liste ALS, two-tower et NDCG sans contexte reste à vérifier. Un projet académique sur MovieLens montre la culture du sujet ; l'expérience de production se vérifie à part.
Que mettre dans le test technique d'un ML engineer recommandation ?
Une étude de conception d'une heure en direct fonctionne bien : un catalogue, un trafic, une contrainte de latence, et la personne dessine la chaîne du retrieval à l'A/B test. Vous pouvez y ajouter un court exercice sur un extrait de logs, par exemple découper les données sans fuite et calculer un rappel à 10. Évitez le long projet à rendre, qui mesure surtout le temps libre du candidat.
Un ingénieur en moteur de recherche peut-il passer sur la recommandation ?
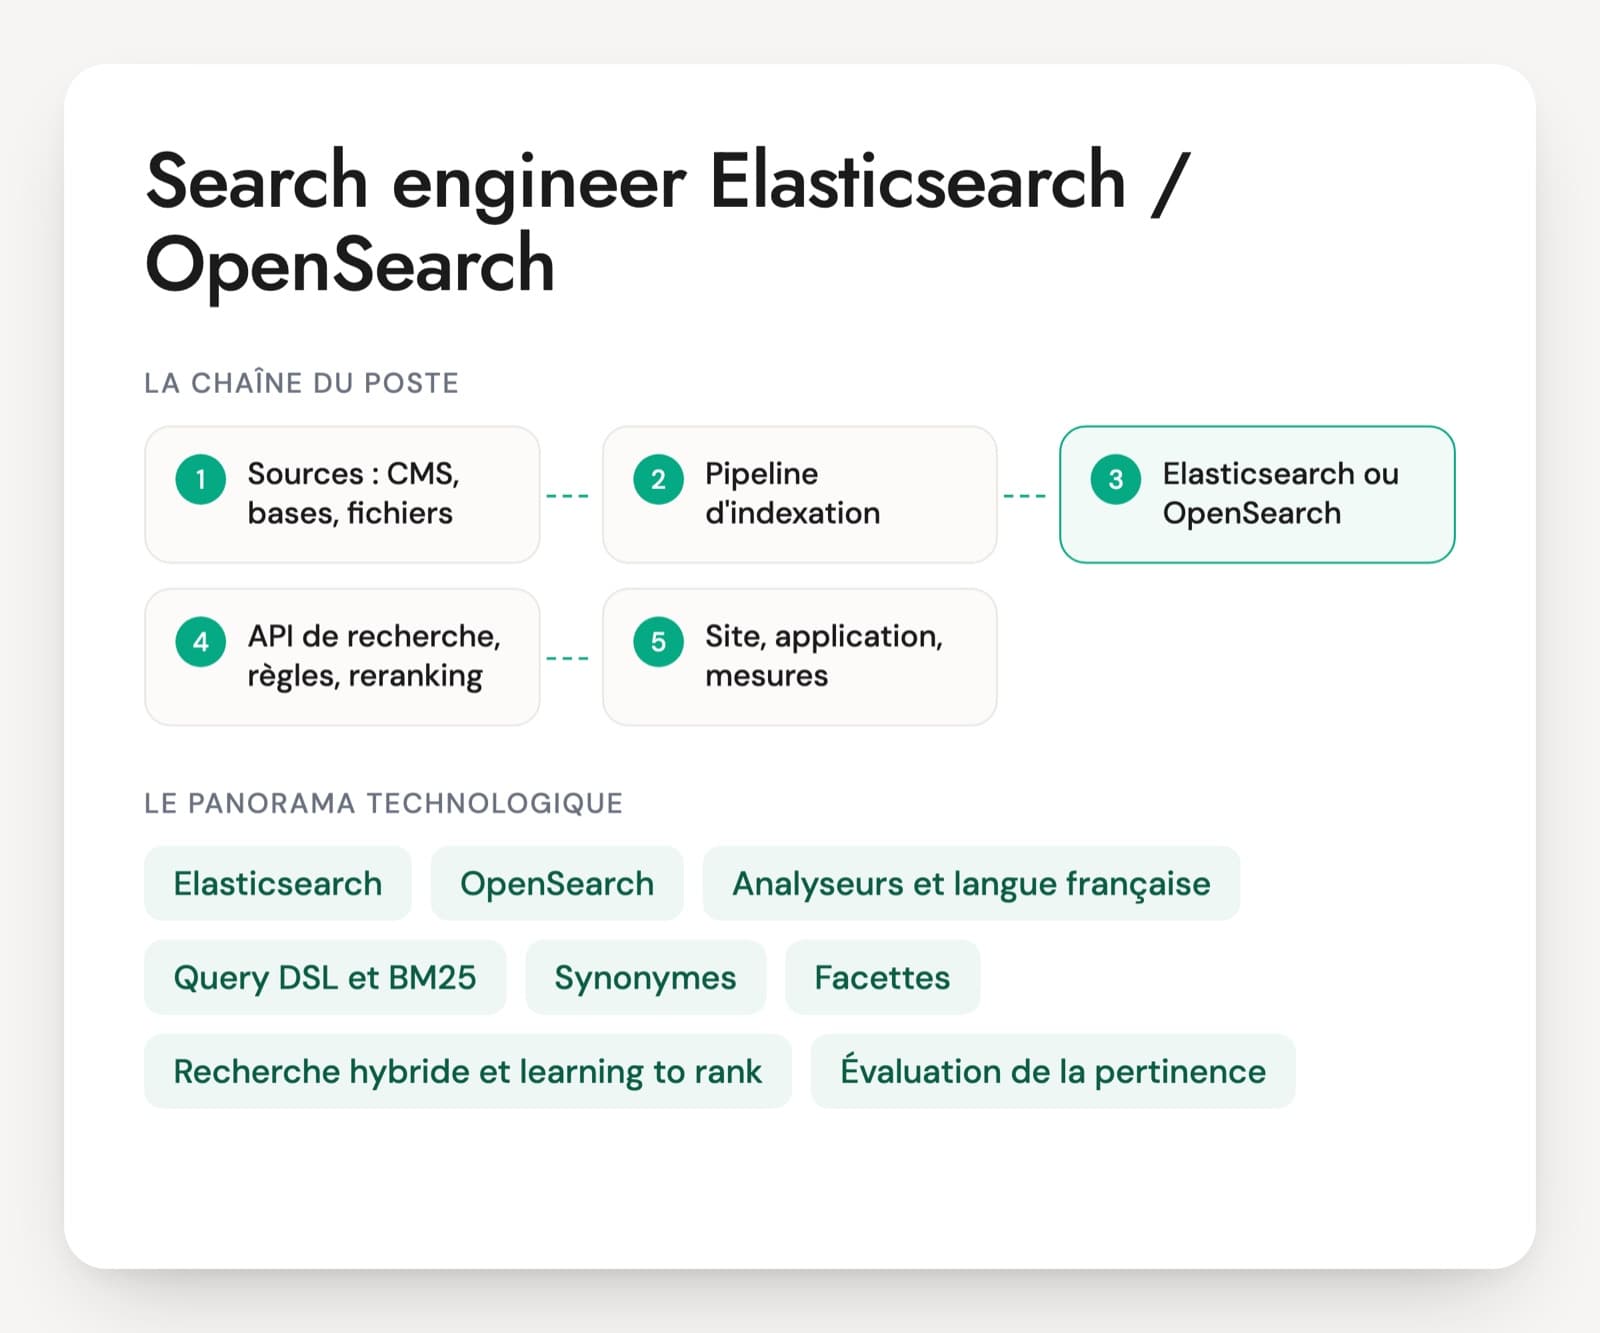
Souvent, oui. La recherche et la recommandation partagent le ranking, les embeddings, les index vectoriels et l'évaluation par NDCG. La recherche part d'une requête explicite, la recommandation doit déduire l'intention à partir de l'historique, ce qui rend le démarrage à froid et les boucles de rétroaction plus présents. Vérifiez en entretien ces deux points et l'habitude des A/B tests.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.