Vous recrutez quelqu'un qui saura brancher un LLM sur les documents de l'entreprise : contrats, procédures, documentation technique, pages SharePoint. Le travail consiste à extraire le texte proprement, à découper et indexer les contenus, à régler la recherche, puis à mesurer si les réponses citent la bonne source. Ces questions d'entretien RAG servent aux ESN qui placent ce profil chez des grands comptes, comme aux clients finaux et aux éditeurs qui le recrutent en direct, souvent dans le juridique, l'assurance, l'industrie ou le public.
Sur un CV, un RAG de démonstration et un RAG en production se ressemblent. LangChain et une base vectorielle y figurent dans les deux cas. L'écart se voit sur les sujets que les tutoriels évitent : un tableau mal extrait, un recall mesuré sur un jeu de questions, des droits d'accès qui suivent chaque passage, un document à effacer au titre du RGPD.
Dès le premier entretien, les questions sur l'évaluation et sur les droits d'accès suffisent souvent à trier les profils. Le PDF va plus loin avec 30 questions sur six axes, un cas de 20 minutes sur un assistant documentaire RH et une grille de 1 à 4.
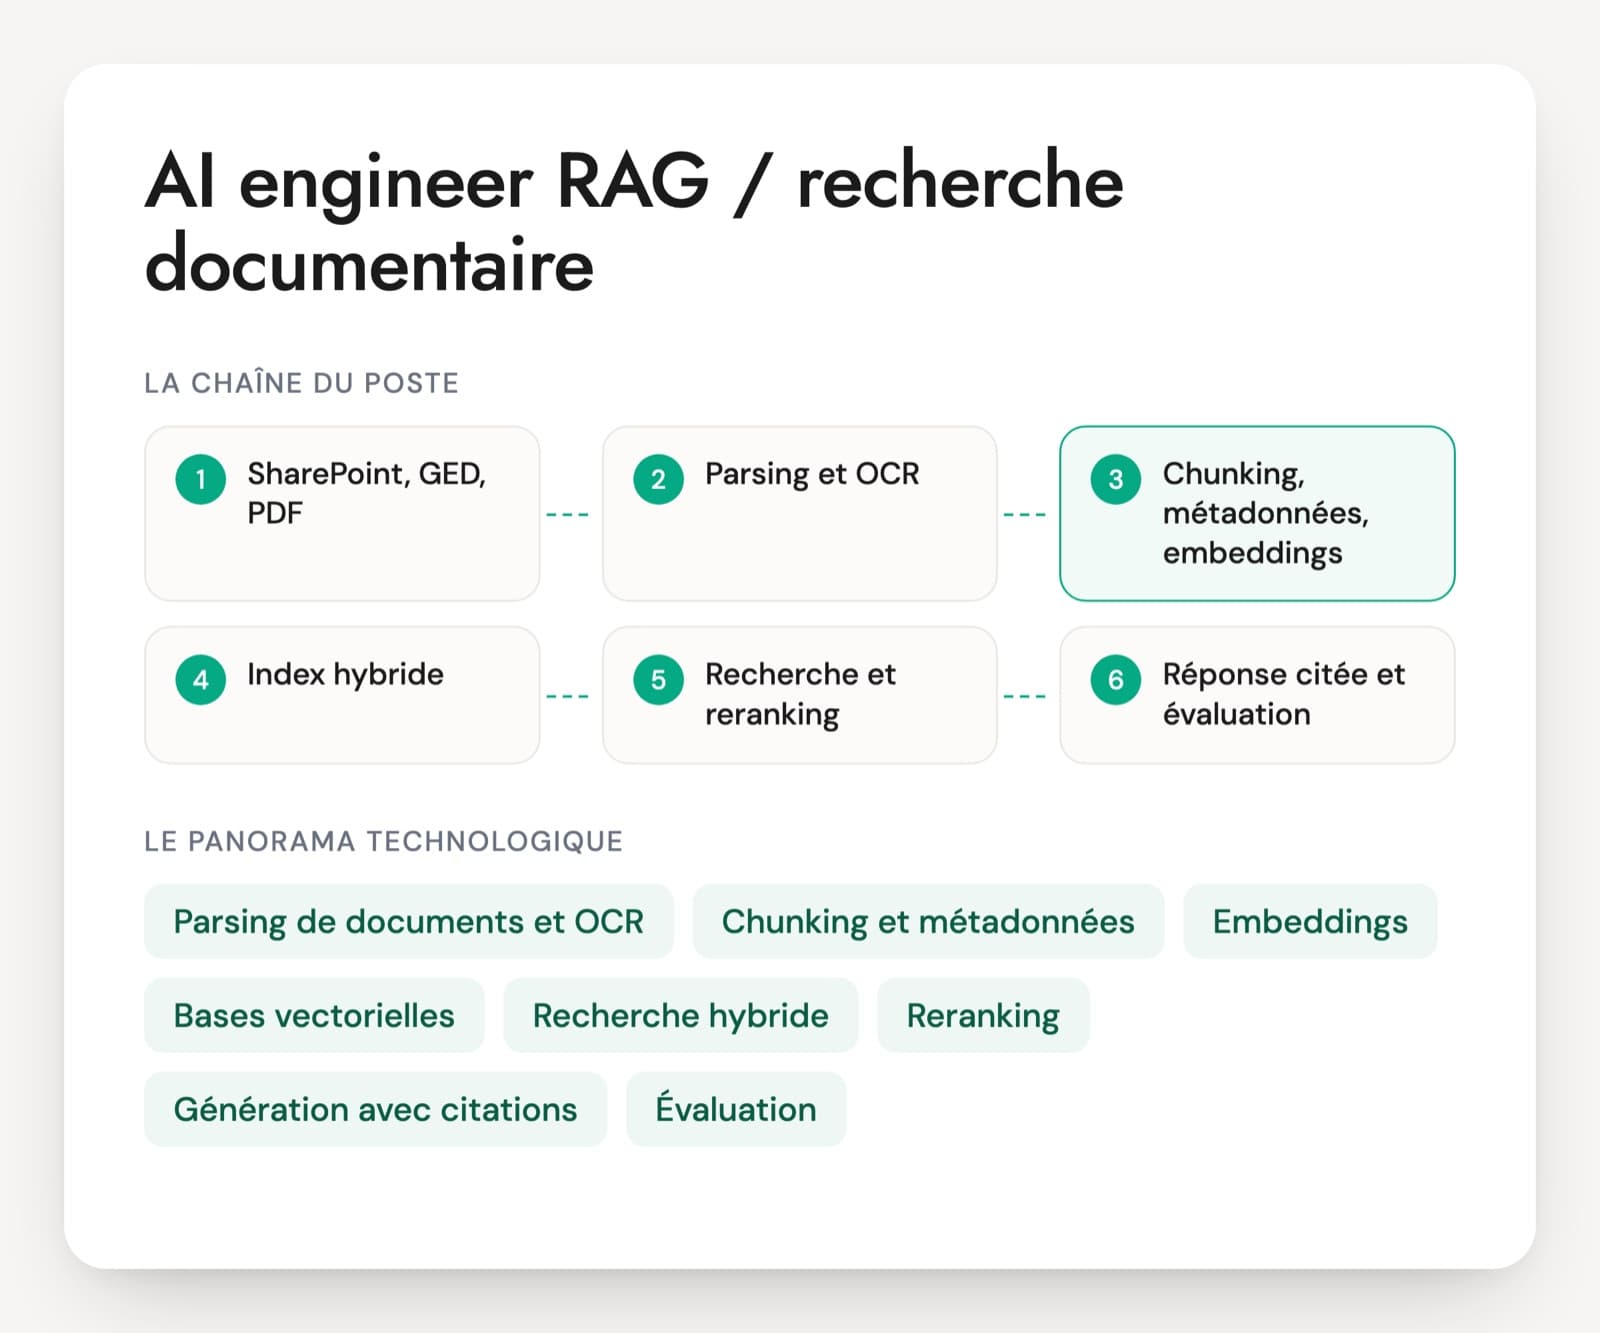
De l'OCR au reranking, la chaîne technique d'un RAG
Parsing de documents et OCR
C'est l'extraction du texte des documents sources. Un PDF natif contient du texte, alors qu'un PDF scanné n'est qu'une image et passe par l'OCR, la reconnaissance de caractères. Les tableaux, les colonnes et les en-têtes posent le plus de problèmes, et une extraction ratée donne des réponses fausses. Demandez comment la qualité de l'extraction est contrôlée avant l'indexation.
Chunking et métadonnées
Les documents sont découpés en passages, les chunks, que le moteur retrouvera ensuite. Trop courts, ils perdent leur contexte. Trop longs, ils diluent l'information utile. Chaque passage porte des métadonnées (source, page, date, version, droits d'accès) qui servent à citer la source et à filtrer selon les droits.
Embeddings
Un modèle d'embedding transforme un texte en vecteur, une liste de nombres qui représente son sens. Deux textes de sens proche ont des vecteurs proches, même sans mot commun. Le choix du modèle dépend de sa qualité en français, de la longueur de texte acceptée et de son hébergement. En changer oblige à recalculer tout l'index.
Bases vectorielles
pgvector (une extension de PostgreSQL), Qdrant, Azure AI Search, Elasticsearch ou OpenSearch stockent les vecteurs et retrouvent les plus proches d'une question. La recherche y est approximative, très rapide, et sa précision se règle. Le nom de la base sur le CV pèse moins que la capacité à expliquer ces réglages et les filtres par métadonnées.
Recherche hybride
On combine une recherche par mots-clés, avec l'algorithme BM25 des moteurs classiques, et une recherche par vecteurs, puis on fusionne les deux listes. Le vectoriel retrouve les reformulations. Les mots-clés retrouvent les références exactes, les noms propres et les numéros de contrat. Un RAG sérieux part aujourd'hui de cette combinaison.
Reranking
Une deuxième passe relit les premiers résultats et les reclasse avec un modèle plus précis, souvent un cross-encoder qui lit la question et le passage ensemble. L'ordre des résultats s'améliore nettement, pour un peu de latence en plus. Un candidat expérimenté sait sur combien de passages il l'applique et pourquoi.
Génération avec citations
Le LLM reçoit la question et les passages retrouvés, puis rédige une réponse qui cite ses sources. Le RAG réduit les hallucinations sans les supprimer, et le modèle peut encore inventer ou mal citer. Un bon profil sait faire répondre « je ne sais pas » et vérifie par le code que chaque citation existe.
Évaluation (recall@k, RAGAS, LLM-as-judge)
La qualité se mesure en deux temps. La récupération d'abord, avec le recall@k, la part des questions dont le bon passage figure dans les k premiers résultats. La réponse ensuite, sa fidélité aux sources et sa pertinence, que RAGAS ou un LLM juge notent en partie automatiquement. Sans jeu de test, personne ne peut dire si une modification améliore le système.
Droits d'accès et données sensibles
Un RAG mal conçu peut montrer à un salarié un document qu'il n'a pas le droit de lire. Les droits de la source (groupes SharePoint, GED) doivent suivre chaque passage et filtrer la recherche selon l'utilisateur. Il faut aussi traiter le RGPD, avec la minimisation et le droit à l'effacement, et choisir l'hébergement du modèle quand les documents sont sensibles.
Le poste varie selon l'employeur. En ESN ou en cabinet, l'AI engineer RAG enchaîne les assistants documentaires chez des grands comptes, souvent sur le cloud imposé par le client, avec un premier résultat mesurable à livrer vite. Chez un client final, il vit avec son index sur la durée : documents mis à jour, droits qui évoluent, questions qui changent. Chez un éditeur ou dans une start-up, le RAG est un produit vendu à plusieurs clients et l'isolation des données entre clients passe au premier plan. Le juridique, l'assurance, l'industrie et le public reviennent souvent, avec des exigences fortes sur l'hébergement des données. Une certification IA d'un fournisseur cloud atteste la connaissance de ses services, sans rien dire de la capacité à évaluer et fiabiliser un RAG.
Ce que l'entretien d'un ingénieur RAG doit couvrir
- Parsing et ingestion de documents
- Chunking et embeddings
- Recherche hybride et reranking
- Réponses citées et hallucinations
- Évaluation de la récupération
- Droits d'accès et données sensibles
En entretien, cinq questions sur un projet RAG
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Un utilisateur tape « avenant 2024-117 » et l'assistant ne remonte rien. Le document est pourtant indexé. D'où vient le problème et que corrigez-vous ?
Une bonne réponseLa recherche vectorielle retrouve le sens, et un numéro d'avenant n'en a pas. Le candidat ajoute une recherche par mots-clés (BM25) en parallèle, fusionne les deux listes et vérifie que le champ indexé découpe correctement ce type de référence. Extraire le numéro en métadonnée pour filtrer dessus est un plus.
Signal d'alerteAugmenter le nombre de résultats ou passer à un modèle d'embedding plus gros, sans voir que le problème vient de la correspondance exacte.
Question 2 · junior à confirmé
On vous confie des contrats scannés avec des grilles tarifaires sur deux colonnes. Comment extrayez-vous le texte pour que les montants restent justes ?
Une bonne réponseIl distingue PDF natif et PDF scanné, passe les scans par l'OCR, puis utilise un outil d'analyse de mise en page qui respecte l'ordre de lecture et reconstruit les tableaux avec leurs en-têtes, en Markdown ou en HTML. Un échantillon est vérifié à la main avant l'indexation et le numéro de page est conservé pour la citation.
Signal d'alerteUne extraction brute de tout le texte en supposant que ça marche. Les erreurs sont découvertes par les utilisateurs.
Question 3 · confirmé
Vous avez changé la taille des chunks. Comment me prouvez-vous que le RAG est meilleur qu'avant ?
Une bonne réponseUn jeu de test de questions réelles, chacune annotée avec le ou les passages attendus. Il mesure d'abord la récupération (recall@k, rang du bon passage), puis la qualité des réponses (fidélité aux sources, pertinence), avant et après, sur le même jeu. Si un LLM sert de juge, ses notes ont été comparées à des notes humaines.
Signal d'alerte« J'ai posé quelques questions et les réponses m'ont paru meilleures. »
Question 4 · confirmé
Un stagiaire RH interroge l'assistant et récupère un extrait de la grille de rémunération de la direction. Où est l'erreur, et comment l'évitez-vous ?
Une bonne réponseLes droits du document source n'ont pas suivi les passages. À l'ingestion, chaque chunk reçoit en métadonnées les groupes autorisés. À la requête, la recherche filtre selon l'identité de l'utilisateur, avant que le texte n'arrive au modèle. Une bonne réponse prévoit aussi la synchronisation quand les droits changent et des tests avec des comptes de profils différents.
Signal d'alerte« J'ajoute dans le prompt de ne pas divulguer d'informations confidentielles. » À ce stade, le texte a déjà été envoyé au modèle.
Question 5 · confirmé
L'assistant décrit avec aplomb une procédure qui n'existe dans aucun document. Comment réduisez-vous ce risque ?
Une bonne réponseUne consigne qui limite la réponse aux extraits fournis et demande de dire « je ne sais pas » sinon. Des citations par passage, vérifiées par le code. Un seuil de pertinence en dessous duquel l'assistant ne répond pas. Une mesure de fidélité aux sources sur le jeu de test pour suivre le taux de réponses inventées.
Signal d'alerte« Le RAG supprime les hallucinations » ou « un modèle récent n'invente plus ».
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Les doutes fréquents avant de recruter un ingénieur RAG
Quel socle technique attendre d'un AI engineer RAG ?
Python et l'usage des API de LLM forment la base. Viennent ensuite l'ingestion de documents (parsing, OCR, tableaux), le découpage et les embeddings, la recherche hybride avec reranking, puis l'évaluation sur un jeu de test. En entreprise, la gestion des droits d'accès et le RGPD comptent autant que la technique. Les offres françaises insistent aussi sur l'industrialisation, avec le déploiement, la supervision et la CI/CD. Un projet utilisé par de vrais utilisateurs dit plus qu'une liste de frameworks.
Un data scientist peut-il tenir un poste d'AI engineer RAG ?
Parfois, mais le métier diffère. Un data scientist entraîne et évalue des modèles sur des données, avec une forte part de statistique. L'AI engineer RAG entraîne rarement un modèle. Il assemble un système autour d'un LLM existant : ingestion des documents, index, recherche, génération, évaluation, droits d'accès. Son profil se rapproche du développeur backend ou du data engineer, avec une bonne culture de la recherche d'information. Certains data scientists ont changé de voie, d'où l'intérêt de vérifier une expérience en production.
Comment tester un ingénieur RAG sans lui faire monter un projet complet ?
Monter un RAG complet en test technique à la maison prend des heures et se compare mal d'un candidat à l'autre. Une mise en situation pendant l'entretien est souvent plus parlante. Décrivez un corpus réel, avec ses PDF scannés, ses droits et ses utilisateurs, puis demandez comment il s'y prendrait et comment il mesurerait le résultat. La fiche PDF de Delectus en propose une de 20 minutes autour d'un assistant documentaire RH, avec sa grille de notation.
RAG ou fine-tuning : que doit savoir trancher un AI engineer ?
Le RAG convient quand la réponse dépend de documents qui changent ou qui sont soumis à des droits : on met à jour l'index, pas le modèle. Le fine-tuning sert à fixer un format, un ton ou un vocabulaire métier, rarement à apprendre des faits. Un bon candidat parle du coût, de la fraîcheur des données et de la citation des sources. Méfiez-vous de celui qui propose un fine-tuning pour corriger une recherche qui ramène les mauvais passages.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.