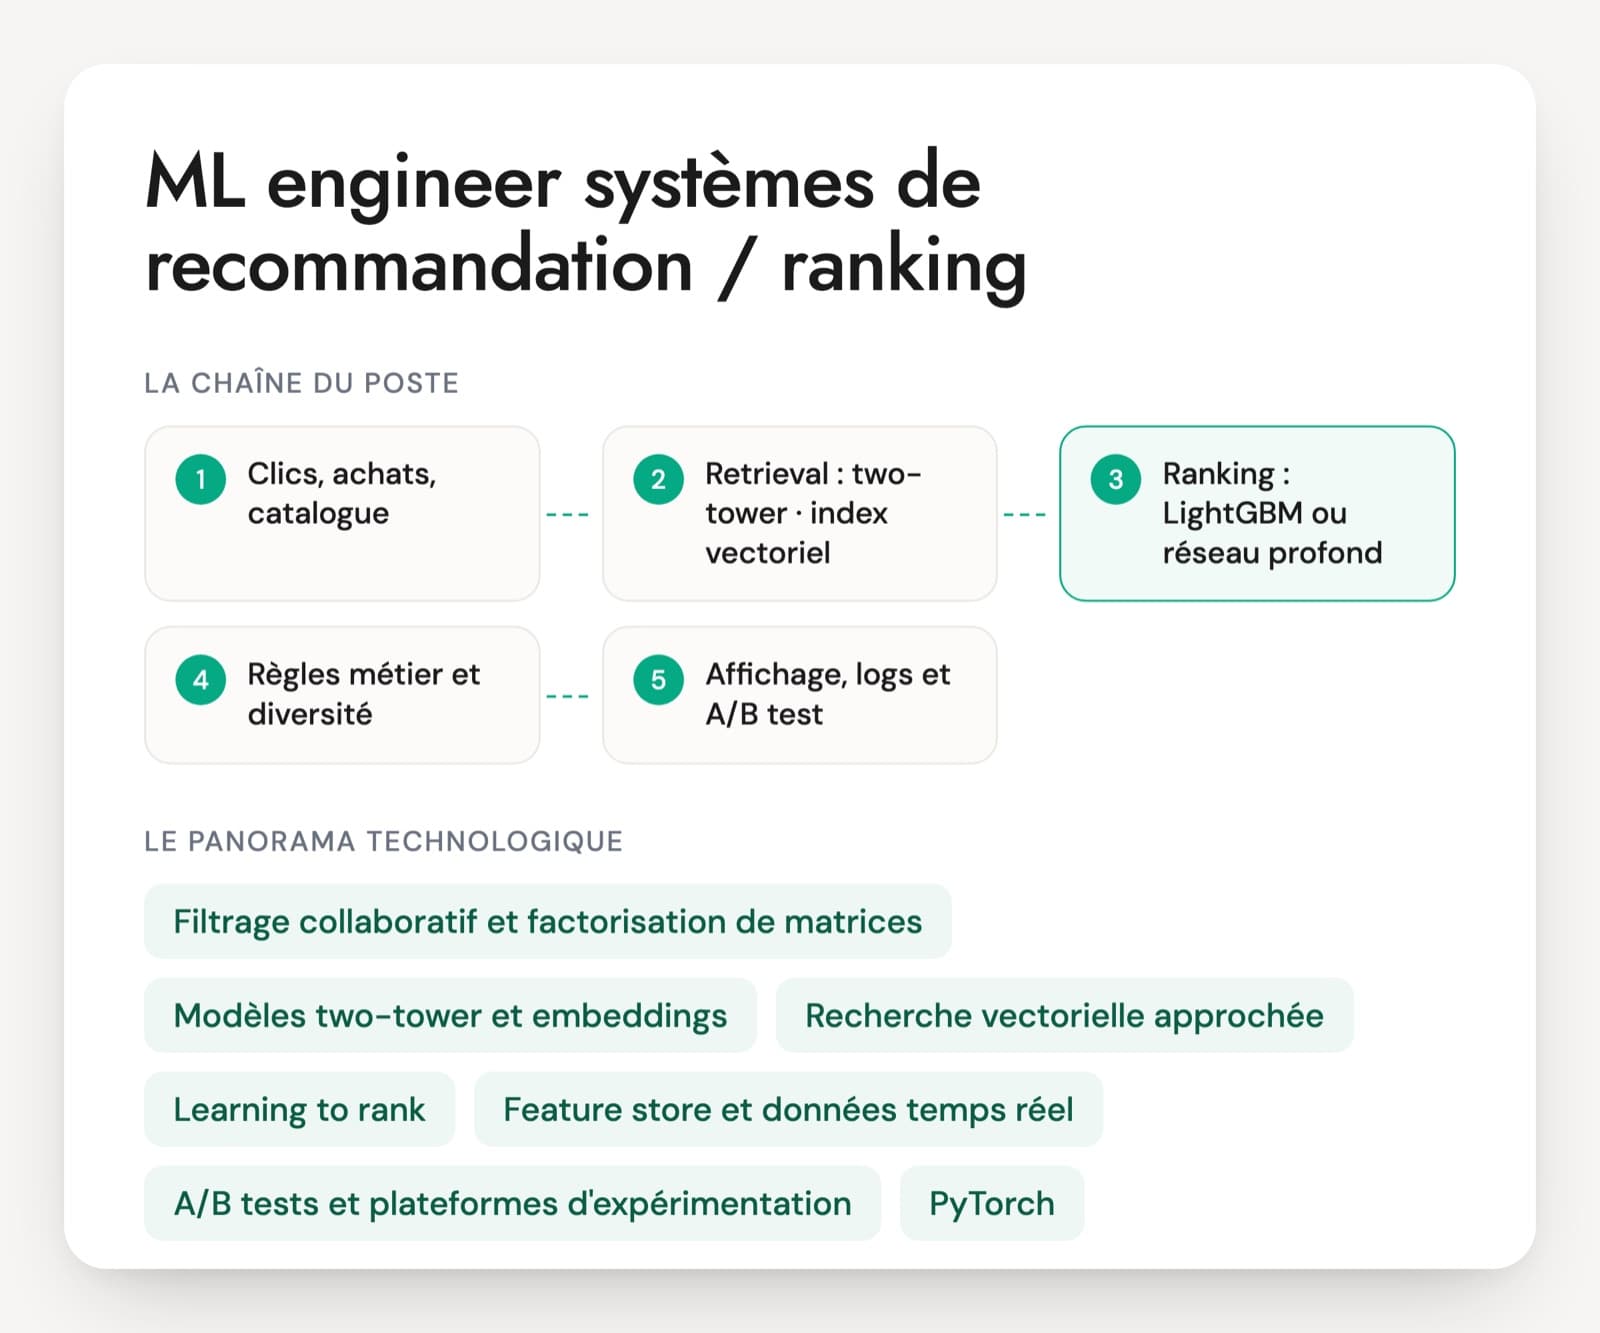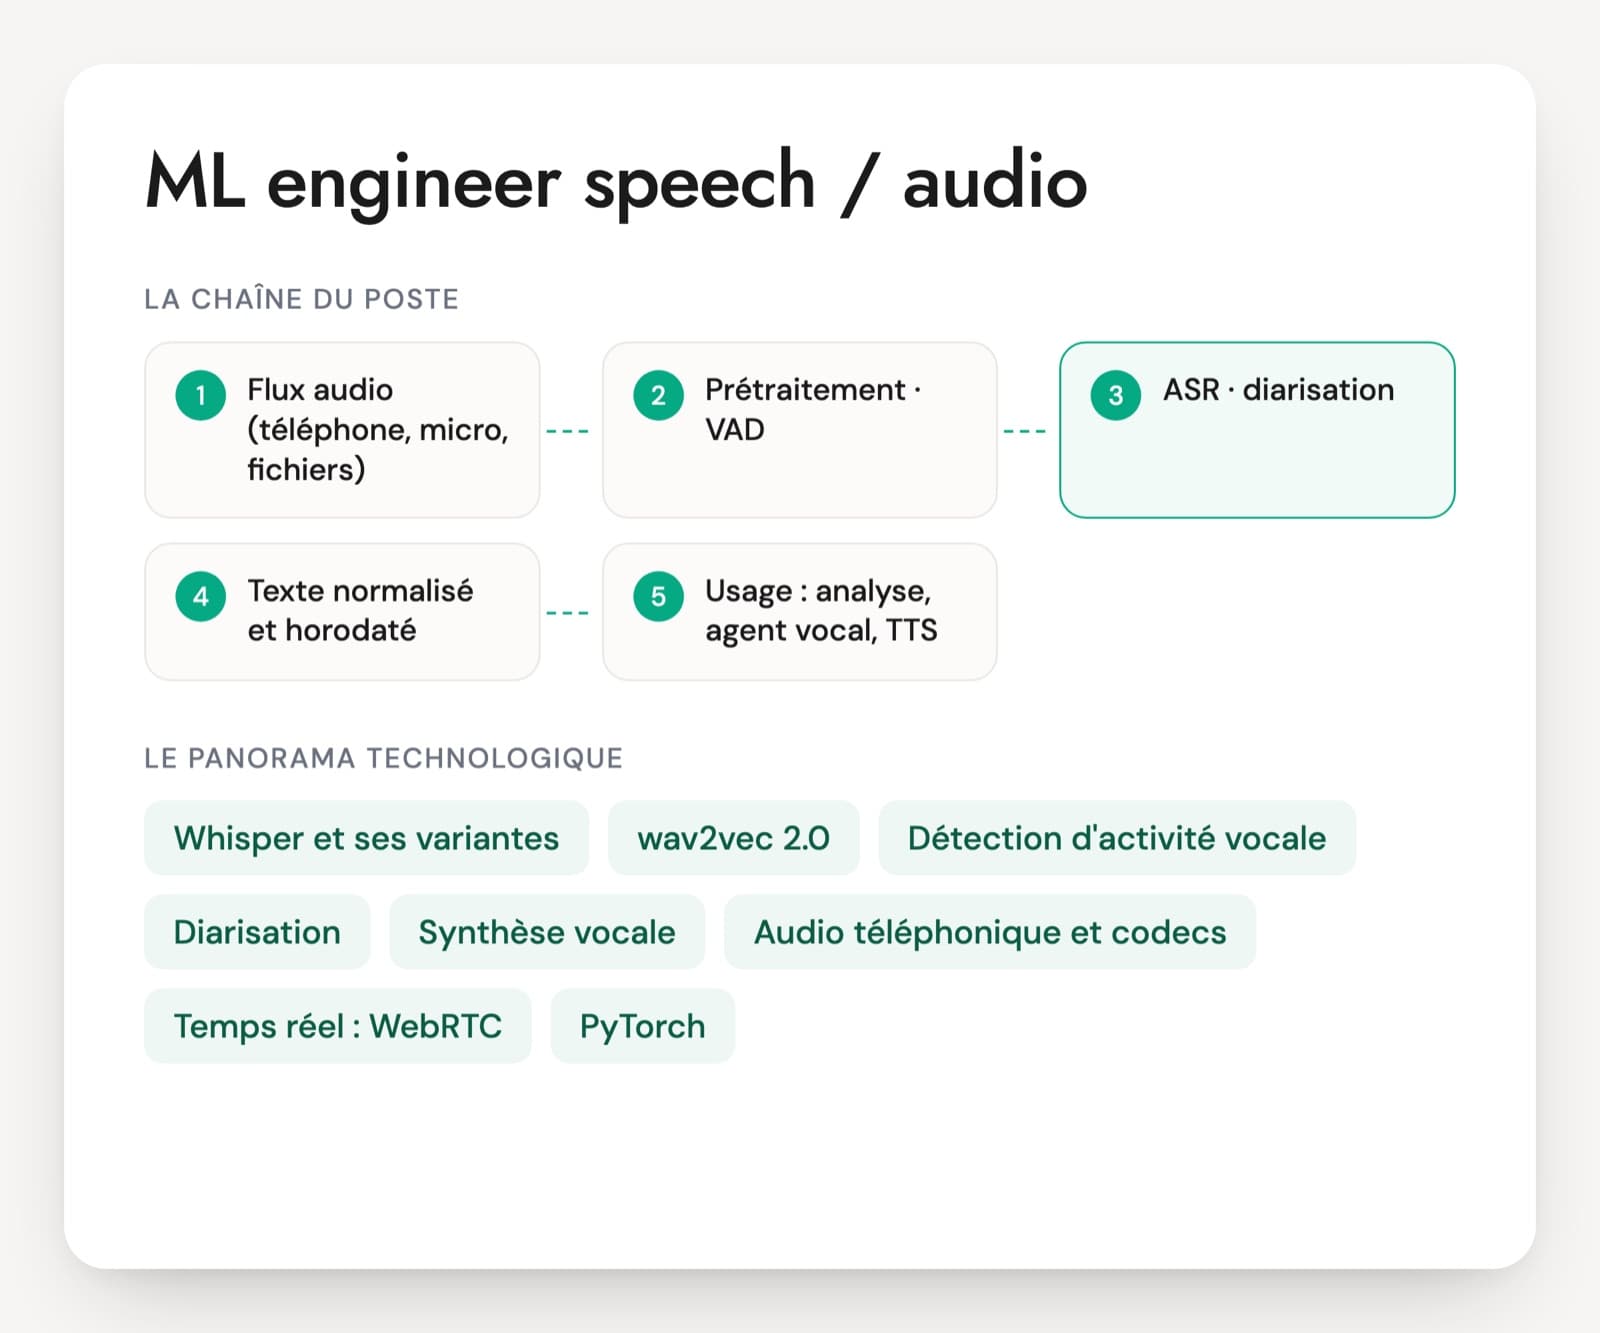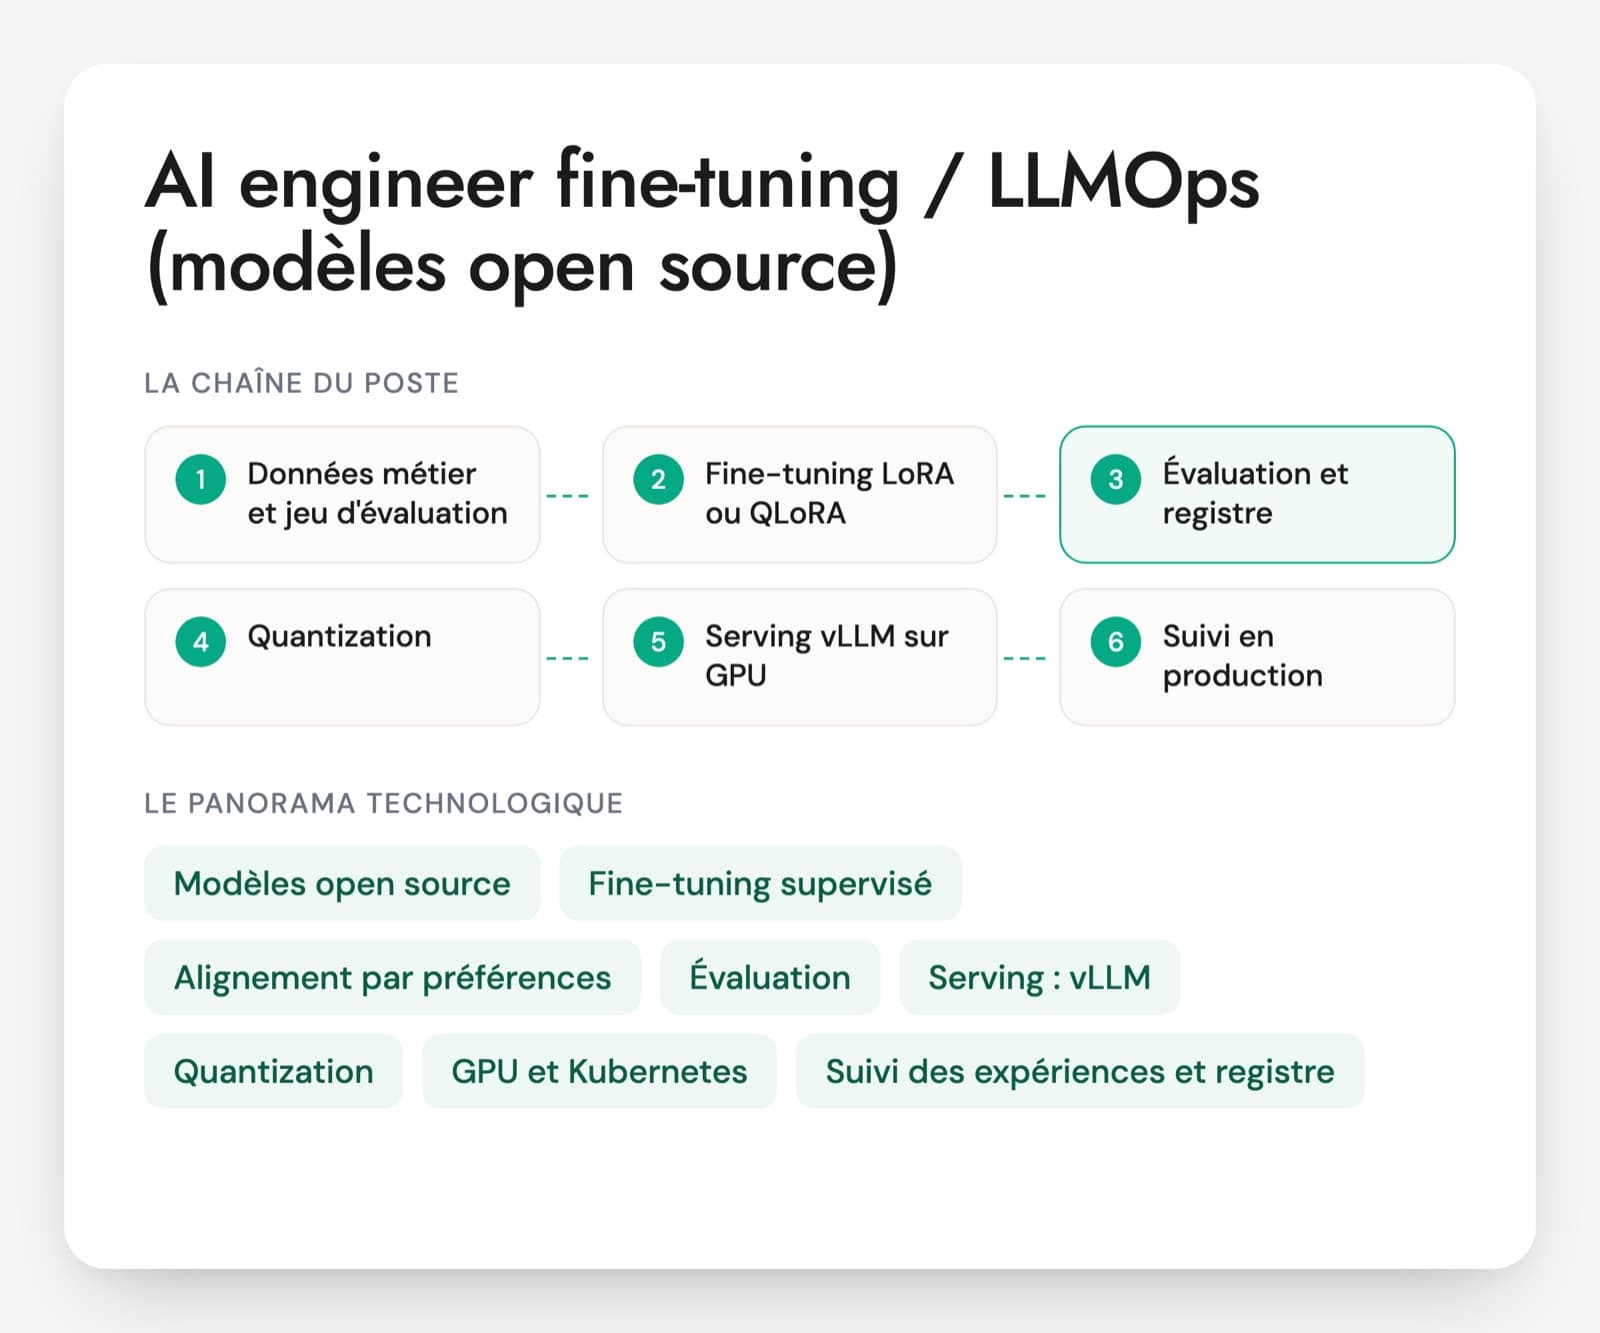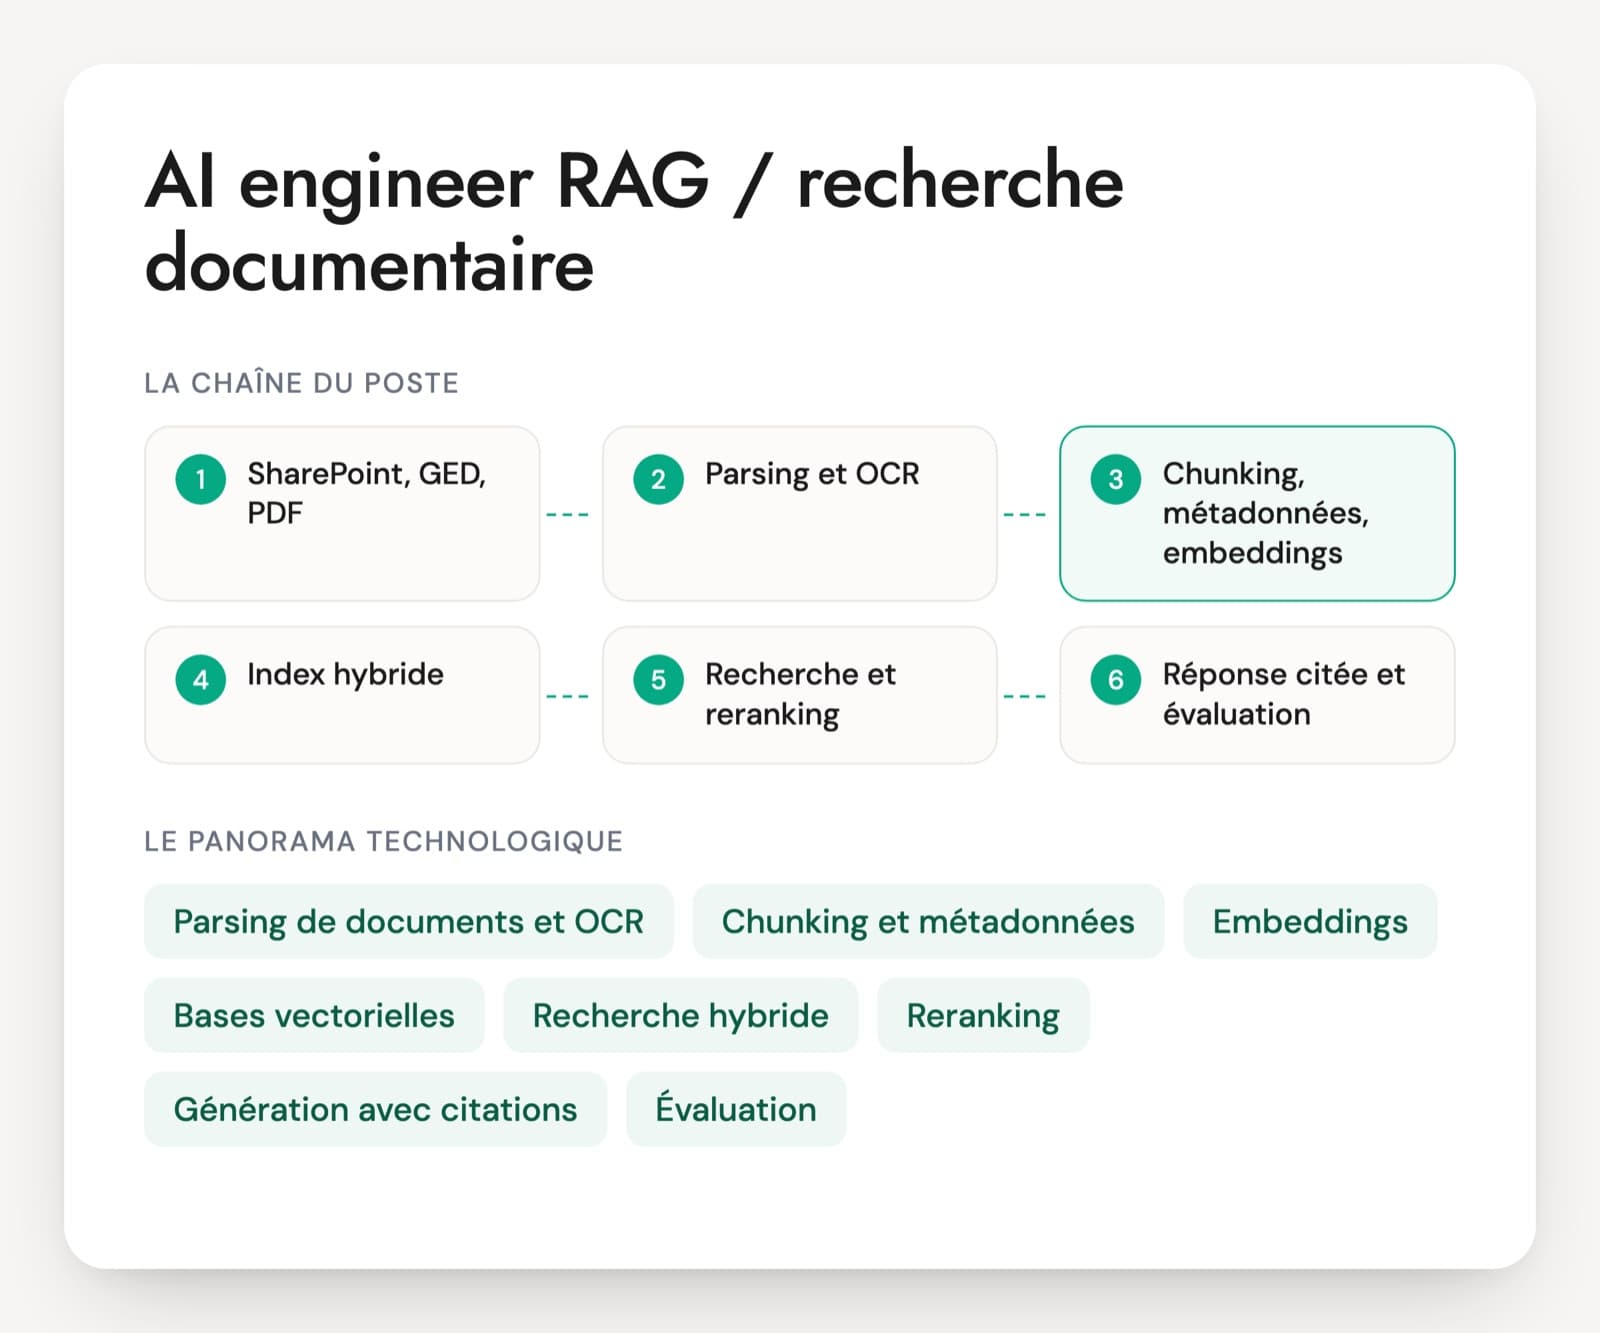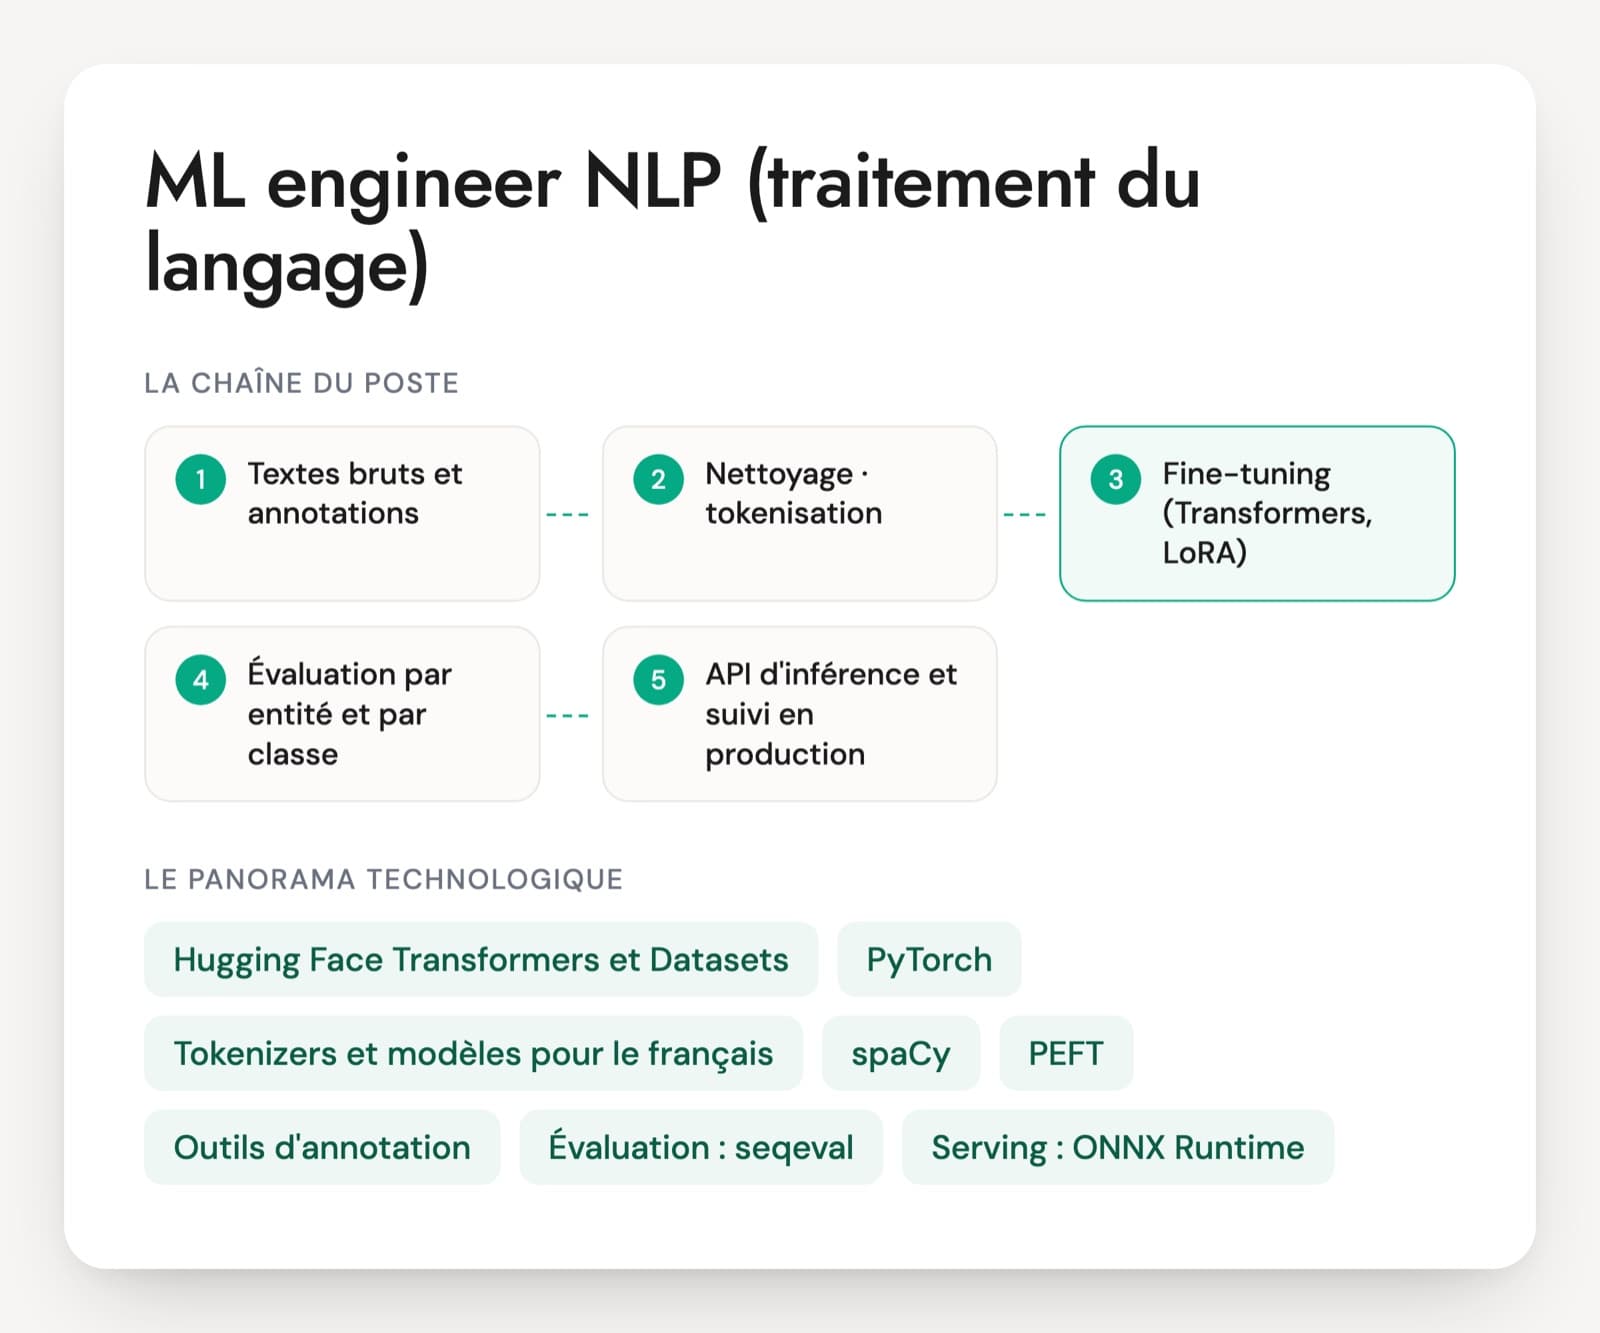
Le poste d'ingénieur NLP se situe entre la data science et le développement. Il constitue des jeux de données annotés, fine-tune des modèles avec Hugging Face et PyTorch, puis les sert derrière une API qui doit tenir la charge. Les sujets sont concrets : tri de courriels, extraction de numéros de contrat dans des PDF, détection de motifs dans des avis clients, anonymisation de comptes rendus. Depuis l'arrivée des LLM, une partie du travail consiste aussi à décider quand un grand modèle vaut son coût et quand un petit modèle fine-tuné suffit.
Tout le monde a « fait du NLP », à lire les CV. La difficulté consiste à distinguer la personne qui a enchaîné des appels à un LLM de celle qui a construit un jeu de test, mesuré un F1 par entité et suivi la qualité après la mise en production. Les offres françaises ajoutent une contrainte souvent sous-estimée : le texte est en français, avec ses accents, ses abréviations et ses fautes de frappe.
Faites décrire au candidat le jeu de test de son dernier projet : taille, annotateurs, accord entre eux. La réponse sépare vite la pratique des mots-clés.
Du tokenizer au serveur d'inférence : la boîte à outils d'un ingénieur NLP
Hugging Face Transformers et Datasets
La bibliothèque de référence pour charger, entraîner et évaluer des modèles de langage, avec son hub de modèles publics. Presque toutes les offres la citent. En entretien, demandez ce qui se passe réellement quand la fonction d'entraînement tourne.
PyTorch
Le framework de deep learning sur lequel reposent la plupart des modèles de texte. Un ingénieur NLP l'utilise pour écrire une boucle d'entraînement, gérer la mémoire du GPU ou déboguer une perte qui ne descend pas. TensorFlow se croise encore dans des projets plus anciens.
Tokenizers et modèles pour le français
Le tokenizer découpe le texte en morceaux que le modèle comprend. Un modèle pensé pour l'anglais découpe les mots français en beaucoup de fragments, ce qui coûte en longueur et en qualité. CamemBERT et FlauBERT ont été entraînés sur du français ; les grands modèles multilingues, comme ceux de Mistral AI, couvrent aussi la langue.
spaCy
Une bibliothèque Python rapide pour les traitements classiques : découpage en phrases, lemmatisation, reconnaissance d'entités nommées. Elle sert souvent de première version ou de brique de prétraitement avant un modèle plus lourd. Un candidat qui la connaît sait en général ce qu'est une chaîne de traitement de texte en production.
PEFT, LoRA et QLoRA
Des méthodes pour adapter un grand modèle à une tâche en n'entraînant qu'une petite partie de ses poids. QLoRA ajoute une compression du modèle de base pour tenir sur un seul GPU. Beaucoup d'offres les citent ; vérifiez que la personne sait dire comment elle a mesuré le gain.
Outils d'annotation
Label Studio, Prodigy ou doccano servent à faire étiqueter des exemples par des humains : catégorie d'un message, position d'une entité dans une phrase. La qualité d'un modèle NLP dépend d'abord de cette étape. Demandez qui a écrit le guide d'annotation et comment les désaccords ont été tranchés.
Évaluation : seqeval, métriques et LLM-as-judge
Pour l'extraction, on mesure précision, rappel et F1 entité par entité ; pour la génération, BLEU ou ROUGE ont des limites connues et beaucoup d'équipes font noter les réponses par un autre LLM, le LLM-as-judge. Chaque méthode a ses biais. Un bon profil sait lequel choisir et ce qu'il ne mesure pas.
Serving : ONNX Runtime, vLLM, conteneurs
Une fois entraîné, le modèle doit répondre vite et à moindre coût. ONNX Runtime accélère les petits modèles sur CPU, vLLM sert les modèles génératifs sur GPU en regroupant les requêtes. Le tout tourne dans Docker, souvent sur Kubernetes, avec un suivi des expériences dans MLflow.
Le poste change selon l'employeur. Dans un grand groupe, l'ingénieur NLP industrialise des modèles pour plusieurs métiers et passe beaucoup de temps sur les données et la conformité. En start-up, il couvre tout, de l'annotation au déploiement. En ESN, les missions récentes mélangent souvent NLP classique, RAG et speech-to-text chez un même client, avec MLflow et une CI GitLab. Le titre varie aussi : data scientist NLP, NLP engineer, ingénieur IA. Lisez les projets décrits plutôt que l'intitulé, et cherchez la trace d'un modèle réellement servi à des utilisateurs.
La couverture technique d'un entretien de ML engineer NLP
- Traitement du texte et tokenisation
- Constitution et qualité des données annotées
- Choix de modèle et fine-tuning
- Évaluation des modèles de langage
- Industrialisation et serving
- Données personnelles et robustesse des sorties
Ce qu'il faut demander à un ingénieur NLP, en cinq questions
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
On vous demande de classer 200 000 courriels clients par motif chaque jour. Vous partez sur un LLM interrogé par API ou sur un petit modèle fine-tuné ? Comment tranchez-vous ?
Une bonne réponseLa réponse part du besoin : nombre de motifs, stabilité de la liste, latence attendue, budget et contraintes de confidentialité. Un LLM avec quelques exemples dans le prompt donne vite une première version et aide à pré-annoter. À ce volume quotidien, un encodeur de type CamemBERT fine-tuné sur quelques milliers d'exemples coûte bien moins cher à faire tourner et répond plus vite. La personne propose de comparer les deux sur le même jeu de test avant de choisir.
Signal d'alerte« Un LLM, c'est ce qui marche le mieux » sans parler de coût ni de latence, ou l'inverse par principe. Aucune mention d'un jeu de test commun pour comparer.
Question 2 · confirmé
Deux annotateurs ne sont d'accord que sur deux tiers des exemples. Que faites-vous avant d'entraîner quoi que ce soit ?
Une bonne réponseMesurer l'accord avec un indicateur qui corrige le hasard, comme le kappa de Cohen, puis lire les désaccords pour trouver leur cause : catégories qui se recouvrent, consigne floue, exemples vraiment ambigus. On revoit le guide d'annotation, on fusionne ou on redéfinit des classes, on fait arbitrer les cas litigieux. Un modèle ne fera pas mieux que l'accord entre humains sur ces classes.
Signal d'alerteEntraîner quand même en espérant que le modèle « lisse » le bruit, ou garder au hasard l'étiquette d'un des deux annotateurs.
Question 3 · confirmé
Votre modèle d'extraction d'entités affiche un F1 de 0,92. Qu'est-ce que ce chiffre ne vous dit pas ?
Une bonne réponseS'il est calculé par entité complète ou par token, s'il s'agit d'une moyenne micro qui cache une entité rare très mal reconnue, et sur quel jeu il a été mesuré. La personne demande le F1 par type d'entité, vérifie que le jeu de test ne contient pas de quasi-doublons des exemples d'entraînement et qu'il ressemble aux documents de production. Elle lit aussi une cinquantaine d'erreurs à la main.
Signal d'alerte« 0,92, c'est très bon », sans question sur la méthode de calcul ni sur la composition du jeu de test.
Question 4 · senior
Vous fine-tunez un modèle de 7 milliards de paramètres avec LoRA sur un seul GPU. Quels réglages surveillez-vous, et comment savez-vous que ça a marché ?
Une bonne réponseLe rang et le facteur d'échelle des adaptateurs, les couches ciblées, le taux d'apprentissage, la longueur des séquences et la quantification du modèle de base en 4 bits (QLoRA) pour tenir en mémoire. La courbe de perte sur un jeu de validation séparé montre le surapprentissage. Le vrai test reste la comparaison avec le modèle de base et une version avec simple prompt sur la tâche cible, plus un contrôle que le modèle n'a pas perdu ses capacités générales.
Signal d'alerteUne liste d'hyperparamètres récitée sans lien avec la mémoire du GPU, ou un succès jugé sur la seule perte d'entraînement.
Question 5 · confirmé
Un modèle entraîné surtout sur de l'anglais découpe les mots français en beaucoup de morceaux. Quelles conséquences en production, et que proposez-vous ?
Une bonne réponsePlus de tokens par document, donc des textes tronqués plus tôt, une inférence plus lente et une facture plus élevée quand on paie au token. La qualité baisse aussi sur les mots rares, les accents et les noms propres. La personne propose de mesurer le nombre moyen de tokens par mot sur un échantillon, puis de tester un modèle entraîné sur du français ou un modèle multilingue mieux outillé.
Signal d'alerte« Le tokenizer, ce n'est qu'un détail technique », ou supprimer les accents pour simplifier, ce qui crée des ambiguïtés.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Recruter en traitement du langage : les points qui reviennent
Votre projet demande-t-il un ingénieur NLP ou un AI engineer LLM ?
Les deux se recoupent. L'AI engineer assemble surtout des applications autour de modèles existants : prompts, RAG, agents, appels d'API. Le ML engineer NLP entraîne et évalue des modèles, constitue les jeux annotés et fine-tune quand un modèle généraliste ne suffit pas ou coûte trop cher. Si votre besoin est un classement à fort volume, une extraction précise sur des documents métier ou un modèle hébergé chez vous, cherchez plutôt le second.
Sur quoi juger un ingénieur NLP quand on n'est pas soi-même technique ?
Sur sa façon de parler de ses projets. Demandez comment il savait que son modèle fonctionnait : un profil expérimenté parle de jeu de test, de métrique par classe, d'erreurs relues à la main et de suivi après la mise en production. Demandez aussi ce qui a raté. Une réponse qui ne cite que des noms de modèles et de bibliothèques, sans chiffre de qualité ni décision argumentée, appelle une vérification par un pair technique.
Un exercice sur notebook est-il un bon test technique pour un ingénieur NLP ?
Il montre la capacité à manipuler des données et un modèle ; l'industrialisation n'y apparaît pas. Un format plus parlant consiste à remettre un petit jeu de textes annotés avec quelques erreurs volontaires et un modèle déjà entraîné, puis à demander en direct d'évaluer ce modèle et de proposer des améliorations. En une heure, vous voyez si la personne repère les étiquettes douteuses, choisit la bonne métrique et lit les erreurs.
Faut-il un doctorat pour tenir un poste d'ingénieur NLP ?
Non pour la plupart des postes en entreprise. Un doctorat apporte une habitude de la méthode expérimentale et de la lecture d'articles, utile pour un poste orienté recherche ou pour adapter des modèles peu documentés. Pour un poste d'industrialisation, l'expérience de modèles servis en production pèse davantage. Vérifiez dans les deux cas la qualité du code, les tests et la capacité à livrer un modèle utilisable par une équipe produit.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.