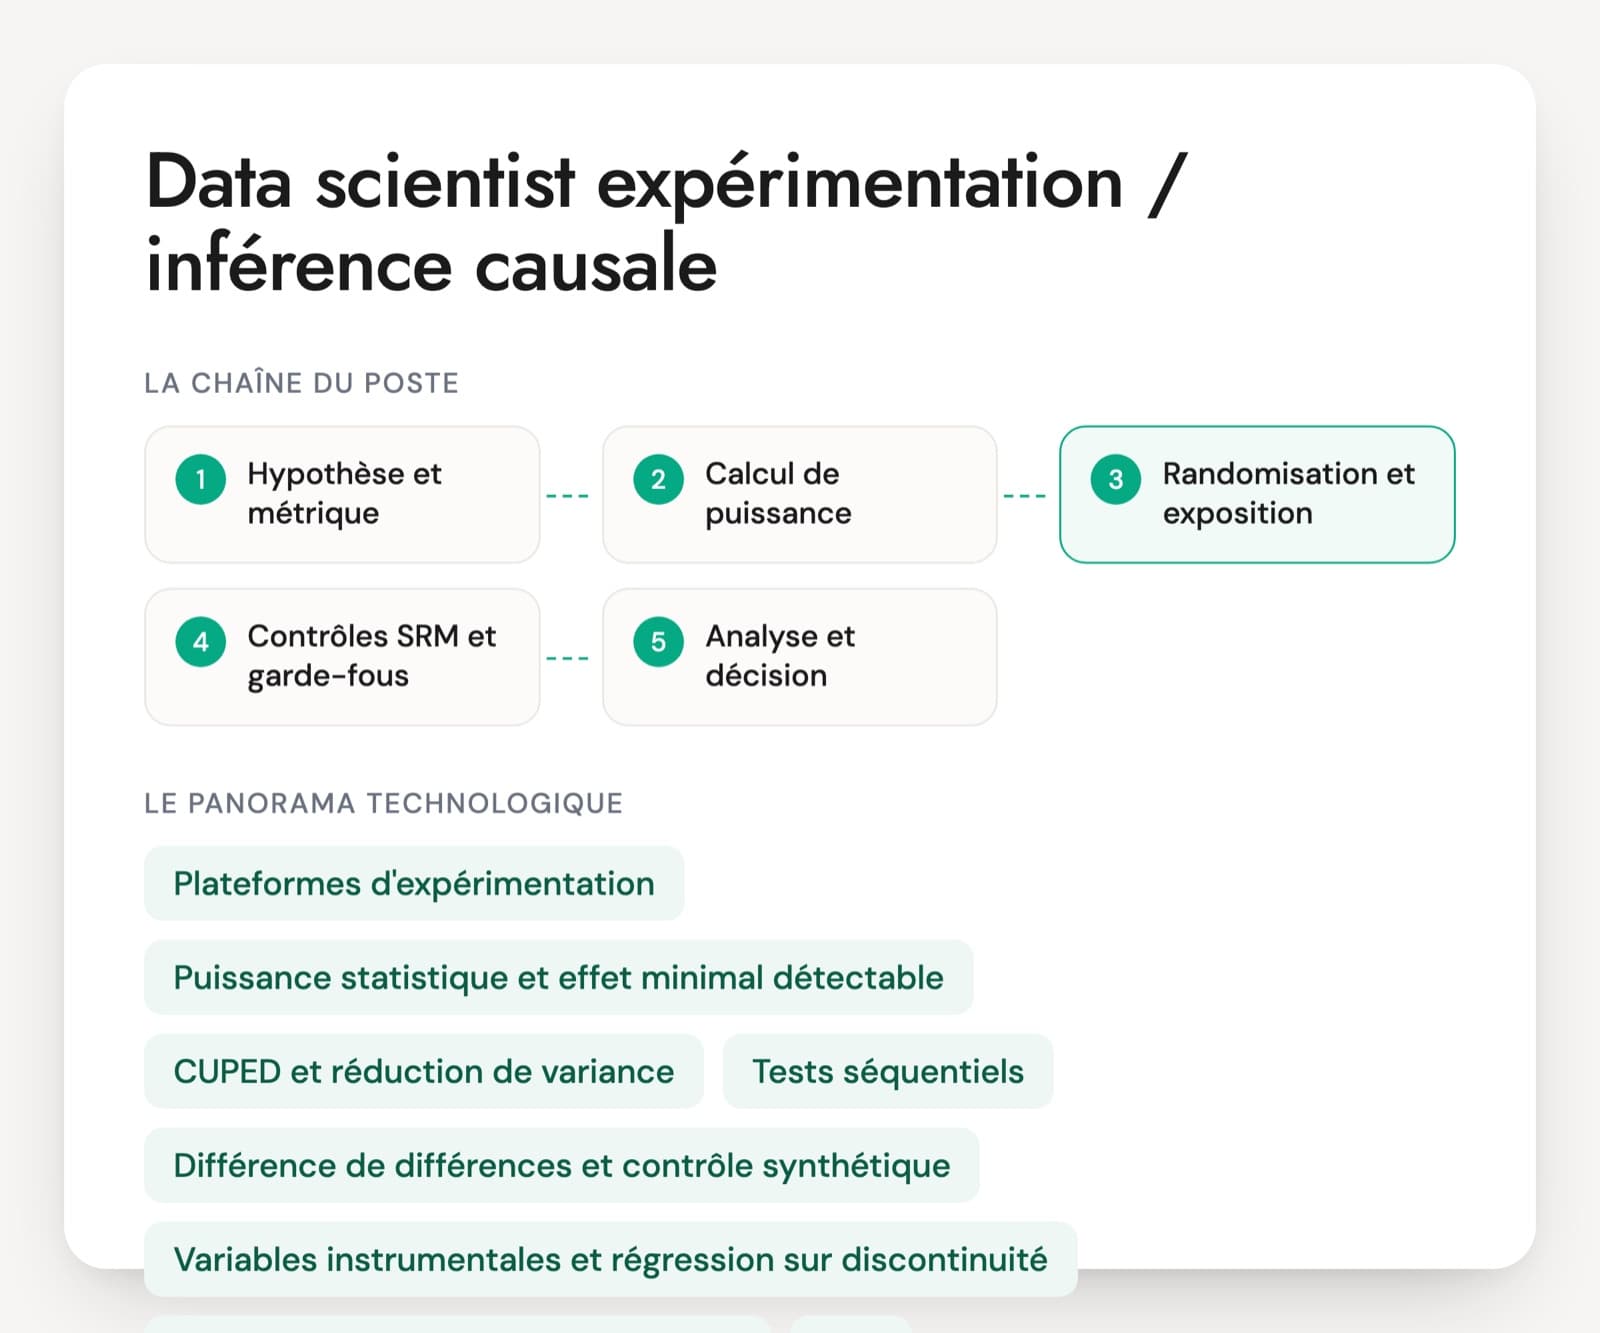
Un data scientist en expérimentation et inférence causale mesure ce que provoque réellement un changement : une nouvelle page de paiement, une baisse de prix, une campagne. Dans une scale-up produit ou un site e-commerce, il fait tourner une plateforme d'A/B tests, interne ou du marché (GrowthBook, Eppo, Statsig, Optimizely), et garantit que les conclusions tiennent. Quand on ne peut pas randomiser, il recourt à la différence de différences, au contrôle synthétique ou aux variables instrumentales. On croise ces postes dans les marketplaces et les applications grand public.
L'écart de niveau se voit mal sur un CV. Beaucoup de candidats savent lancer un test et lire une p-value. Beaucoup moins savent dire avant le lancement combien de temps il doit durer, pourquoi regarder les résultats chaque jour fausse la conclusion, ou que faire quand les deux groupes n'ont pas la taille prévue. Sur données d'observation, l'écart se creuse : un profil solide énonce les hypothèses de sa méthode et la façon de les vérifier.
L'ordre des questions suit la vie d'une expérience, du dimensionnement à la lecture des résultats. Le PDF en ajoute 25, avec un axe entier sur les méthodes quasi-expérimentales, un cas de 20 minutes sur une marketplace où les groupes se contaminent et une grille de 1 à 4.
Les méthodes d'expérimentation et d'inférence causale à connaître
Plateformes d'expérimentation
Elles répartissent les utilisateurs entre versions, enregistrent qui a vu quoi et calculent les résultats. Les entreprises utilisent des outils comme GrowthBook, Eppo, Statsig, Optimizely ou AB Tasty, ou une plateforme interne. Le data scientist en définit les métriques, les contrôles automatiques et les règles d'arrêt.
Puissance statistique et effet minimal détectable
Avant le lancement, on calcule combien d'utilisateurs il faut pour détecter un effet d'une taille donnée (MDE, minimum detectable effect). Ce calcul fixe la durée du test. Un candidat qui s'en passe lancera des tests trop courts et conclura sur du bruit.
CUPED et réduction de variance
CUPED s'appuie sur une mesure prise avant le test, comme les dépenses du mois précédent, pour retirer une partie du bruit de la métrique. À trafic égal, le test devient plus sensible. Plusieurs plateformes du marché la proposent, sous ce nom ou sous une variante.
Tests séquentiels
Consulter les résultats chaque jour et s'arrêter dès que c'est significatif fait grimper le taux de faux positifs. Les tests séquentiels (mSPRT, plans séquentiels par groupes, intervalles valides à tout moment) autorisent ces regards en contrôlant l'erreur. Les approches bayésiennes, proposées par certains outils, demandent elles aussi une règle d'arrêt.
Différence de différences et contrôle synthétique
Quand un changement touche une région, un magasin ou un pays entier, on compare son évolution à celle d'unités non touchées. La différence de différences suppose des tendances parallèles avant le changement, et ses versions récentes traitent les déploiements échelonnés. Le contrôle synthétique fabrique un témoin pondéré à partir de plusieurs unités.
Variables instrumentales et régression sur discontinuité
Deux méthodes pour estimer un effet sans expérience, quand une source de variation se comporte comme un tirage au sort : un seuil d'éligibilité, une règle d'attribution, une panne. On les rencontre surtout chez les profils formés en économétrie.
Modèles uplift et effets hétérogènes
Un modèle uplift estime l'effet d'une action sur chaque client, une information qu'un modèle de probabilité d'achat ne donne pas. Les bibliothèques CausalML, EconML et DoWhy couvrent ces méthodes (meta-learners, forêts causales, double machine learning). Elles servent à cibler une campagne ou une remise.
SQL, Python et R
Les expériences se calculent sur des tables d'événements en SQL, puis en Python (statsmodels, SciPy, pandas) ou en R. Méthode delta, bootstrap et régressions avec erreurs robustes font partie du quotidien. Le SQL compte autant que la statistique : une jointure mal faite entre expositions et événements suffit à fausser un test.
Le contenu du poste dépend de la maturité de l'entreprise. Dans une scale-up qui lance des dizaines de tests par mois, le data scientist construit ou fait évoluer la plateforme, écrit les règles communes et relit les analyses des équipes produit. Ailleurs, il fait les deux métiers : quelques A/B tests sur le site ou l'application, et beaucoup d'études sur données d'observation pour mesurer une campagne, une ouverture de magasin ou un changement de prix. Les profils venus de l'économétrie sont souvent plus à l'aise sur ce second volet, ceux venus du produit sur le premier. Si le poste demande les deux, l'entretien doit couvrir les deux.
Six savoir-faire statistiques à valider avant l'embauche
- Conception et dimensionnement des tests
- Contrôles de validité d'une expérience
- Réduction de variance et tests séquentiels
- Métriques ratio, méthode delta et bootstrap
- Méthodes quasi-expérimentales
- Uplift et effets hétérogènes
Un data scientist expérimentation face à cinq tests mal engagés
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · junior à confirmé
Le produit veut tester un nouveau tunnel de commande. Comment fixez-vous la durée du test ?
Une bonne réponseLa personne part de la métrique principale (taux de conversion), de sa valeur actuelle et de sa variance, de l'effet minimal qui vaut la peine d'être détecté selon le métier, du risque d'erreur accepté (souvent 5 %) et de la puissance voulue (souvent 80 %). Elle en tire un nombre d'utilisateurs par groupe, puis une durée selon le trafic, arrondie à des semaines entières pour couvrir les écarts entre jours.
Signal d'alerteOn lance et on arrête quand c'est significatif, ou deux semaines par habitude, sans aucun calcul.
Question 2 · confirmé
Le test devait répartir le trafic 50/50 et vous observez 50,8 % contre 49,2 % sur 400 000 utilisateurs. Que faites-vous ?
Une bonne réponseUn test du khi-deux de déséquilibre d'échantillon (SRM, sample ratio mismatch). Sur ce volume, un tel écart est très improbable par hasard, donc l'assignation ou l'enregistrement a un défaut. La personne ne lit pas les résultats et cherche la cause : redirection qui perd des utilisateurs, robots, bug d'exposition sur un navigateur, filtre appliqué après l'assignation.
Signal d'alerteL'écart est petit, on continue, puis une conclusion sur la conversion comme si les groupes étaient comparables.
Question 3 · confirmé
Votre manager regarde le tableau de bord chaque matin et veut arrêter le test dès que la p-value passe sous 0,05. Qu'en dites-vous ?
Une bonne réponseRegarder à répétition avec un test classique fait grimper le risque de faux positif : la p-value finit souvent par passer sous le seuil par hasard. Deux options. Fixer la durée à l'avance et ne décider qu'à la fin, ou passer à un test séquentiel (mSPRT, plan séquentiel par groupes, intervalles valides à tout moment) qui autorise ces regards en contrôlant l'erreur.
Signal d'alerteAccepter l'arrêt anticipé, ou ne pas voir où est le problème.
Question 4 · senior
Votre métrique principale est le panier moyen, très bruité. Comment rendez-vous le test plus sensible sans l'allonger ?
Une bonne réponseCUPED : une régression sur une variable mesurée avant le test, comme le panier des semaines précédentes, qui retire la part prévisible de la variance sans biaiser l'estimation, puisque cette variable ne dépend pas du traitement. S'y ajoutent le traitement des valeurs extrêmes (winsorisation fixée à l'avance) et le fait que le panier moyen est un ratio, dont la variance se calcule par la méthode delta ou le bootstrap quand on randomise par utilisateur.
Signal d'alerteSupprimer les gros paniers après avoir vu les résultats, ou prendre comme covariable une mesure faite pendant le test.
Question 5 · senior
Une enseigne a ouvert la livraison à domicile dans 12 villes et pas ailleurs. Comment estimez-vous l'effet sur les ventes ?
Une bonne réponseUne différence de différences entre villes servies et non servies, après vérification de tendances parallèles avant l'ouverture, ou un contrôle synthétique qui pondère des villes témoins pour reproduire la trajectoire passée. La personne discute le choix des villes (retenues pour leur potentiel, d'où un biais), les ouvertures échelonnées qui demandent des estimateurs adaptés, et teste la robustesse par des placebos.
Signal d'alerteComparer les 12 villes avant et après sans groupe témoin, ou comparer directement villes servies et non servies.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Recruter un spécialiste de l'inférence causale, en pratique
Économètre ou data scientist produit : quel parcours privilégier ?
Tout dépend de la part d'A/B tests dans le poste. Un profil passé par l'économétrie ou la statistique maîtrise la différence de différences, les variables instrumentales et l'énoncé des hypothèses, mais doit montrer qu'il manipule des données d'événements en SQL et à grande échelle. Un data scientist produit connaît les tests en ligne et leurs pièges pratiques, parfois moins les méthodes sans randomisation. Si l'offre mentionne les deux volets, testez les deux.
Data scientist expérimentation et product data analyst, quelle différence ?
Le product data analyst lance et lit des tests, suit les funnels et la rétention. Le data scientist expérimentation conçoit les règles : calcul de puissance, contrôles automatiques, réduction de variance, tests séquentiels. Il traite aussi les cas difficiles, comme les effets de réseau ou les études où aucun test n'est possible. Dans une petite équipe, une même personne fait les deux. Pour un poste de référent, exigez la seconde liste.
Faut-il connaître la plateforme d'A/B test utilisée chez nous ?
Rarement. GrowthBook, Eppo, Statsig ou une plateforme interne reposent sur les mêmes notions : assignation, exposition, métriques, contrôles. Un candidat qui comprend ce que calcule l'outil, par exemple comment il traite les ratios ou applique CUPED, s'adapte en quelques semaines. Savoir naviguer dans un outil sans pouvoir refaire le calcul à la main est un signal faible.
Comment évaluer un candidat sur l'inférence causale en une heure ?
Donnez un résultat d'A/B test volontairement faussé, avec un déséquilibre de groupes ou un arrêt anticipé, et demandez ce que la personne en conclut. Ajoutez une question ouverte sur un changement déployé sans test, à mesurer après coup. Ce test technique court montre le réflexe de contrôle et la capacité à énoncer des hypothèses. La grille du PDF permet de noter chaque volet de 1 à 4.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.