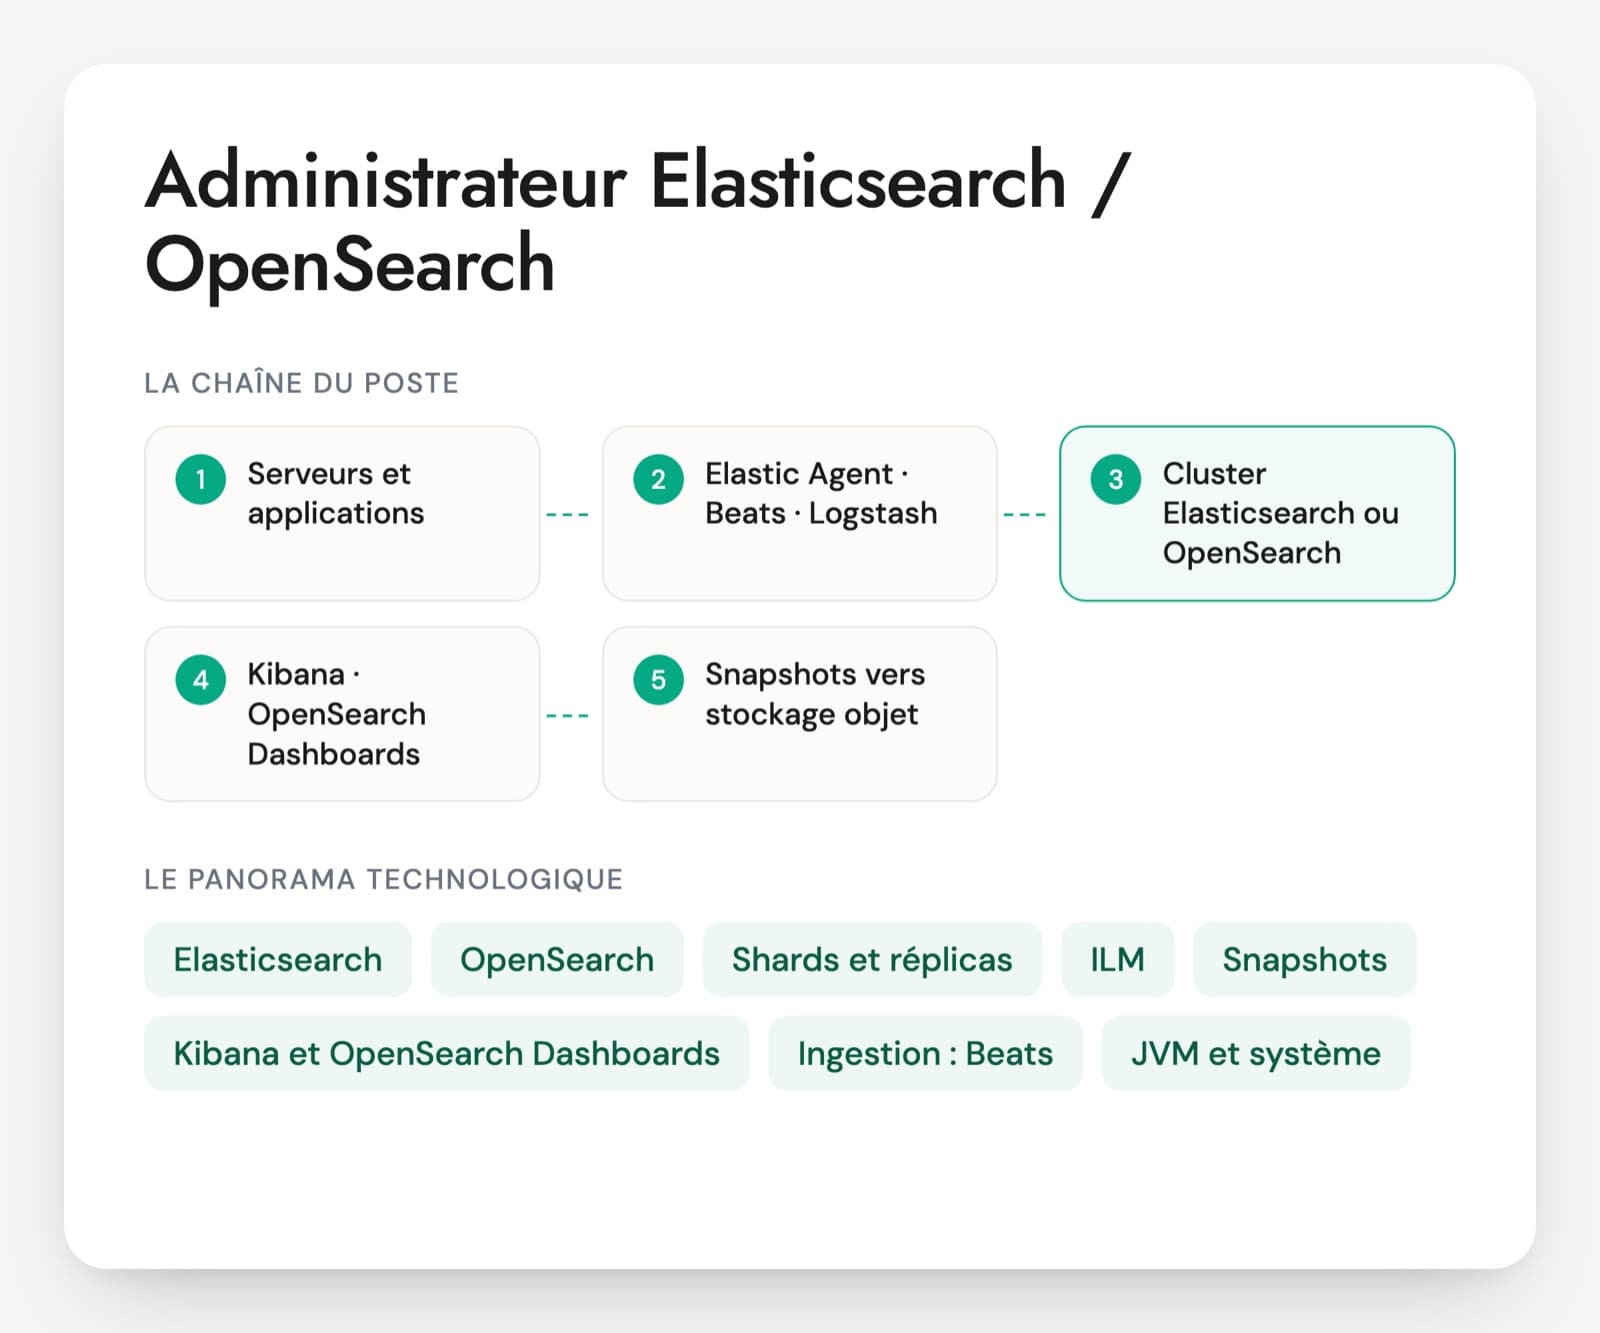
Recruter un administrateur Elasticsearch, c'est chercher quelqu'un qui fait vivre le moteur plutôt que quelqu'un qui l'interroge. Le poste couvre l'installation des nœuds, le découpage des index en shards, la gestion du cycle de vie des données, les snapshots, les montées de version et la sécurité. Sur Free-Work, les missions mêlent souvent Elastic Cloud ou des clusters installés sur site, Kibana, Logstash, Ansible, et parfois Kafka en amont pour la collecte des logs.
Le piège vient des profils qui ont beaucoup utilisé la pile ELK sans jamais l'administrer. Construire un tableau de bord Kibana ou écrire une requête ne dit rien de la capacité à expliquer un cluster resté jaune, à corriger 9 000 shards trop petits ou à régler la mémoire Java d'un nœud qui décroche. L'écart entre Elasticsearch, aujourd'hui en version 9, et OpenSearch, issu d'un fork de 2021, compte aussi : les deux ne s'administrent plus tout à fait pareil.
Sur Elasticsearch, la taille du parc change tout : faites préciser au manager le nombre de nœuds, le volume ingéré par jour et la distribution retenue. Un candidat qui a tenu trois nœuds ne se juge pas comme celui qui en a tenu quatre-vingts.
Les briques d'une plateforme Elasticsearch ou OpenSearch
Elasticsearch
Le moteur de recherche et d'analyse, bâti sur Lucene, édité par Elastic et aujourd'hui en version 9. Il sert à la recherche dans des catalogues ou des documents, et surtout au stockage de logs et de métriques. La sécurité (TLS, authentification) est activée par défaut depuis la version 8.
OpenSearch
Le fork open source d'Elasticsearch 7.10, porté par AWS puis confié à l'OpenSearch Software Foundation. Il est en version 3 et existe aussi en service managé chez AWS (Amazon OpenSearch Service). Les concepts de base sont communs, mais le cycle de vie, la sécurité et certaines API diffèrent. Demandez sur lequel la personne a vraiment travaillé.
Shards et réplicas
Chaque index est découpé en shards répartis sur les nœuds, chacun avec ses copies. Le nombre de shards principaux se fixe à la création. Elastic recommande des shards de 10 à 50 Go. Trop de petits shards ralentit et fragilise le cluster, c'est l'erreur la plus fréquente sur les plateformes de logs.
ILM, ISM et data tiers
ILM (Index Lifecycle Management) chez Elastic et ISM (Index State Management) chez OpenSearch font passer automatiquement les index d'une phase à l'autre : écriture, lecture seule, archivage, suppression. Les data tiers (hot, warm, cold, frozen) placent les données anciennes sur du matériel moins cher. C'est là que se joue le coût du stockage.
Snapshots
Les sauvegardes incrémentales d'index vers un stockage objet (S3, Azure Blob, Google Cloud Storage) ou un partage réseau. Une politique planifie les snapshots et leur rétention. Les searchable snapshots d'Elastic permettent même d'interroger des données restées dans le stockage objet.
Kibana et OpenSearch Dashboards
Les interfaces de consultation et d'administration. On y crée les tableaux de bord, on y gère les rôles, et la console permet d'envoyer des requêtes au cluster. Pour un administrateur, Kibana sert aussi à la supervision du cluster et à l'assistant de montée de version.
Ingestion : Beats, Elastic Agent, Logstash
Les agents collectent les logs sur les serveurs, Elastic Agent étant piloté de façon centrale par Fleet. Logstash, ou les pipelines d'ingestion du cluster, transforment les données avant indexation. Côté OpenSearch, on trouve plutôt Data Prepper ou Fluent Bit.
JVM et système
Elasticsearch tourne sur Java. La taille de la heap, calculée automatiquement par défaut, les pauses du ramasse-miettes et la mémoire laissée au système pour Lucene décident de la stabilité des nœuds. Quelques réglages système (vm.max_map_count, swap désactivé) sont vérifiés au démarrage en production.
Le poste porte plusieurs noms : administrateur Elasticsearch, expert Elastic, ingénieur ELK, ingénieur DataOps ou d'exploitation middleware. Une grande partie des clusters français sert aux logs et à la sécurité, parfois alimentés par Kafka ; d'autres font tourner la recherche d'un site ou d'une application métier. Le travail diffère selon l'hébergement : Elastic Cloud ou Amazon OpenSearch Service, où l'exploitation porte sur les index, les droits et les coûts, ou clusters installés sur machines virtuelles ou Kubernetes (ECK), où s'ajoutent le système, la JVM et les montées de version. La personne cumule souvent avec d'autres bases ou middlewares. Les certifications Elastic Certified Engineer et Elastic Certified Observability Engineer attestent les bases, l'expérience se vérifie par les incidents racontés.
Points de contrôle pour un administrateur Elasticsearch
- Dimensionnement des shards et topologie des nœuds
- Mappings, modèles d'index et ingestion
- Cycle de vie des données et snapshots
- Tuning JVM et performance des requêtes
- Santé du cluster, incidents et montées de version
- Sécurité et choix Elasticsearch ou OpenSearch
Ce que vous pouvez demander à un administrateur Elasticsearch
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Le cluster passe en jaune après le redémarrage d'un nœud et y reste depuis une heure. Comment trouvez-vous la cause ?
Une bonne réponseJaune veut dire que tous les shards principaux sont affectés mais que des réplicas ne le sont pas. L'API _cluster/allocation/explain donne la raison exacte, et _cat/shards liste les shards non affectés. Causes fréquentes : allocation laissée désactivée après une maintenance (cluster.routing.allocation.enable), seuil de disque dépassé, plus de réplicas que de nœuds disponibles, règles d'allocation par attribut ou par zone.
Signal d'alerteSupprimer et recréer l'index, redémarrer tout le cluster, ou confondre jaune et rouge.
Question 2 · confirmé
Un cluster de logs compte 9 000 shards pour 3 To de données sur six nœuds. Qu'en pensez-vous ?
Une bonne réponseC'est du sur-découpage : à peine plus de 300 Mo par shard en moyenne, loin des 10 à 50 Go recommandés, et 1 500 shards par nœud, au-dessus de la limite par défaut de 1 000, qu'on a donc relevée. Chaque shard coûte de la mémoire, de l'état de cluster et un thread par recherche. Correction : rollover sur la taille (max_primary_shard_size à 50 Go) plutôt qu'un index par jour, moins de shards principaux, shrink ou réindexation des petits index anciens, suppression de l'inutile.
Signal d'alerteAjouter des nœuds ou relever encore la limite de shards par nœud, sans toucher au découpage.
Question 3 · confirmé
Des logs doivent rester consultables 30 jours et être conservés un an pour l'audit. Comment organisez-vous leur cycle de vie ?
Une bonne réponseDes data streams avec une politique ILM (ISM sur OpenSearch) : phase hot avec rollover par taille ou par âge, phase warm avec force merge et moins de réplicas, puis suppression du cluster à 30 jours. Des snapshots planifiés avec une rétention d'un an dans un stockage objet. Sur Elastic avec la licence adaptée, un tier cold ou frozen en searchable snapshots garde l'année consultable à moindre coût. La personne vérifie qu'une restauration fonctionne.
Signal d'alerteUn script cron qui supprime les index par curl, ou tout garder un an sur les disques rapides.
Question 4 · senior
Un nœud de données subit des pauses du ramasse-miettes de plusieurs secondes et sort régulièrement du cluster. Que vérifiez-vous ?
Une bonne réponseLa taille de la heap (automatique par défaut ; réglée à la main, pas plus de la moitié de la RAM et sous le seuil des pointeurs compressés, autour de 30 Go), son taux d'occupation et les journaux du ramasse-miettes. Puis ce qui la remplit : agrégations sur des champs à forte cardinalité, fielddata activé sur des champs text, trop de shards, déclenchements des circuit breakers. Le swap doit être désactivé. L'API hot_threads et les statistiques du nœud complètent.
Signal d'alertePasser la heap à 64 Go, ou redémarrer le nœud chaque nuit.
Question 5 · confirmé
Un champ status arrive tantôt en nombre, tantôt en texte, et des documents commencent à être rejetés. Que s'est-il passé, et comment l'évitez-vous ?
Une bonne réponseLe mapping dynamique a fixé le type du champ au premier document reçu, et les documents de type différent sont rejetés (mapper_parsing_exception). On ne change pas le type d'un champ existant : nouvel index avec un mapping explicite, réindexation et bascule par alias. En prévention, des modèles d'index composables avec des mappings explicites, dynamic à strict ou des runtime fields, une convention de nommage comme ECS et la limite du nombre de champs pour éviter l'explosion du mapping.
Signal d'alerte« On modifie le type du champ dans le mapping », ou ignorer l'existence du mapping dynamique.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Administrateur Elasticsearch ou OpenSearch : vos questions de recruteur
Administrateur Elasticsearch ou administrateur OpenSearch : est-ce le même profil ?
Le socle est commun : shards, réplicas, mappings, snapshots, JVM. OpenSearch vient d'un fork d'Elasticsearch 7.10 en 2021, et les deux produits ont divergé depuis. Le cycle de vie s'appelle ILM d'un côté, ISM de l'autre, la sécurité fonctionne différemment et certaines fonctions n'existent que d'un côté. Un bon administrateur passe de l'un à l'autre en quelques semaines. Précisez dans l'annonce lequel vous exploitez, et si c'est en service managé.
Comment vérifier qu'un profil ELK sait administrer, et pas seulement utiliser Kibana ?
Posez des questions sur ce qui casse : un cluster resté jaune, un disque au-dessus du seuil d'inondation, un nœud qui décroche à cause de la JVM, un index supprimé par erreur. Quelqu'un qui a seulement construit des tableaux de bord répond par l'interface. Un administrateur cite des API (allocation explain, _cat/shards, hot_threads), des réglages et des décisions de découpage. Demandez aussi la taille des clusters tenus, en nœuds et en volume.
Quel test technique pour un administrateur Elasticsearch ?
Montrez la sortie de _cat/shards ou de _cluster/health d'un cluster en difficulté et demandez un diagnostic à voix haute. Autre format utile : faire écrire en vingt minutes une politique ILM ou ISM pour un besoin de rétention donné, puis la commenter ensemble. Les QCM qu'on trouve en ligne vérifient surtout le vocabulaire. Un exercice tiré d'une situation réelle montre mieux les réflexes d'exploitation.
Les certifications Elastic sont-elles un bon indicateur ?
Elastic Certified Engineer porte sur l'installation, la configuration, les index, les requêtes et la sécurité, sous forme d'exercices pratiques sur un vrai cluster. C'est un signal sérieux sur les bases. Elle ne dit rien de l'exploitation dans la durée, des montées de version ou de la gestion d'un incident en production. Pour OpenSearch, il n'existe pas d'équivalent aussi répandu, donc l'entretien technique reste le seul moyen de juger.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.