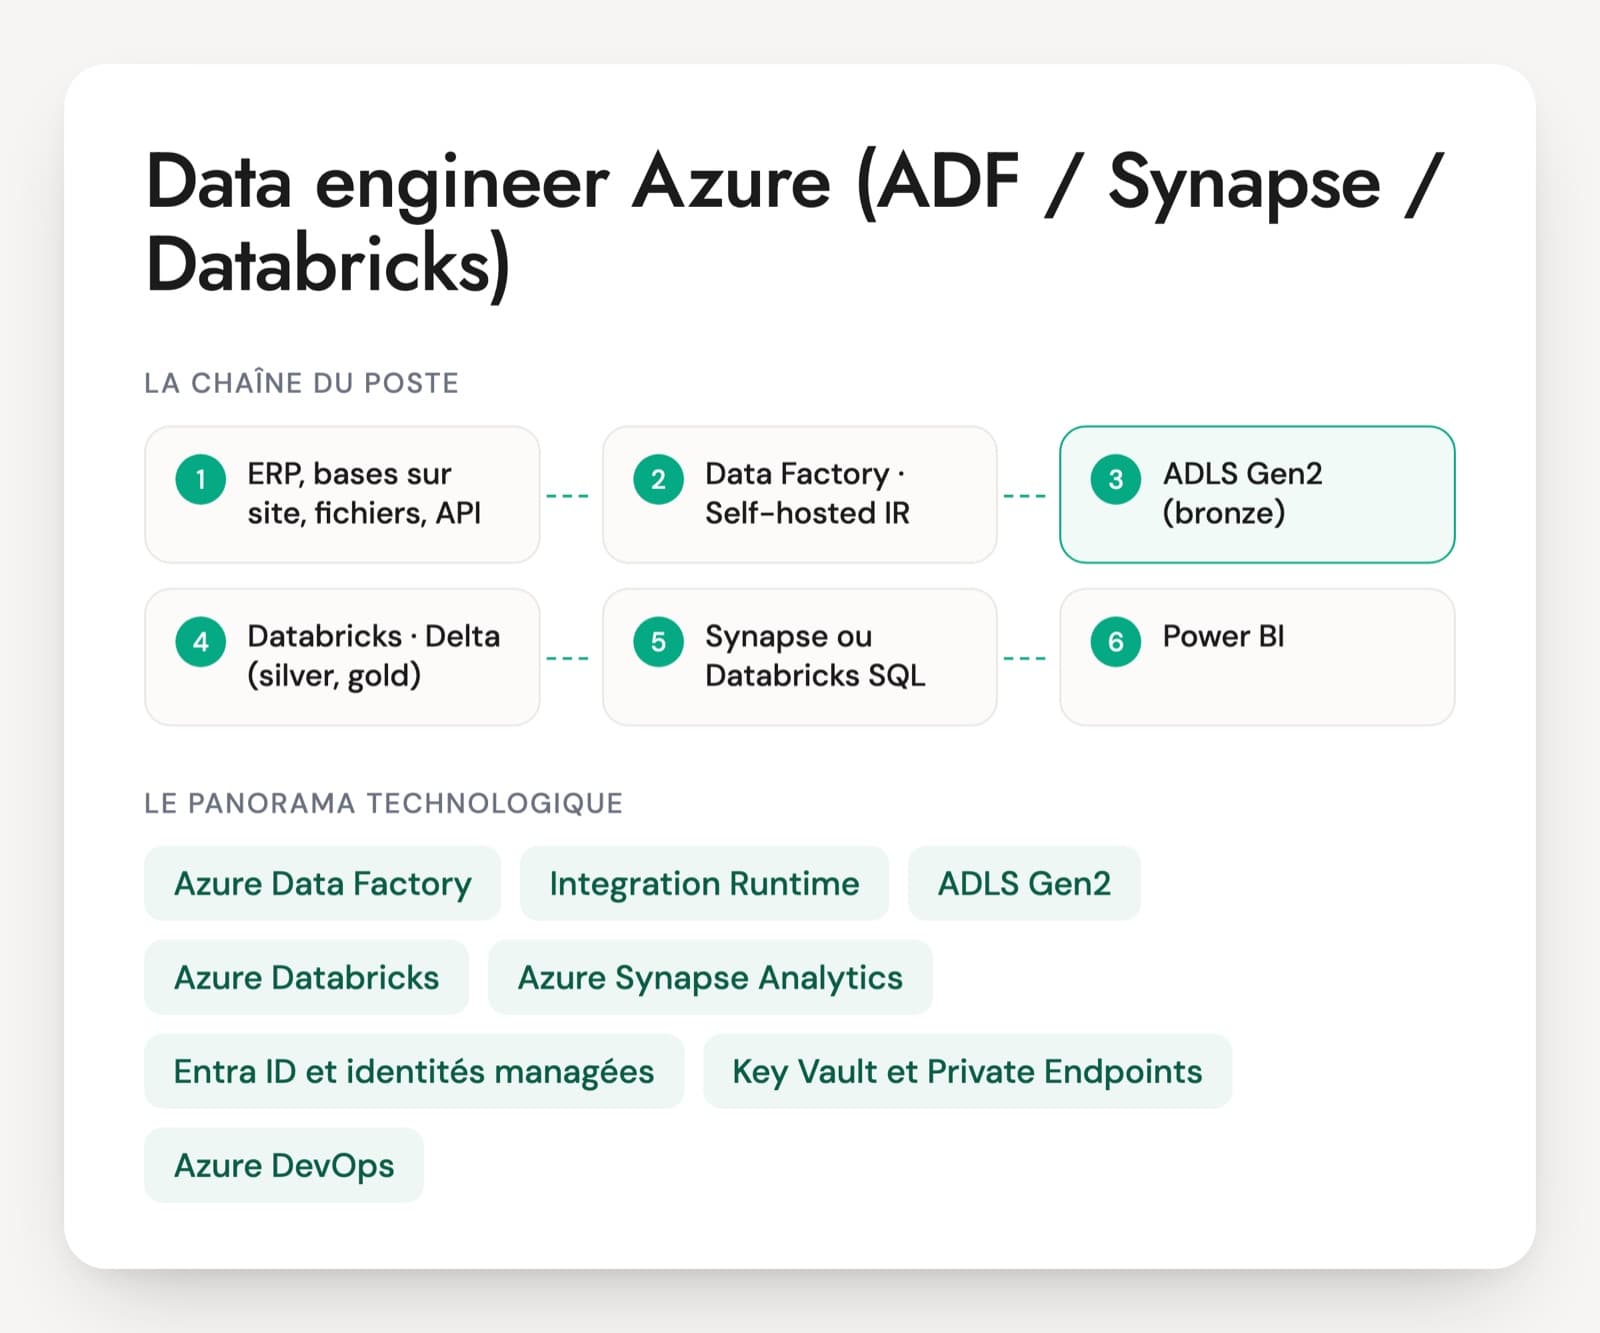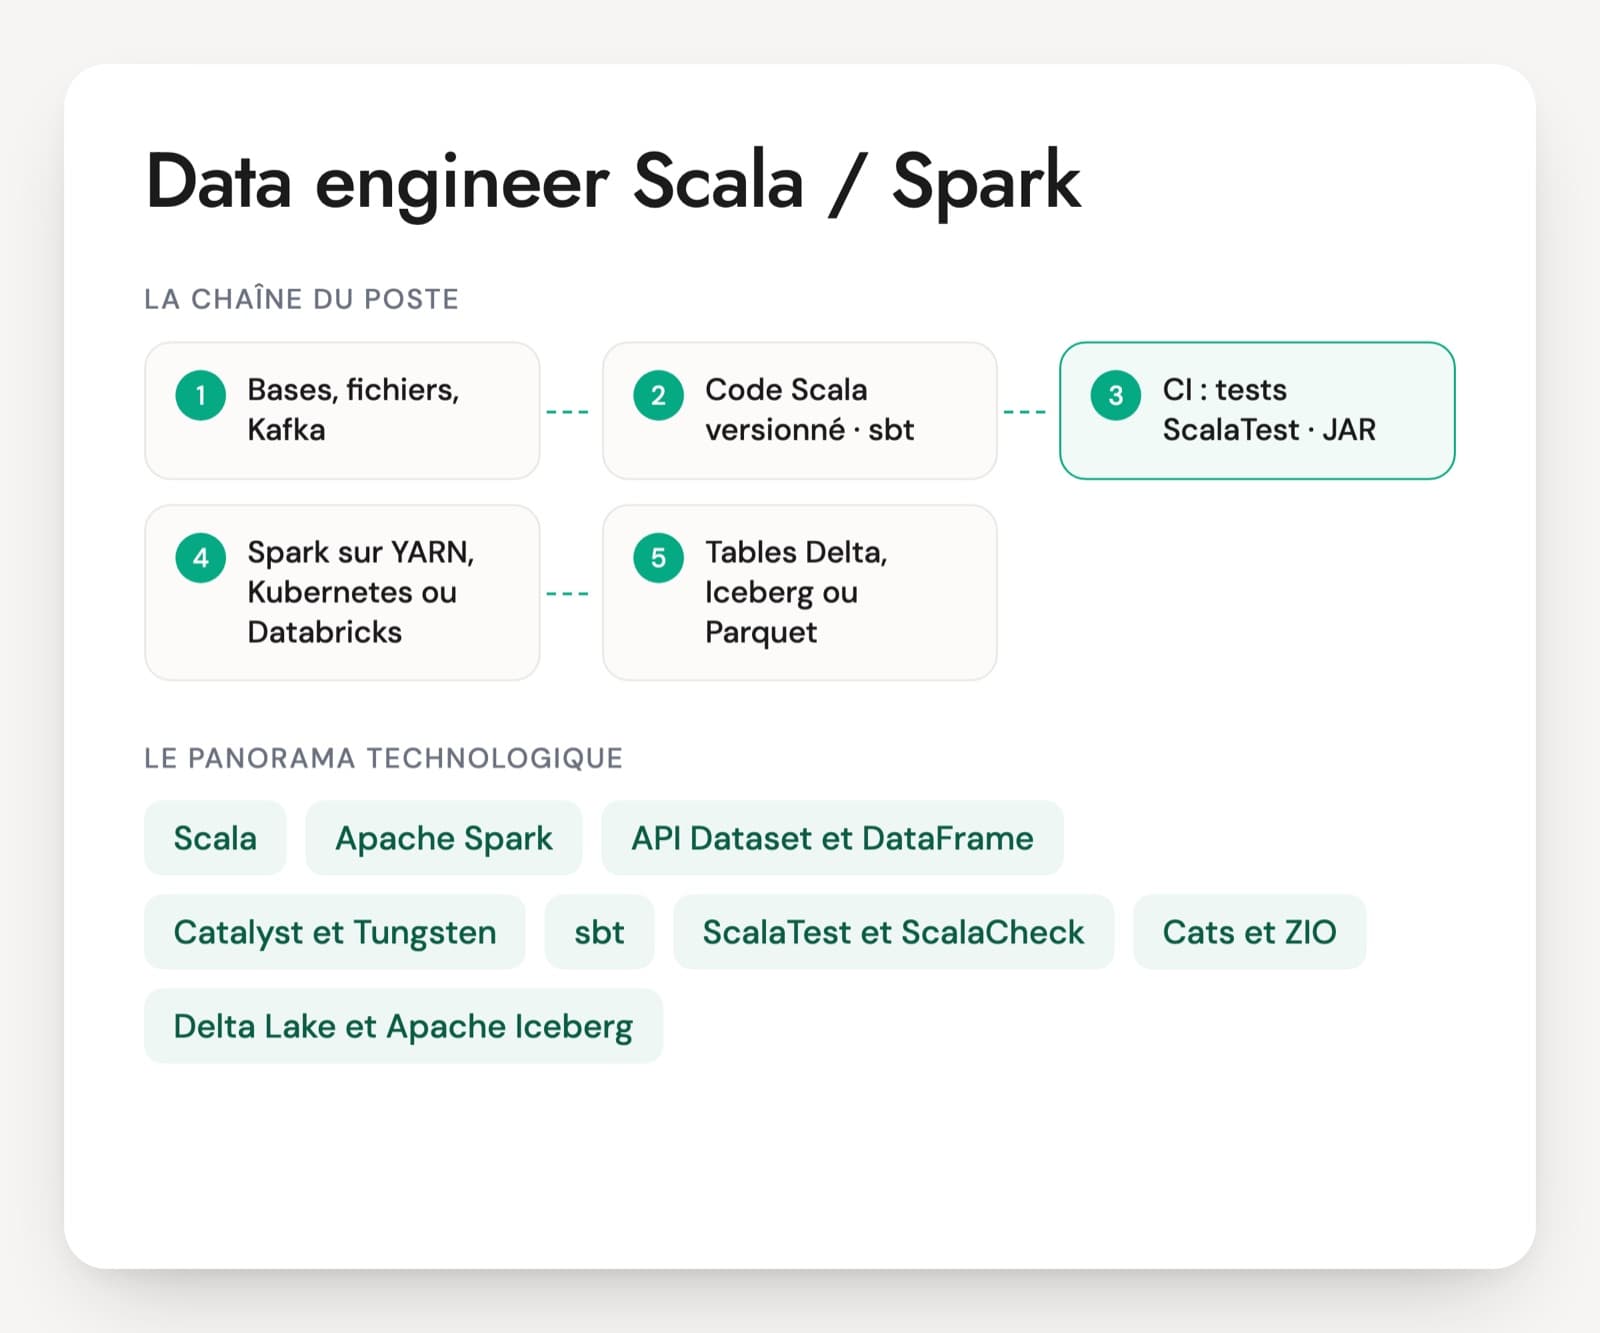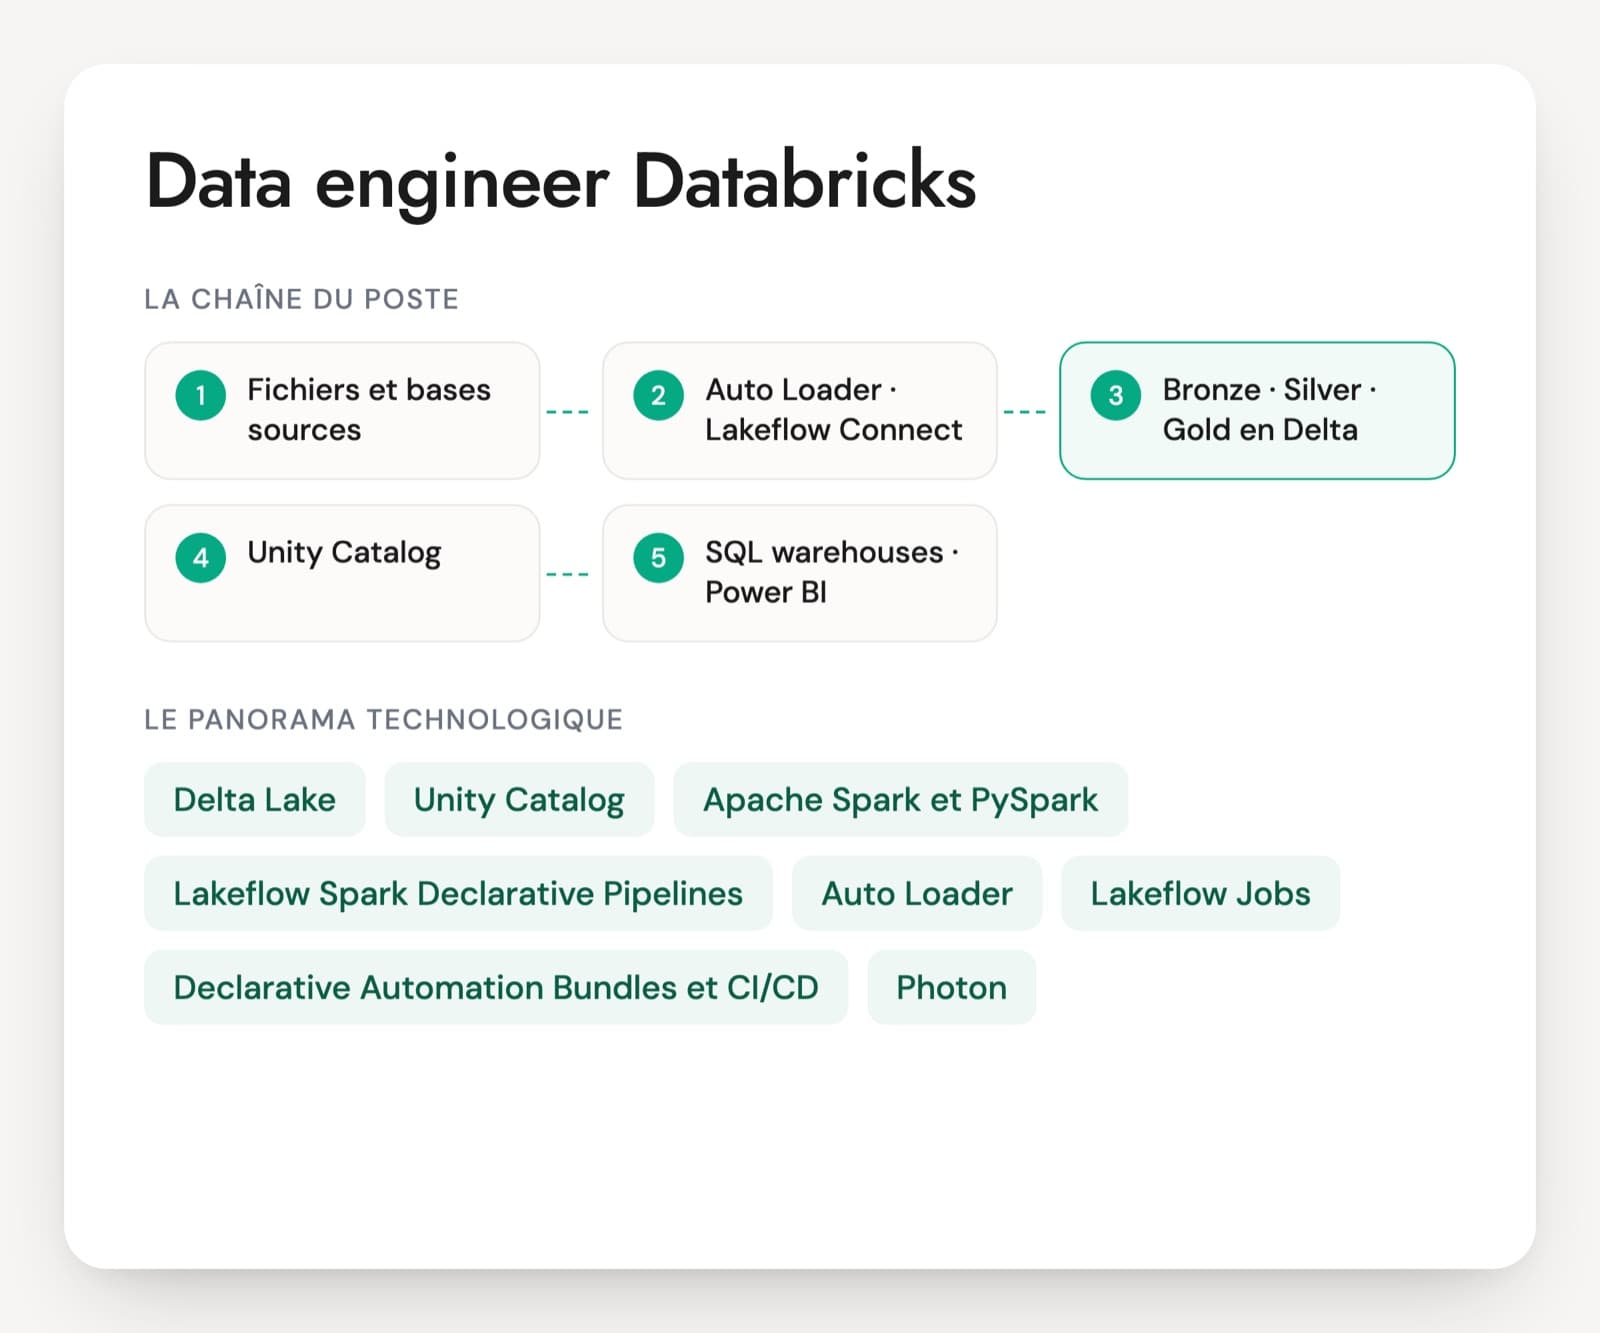
Vous préparez l'entretien technique d'un data engineer Databricks et la fiche de poste aligne Delta Lake, PySpark, Unity Catalog et Lakeflow. Les questions réunies ici partent de situations que l'on rencontre en production. En ESN, le consultant arrive souvent sur une plateforme montée par une autre équipe, sur le cloud choisi par le client. Chez un client final, le poste s'étend au suivi de la facture et à la gouvernance, avec souvent une migration vers Unity Catalog en cours.
Sur les CV, les noms changent d'une année à l'autre. Delta Live Tables s'appelle aujourd'hui Lakeflow Spark Declarative Pipelines, Workflows est devenu Lakeflow Jobs et les Asset Bundles ont été renommés en 2026. Les deux vocabulaires désignent les mêmes outils. Les certifications Associate et Professional montrent que la personne connaît les fonctionnalités. Pour juger l'expérience, faites-la parler de petits fichiers à compacter, d'une jointure déséquilibrée ou d'une facture qui a dérapé.
Un manager data peut mener l'entretien seul avec ces questions. Si vous recrutez sans profil technique à vos côtés, le PDF donne une trame complète avec 30 questions sur six axes, un cas de 20 minutes sur le chiffre d'affaires de 300 magasins attendu à 8 h et une grille de 1 à 4.
La plateforme Databricks, brique par brique
Delta Lake
Le format de table de Databricks. Les données sont des fichiers Parquet dans un stockage cloud, accompagnés d'un journal de transactions qui permet les mises à jour avec MERGE et le retour à une version antérieure (time travel). Les performances dépendent beaucoup de l'entretien des tables : compactage, liquid clustering, nettoyage des anciens fichiers. Commencez l'entretien par ce sujet.
Unity Catalog
Le catalogue central de la plateforme. Il range les données en catalogue, schéma et table, gère les droits de lecture et d'écriture et trace le lignage, c'est-à-dire quelle table en alimente quelle autre. Attendez du candidat qu'il sache séparer les environnements, filtrer des lignes et masquer des colonnes sensibles, un sujet fréquent avec le RGPD.
Apache Spark et PySpark
Le moteur de calcul distribué qui exécute les traitements sur plusieurs machines. Les équipes l'utilisent surtout en Python (PySpark) ou en SQL. Un profil confirmé sait ouvrir la Spark UI et expliquer pourquoi un job est lent ou déséquilibré, là où un junior s'arrête souvent à l'écriture du code.
Lakeflow Spark Declarative Pipelines (ex-DLT)
L'ancien Delta Live Tables, renommé en 2025. L'équipe déclare les tables à produire et leurs contrôles de qualité, et Databricks se charge de l'ordre d'exécution et du traitement incrémental. Un CV qui mentionne DLT parle du même outil. Demandez aussi dans quels cas le candidat ne l'utiliserait pas.
Auto Loader
Le composant qui ingère les fichiers déposés dans un stockage cloud au fil de l'eau. Il ne lit que les nouveaux fichiers et suit les changements de structure, par exemple une colonne ajoutée par un fournisseur. La plupart des pipelines Databricks commencent par lui.
Lakeflow Jobs (ex-Workflows)
L'orchestrateur intégré, anciennement Workflows. Il enchaîne notebooks, scripts et pipelines, à heure fixe ou à l'arrivée d'un fichier, et sait relancer uniquement les tâches en échec. Beaucoup d'équipes le combinent avec Airflow. Vérifiez que les tâches du candidat peuvent être rejouées sans créer de doublons.
Declarative Automation Bundles et CI/CD
Les bundles, appelés Databricks Asset Bundles jusqu'à leur renommage en 2026, décrivent jobs et pipelines dans des fichiers versionnés dans Git. La CI les déploie ensuite du dev vers la prod, sans copie de notebooks à la main. Un confirmé en a déjà mis en place ou s'en sert tous les jours.
Photon, SQL warehouses et serverless
Photon accélère l'exécution du SQL et des DataFrames. Les SQL warehouses répondent aux requêtes des outils de BI comme Power BI, et le serverless dispense de gérer des clusters. Ce sont aussi les postes qui font monter la facture. Le candidat doit savoir les dimensionner et les arrêter quand ils ne servent pas.
Le même intitulé recouvre des postes assez différents. En ESN, le data engineer Databricks arrive souvent en mission sur une plateforme construite par d'autres, sur Azure, AWS ou GCP selon le client, et doit comprendre vite l'existant et ses conventions. Chez un client final, il suit la facture et la gouvernance sur la durée, et la migration vers Unity Catalog ou vers les pipelines Lakeflow fait partie des chantiers fréquents. En start-up, il prend souvent aussi l'analytics engineering et la BI. Les certifications Databricks Certified Data Engineer Associate et Professional reviennent sur beaucoup de CV. Elles attestent la connaissance des fonctionnalités et du vocabulaire, l'expérience d'une plateforme en production se vérifie en entretien. Pensez enfin aux renommages de DLT, de Workflows et des Asset Bundles en lisant les CV, un candidat peut employer l'ancien nom comme le nouveau.
Les savoir-faire attendus d'un data engineer Databricks
- Delta Lake et maintenance des tables
- Optimisation Spark
- Pipelines Lakeflow et ingestion
- Gouvernance Unity Catalog
- Orchestration, CI/CD et bundles
- Calcul et maîtrise des coûts
Ce qu'il faut demander à un data engineer Databricks
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Une table Delta reçoit de nouveaux fichiers toutes les cinq minutes, et les requêtes ralentissent un peu plus chaque semaine. D'où vient le problème, et que faites-vous ?
Une bonne réponseLe candidat reconnaît le problème des petits fichiers : chaque écriture en ajoute de minuscules, que chaque requête doit ouvrir. Il le confirme avec DESCRIBE DETAIL (nombre et taille des fichiers). Il compacte avec OPTIMIZE, active l'auto compaction et les optimized writes, et met en place le liquid clustering sur les colonnes filtrées. Sur une table managée Unity Catalog, il parle de la predictive optimization, qui lance OPTIMIZE et VACUUM automatiquement.
Signal d'alerteProposer un plus gros cluster, ou partitionner par heure ou par identifiant, ce qui multiplie encore les petits fichiers.
Question 2 · confirmé
Un job Spark reste bloqué à 99 %. 199 tâches se terminent en une minute, la dernière tourne pendant quarante minutes. Qu'allez-vous regarder ?
Une bonne réponseIl pense à un déséquilibre des données (skew). Dans la Spark UI, il compare la durée et le volume de shuffle de la tâche lente avec la médiane, puis cherche la clé surreprésentée : valeurs nulles, client « inconnu », produit par défaut. Pour corriger, il cite la gestion du skew par l'Adaptive Query Execution, activée par défaut sur Databricks, un traitement à part des nulls, le salage de la clé, ou un broadcast si l'autre table est petite.
Signal d'alerteAjouter des nœuds, alors que la tâche lente tourne toujours seule sur un cœur. Ou modifier le nombre de partitions au hasard.
Question 3 · confirmé
Un fournisseur dépose des fichiers JSON toutes les heures dans un stockage cloud et ajoute parfois une colonne sans prévenir. Comment les ingérez-vous ?
Une bonne réponseAvec Auto Loader (format cloudFiles), qui ne traite que les nouveaux fichiers et garde sa position dans un checkpoint. Le schéma est inféré puis suivi dans un emplacement dédié (schemaLocation). En mode addNewColumns, celui par défaut, le flux s'arrête quand une nouvelle colonne apparaît et repart au redémarrage avec le schéma mis à jour. Les valeurs non conformes vont dans la colonne _rescued_data.
Signal d'alerteRelire tout le dossier à chaque exécution, ou tenir à la main une table des fichiers déjà traités.
Question 4 · confirmé
Vous avez trois environnements, dev, recette et prod. Comment les organisez-vous dans Unity Catalog, et qui peut écrire en prod ?
Une bonne réponseIl s'appuie sur l'espace de noms à trois niveaux (catalogue.schéma.table), avec un catalogue par environnement, parfois croisé avec les domaines métier. Chaque catalogue est rattaché aux workspaces correspondants. Les droits (USE CATALOG, USE SCHEMA, SELECT, MODIFY) vont à des groupes et jamais à des personnes. En prod, seul le service principal de la CI/CD écrit.
Signal d'alerteDes droits nominatifs, ALL PRIVILEGES pour toute l'équipe, ou un seul catalogue pour tout.
Question 5 · confirmé
Votre pipeline tourne dans le workspace de dev. Comment l'amenez-vous en prod sans copier-coller de notebooks ?
Une bonne réponseLe code est dans Git (Git folders). Un bundle (Declarative Automation Bundles, ex-Databricks Asset Bundles) décrit jobs et pipelines dans databricks.yml, avec une cible par environnement. La CI, GitLab CI, GitHub Actions ou Azure DevOps, exécute databricks bundle validate puis deploy sous un service principal, une fois les tests unitaires passés.
Signal d'alerteExporter et réimporter les notebooks à la main, ou faire tourner en prod le notebook personnel d'un développeur.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Questions fréquentes sur le recrutement d'un data engineer Databricks
Quel niveau attendre d'un data engineer Databricks confirmé ?
La base reste PySpark et SQL, Delta Lake avec MERGE et la maintenance des tables, et la lecture de la Spark UI. S'y ajoutent l'ingestion avec Auto Loader ou les pipelines Lakeflow, la gestion des droits dans Unity Catalog et le déploiement par bundles depuis une CI. Selon la mission, comptez aussi le cloud du client (Azure, AWS ou GCP) et un orchestrateur comme Airflow. Un senior doit en plus savoir expliquer et réduire une facture.
La certification Databricks suffit-elle pour juger un candidat ?
Les certifications Data Engineer Associate et Professional prouvent que la personne connaît les fonctionnalités et le vocabulaire de la plateforme. Elles ne disent pas si elle a déjà diagnostiqué un job lent, retraité une table en production ou expliqué une hausse de facture à son manager. Lisez-la comme un bon signe sur le CV, puis posez des questions de mise en situation pour vérifier l'expérience.
Quel test technique donner à un data engineer Databricks ?
Le plus utile est un exercice court proche du poste. Un cas d'architecture discuté à l'oral, par exemple une chaîne qui va de fichiers déposés chaque nuit jusqu'à un tableau de bord Power BI, montre comment la personne raisonne sur l'ingestion, la qualité et les droits. Pour un profil junior, un petit exercice PySpark sur un jeu de données fourni suffit. Évitez les longs devoirs à la maison, qui découragent les candidats déjà en poste.
Un data engineer Spark venu de Hadoop est-il opérationnel sur Databricks ?
En partie. Spark est le moteur de calcul. Databricks est une plateforme qui l'intègre avec Delta Lake, Unity Catalog, les pipelines Lakeflow, un orchestrateur et des SQL warehouses. Un data engineer Spark qui vient de Hadoop ou d'EMR maîtrise le calcul, mais découvre parfois la gouvernance, le serverless et la facturation à l'usage de Databricks. Demandez-lui sur quelle plateforme il a travaillé et qui s'occupait des droits et des coûts.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.