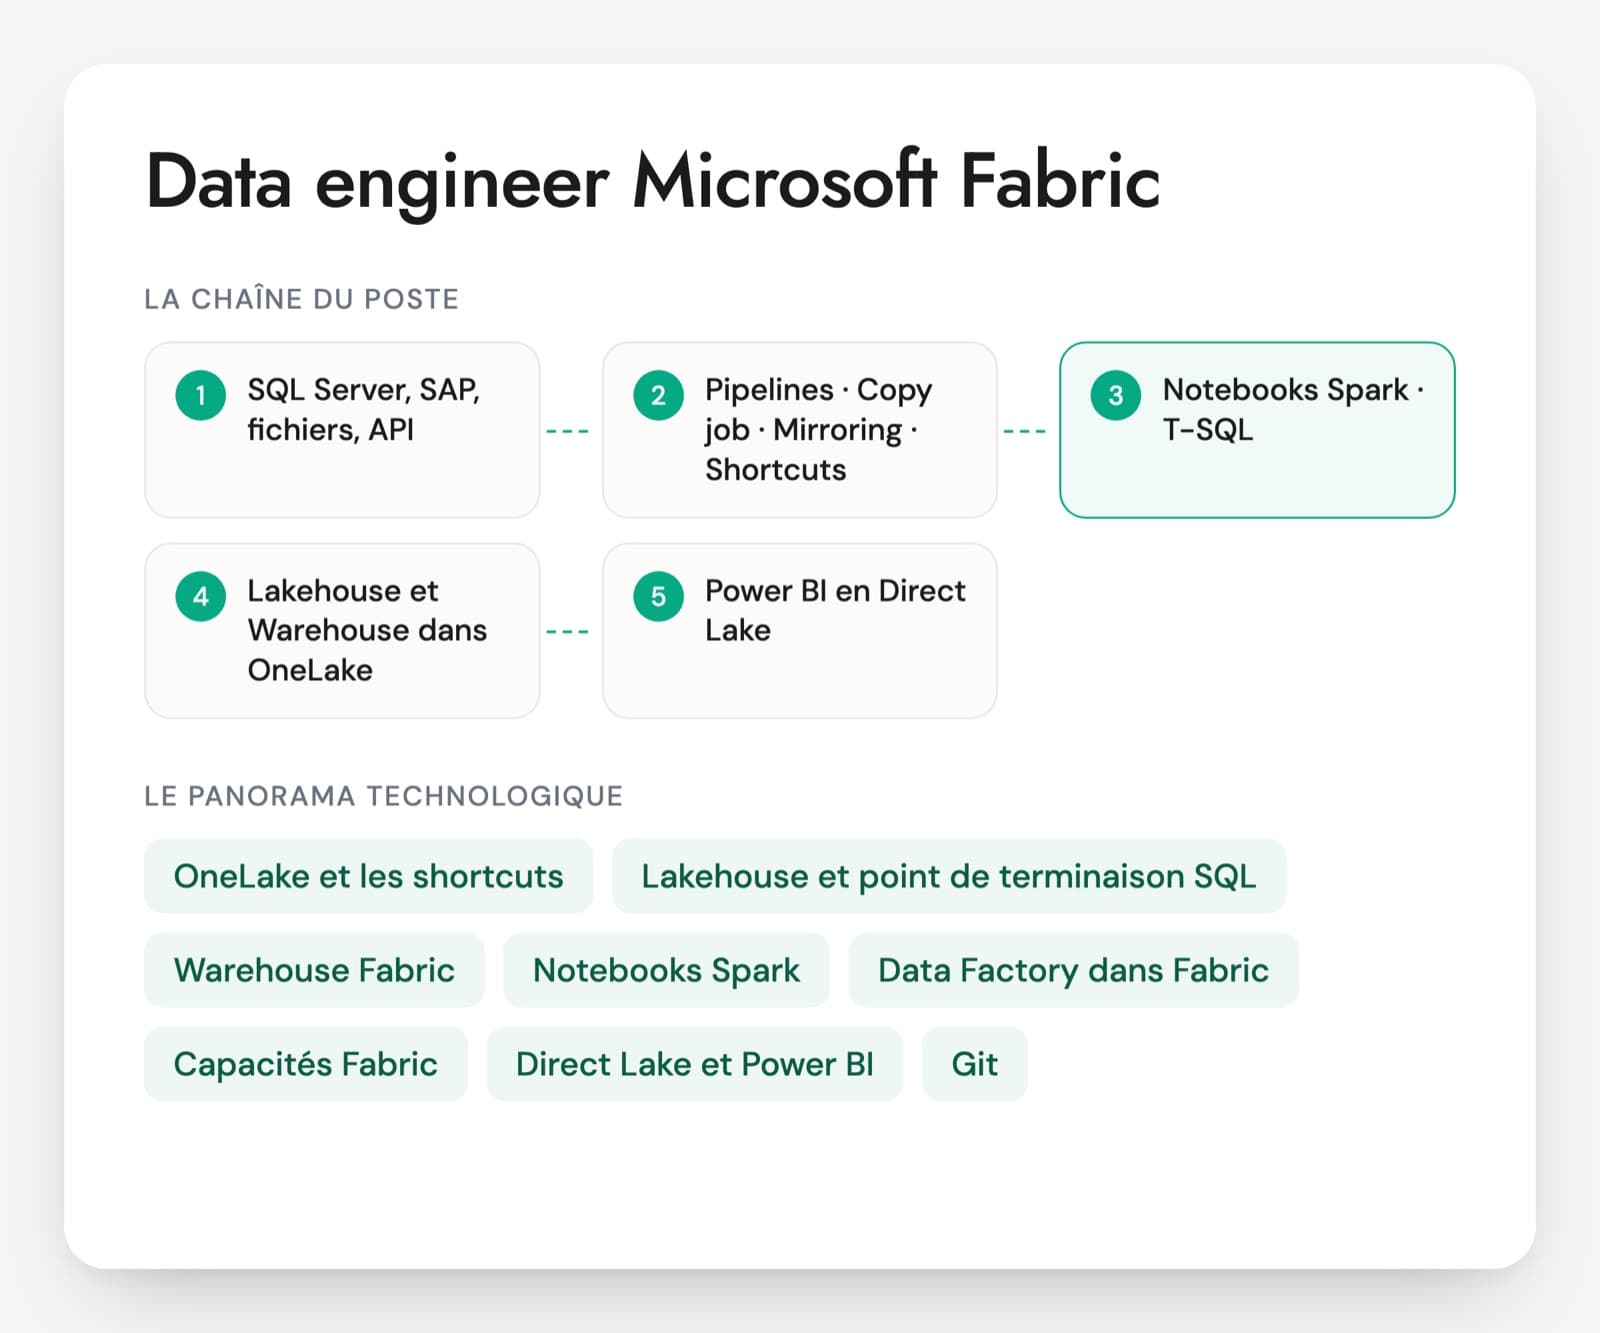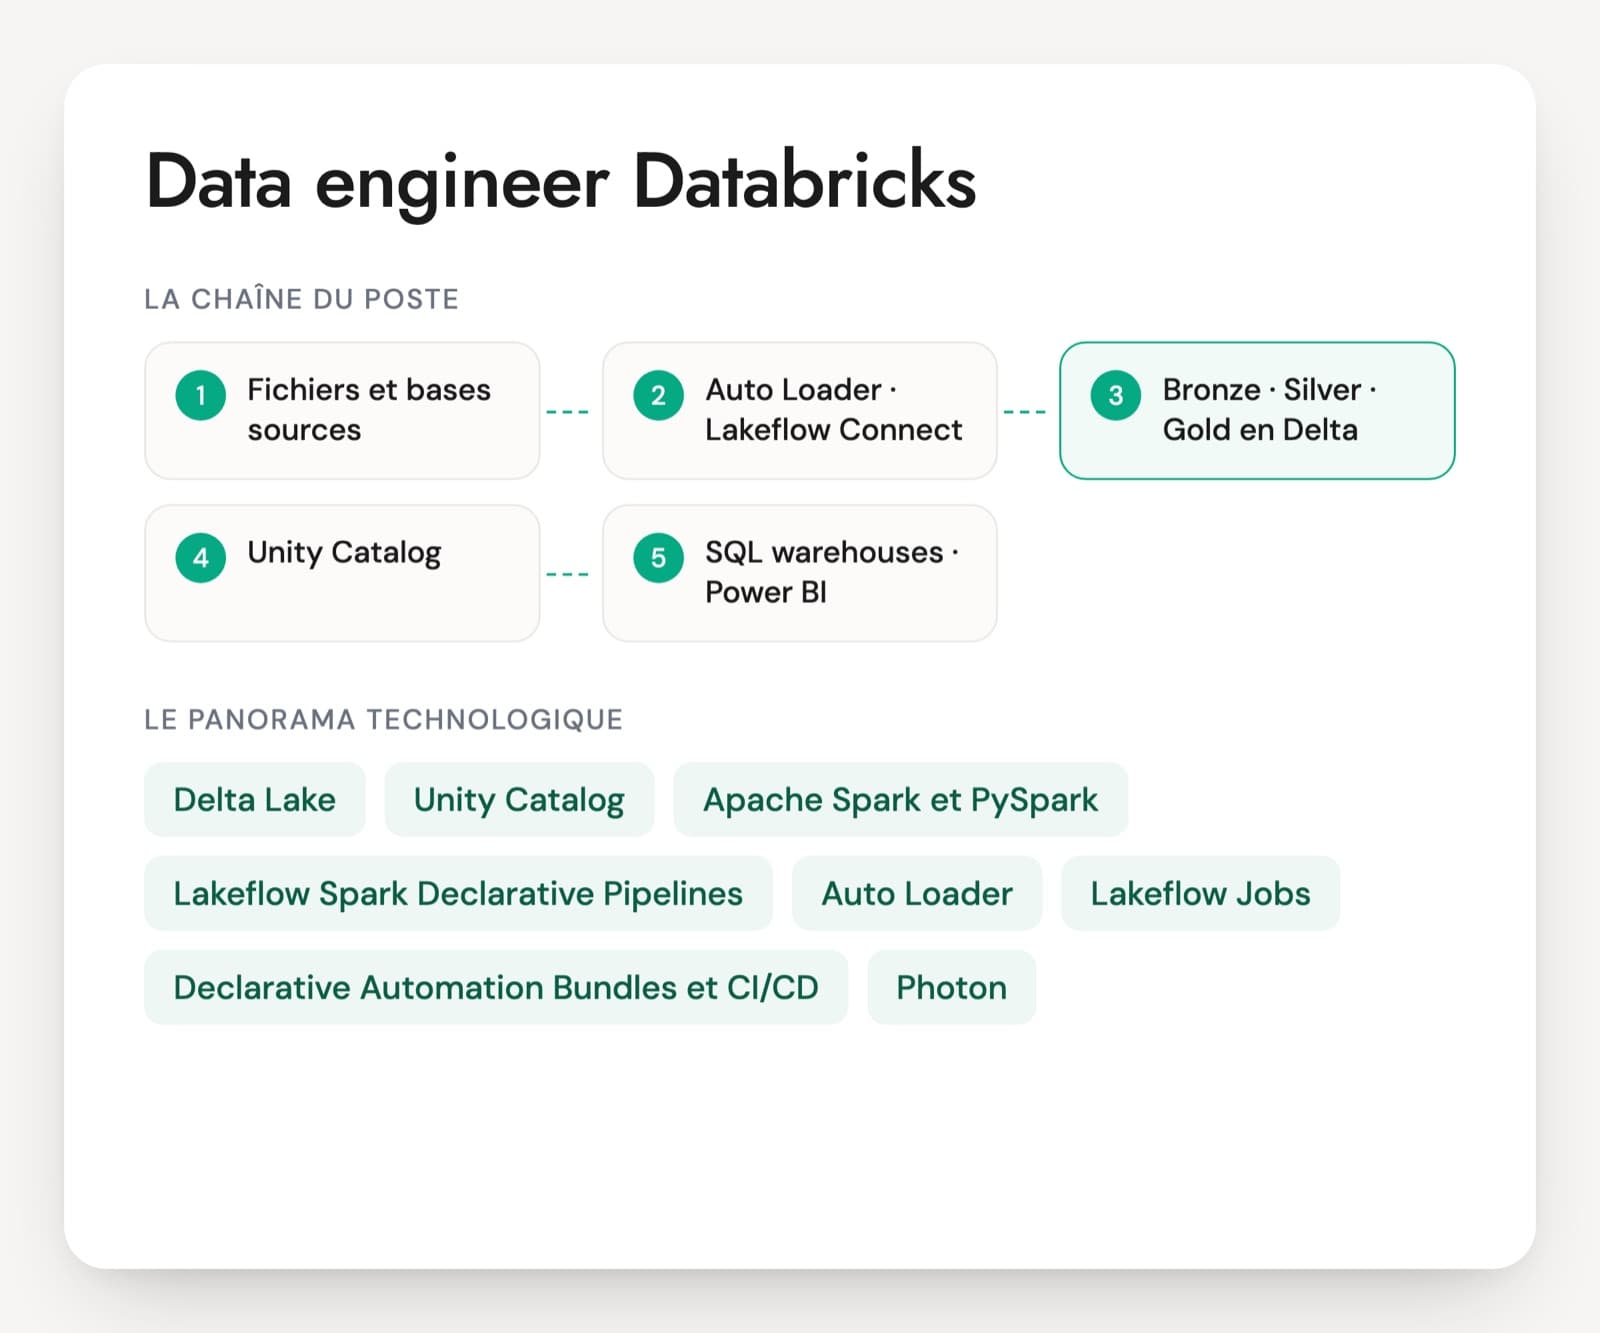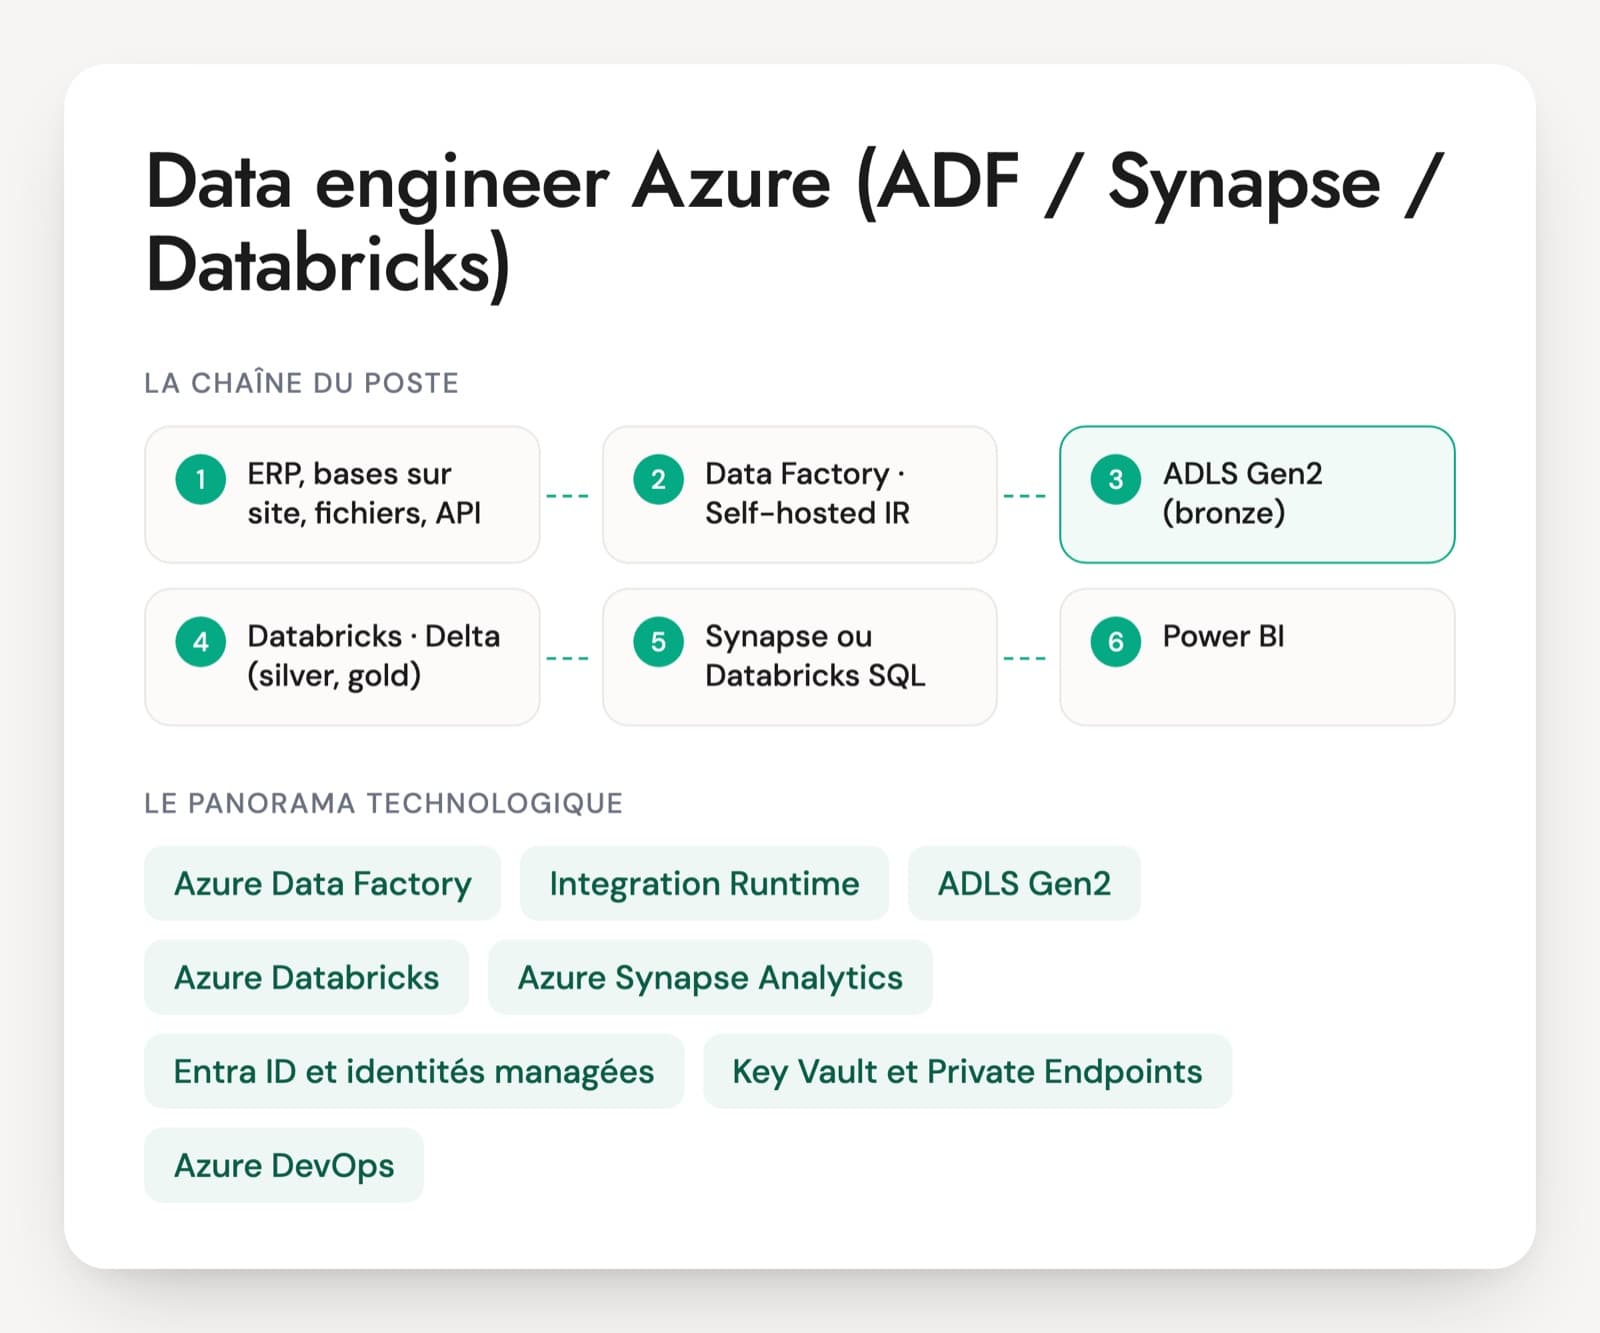
Le quotidien d'un data engineer Azure fournit les meilleures questions. Les flux passent par Azure Data Factory, les données sont stockées dans ADLS Gen2 puis transformées dans Azure Databricks ou Synapse, et l'ensemble est sécurisé avec Entra ID, Key Vault et des Private Endpoints. En France, le profil est surtout recherché par les grands comptes et les ETI dont la plateforme tourne sur Azure, en banque, assurance, industrie, distribution ou dans le secteur public. En ESN, la mission démarre souvent sur une plateforme existante aux règles réseau déjà posées.
Le CV mélange souvent Azure et Fabric. Les deux se ressemblent dans le discours, mais Synapse repose sur des ressources Azure séparées alors que Fabric est un service SaaS unifié. La DP-203, encore très présente sur les CV, a été retirée en mars 2025. Databricks a aussi renommé Delta Live Tables. Un profil passé par la production parle d'Integration Runtime, de DNS privé et d'identités managées, parce que c'est là que surviennent les pannes.
Sur Azure, le premier incident arrive souvent par le réseau ou par une identité mal configurée. Le PDF part de là, avec un cas de 20 minutes sur la plateforme data d'un distributeur en réseau privé, 30 questions sur six axes et une grille de notation de 1 à 4.
La stack Azure d'un data engineer, service par service
Azure Data Factory (ADF)
L'outil d'intégration et d'orchestration d'Azure. Il se connecte aux bases, aux fichiers, aux API et aux applications, copie les données et enchaîne les traitements sans serveur à gérer. Les pipelines se construisent surtout dans une interface graphique et se versionnent dans Git. Vérifiez que la personne maîtrise le chargement incrémental et l'accès à une source sur site.
Integration Runtime
Le moteur qui exécute les copies d'ADF. L'Azure IR tourne dans le cloud. Le Self-hosted IR s'installe sur un serveur de l'entreprise pour atteindre les bases du datacenter. Les problèmes de réseau et de performance se logent souvent à cet endroit.
ADLS Gen2
Le stockage du data lake, un compte de stockage Azure avec de vrais répertoires et des droits par dossier (ACL). Les données y sont rangées par couches, de la donnée brute à celle prête pour les rapports, le plus souvent en Parquet ou en Delta.
Azure Databricks
La plateforme Spark la plus répandue sur Azure, pour transformer de gros volumes en PySpark ou en SQL. Les tables sont au format Delta, qui gère les mises à jour et l'historique. Unity Catalog centralise les droits, le catalogue et la traçabilité. Vérifiez que la personne sait optimiser un traitement, au-delà de l'écriture d'un notebook.
Azure Synapse Analytics
L'entrepôt de données historique de Microsoft. Le pool SQL dédié est un moteur parallèle à capacité réservée, le pool SQL serverless interroge à la demande les fichiers du lake. Synapse reste très présent dans les grands comptes, même si Microsoft oriente les nouveaux projets vers Fabric.
Entra ID et identités managées
Entra ID, l'ancien Azure Active Directory, gère les identités. Les identités managées donnent à ADF ou à Databricks un accès au stockage sans mot de passe dans le code. Demandez la différence entre droits sur la ressource et droits sur les données. Beaucoup de candidats les confondent.
Key Vault et Private Endpoints
Key Vault stocke les secrets, les clés et les certificats. Les Private Endpoints font passer le trafic vers le stockage ou le Key Vault par le réseau interne. Dans la banque, l'assurance et l'industrie, ce réseau privé est imposé et provoque une bonne part des pannes.
Azure DevOps, Terraform ou Bicep
Azure DevOps ou GitHub héberge le code et les pipelines de déploiement. Terraform ou Bicep décrit l'infrastructure sous forme de code. Un profil confirmé fait passer un pipeline ADF ou un job Databricks de la recette à la production sans clic manuel.
On rencontre ce profil surtout dans les grands comptes et les ETI dont la plateforme repose sur Azure PaaS, en banque, assurance, industrie, distribution ou secteur public. En ESN, le data engineer Azure arrive sur une plateforme existante, avec ses règles de réseau et de sécurité, et doit s'y retrouver vite. Chez un client final, il maintient souvent un mélange d'ADF, de Synapse et de Databricks, parfois avec de vieux packages SSIS. Le poste diffère de celui de data engineer Microsoft Fabric, car ici chaque service est une ressource Azure séparée avec son réseau et ses droits, alors que Fabric est un service SaaS unifié. La DP-203 (Azure Data Engineer Associate), très présente sur les CV, a été retirée le 31 mars 2025 et ne peut plus être obtenue ni renouvelée. Microsoft oriente désormais vers la DP-700, centrée sur Fabric. Les certifications Databricks Data Engineer Associate ou Professional complètent souvent le profil, sans dispenser de vérifier l'expérience de production en entretien.
Où un data engineer Azure doit se montrer solide
- Pipelines Azure Data Factory
- Spark et Delta sur Azure Databricks
- Entrepôt Synapse (dédié, serverless)
- Organisation du data lake ADLS
- Sécurité Entra ID et réseau privé
- CI/CD, supervision et coûts
Questions techniques sur une plateforme Azure en production
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Chaque nuit, vous devez copier vers ADLS les lignes modifiées d'une base SQL Server hébergée dans le datacenter du client. Comment montez-vous ce pipeline Data Factory ?
Une bonne réponseUn Self-hosted Integration Runtime installé sur un serveur du réseau client, puisque l'Azure IR ne voit pas une base sur site. Une copie incrémentale : une Lookup lit le dernier filigrane (watermark) dans une table de contrôle, la Copy activity filtre sur la date de modification, puis le filigrane est mis à jour. Le CDC de SQL Server prend le relais si la table n'a pas de date fiable. Les identifiants restent dans Key Vault, référencé par le linked service, et les fichiers sont écrits en Parquet, rangés par date de chargement.
Signal d'alerteUne copie complète de la table chaque nuit sans réfléchir au volume, ou un mot de passe en clair dans le linked service.
Question 2 · senior
Sur Azure Databricks, un MERGE sur une table Delta de deux milliards de lignes prend trois heures. Où cherchez-vous ?
Une bonne réponseDans le plan de la requête et l'interface Spark, pour voir combien de fichiers sont lus et réécrits. Ensuite une condition de MERGE qui permet d'écarter des fichiers (filtre sur la date ou la partition), une organisation des données adaptée à la clé (liquid clustering ou Z-order), des fichiers de taille raisonnable après OPTIMIZE, un déséquilibre de clés côté source, ou des doublons dans la source qui font échouer ou gonfler le MERGE. Photon et la taille du cluster viennent seulement après.
Signal d'alerte« On double le cluster » en premier réflexe, ou ignorer qu'un MERGE réécrit en entier chaque fichier qui contient une ligne modifiée.
Question 3 · confirmé
Dans un pool SQL dédié Synapse, comment distribuez-vous une table de faits de 800 millions de lignes et ses dimensions ?
Une bonne réponseLa table de faits en hash sur une colonne à forte cardinalité, bien répartie et utilisée dans les jointures, pour limiter les mouvements de données entre les 60 distributions. Les petites dimensions répliquées, les tables de transit en round robin. Un bon profil contrôle le déséquilibre après chargement et sait que le moteur ne vérifie pas les clés primaires.
Signal d'alerteUn hash sur une date ou sur une colonne pleine de valeurs nulles, ou ignorer que le pool SQL dédié est un moteur massivement parallèle.
Question 4 · confirmé
L'accès public est coupé sur le Storage et sur le Key Vault, et votre pipeline ADF tombe en erreur d'autorisation. Que vérifiez-vous ?
Une bonne réponseLe réseau d'abord : un Integration Runtime dans un réseau virtuel managé avec des managed private endpoints créés et approuvés côté ressource, ou un Self-hosted IR dans le réseau de l'entreprise, et une résolution DNS vers l'adresse privée. Puis les droits : l'identité managée de la fabrique a besoin d'un rôle sur les données, comme Storage Blob Data Contributor, et d'un accès aux secrets du Key Vault. Un profil expérimenté sait aussi qu'ADLS Gen2 peut demander deux points de terminaison privés, dfs et blob.
Signal d'alerteRouvrir l'accès public « pour tester », ou attribuer le rôle Contributor sur le compte de stockage en croyant qu'il donne accès aux fichiers.
Question 5 · junior à confirmé
Sur un projet ADF et Databricks, qu'est-ce que vous confiez à Data Factory et qu'est-ce que vous gardez pour Databricks ?
Une bonne réponseADF orchestre et copie : connexion aux sources, ingestion brute, lancement des notebooks ou des jobs Databricks, gestion des reprises. Databricks porte les transformations, en PySpark ou en SQL, sur des tables Delta. Les mapping data flows d'ADF tournent eux aussi sur Spark et dépannent pour des transformations simples quand l'équipe ne code pas.
Signal d'alerteDes règles métier éparpillées dans des dizaines d'activités ADF imbriquées, ou un cluster Databricks démarré juste pour copier un fichier.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
DP-203, Fabric et format d'évaluation pour un data engineer Azure
Sur quels services Azure interroger un data engineer ?
Azure Data Factory pour l'ingestion et l'orchestration, Spark et Delta sur Azure Databricks, un SQL avancé et, selon le contexte, les pools Synapse. Sur les plateformes de banque ou d'assurance, la sécurité pèse lourd, avec les identités managées, Key Vault, les Private Endpoints et la résolution DNS privée. Ajoutez le déploiement par Azure DevOps ou GitHub avec Terraform ou Bicep. Pour un poste en run, demandez comment la personne supervise ses pipelines et suit les coûts.
La certification DP-203 a-t-elle encore une valeur sur un CV ?
Microsoft a retiré la DP-203 le 31 mars 2025. Elle ne peut plus être passée ni renouvelée, mais une certification obtenue avant cette date reste un indice de connaissance des services data d'Azure. La DP-700, qui lui succède, porte sur Microsoft Fabric. Les certifications Databricks complètent souvent le profil. Pour l'expérience de production, appuyez-vous sur des questions de diagnostic comme celles de cette page.
Un data engineer Azure travaille-t-il comme un data engineer Fabric ?
Le data engineer Azure travaille sur des ressources séparées, Data Factory, ADLS Gen2, Databricks ou Synapse, chacune avec son réseau, ses droits et sa facturation. Le data engineer Fabric travaille dans un service SaaS unifié. Les compétences se recoupent sur Spark, SQL et la modélisation. Le réseau privé, les Private Endpoints et l'infrastructure as code pèsent beaucoup plus côté Azure. Lisez le CV en cherchant quels services ont vraiment été exploités en production.
Comment construire l'entretien technique d'un data engineer Azure ?
Plutôt qu'un long test technique sur des définitions, partez de cas concrets. Un chargement incrémental depuis une base sur site, un MERGE Delta trop lent ou une erreur d'autorisation derrière un réseau privé font vite apparaître les réflexes de production. Notez chaque thème sur la même grille pour comparer les candidats. Une mise en situation de 20 minutes complète bien les questions, et la fiche PDF de Delectus AI en propose une avec sa grille de notation.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.