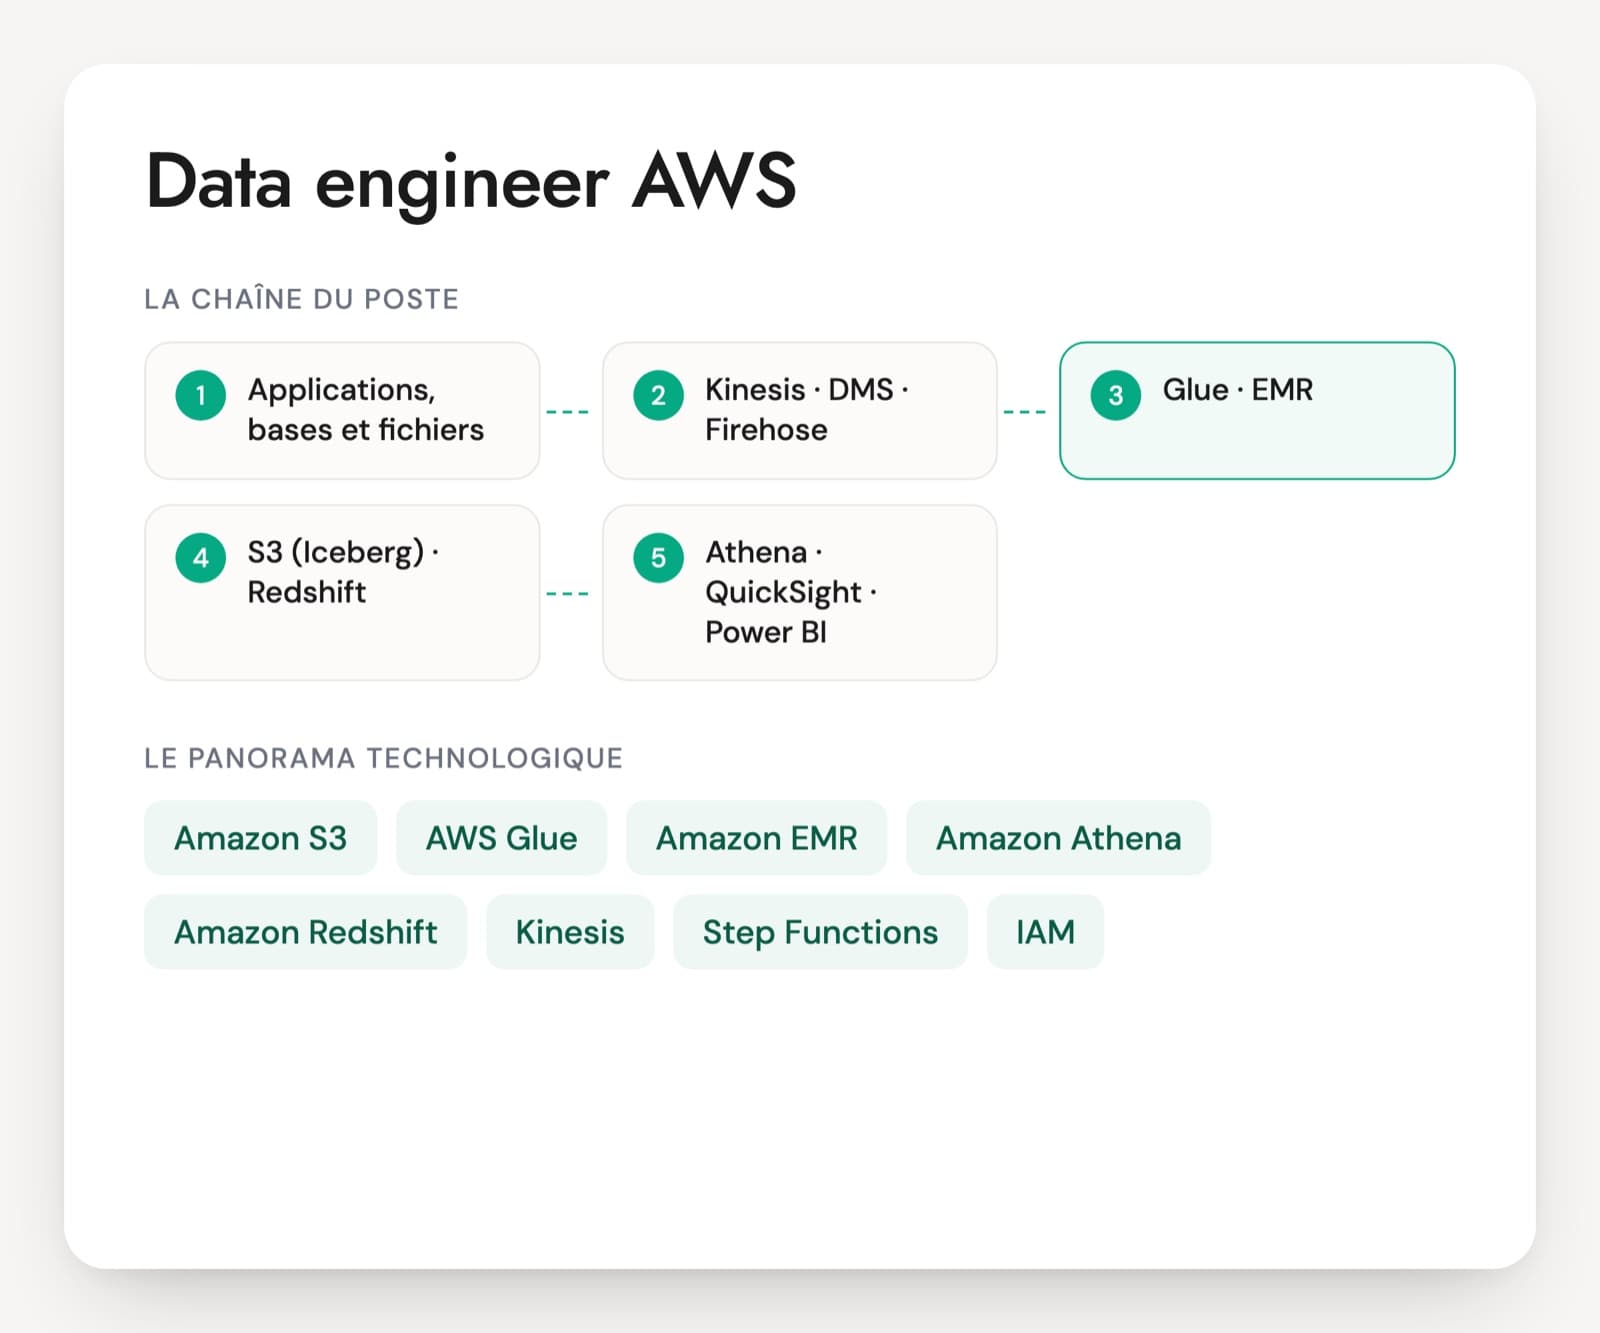
Un data engineer AWS passe ses journées entre S3, Glue et Redshift. Il dépose les données brutes dans S3, les transforme avec des jobs Glue écrits en PySpark ou sur EMR, puis les rend interrogeables par Athena ou les charge dans Redshift. Step Functions ou Airflow orchestrent les traitements, Kinesis ou MSK portent le temps réel. Les offres récentes de Free-Work citent aussi Apache Iceberg, Lake Formation et dbt. En ESN, la mission consiste souvent à industrialiser un data lake monté vite ; chez un client final, à en tenir la facture.
La liste des services AWS s'allonge sans effort sur un CV. Elle ne dit pas si la personne a conçu un job incrémental ou seulement lancé un crawler depuis la console. La certification AWS Certified Data Engineer Associate atteste une connaissance large de l'écosystème. En entretien, la pratique se repère à des détails concrets, comme la taille des fichiers Parquet, une clé de distribution Redshift, un bookmark Glue remis à zéro ou un rôle IAM taillé pour un seul pipeline.
Le PDF complète la page avec l'entretien entier : 30 questions sur six axes techniques, une grille de 1 à 4 et un cas de 20 minutes sur les scans de colis d'un transporteur, à transformer en tableau de bord des retards.
De S3 à Redshift, les services d'un data engineer AWS
Amazon S3
Le stockage de fichiers qui sert de data lake. Les données y sont rangées par zones, brute puis nettoyée puis prête à l'usage, et par dossiers de date. Le format et la taille des fichiers décident de la vitesse et du coût de tout ce qui vient après. Des règles de cycle de vie archivent ou suppriment les anciens fichiers, ce qui compte pour la facture comme pour le RGPD.
AWS Glue
Deux outils sous le même nom. Le Data Catalog décrit les tables du data lake et sert de référence commune à Athena, EMR et Redshift. Les jobs Glue exécutent du Spark sans serveur à gérer, facturés à la DPU-heure. Glue 6.0, sorti en août 2026, passe à Spark 4.1 avec un tarif plus bas, mais beaucoup de CV parlent encore de Glue 3 ou 4.
Amazon EMR
Spark, Hadoop, Trino ou Flink managés par AWS, sur des machines EC2 ou en mode serverless. On le choisit pour les traitements lourds ou longs, pour garder la main sur la configuration, ou pour réduire le coût avec des instances spot. On le croise aussi après la migration d'un cluster Hadoop sur site.
Amazon Athena
Le moteur SQL qui interroge directement les fichiers de S3, sans serveur. Chaque requête est facturée au volume lu : des fichiers Parquet partitionnés par date coûtent bien moins cher que du JSON brut. Athena sait aussi lire et modifier des tables Apache Iceberg, ce qui permet des MERGE et des suppressions ciblées.
Amazon Redshift
L'entrepôt de données d'AWS, en cluster provisionné ou en version Serverless. Les performances dépendent de la façon dont les tables sont réparties entre les nœuds (clé de distribution) et triées (clé de tri). Les données arrivent par la commande COPY depuis S3, ou par une intégration zero-ETL depuis Aurora. Redshift Spectrum lit aussi les fichiers restés dans S3.
Kinesis, Firehose et MSK
Les briques du temps réel. Kinesis Data Streams transporte des événements découpés en shards. Amazon Data Firehose, l'ancien Kinesis Data Firehose, les dépose dans S3 ou Redshift par paquets, sans code. MSK héberge Apache Kafka pour les équipes qui en ont déjà l'usage.
Step Functions, Lambda et MWAA
L'orchestration. Step Functions enchaîne les étapes d'un pipeline sous forme de machine à états, Lambda exécute des tâches courtes de quinze minutes au plus, et MWAA héberge Apache Airflow. Demandez comment la personne relance une journée passée dans l'outil qu'elle cite.
IAM, KMS et Lake Formation
La sécurité de la plateforme. IAM attribue un rôle à chaque job, KMS chiffre les données avec des clés dont on contrôle l'usage, et Lake Formation règle qui lit quelle table, quelle colonne ou quelles lignes. La plupart des incidents de sécurité sur un data lake AWS viennent de droits trop larges posés ici.
Le poste change selon l'employeur. En ESN, le data engineer AWS arrive sur un data lake qu'il n'a pas construit et doit vite comprendre l'organisation des comptes, des buckets et des droits. Chez un client final, il garde ses pipelines plusieurs années et répond de leur coût. En start-up, il fait souvent aussi de la modélisation avec dbt sur Redshift ou Athena. Les grands comptes lancent des migrations depuis Hadoop sur site vers EMR, ou depuis Teradata et Oracle vers Redshift, et certaines offres récentes citent SageMaker Unified Studio comme point d'entrée des équipes data. La certification AWS Certified Data Engineer Associate, valable trois ans, couvre l'ingestion, la transformation, le stockage, l'exploitation et la sécurité. L'expérience de production, elle, se vérifie en entretien.
Les services et réflexes AWS à couvrir en entretien
- Data lake S3 et formats de fichiers
- Jobs Spark sur Glue et EMR
- Redshift et Athena : modélisation et coûts
- Ingestion temps réel et CDC
- IAM, KMS et Lake Formation
- Orchestration, qualité et run
Cinq situations de production pour un data engineer AWS
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Un job Glue relit chaque nuit tout l'historique stocké dans S3, alors que seules les données de la veille changent. Que modifiez-vous ?
Une bonne réponseIl active les job bookmarks, qui mémorisent les fichiers déjà traités, ou il filtre explicitement sur les partitions de date avec un prédicat poussé au catalogue (push down predicate). En sortie, il réécrit seulement la partition du jour (écrasement dynamique des partitions) ou fusionne le delta dans une table Iceberg avec un MERGE. Il vérifie le gain dans les métriques du job, en DPU-heures consommées.
Signal d'alerte« On ajoute des DPU » pour que le job aille plus vite, ou relire tout l'historique puis dédupliquer à la fin. Une réponse qui ignore l'existence des bookmarks.
Question 2 · confirmé
Athena met une minute et coûte cher sur un dossier S3 qui contient deux millions de petits fichiers JSON. Que faites-vous ?
Une bonne réponseIl convertit la couche lue par Athena en Parquet, un format en colonnes et compressé, et compacte les fichiers pour dépasser 128 Mo chacun, seuil sous lequel la documentation Athena signale une perte de performance. Il partitionne par date et déclare les partitions par projection pour éviter de les lister. À la source, il règle le tampon de Firehose ou la taille des écritures du job. Une table Iceberg avec compaction planifiée règle le problème dans la durée.
Signal d'alerte« On passe tout dans Redshift » sans diagnostic, ou ignorer qu'Athena facture le volume lu par chaque requête.
Question 3 · confirmé
Dans Redshift, une jointure entre la table des ventes et celle des clients ralentit tous les tableaux de bord. Où regardez-vous ?
Une bonne réponseDans le plan d'exécution (EXPLAIN) : des étapes DS_BCAST_INNER ou DS_DIST_BOTH montrent que les lignes voyagent entre les nœuds. Il propose une distribution KEY sur la colonne de jointure pour les deux grosses tables, ou ALL pour une petite dimension, une clé de tri sur la date filtrée, et des statistiques à jour. Il connaît l'optimisation automatique des tables et consulte les vues système comme SYS_QUERY_HISTORY pour repérer les requêtes lentes.
Signal d'alerte« On ajoute un index », alors que Redshift n'en a pas, ou « on agrandit le cluster » sans avoir lu le plan.
Question 4 · senior
Vous devez répliquer en continu une base Aurora PostgreSQL vers le data lake sans la ralentir. Comment faites-vous ?
Une bonne réponseUne capture des changements (CDC) qui lit le journal de la base au lieu d'interroger les tables : AWS DMS avec la réplication logique de PostgreSQL, vers S3 ou vers Kinesis. Une charge complète d'abord, puis le flux continu. Il garde la nature de chaque opération pour appliquer les suppressions, fusionne dans une table Iceberg avec un MERGE et prévoit les changements de schéma. Si la cible est Redshift, il cite l'intégration zero-ETL comme alternative.
Signal d'alerteUn SELECT complet toutes les cinq minutes, ou un filtre sur une colonne updated_at qui laisse passer les suppressions.
Question 5 · confirmé
Comment un job Glue obtient-il l'accès à un bucket S3 chiffré, et qui d'autre peut lire ces données ?
Une bonne réponseLe job tourne avec un rôle IAM qui lui est propre, limité au bucket et aux préfixes dont il a besoin. La politique de la clé KMS autorise ce rôle à déchiffrer. Aucune clé d'accès n'apparaît dans le code. Pour les autres lecteurs, Lake Formation accorde des droits par base, table ou colonne aux analystes, souvent par étiquettes (LF-tags). CloudTrail garde la trace des accès.
Signal d'alerteUn rôle avec AdministratorAccess ou s3:* sur toutes les ressources, des clés d'accès collées dans le script, ou « le bucket est privé, donc c'est bon ».
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Services AWS à exiger et place de la certification
Quels services AWS un data engineer doit-il vraiment connaître ?
S3 et le Glue Data Catalog sont présents sur presque toutes les plateformes. Ajoutez Spark, via Glue ou EMR, Athena ou Redshift selon l'architecture, et IAM. Le reste dépend du poste : Kinesis, MSK ou DMS pour l'ingestion, Step Functions ou MWAA pour l'orchestration, Lake Formation pour la gouvernance, Terraform ou CDK pour l'infrastructure. Le socle reste un bon niveau en SQL et en Python. Demandez quels services la personne a fait tourner en production, pas ceux qu'elle a essayés.
Que vaut la certification AWS Data Engineer Associate sur un CV ?
Lancée en 2024 sous le code d'examen DEA-C01, elle couvre l'ingestion, la transformation, le stockage, l'exploitation et la sécurité des données sur AWS. Elle est valable trois ans, ce qui permet de voir si elle est récente. Elle prouve une connaissance large des services, pas la conduite d'une plateforme. Demandez un job Glue optimisé, une facture Athena réduite ou un incident résolu. Sans exemple concret, un profil certifié reste à confirmer par une mise en situation.
Glue ou EMR : faut-il exiger les deux ?
Rarement. Les deux exécutent du Spark. Glue évite d'administrer un cluster et convient aux traitements réguliers de taille moyenne. EMR laisse plus de contrôle, accepte d'autres moteurs comme Flink ou Trino et devient intéressant pour les traitements longs, avec des instances spot. Une personne solide en PySpark sur Glue passe sur EMR sans grande difficulté. Ce qui compte, c'est la compréhension de Spark : partitions, shuffle, taille des fichiers. Exigez EMR seulement si votre plateforme en dépend beaucoup.
Test technique sur un compte AWS : bonne ou mauvaise idée ?
Monter un compte de test prend du temps, coûte de l'argent et mesure surtout l'aisance dans la console. Un exercice commenté en entretien technique en dit davantage. Montrez la liste des fichiers d'un dossier S3 et une requête Athena lente, ou un script Glue qui relit tout l'historique, et demandez à la personne de raisonner à voix haute. Vous voyez en quelques minutes si elle pense volume lu, partitions et reprise, et une réponse préparée d'avance tient mal face à un cas réel.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.