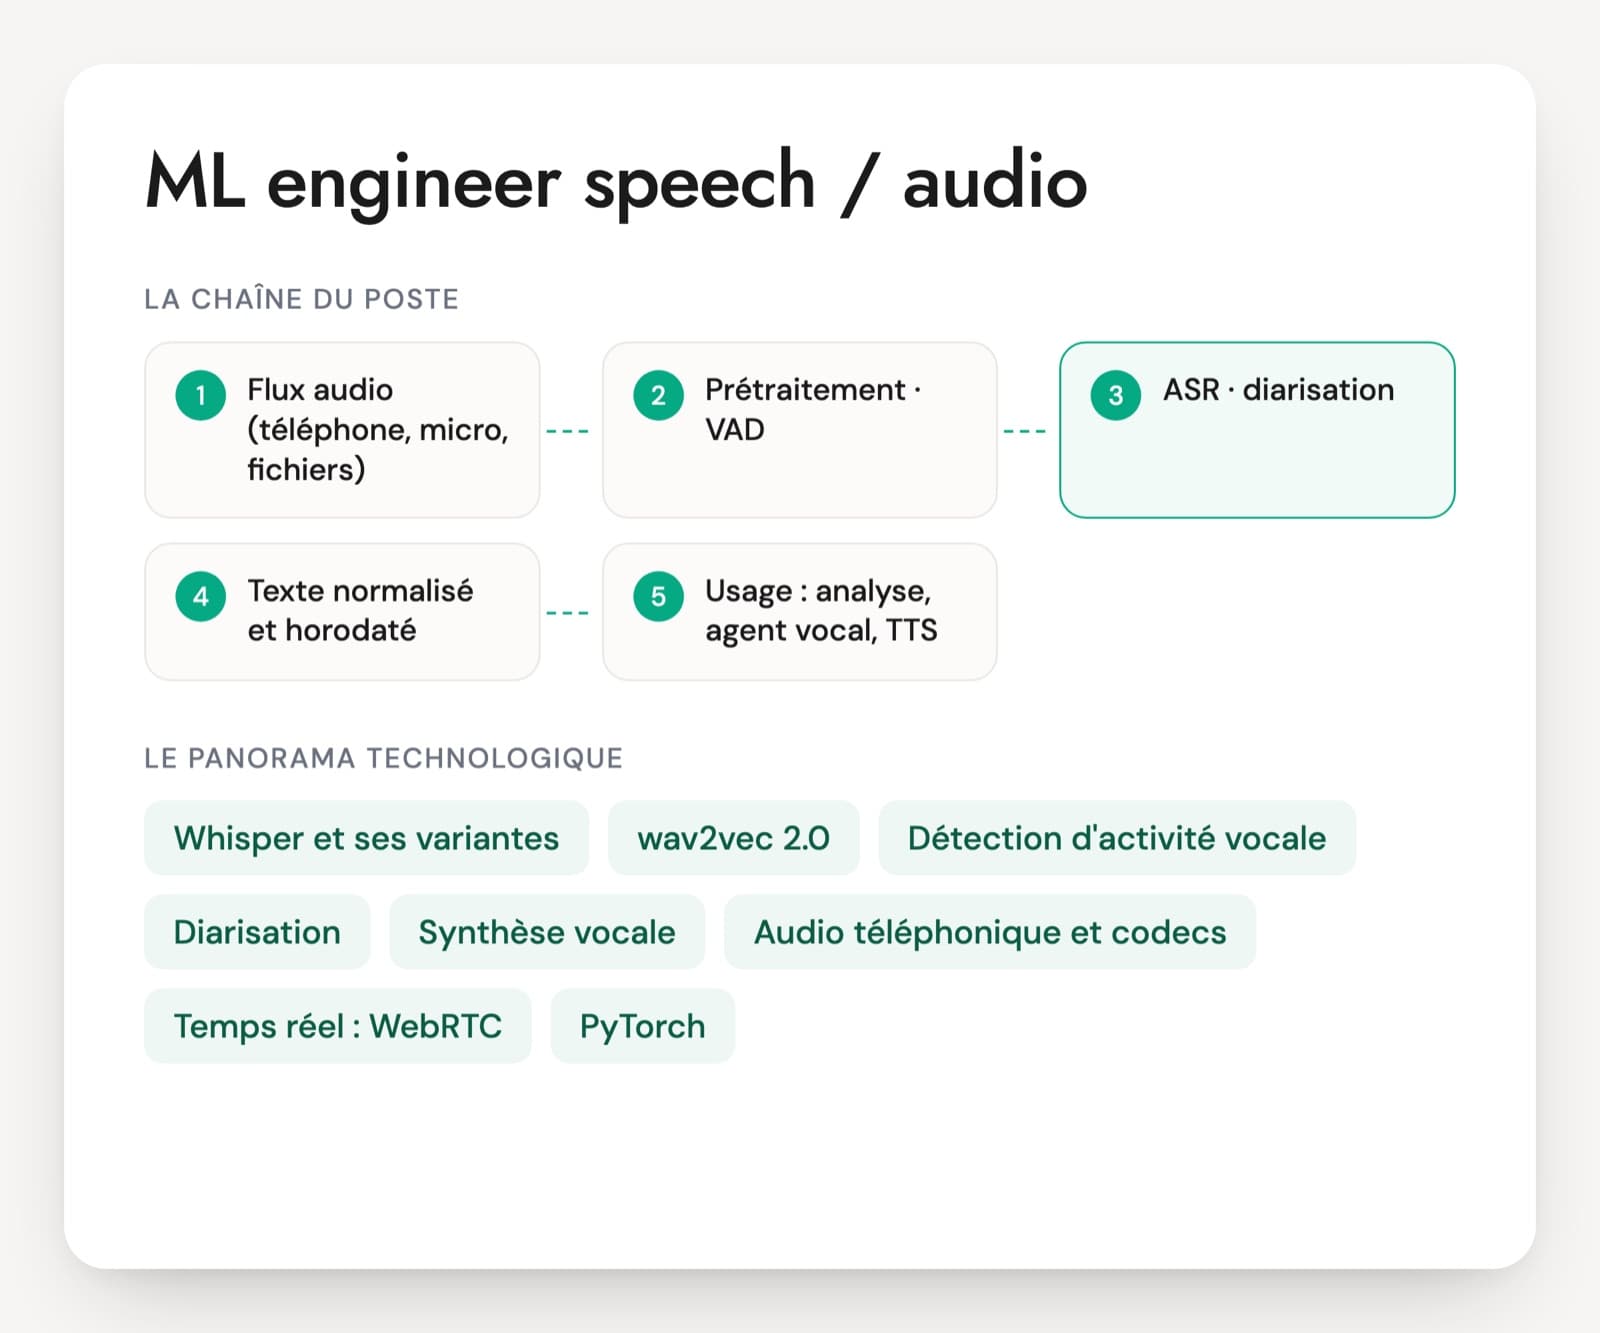
Un ML engineer speech travaille sur trois familles de modèles. La reconnaissance vocale (ASR) transforme un enregistrement en texte, avec Whisper, wav2vec 2.0 ou les modèles NeMo de NVIDIA. La diarisation indique qui parle quand. La synthèse vocale (TTS) fait parler une machine. Autour, il y a la détection de parole, le traitement du signal et toute la contrainte du temps réel quand le modèle sert un agent vocal ou un sous-titrage en direct.
Le piège vient de l'écart entre la démonstration et la production. Un modèle qui transcrit parfaitement un podcast peut s'effondrer sur un appel téléphonique en 8 kHz, avec un accent, un bruit de rue et des numéros de dossier dictés à toute vitesse. Les bons profils parlent spontanément de taux d'erreur mesuré sur leurs propres données, de normalisation du texte, de silences mal transcrits et de latence au premier mot.
Le taux d'erreur de son dernier système, et le jeu de test qui a servi à le mesurer, se demandent dès le début. Un chiffre précis, avec le type d'audio, sépare vite la pratique d'une démonstration Whisper. Les appels d'un centre de contact forment la matière du cas pratique.
Les modèles et logiciels du traitement de la parole
Whisper et ses variantes
Le modèle de transcription d'OpenAI, publié en open source et très répandu, y compris en français. Des versions accélérées comme faster-whisper le rendent utilisable en production. Il travaille par fenêtres de 30 secondes et peut inventer du texte sur des silences : demandez comment la personne l'a géré.
wav2vec 2.0, NeMo et modèles en streaming
wav2vec 2.0, de Meta, sert souvent de base à adapter sur un domaine précis. Les modèles NeMo de NVIDIA (Parakeet, Canary) et d'autres modèles conçus pour le flux continu transcrivent au fil de la parole, ce que Whisper fait mal. Mistral AI propose aussi Voxtral pour la parole. Le choix dépend de la latence visée et de la langue.
Détection d'activité vocale (VAD)
Un petit modèle qui repère les moments où quelqu'un parle. Silero VAD est très utilisé, en 8 ou 16 kHz. Il sert à ne transcrire que la parole, et dans un agent vocal à décider quand l'interlocuteur a fini sa phrase. Un mauvais réglage coupe les gens au milieu d'une phrase ou fait attendre la machine trop longtemps.
Diarisation (pyannote)
La diarisation découpe un enregistrement par locuteur. pyannote.audio est la bibliothèque open source de référence, avec un pipeline communautaire et une offre payante plus précise. La qualité se mesure par le taux d'erreur de diarisation (DER), qui souffre surtout quand deux personnes parlent en même temps.
Synthèse vocale (TTS)
Les voix de synthèse viennent d'API cloud (Azure AI Speech, Google, ElevenLabs) ou de modèles open source hébergés en interne. Les sujets d'entretien portent sur la latence avant le premier son, la prononciation des sigles, des montants et des noms propres, et le consentement quand on reproduit la voix d'une personne.
Audio téléphonique et codecs
Le téléphone classique transmet un son échantillonné à 8 kHz et compressé (G.711, en loi A en Europe), qui coupe tout ce qui dépasse environ 3,4 kHz. La plupart des modèles sont entraînés en 16 kHz. Un candidat qui a travaillé sur des appels réels connaît cet écart et sait comment le compenser.
Temps réel : WebRTC, SIP et orchestration
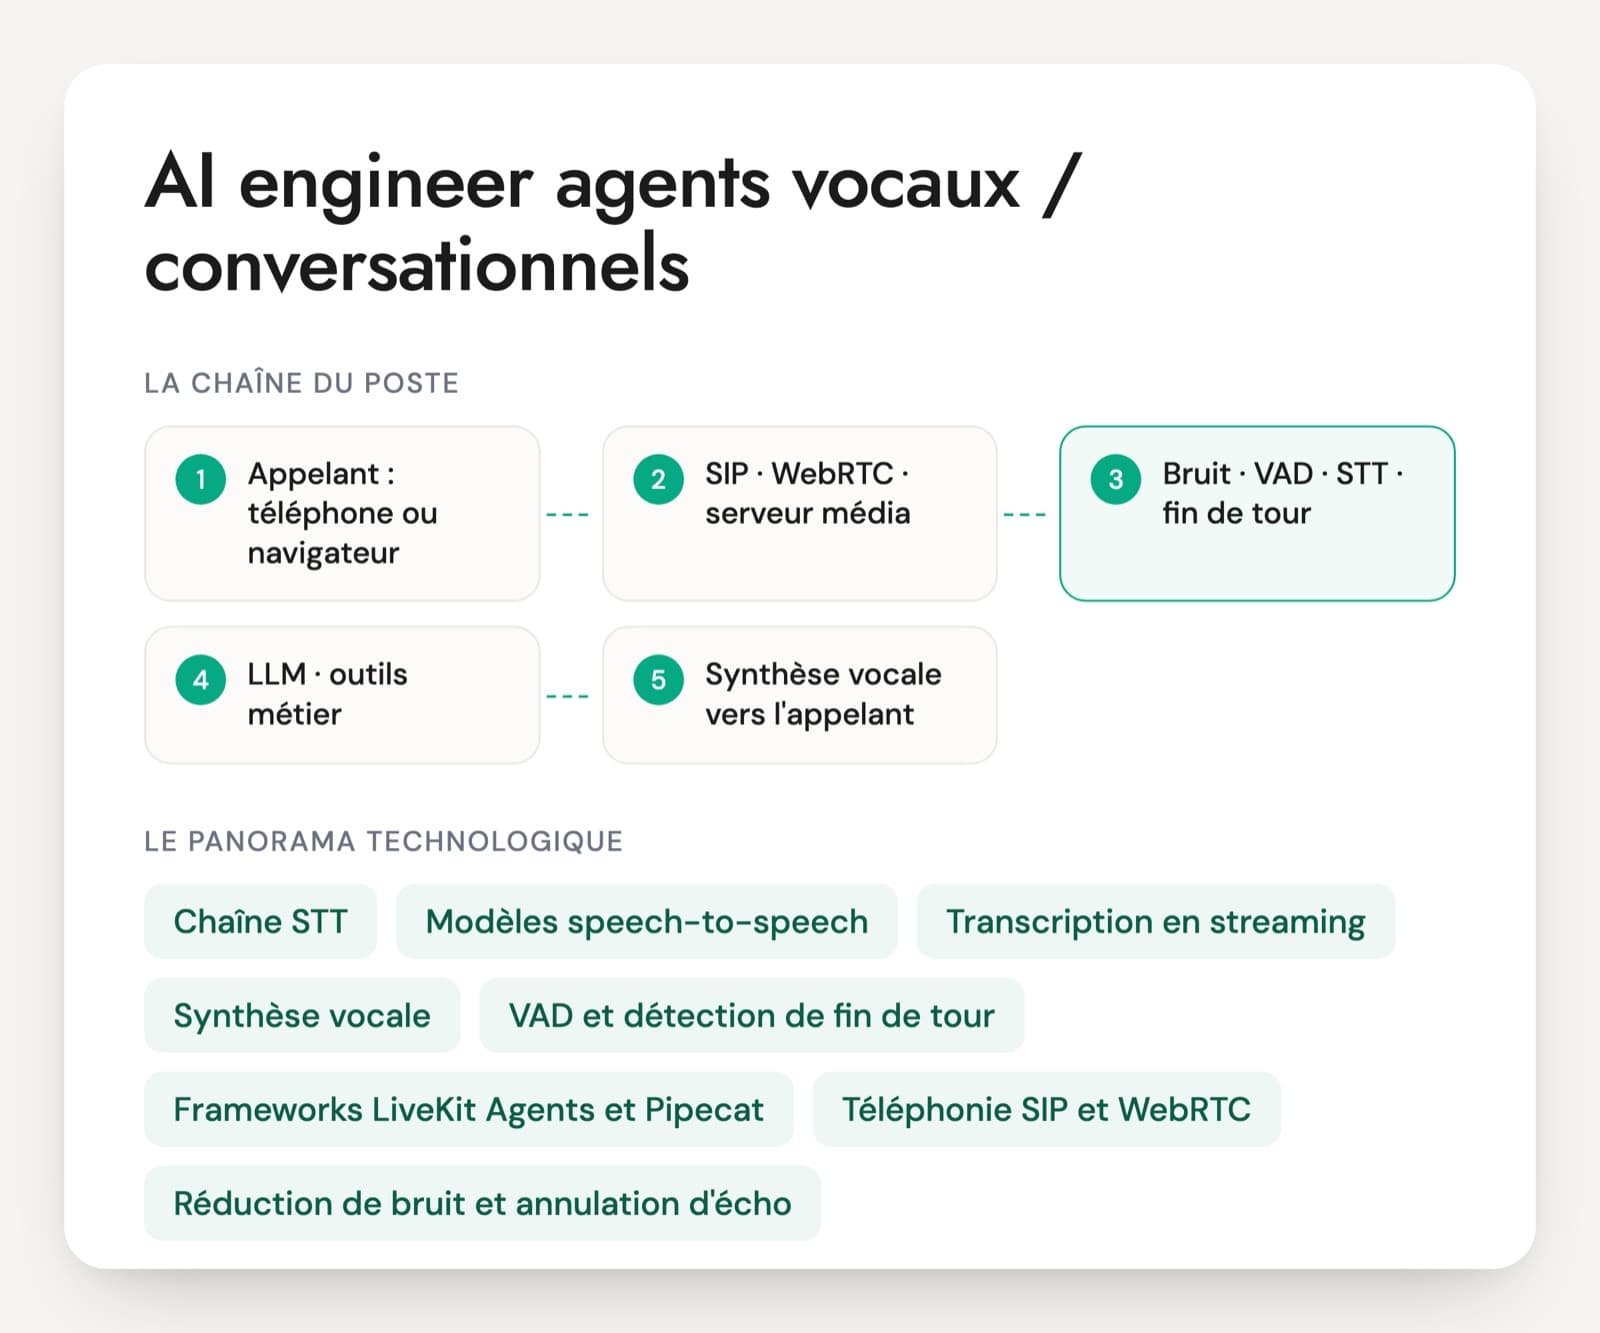
Pour un agent vocal ou une assistance au conseiller en direct, l'audio arrive en flux par SIP ou WebRTC, souvent via une plateforme comme LiveKit ou Pipecat. L'ingénieur speech doit tenir la latence de bout en bout et gérer l'interruption de la machine par l'humain (barge-in), avec une annulation d'écho.
PyTorch, torchaudio et évaluation
L'entraînement et l'adaptation se font avec PyTorch, torchaudio et Hugging Face. L'évaluation repose sur le taux d'erreur de mots (WER), calculé avec des outils comme jiwer après normalisation du texte. Sans jeu de test annoté issu des données réelles, aucun chiffre de qualité n'a de sens.
Le métier se retrouve dans des contextes variés : éditeurs de logiciels de centre de contact, start-up d'agents vocaux, plateformes de sous-titrage et de transcription de réunions, médias, équipes IA de grands groupes. Les offres françaises le mélangent souvent avec le NLP et les LLM, et parlent de speech-to-text comme d'une brique parmi d'autres. Le titre varie : ingénieur speech, ingénieur reconnaissance vocale, ML engineer audio, voice AI engineer. Beaucoup de profils viennent de laboratoires de recherche en parole. Vérifiez qu'ils ont aussi servi un modèle à des utilisateurs, avec une contrainte de coût ou de latence.
Points de contrôle pour l'entretien d'un ML engineer speech
- Signal audio et téléphonie
- Reconnaissance vocale (ASR) et adaptation
- Évaluation de la transcription
- VAD, diarisation et tours de parole
- Temps réel et mise en production
- Synthèse vocale et données vocales
Un ingénieur speech face à du vrai audio
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Votre modèle de transcription affiche 6 % de WER sur un benchmark public et 25 % sur les appels de vos clients. Comment expliquez-vous l'écart ?
Une bonne réponseLes benchmarks sont souvent de la parole lue ou propre, en 16 kHz. Les appels réels sont en 8 kHz compressé, bruités, avec des accents, des hésitations, des chevauchements et un vocabulaire métier (noms de produits, numéros de dossier). La normalisation du texte peut aussi gonfler le chiffre : « 23 » contre « vingt-trois ». La personne propose de constituer un jeu de test annoté sur de vrais appels, de normaliser références et transcriptions de la même façon, puis de classer les erreurs par cause.
Signal d'alerte« Le modèle est mauvais, on en prend un plus gros », sans analyse des erreurs ni question sur la normalisation.
Question 2 · confirmé
Les appels arrivent en 8 kHz et votre modèle a été entraîné en 16 kHz. Que faites-vous ?
Une bonne réponseDécoder d'abord le codec (G.711 en loi A ou µ), puis rééchantillonner en 16 kHz pour que le modèle accepte l'entrée, en sachant que les fréquences perdues ne reviennent pas. Pour réduire l'écart, adapter le modèle sur de l'audio téléphonique réel, ou simuler la téléphonie sur des données 16 kHz (sous-échantillonnage, codec, bruit) pour l'entraînement. Le gain se mesure sur un test d'appels réels.
Signal d'alerteEnvoyer le flux 8 kHz tel quel en le déclarant comme du 16 kHz, ce qui accélère la voix, ou croire que le rééchantillonnage restitue la qualité d'origine.
Question 3 · senior
Dans un agent vocal, comment décidez-vous que la personne a fini de parler ?
Une bonne réponseUne VAD donne la fin de la parole détectée, mais un simple seuil de silence coupe les gens qui réfléchissent ou fait attendre la machine. Les bons systèmes combinent la VAD avec un modèle de détection de fin de tour qui tient compte du sens de la phrase, ajustent le délai selon le contexte (dictée d'un numéro, question ouverte) et gèrent l'interruption de la machine par l'humain. La personne mesure le taux de coupures et le délai de réponse.
Signal d'alerteUn silence fixe de deux secondes pour tout le monde, ou aucune notion de barge-in ni d'écho de la voix de synthèse.
Question 4 · confirmé
Whisper produit des phrases entières sur des passages de silence ou de musique d'attente. Pourquoi, et comment l'empêchez-vous ?
Une bonne réponseWhisper est un modèle qui génère du texte à partir de l'audio ; entraîné sur des données du web, il complète parfois le vide avec des phrases plausibles (« Merci d'avoir regardé »). On filtre avec une VAD avant transcription, on règle les seuils de probabilité d'absence de parole et de taux de compression, on évite de conditionner chaque fenêtre sur le texte précédent quand les hallucinations se répètent, et on teste sur un jeu qui contient des silences et de la musique.
Signal d'alerteNe jamais avoir observé le phénomène, ou le corriger par une liste de phrases interdites ajoutée après coup.
Question 5 · confirmé
Comment mesurez-vous la qualité d'une diarisation sur des enregistrements de réunions ?
Une bonne réponseLe taux d'erreur de diarisation (DER), qui additionne parole manquée, fausse détection de parole et confusion entre locuteurs, en précisant s'il est calculé avec une marge de tolérance aux frontières et en comptant ou non les chevauchements. La personne regarde aussi l'erreur sur le nombre de locuteurs estimé et la qualité sur les passages où plusieurs personnes parlent en même temps, où se concentrent souvent les erreurs.
Signal d'alerteJuger à l'oreille sur deux enregistrements, ou ne pas savoir de quoi se compose le DER.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
API du marché ou modèle maison, et le parcours d'un ingénieur speech
Où finit le travail de l'AI engineer voix et où commence celui de l'ingénieur speech ?
L'AI engineer voix assemble un agent vocal à partir de briques existantes : API de transcription, LLM, synthèse vocale, plateforme temps réel. L'ingénieur speech intervient sous ces briques. Il adapte un modèle de transcription à des appels réels, mesure le taux d'erreur, règle la détection de parole, héberge et optimise les modèles. Si les briques du marché donnent une qualité suffisante, le premier profil peut suffire ; sinon, il vous faut le second.
Une API de transcription du marché ne suffit-elle pas ?
Souvent, pour démarrer. Un ingénieur speech devient utile quand la qualité ne tient pas sur votre audio réel (téléphone, bruit, vocabulaire métier), quand les enregistrements ne peuvent pas sortir de votre hébergement, quand le volume rend le coût à la minute trop élevé, ou quand la latence d'un service externe gêne un usage en direct. En entretien, demandez à la personne comment elle comparerait une API et un modèle hébergé sur vos données.
Comment faire passer un test technique à un ingénieur speech ?
Donnez une dizaine d'enregistrements représentatifs avec leurs transcriptions de référence et la sortie d'un modèle. Demandez de calculer le WER, d'expliquer les écarts et de proposer trois améliorations classées par effort. En une heure, vous voyez si la personne pense à la normalisation, distingue les erreurs dues à l'audio de celles dues au vocabulaire et sait prioriser. Un exercice de code pur passe à côté de ces réflexes.
Quel parcours mène au métier d'ingénieur speech ?
Beaucoup viennent du traitement du signal ou d'une thèse en traitement automatique de la parole, dans des laboratoires comme le LIUM au Mans, le LIA à Avignon ou le LORIA à Nancy. D'autres arrivent du deep learning généraliste et se sont spécialisés sur un produit vocal. Le diplôme compte moins que l'expérience de modèles servis sur de l'audio réel. Vérifiez la qualité du code et la culture de la mesure.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.