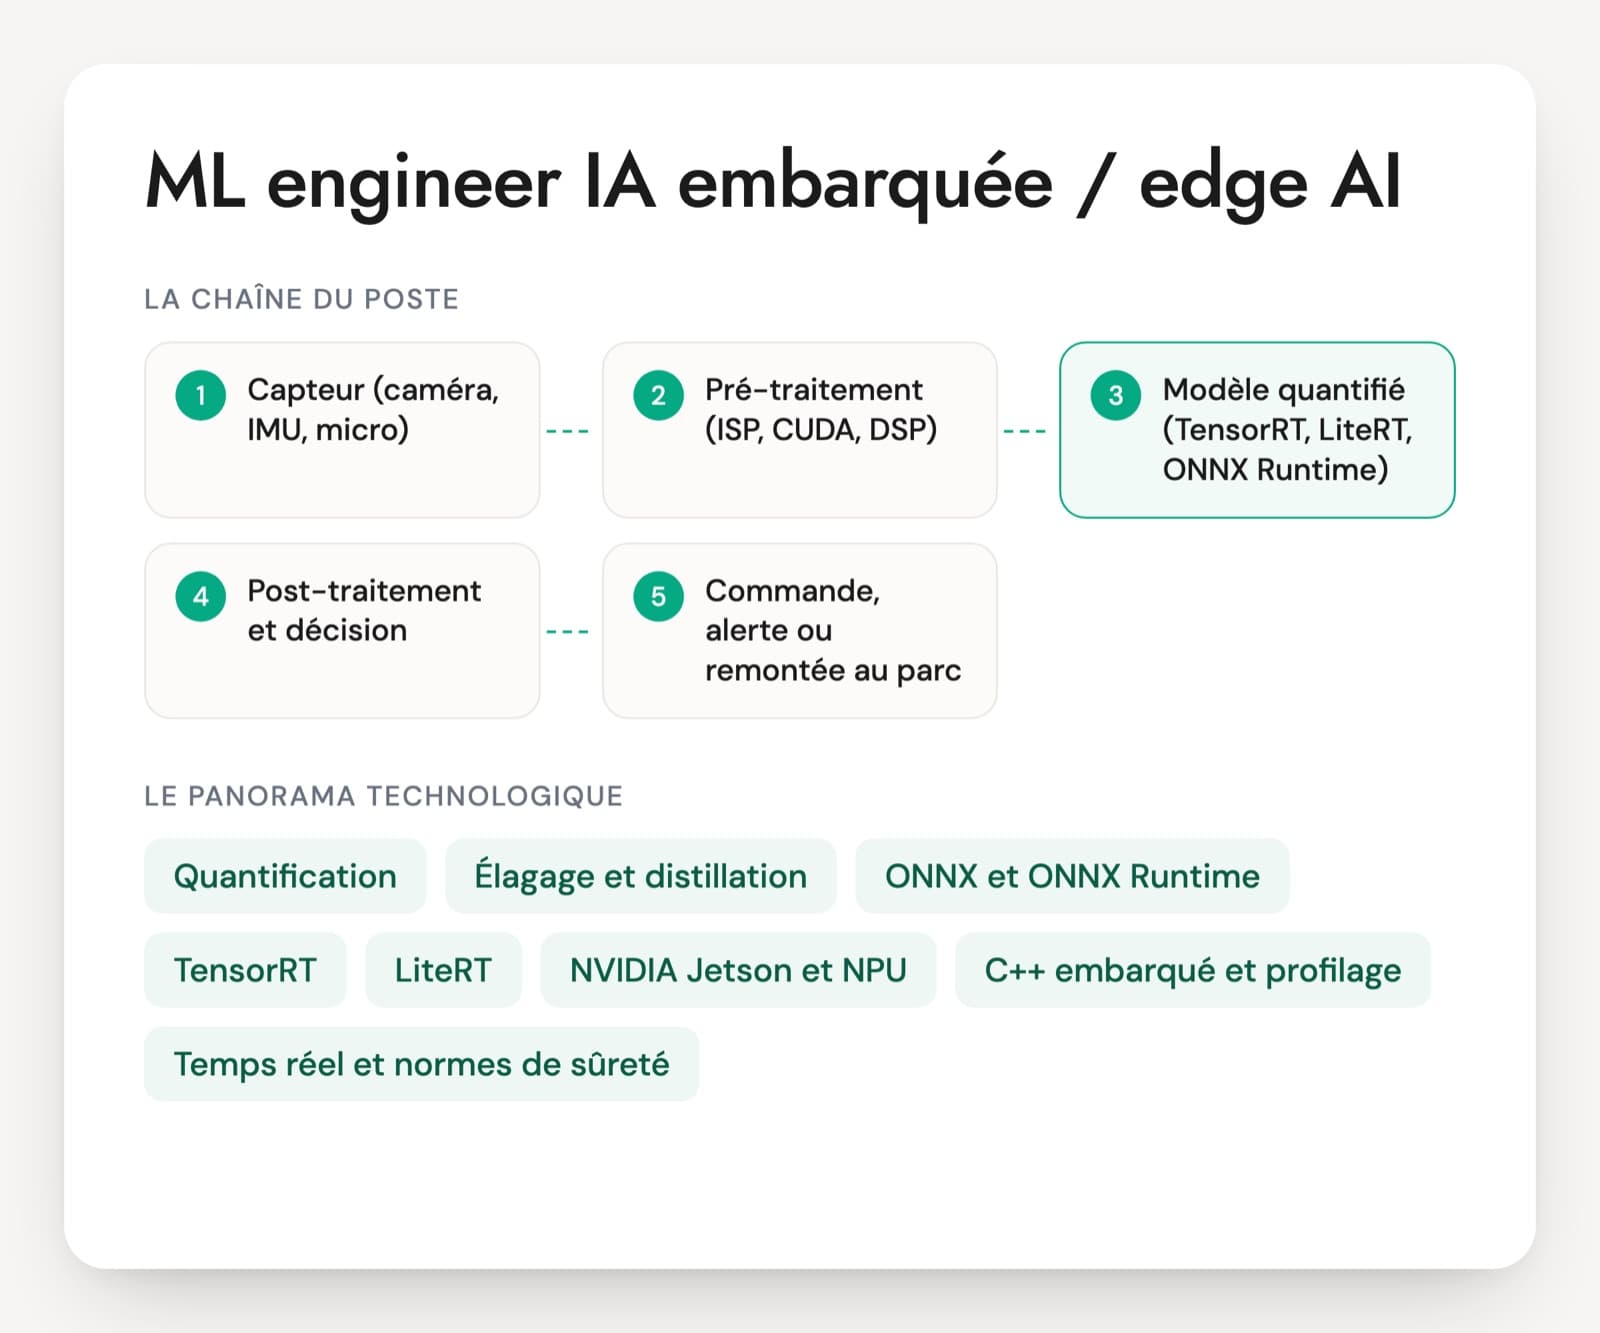
Le poste d'ingénieur IA embarquée, ou edge AI, commence là où s'arrête le data scientist. Le modèle est entraîné, il faut maintenant le faire tenir dans une caméra, un drone, un robot ou un capteur industriel. Quantification en INT8, conversion vers ONNX, TensorRT ou LiteRT, code C++ autour du modèle, mesure de la latence sur la carte. Les offres viennent surtout de l'aéronautique, de la défense, de l'automobile, du spatial et de l'industrie, souvent via des ESN d'ingénierie ou des laboratoires.
Les CV mélangent deux profils. Le spécialiste du deep learning cite TensorRT après un tutoriel, sans avoir jamais mesuré une latence au pire cas. L'ingénieur logiciel embarqué maîtrise le C++ et le temps réel, mais découvre la quantification. Le bon candidat sait expliquer une perte de précision après quantification et ce qui se passe quand une image dépasse son délai.
Sur l'embarqué, une chaîne complète sur une carte Jetson ou un microcontrôleur, même en projet d'école, vaut mieux chez un junior qu'une liste de frameworks. Pour un senior, demandez la latence mesurée sur sa dernière cible et ce qu'il a sacrifié pour la tenir. Pour le cas pratique, un robot doit détecter des personnes.
Runtimes et compilateurs pour cibles embarquées
Quantification (INT8, FP16, INT4)
Le passage des poids et des calculs de 32 bits à 16, 8 ou 4 bits. Le modèle devient plus petit et plus rapide, au prix d'une perte de précision à mesurer. On quantifie après entraînement avec un jeu de calibration, ou pendant l'entraînement (QAT) quand la perte est trop forte. C'est le premier sujet à creuser en entretien.
Élagage et distillation
Deux autres façons d'alléger un modèle. L'élagage retire des poids ou des canaux entiers, la distillation entraîne un petit modèle à imiter un grand. Un candidat expérimenté sait qu'un élagage non structuré réduit la taille du fichier sans forcément accélérer l'inférence, faute de support matériel.
ONNX et ONNX Runtime
ONNX est le format d'échange qui permet d'exporter un modèle PyTorch vers d'autres moteurs. ONNX Runtime l'exécute sur CPU, GPU ou NPU grâce à des modules propres à chaque matériel (CUDA, TensorRT, OpenVINO, Qualcomm). L'export échoue parfois sur une opération non prise en charge, un incident que tout praticien a déjà rencontré.
TensorRT
Le moteur d'inférence de NVIDIA. Il fusionne les couches, choisit les noyaux de calcul les plus rapides et gère FP16 et INT8. Le moteur généré est lié à une architecture de GPU et à une version de TensorRT, ce qui complique son déploiement sur un parc de cartes hétérogène.
LiteRT, ExecuTorch et outils microcontrôleurs
LiteRT est le nouveau nom de TensorFlow Lite depuis 2024 ; il convertit aussi des modèles PyTorch et JAX. ExecuTorch est la solution de PyTorch pour les mobiles et l'embarqué. Sur microcontrôleur, on croise LiteRT pour microcontrôleurs, les outils de ST pour les STM32 et les bibliothèques CMSIS-NN d'Arm.
NVIDIA Jetson et NPU
Les cartes Jetson (Orin, et Thor depuis 2025) embarquent un GPU, des accélérateurs dédiés (DLA) et une mémoire partagée entre CPU et GPU. Les NPU de Qualcomm, NXP, Hailo ou Arm (Ethos-U) consomment moins mais n'acceptent qu'une partie des opérations. Demandez ce qui arrive aux opérations qu'ils ne savent pas exécuter.
C++ embarqué et profilage
Le modèle n'est qu'une partie du programme. Capture, pré-traitement, post-traitement et communication sont souvent écrits en C++, avec CUDA pour les calculs sur GPU. Les outils de profilage (Nsight Systems, perf) montrent où passe le temps, et la réponse surprend souvent : rarement dans le réseau lui-même.
Temps réel et normes de sûreté
Sur un système embarqué, une latence moyenne ne veut rien dire : seul compte le pire cas, sous charge et à chaud. Selon le domaine, le logiciel suit des normes comme l'ISO 26262 et l'ISO 21448 dans l'automobile, complétées par l'ISO/PAS 8800 pour l'IA, ou la DO-178C dans l'aéronautique. Elles exigent traçabilité et comportement défini en cas d'erreur.
Le poste existe sous plusieurs intitulés : ingénieur IA embarquée, ML engineer edge, ingénieur optimisation d'inférence, parfois ingénieur vision embarquée. Les employeurs sont les industriels de l'aéronautique, de la défense, de l'automobile et du spatial, leurs sous-traitants en ingénierie, des laboratoires comme le CEA, et des start-up qui conçoivent des capteurs intelligents ou des robots. Selon le poste, le centre de gravité varie : plus de C++ et de temps réel chez un équipementier, plus de compression de modèles dans un laboratoire. Les questions techniques restent les mêmes d'un domaine à l'autre ; seules les normes de sûreté applicables changent.
Du modèle à la carte, les axes d'évaluation d'un ML engineer embarqué
- Quantification et compression de modèles
- Runtimes d'inférence et conversion
- Architecture des cibles (GPU, NPU, microcontrôleur)
- C++ et performance embarquée
- Temps réel, latence au pire cas et sûreté
- Validation sur cible et mise à jour du parc
Ce qu'un ingénieur edge AI doit savoir expliquer sur sa cible
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Après passage en INT8, votre modèle de détection perd six points de précision sur une seule classe. Que faites-vous ?
Une bonne réponseIl vérifie d'abord le jeu de calibration : est-il représentatif, contient-il cette classe et ses conditions difficiles (nuit, contre-jour) ? Puis une quantification par canal plutôt que par tenseur, une comparaison couche par couche entre FP32 et INT8 pour trouver les couches sensibles, laissées en FP16 (précision mixte). Si la perte reste trop forte, un entraînement avec quantification simulée (QAT). La mesure se fait sur la cible, pas seulement dans Python.
Signal d'alerte« On reste en FP32 », ou une calibration sur une dizaine d'images prises au hasard. Ajuster le seuil de détection pour masquer la perte.
Question 2 · senior
Le modèle tourne à 30 ms en moyenne sur un Jetson, et le cahier des charges impose 40 ms par image. Est-ce suffisant ?
Une bonne réponseNon, la moyenne ne prouve rien. Il faut la distribution complète (centiles élevés et maximum) sur une longue durée, carte chaude, avec les autres processus actifs, et mesurer de bout en bout : capture, pré-traitement, copies mémoire, inférence, post-traitement. Il fixe le mode d'alimentation et les fréquences, surveille la baisse de fréquence thermique et définit ce que fait le système quand une image dépasse son délai.
Signal d'alerteUne moyenne mesurée sur cent images au banc, carte froide, en ne chronométrant que l'appel au modèle.
Question 3 · confirmé
Un moteur TensorRT généré sur votre poste de développement refuse de se charger sur la carte cible. Pourquoi, et comment organisez-vous la génération des moteurs ?
Une bonne réponseUn moteur TensorRT dépend de l'architecture du GPU et des versions de TensorRT et de CUDA. Il se génère sur la cible ou sur un matériel identique avec les mêmes versions (JetPack figé), les options de compatibilité de TensorRT ayant des limites. L'artefact versionné est le fichier ONNX avec la configuration de génération, et la CI produit les moteurs sur le matériel cible.
Signal d'alerteCopier un fichier .engine d'une machine à l'autre comme un modèle universel, sans savoir pourquoi il ne charge pas.
Question 4 · confirmé
Vous devez faire tenir un modèle de détection d'anomalies vibratoires sur un microcontrôleur avec 256 Ko de RAM. Par où commencez-vous ?
Une bonne réponsePar le budget mémoire : poids en flash, pic des activations en RAM (la zone de travail du runtime), pile et tampons du capteur. Il choisit une petite architecture, par exemple un réseau convolutif 1D, envisage des caractéristiques calculées (FFT) plutôt que le signal brut, quantifie entièrement en entiers 8 bits et utilise un outil adapté (LiteRT pour microcontrôleurs, outils ST, CMSIS-NN). Il mesure mémoire et temps sur la carte dès la première version.
Signal d'alertePartir d'un gros modèle pour l'élaguer ensuite sans budget, ou ne compter que la taille des poids en oubliant les activations.
Question 5 · confirmé
Sur la cible, le modèle ne donne pas les mêmes résultats que dans le notebook, avec les mêmes poids. Où cherchez-vous ?
Une bonne réponseD'abord le pré-traitement, la cause la plus fréquente : ordre des canaux (RGB ou BGR), normalisation, méthode de redimensionnement, disposition des données (NCHW ou NHWC). Puis la quantification et les différences de conversion d'opérations. Il compare les sorties couche par couche sur une même entrée fixée et garde des vecteurs de test de référence rejoués à chaque version.
Signal d'alerte« On réentraîne le modèle », ou accuser le matériel sans comparer les sorties intermédiaires.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Edge AI : les interrogations avant d'ouvrir le poste
Quelle différence entre un ML engineer edge AI et un ingénieur logiciel embarqué ?
L'ingénieur logiciel embarqué maîtrise le C++, le temps réel, les pilotes et les contraintes matérielles, sans forcément connaître les réseaux de neurones. Le ML engineer edge AI ajoute la compression des modèles, la conversion vers les runtimes d'inférence et la mesure de la perte de précision. Sur un petit projet, un seul profil hybride suffit. Sur un produit certifié, les deux travaillent ensemble et l'entretien doit vérifier que chacun comprend les contraintes de l'autre.
Faut-il exiger le C++ pour un poste d'ingénieur IA embarquée ?
Sur une cible de production, oui dans la plupart des cas : le code autour du modèle, la capture et le post-traitement tournent en C++, parfois en C sur microcontrôleur. Un profil Python seul peut tenir un poste centré sur la compression de modèles dans un laboratoire. Vérifiez la pratique réelle plutôt que la ligne du CV : gestion de la mémoire, profilage, compilation croisée vers la carte cible.
Comment organiser un test technique pour un poste edge AI ?
Un exercice de deux heures sur un modèle fourni fonctionne bien : export vers ONNX, quantification, mesure de la précision avant et après, puis explication des écarts. Si vous disposez d'une carte de développement, faites mesurer la latence sur la cible. À défaut, une discussion sur des mesures réelles fournies par vos équipes montre si la personne sait lire une distribution de latence et repérer une copie mémoire inutile.
Les normes de sûreté doivent-elles figurer dans le profil recherché ?
Tout dépend du produit. Pour un calculateur automobile ou un équipement aéronautique, l'expérience d'un cycle de développement sous ISO 26262 ou DO-178C fait gagner des mois, car la traçabilité des données et des versions de modèle y est exigée. Pour une caméra industrielle ou un objet connecté, ce n'est pas un prérequis. Dans les deux cas, demandez comment le système se comporte en cas d'erreur du modèle.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.