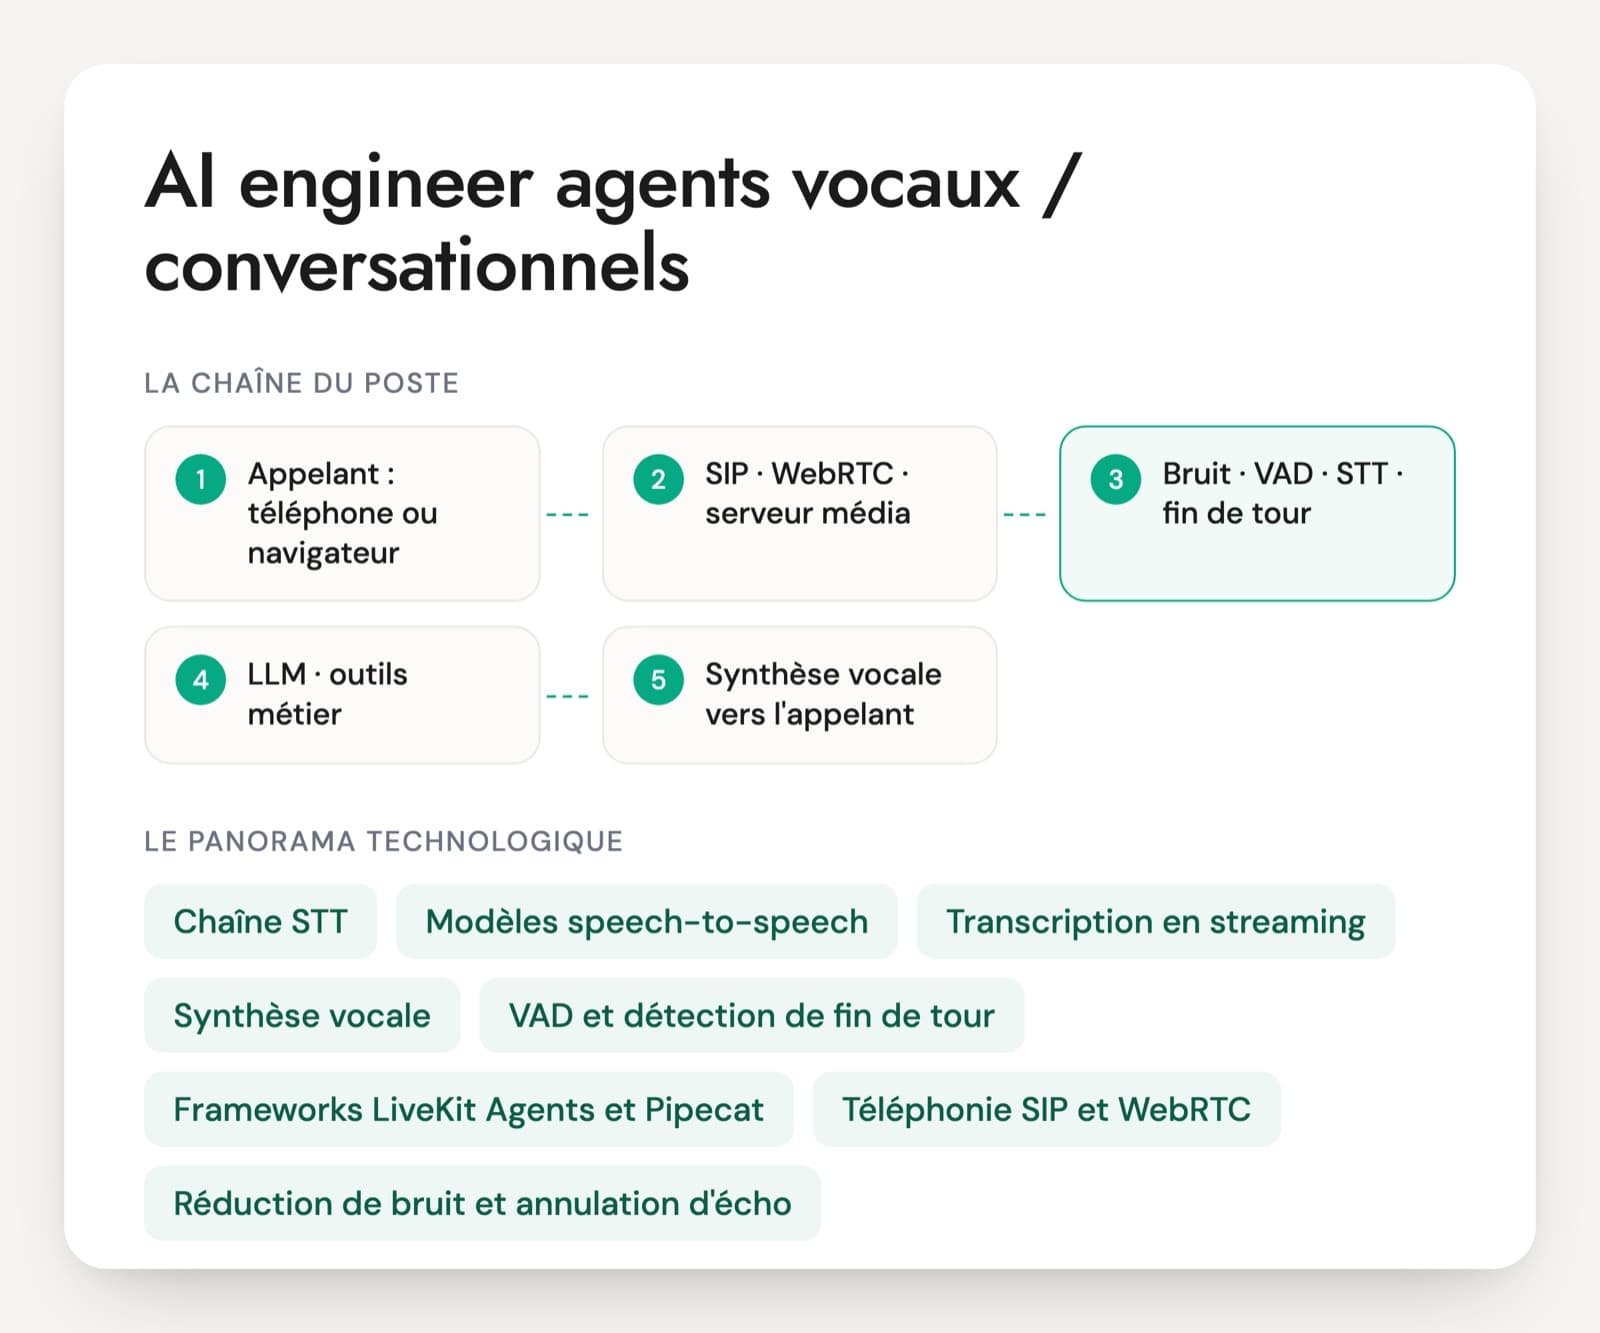
Un agent vocal IA enchaîne en temps réel la transcription de la parole (STT), un LLM qui décide de la réponse et appelle des outils, puis une voix de synthèse (TTS), ou bien un modèle speech-to-speech qui fait tout d'un bloc. L'AI engineer qui le construit branche le tout sur la téléphonie ou sur une application, souvent avec LiveKit ou Pipecat, et doit tenir une latence que l'appelant ne remarque pas. On le recrute pour un standard d'accueil, une prise de rendez-vous, une préqualification d'appels ou un service client.
Beaucoup de CV affichent un agent vocal monté en un week-end avec une plateforme prête à l'emploi. La démo marche au calme, dans un navigateur, avec une seule personne qui parle lentement. Le niveau se lit ailleurs : comment la personne découpe un délai de réponse, comment l'agent sait que l'appelant a fini sa phrase, ce qui arrive quand on lui coupe la parole et comment l'appel repasse à un conseiller.
Ces questions viennent mieux après un premier échange sur la démo du candidat. Le chiffre à obtenir est le délai mesuré entre la fin de la phrase et le premier son de l'agent, avec la méthode utilisée pour le mesurer. Le cas pratique simule le standard d'un réseau de garages.
Ce qui se passe entre la ligne téléphonique et la voix de synthèse
Chaîne STT, LLM, TTS
L'architecture la plus courante, dite en cascade. La parole est transcrite en texte, un LLM produit la réponse, une voix de synthèse la prononce. Chaque brique se choisit séparément, ce qui permet de prendre un moteur de transcription bon en français et une voix propre à la marque. Le prix à payer, c'est une latence qui s'additionne d'une étape à l'autre.
Modèles speech-to-speech (OpenAI Realtime, Azure Voice Live)
Ces API reçoivent l'audio et renvoient de l'audio, avec des modèles comme gpt-realtime. Voice Live, chez Microsoft, regroupe transcription, modèle, voix, réduction de bruit et détection de fin de tour derrière une seule connexion. La mise en place va plus vite, au prix d'un contrôle plus réduit sur chaque étape. Un bon candidat sait dire quand il les choisirait.
Transcription en streaming (Deepgram, Azure Speech, modèles Whisper)
Le moteur STT transforme la voix en texte au fil de l'eau, avec des résultats partiels puis définitifs. Au téléphone, il bute sur les noms propres, les numéros et les adresses. Deepgram Flux y ajoute sa propre détection de fin de tour. Demandez comment la personne a mesuré la qualité sur de vrais appels en français.
Synthèse vocale (ElevenLabs, Cartesia, voix Azure)
Le TTS produit la voix de l'agent, en commençant à parler avant la fin du texte. Le choix se fait sur le naturel, la latence et la lecture correcte des dates, sigles et montants. Certaines voix déforment ou ajoutent des mots, ce qui se repère en écoutant, pas en lisant les journaux.
VAD et détection de fin de tour
La détection d'activité vocale (Silero VAD, par exemple) repère seulement si quelqu'un parle. Un modèle de fin de tour, comme le turn detector de LiveKit ou le semantic_vad de l'API Realtime, estime si la personne a fini sa phrase. C'est là que se joue l'impression d'un agent qui coupe la parole ou qui laisse des blancs.
Frameworks LiveKit Agents et Pipecat
Deux frameworks open source pour orchestrer un agent vocal temps réel en Python. Ils gèrent le flux audio, les interruptions, l'appel des outils et l'enchaînement des briques. Vapi ou Retell proposent la même chose en service hébergé. Une expérience sur l'un se transpose à l'autre si la personne comprend ce qui se passe dessous.
Téléphonie SIP et WebRTC
Le SIP relie l'agent au réseau téléphonique via un trunk chez un opérateur comme Twilio ou Telnyx. Le WebRTC sert aux appels depuis un navigateur ou une application. Au téléphone, l'audio est en bande étroite, les touches du clavier (DTMF) et le transfert vers un conseiller entrent en jeu. Une démo web ne prépare pas à tout cela.
Réduction de bruit et annulation d'écho
Des modèles comme Krisp retirent le bruit de fond avant la détection de voix. L'annulation d'écho empêche l'agent d'entendre sa propre voix et de s'interrompre tout seul. Les deux ajoutent un peu de traitement, donc de latence, qu'un candidat expérimenté sait chiffrer.
Ces profils viennent souvent du backend Python, du traitement de la parole ou des chatbots texte, et la voix se découvre sur le terrain. En ESN ou en agence, l'AI engineer voix monte des agents pour plusieurs clients, souvent sur une plateforme hébergée, et doit les brancher sur des standards téléphoniques variés. Chez un éditeur ou un client final, il garde l'agent en production, suit sa latence et ses coûts et le fait évoluer à chaque nouveau modèle. En start-up voicetech, il descend jusqu'au serveur média et à la téléphonie. L'AI Act impose depuis août 2026 d'informer l'appelant qu'il parle à une IA, et le RGPD encadre enregistrements et transcriptions.
Les acquis techniques d'un AI engineer voix à faire démontrer
- Architecture temps réel STT, LLM, TTS
- Latence de bout en bout et sa mesure
- Fin de tour, interruptions et bruit
- Téléphonie SIP, WebRTC et transfert
- Outils, contexte et conformité de l'agent
- Tests, coûts et exploitation en production
Latence, interruptions, SIP : les questions à poser à un ingénieur agent vocal
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Votre agent vocal met deux secondes à répondre au téléphone. Comment découpez-vous ce délai, et où allez-vous chercher du temps ?
Une bonne réponseIl mesure chaque étape d'un tour : attente de la fin de parole, transcription finale, premier token du LLM, premier son produit par la synthèse vocale, puis le trajet réseau jusqu'à l'appelant. Il regarde la médiane et le 95e centile, pas une moyenne. Les gains viennent du streaming à chaque étape (la synthèse démarre dès la première phrase), d'un prompt plus court ou mis en cache, de connexions gardées ouvertes et de services hébergés dans la même région.
Signal d'alerte« On prend un modèle plus rapide » sans avoir mesuré, ou un chiffre unique tiré des logs du serveur sans savoir ce qu'entend réellement l'appelant.
Question 2 · confirmé
L'agent coupe la parole aux appelants qui marquent une pause pour chercher leur numéro de dossier. Que réglez-vous ?
Une bonne réponseIl distingue la détection d'activité vocale (VAD), qui dit seulement si quelqu'un parle, de la détection de fin de tour, qui estime si la personne a terminé. Un simple seuil de silence coupe les hésitations. Il propose un modèle de fin de tour qui lit les mots ou l'intonation (le turn detector de LiveKit, le semantic_vad de l'API Realtime, les événements de fin de tour de Deepgram Flux) et des délais minimum et maximum d'attente. Il peut aussi allonger l'attente juste après une question qui appelle un numéro.
Signal d'alertePasser le silence à deux secondes pour tout l'appel, ce qui ralentit chaque réponse, ou confondre VAD et fin de tour.
Question 3 · senior
L'appelant se met à parler pendant que l'agent répond. Que doit-il se passer techniquement, et que garde-t-on dans l'historique de la conversation ?
Une bonne réponseLa parole détectée pendant la lecture coupe la synthèse et vide le tampon audio déjà envoyé, puis annule la génération du LLM en cours. L'historique est tronqué au texte réellement prononcé, grâce aux horodatages de la synthèse, sinon le modèle croit avoir tout dit. Il filtre les fausses interruptions (toux, bruit, un « hm hm » d'acquiescement) par une durée ou un nombre de mots minimum, et reprend la réponse si l'interruption n'en était pas une.
Signal d'alerteLaisser l'agent finir sa phrase, ou garder dans le contexte toute la réponse générée comme si l'appelant l'avait entendue.
Question 4 · confirmé
Vous branchez l'agent sur un numéro de téléphone existant. Qu'est-ce qui change par rapport à la démo dans le navigateur ?
Une bonne réponseUn trunk SIP chez l'opérateur (Twilio, Telnyx ou un autre) relié au serveur média, par exemple LiveKit SIP, avec des règles qui envoient chaque appel vers le bon agent. L'audio passe en bande étroite à 8 kHz (codec G.711), ce qui dégrade la transcription, avec plus de bruit de fond. Il cite les touches du clavier (DTMF), le transfert vers un conseiller, à froid par SIP REFER ou accompagné, l'enregistrement et l'information de l'appelant.
Signal d'alertePenser que l'audio est le même qu'en WebRTC, ou n'avoir jamais prévu comment l'appel repart vers un humain.
Question 5 · senior
Chaîne STT, LLM, TTS ou modèle speech-to-speech comme gpt-realtime : comment tranchez-vous pour le standard téléphonique d'une entreprise ?
Une bonne réponseLe speech-to-speech gagne en latence et en naturel avec moins de pièces à assembler. Il donne moins de contrôle : transcription moins fiable pour les journaux, choix de voix réduit, garde-fous plus difficiles à poser sur le texte, coût des tokens audio. La chaîne en cascade permet de choisir un STT bon en français et une voix de marque, et d'inspecter chaque étape, au prix d'une orchestration plus fine de la latence. Il cite les formules hybrides (Voice Live avec une voix Azure, un modèle temps réel couplé à une synthèse externe) et tranche par des mesures sur de vrais appels en français.
Signal d'alerteUn avis tranché par principe, sans critère mesurable, ou une méconnaissance de l'une des deux architectures.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Profil voix, du CV au test sans infrastructure téléphonique
Sur quelles compétences juger un AI engineer spécialiste de la voix ?
Le socle reste celui d'un AI engineer : Python, API de LLM, appel d'outils, évaluation. La voix ajoute le temps réel. La personne doit savoir découper et mesurer une latence, régler la détection de fin de tour, gérer les interruptions et l'écho, choisir un moteur de transcription et une voix sur de vrais enregistrements. Pour un agent téléphonique, comptez aussi le SIP, les touches du clavier et le transfert d'appel. Ajoutez les obligations d'information de l'appelant.
Qu'apprend-on en plus quand on passe d'un chatbot texte à un agent vocal ?
Surtout la contrainte de temps. Un chatbot peut réfléchir trois secondes, un agent vocal non. Il faut deviner quand l'appelant a fini de parler, accepter d'être interrompu, corriger une transcription approximative et lire à voix haute des dates ou des numéros sans erreur. Un profil RAG ou agents solide apprend vite cette partie s'il a déjà travaillé avec du streaming. Vérifiez en entretien qu'il raisonne en millisecondes et en tours de parole, pas seulement en qualité de réponse.
Quelle place donner à LiveKit ou Pipecat sur un CV ?
C'est un bon indice, sans être une condition. Ces frameworks partagent les mêmes notions : flux audio, VAD, fin de tour, interruptions, appel d'outils. Une personne qui les comprend passe de l'un à l'autre en quelques jours. Méfiez-vous plutôt d'un CV qui ne cite qu'une plateforme hébergée configurée à la souris. Demandez ce qui se passe quand l'appelant coupe la parole et comment la latence a été mesurée : la réponse montre si l'expérience dépasse le paramétrage.
Peut-on évaluer un ingénieur agent vocal en test technique sans infrastructure téléphonique ?
Oui, avec un exercice court. Donnez l'enregistrement stéréo d'un appel raté et les journaux de latence par tour, puis demandez un diagnostic à voix haute : où se perd le temps, pourquoi l'agent coupe la parole, que changer. Un second exercice possible porte sur le schéma d'un agent de prise de rendez-vous avec ses outils et le transfert vers un humain. Pas besoin de trunk SIP, le raisonnement suffit pour classer les candidats.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.