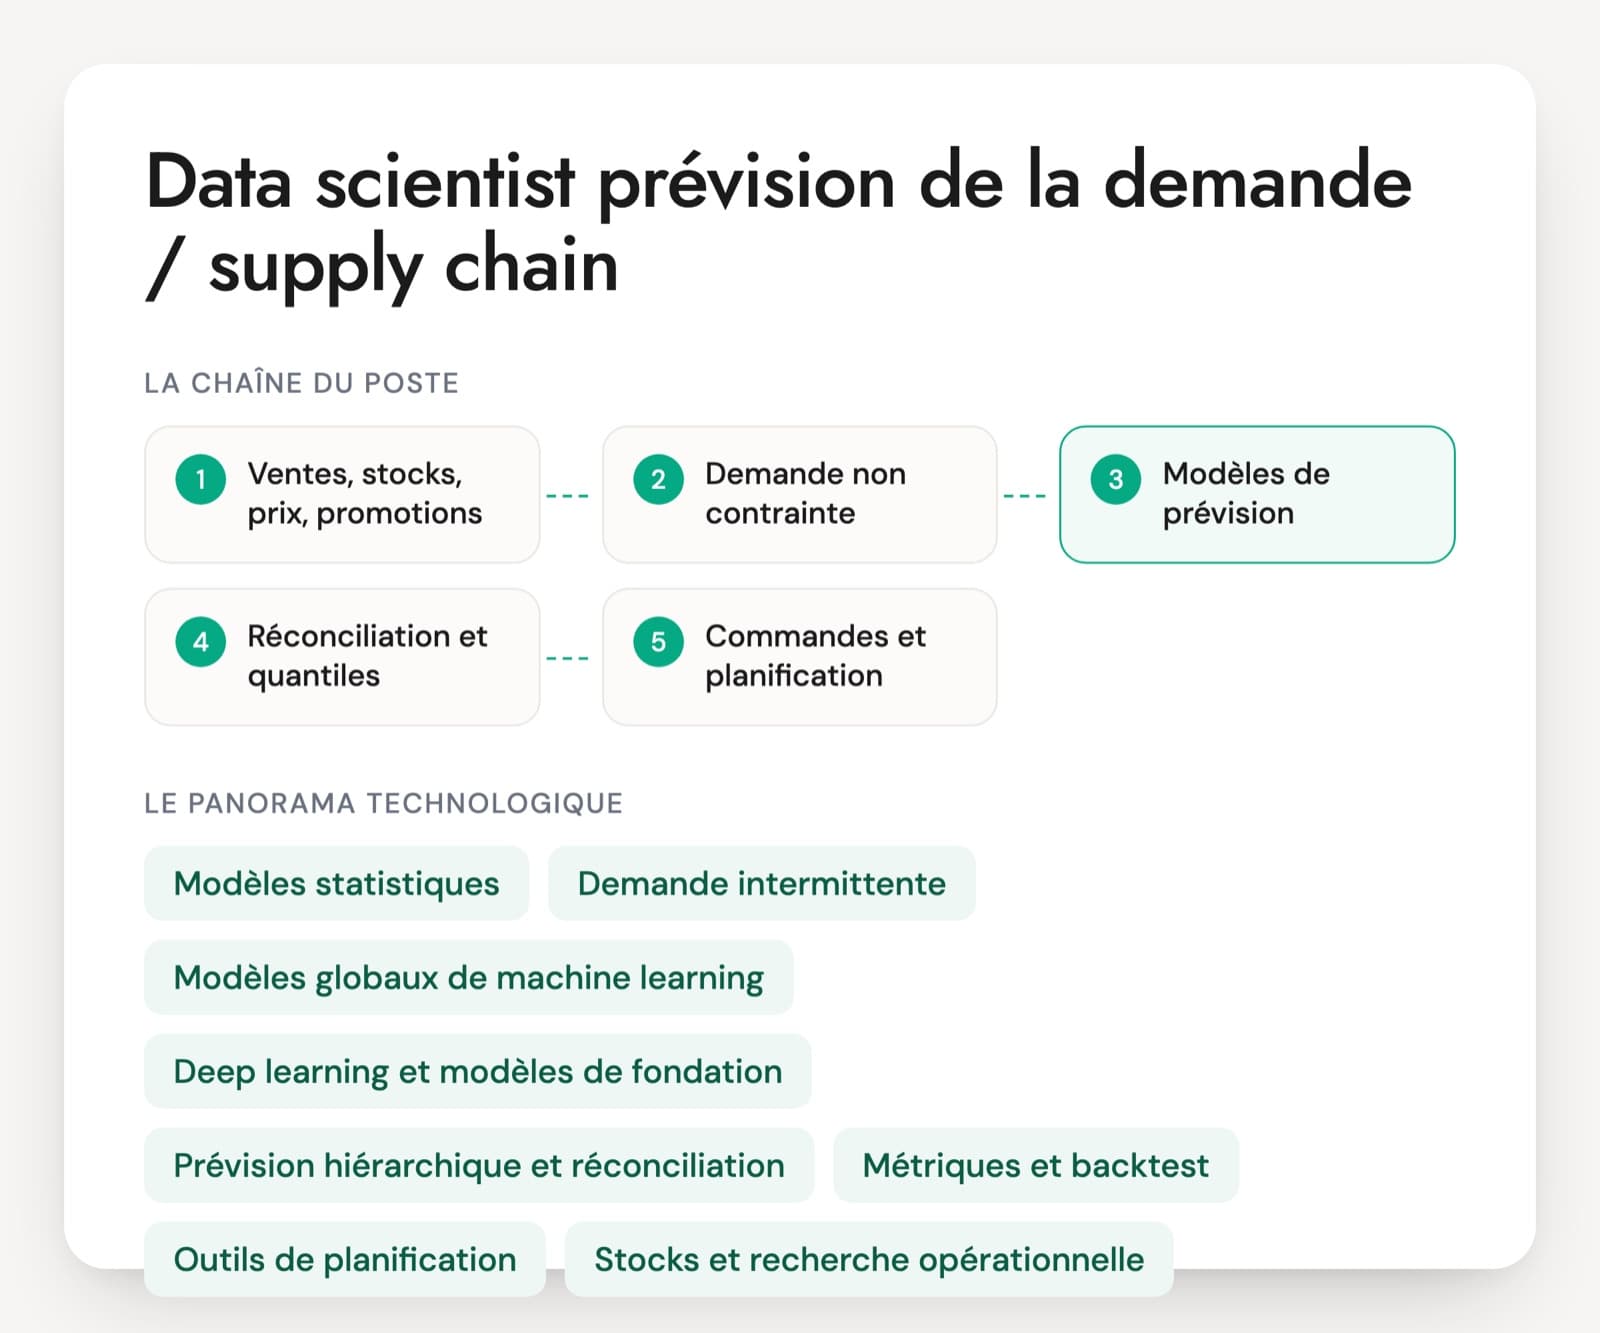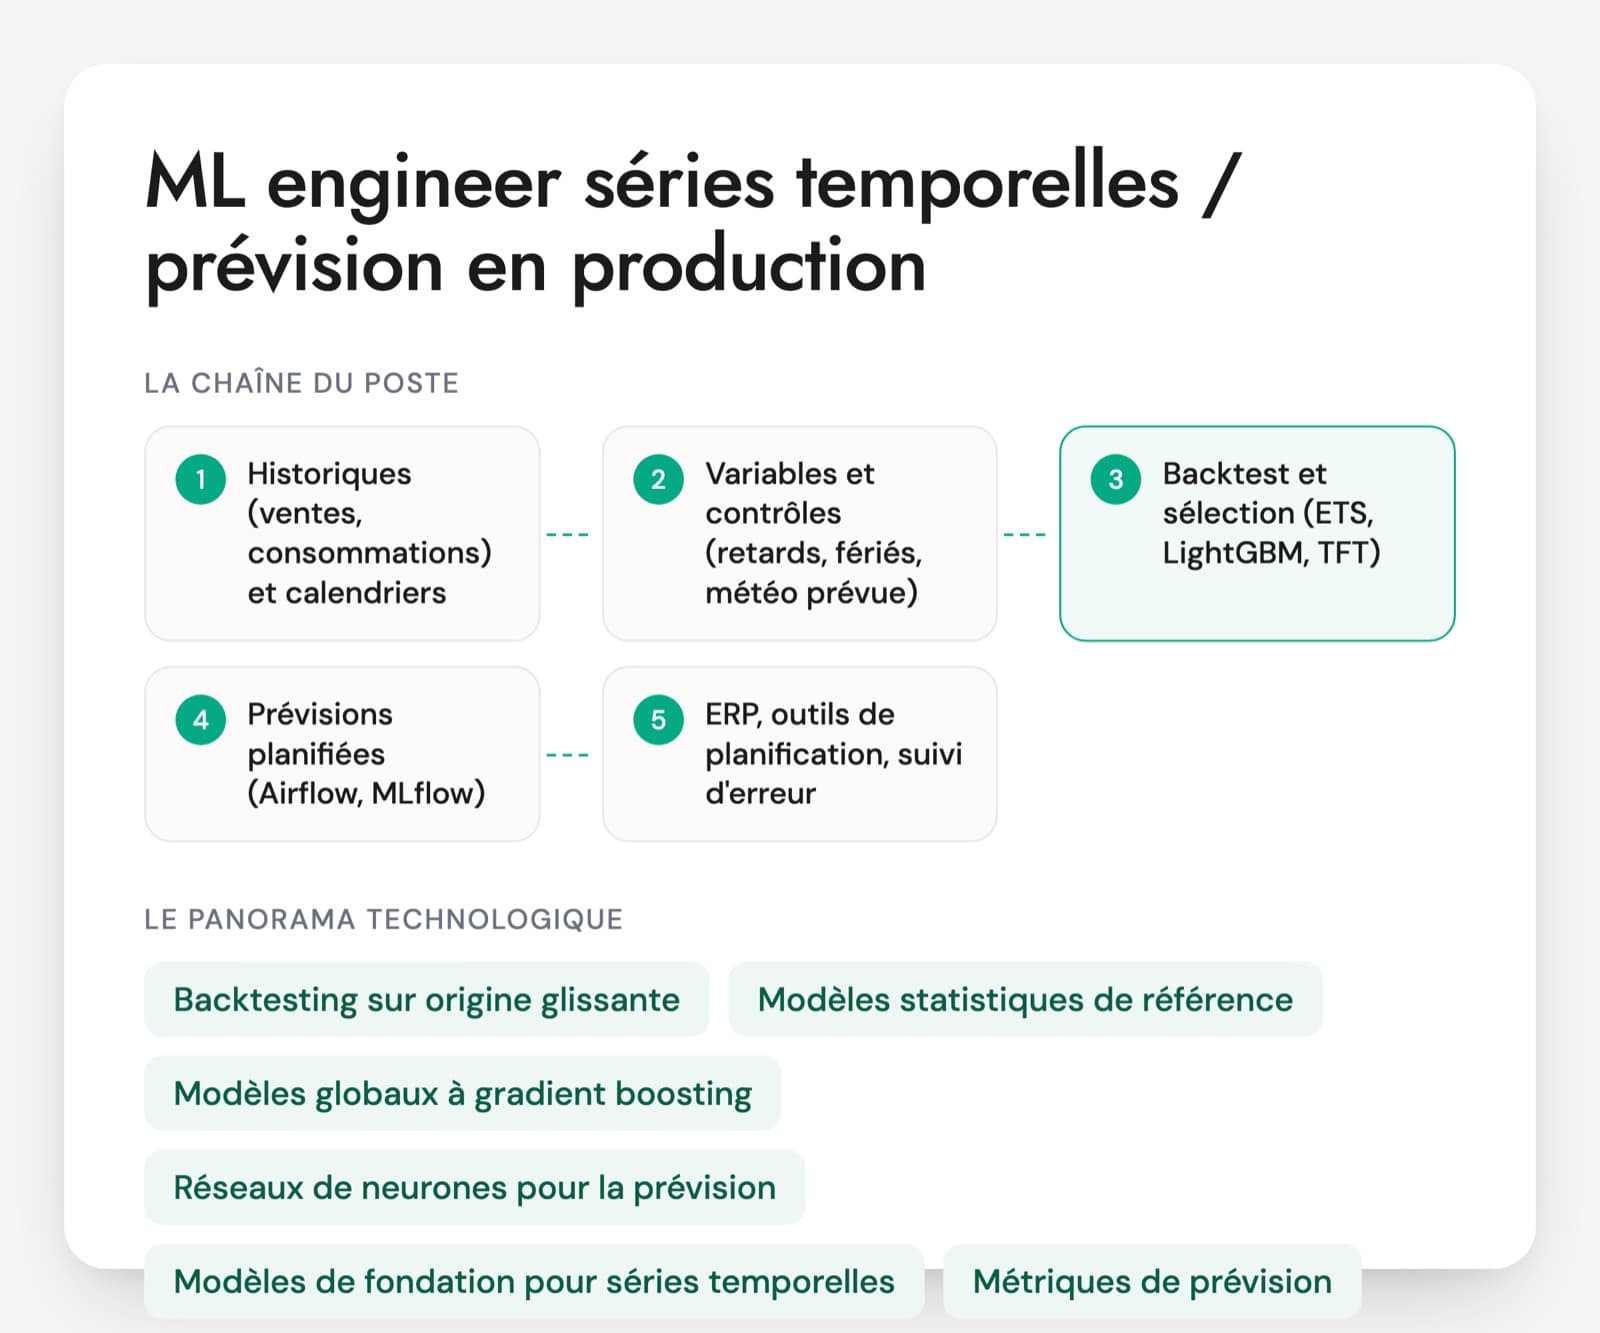
Le ML engineer séries temporelles occupe un poste à part dans le machine learning. Il construit des modèles de prévision qui tournent en production à date fixe, souvent sur des dizaines de milliers de séries : références par magasin, sites de consommation, agences, lignes de produits. Les offres viennent de la distribution, de l'énergie, du transport, de la finance et des éditeurs de logiciels de planification. La prévision de la demande reste le cas le plus courant.
Un piège revient sans cesse en entretien : le score de validation trop beau. Un découpage aléatoire des données, une variable connue seulement après coup ou un MAPE calculé sur des volumes proches de zéro suffisent à afficher une erreur flatteuse qui s'effondre le premier mois. Un profil qui a vraiment livré des prévisions parle de backtest sur origine glissante, de comparaison avec une prévision naïve et d'erreur suivie série par série.
Jour par magasin ou mois par région : l'horizon et la granularité des prévisions changent les méthodes et les pièges, d'où l'intérêt de les faire préciser par le manager. Le PDF contient un cas de 20 minutes sur la consommation électrique de sites clients.
Bibliothèques et modèles de prévision qu'un ML engineer met en production
Backtesting sur origine glissante
La méthode de validation propre aux séries temporelles. On se place à plusieurs dates passées, on entraîne avec les seules données disponibles à cette date et on prévoit l'horizon voulu. Un mélange aléatoire des données, comme en machine learning classique, fait fuir l'avenir dans l'entraînement. C'est le premier point à vérifier.
Modèles statistiques de référence
Lissage exponentiel (ETS), ARIMA, prévision naïve saisonnière, Croston pour les ventes intermittentes. Ils servent de point de comparaison et restent parfois les meilleurs sur des séries courtes. La bibliothèque statsforecast de Nixtla les applique vite à des milliers de séries. Un modèle complexe qui ne les bat pas n'a rien à faire en production.
Modèles globaux à gradient boosting
LightGBM, parfois XGBoost ou CatBoost, entraîné une seule fois sur toutes les séries avec des variables de retard, de calendrier, de prix et de promotion. C'est l'approche la plus répandue en production pour la prévision de la demande. Des bibliothèques comme mlforecast ou Darts gèrent la fabrication des variables et le backtest.
Réseaux de neurones pour la prévision
N-BEATS, N-HiTS, le Temporal Fusion Transformer (TFT) et DeepAR, disponibles dans neuralforecast, Darts ou PyTorch Forecasting. Le TFT sait utiliser des variables connues à l'avance (calendrier, promotions prévues) et produire des quantiles. Ils demandent plus de données et de réglages que LightGBM, pour un gain qui varie selon les cas.
Modèles de fondation pour séries temporelles
Des modèles pré-entraînés sur de très nombreuses séries, utilisables sans entraînement : TimesFM de Google, Chronos d'Amazon, TimeGPT de Nixtla. Ils donnent un point de départ rapide pour des séries nouvelles ou courtes. Comme tout autre modèle, ils se comparent aux références dans le même backtest avant d'être retenus.
Métriques de prévision
MAE, RMSE, MAPE, WAPE, MASE, biais, et pour les prévisions en quantiles la pinball loss ou le CRPS. Le choix n'est pas neutre : le MAPE explose quand les volumes approchent de zéro et favorise les prévisions trop basses. Demandez au candidat laquelle il retient et pourquoi.
Prévision probabiliste et hiérarchique
Une prévision utile au métier donne souvent une fourchette (quantiles, intervalles conformes) plutôt qu'une seule valeur, pour dimensionner un stock ou une marge de sécurité. Quand les prévisions existent à plusieurs niveaux (produit, magasin, région), la réconciliation hiérarchique garantit que les totaux sont cohérents.
Orchestration, suivi d'expériences et monitoring
Les prévisions sortent à date fixe via un orchestrateur (Airflow, Dagster, Prefect, ou les outils de Databricks et des clouds). MLflow ou un équivalent garde la trace des modèles et des backtests. Une fois les vraies valeurs connues, l'erreur est calculée et suivie par segment, avec une alerte quand elle dérive.
Le poste se trouve sous plusieurs intitulés : ML engineer prévision, data scientist forecasting, ingénieur machine learning séries temporelles. La frontière avec le data scientist est floue ; l'annonce penche vers le ML engineer dès qu'elle parle de mise en production, de réentraînement planifié et de suivi des prévisions. Les employeurs sont des distributeurs, des énergéticiens, des acteurs du transport et de la logistique, des banques et des éditeurs de logiciels de planification. Les questions techniques restent les mêmes d'un secteur à l'autre : protocole de backtest, choix des métriques, gestion de milliers de séries, surveillance de l'erreur.
La grille de compétences d'un ML engineer séries temporelles
- Backtesting et protocole d'évaluation
- Modèles globaux et variables temporelles
- Métriques et prévision probabiliste
- Hiérarchies, ruptures et cas particuliers
- Industrialisation et réentraînement planifié
- Suivi de la qualité des prévisions
Des prévisions relancées chaque semaine, sujet par sujet
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Votre modèle affiche 4 % d'erreur en validation et 15 % le premier mois de production. Quelle fuite cherchez-vous en premier ?
Une bonne réponseUn découpage aléatoire ou une validation croisée classique qui mélange passé et futur. Puis les variables connues seulement après coup : météo observée au lieu de la météo prévue, moyennes glissantes qui incluent la valeur à prévoir, retards plus courts que l'horizon, données corrigées après publication. La correction passe par un backtest sur origine glissante qui reproduit exactement les conditions de la production, avec les données telles qu'elles étaient connues à chaque date.
Signal d'alerte« Le modèle a surappris, on ajoute de la régularisation », sans chercher de fuite. Ou ne pas voir le problème d'un découpage aléatoire sur des séries temporelles.
Question 2 · confirmé
Vous devez prévoir les ventes de 30 000 références dans 200 magasins. Un modèle par série ou un modèle global ?
Une bonne réponseUn modèle global, de type LightGBM, entraîné sur toutes les séries avec des variables d'identification (famille, magasin), des retards, le calendrier, les prix et les promotions. Il partage l'information entre séries, aide les séries courtes et s'entraîne en une fois. La personne le compare dans le backtest à une référence locale (ETS ou naïf saisonnier) et traite à part les ventes intermittentes et les nouveaux produits.
Signal d'alerteSix millions de modèles ARIMA réglés un par un, ou un réseau de neurones lancé sans aucune référence simple pour comparer.
Question 3 · junior à confirmé
Le métier suit la qualité des prévisions avec le MAPE. Pourquoi cela peut-il vous tromper, et que proposez-vous ?
Une bonne réponseLe MAPE n'est pas défini quand la valeur réelle vaut zéro et explose sur les petits volumes ; il pénalise davantage la surprévision que la sous-prévision et pousse vers des prévisions trop basses. Il propose le WAPE pour un suivi agrégé, le MASE pour comparer à une prévision naïve, le suivi du biais, et la pinball loss si l'on prévoit des quantiles. Le choix se fait avec le métier selon le coût d'une erreur.
Signal d'alerte« On prend le RMSE parce que c'est le standard », sans lien avec l'usage. Aucune comparaison à une prévision naïve.
Question 4 · confirmé
Comment décidez-vous de réentraîner un modèle de prévision : à date fixe ou sur déclenchement ?
Une bonne réponseIl sépare la remise à jour sur données récentes avec les mêmes réglages, fréquente et peu coûteuse, du réglage complet du modèle, plus rare. Le calendrier suit l'arrivée des données. Un déclenchement s'ajoute quand l'erreur suivie dépasse un seuil par rapport à la référence. Tout nouveau modèle passe d'abord un backtest contre le modèle en service (champion et challenger), avec versionnage dans MLflow ou équivalent.
Signal d'alerteUn réentraînement automatique chaque nuit mis en production sans comparaison, ou un modèle jamais réentraîné depuis sa livraison.
Question 5 · confirmé
Le planificateur vous demande combien de stock commander. Une prévision ponctuelle suffit-elle ?
Une bonne réponseNon : il faut une prévision en quantiles ou en intervalles, car le stock de sécurité dépend de l'incertitude. Il cite la régression quantile (objectif quantile de LightGBM), les modèles qui sortent des distributions (DeepAR, TFT), la prédiction conforme, et la pinball loss pour l'évaluation. Il vérifie la couverture : un intervalle à 90 % doit contenir environ 90 % des valeurs observées. Le quantile retenu découle du niveau de service visé.
Signal d'alerteLa prévision moyenne plus ou moins deux écarts-types en supposant une loi normale, sans vérifier la couverture.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Prévision et machine learning : réponses pour le recruteur
Comment se partagent le travail un data scientist prévision et un ML engineer séries temporelles ?
Le data scientist prévision conçoit et compare les modèles, analyse les séries et dialogue avec le métier sur les hypothèses. Le ML engineer séries temporelles fait tourner ces prévisions en production : pipelines planifiés, réentraînement, versionnage, surveillance de l'erreur, livraison aux outils de planification. Beaucoup d'équipes recrutent un profil qui couvre les deux. L'entretien doit alors vérifier la partie production, souvent la moins développée chez les candidats venus de la data science.
Quelles bibliothèques attendre sur le CV d'un ML engineer séries temporelles ?
En Python, pandas ou polars, LightGBM, et au moins une bibliothèque dédiée : statsforecast, mlforecast et neuralforecast chez Nixtla, Darts, sktime ou PyTorch Forecasting. Côté production, un orchestrateur (Airflow, Dagster, Prefect), MLflow et souvent Spark ou Databricks quand les séries se comptent en millions. La liste compte moins que la méthode : demandez comment le backtest a été construit sur le dernier projet.
À quoi peut ressembler le test technique d'un poste en prévision ?
Un jeu de données de ventes ou de consommation, quelques centaines de séries, et une consigne simple : battre une prévision naïve saisonnière à quatre semaines. Comptez deux à trois heures, puis une restitution orale. Regardez le découpage temporel, le choix de la métrique, la comparaison aux références et la façon dont la personne explique ses erreurs, bien plus que le score final.
Les modèles de fondation pour séries temporelles changent-ils le profil recherché ?
Ils ajoutent une option, sans remplacer la méthode. TimesFM, Chronos ou TimeGPT donnent des prévisions sans entraînement, utiles pour des séries courtes ou un démarrage rapide. Le métier reste le même : les comparer aux références dans un backtest honnête, intégrer les variables propres à l'entreprise (promotions, prix, calendrier local) et surveiller l'erreur en production. Un candidat qui les connaît et sait les évaluer a un atout.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.