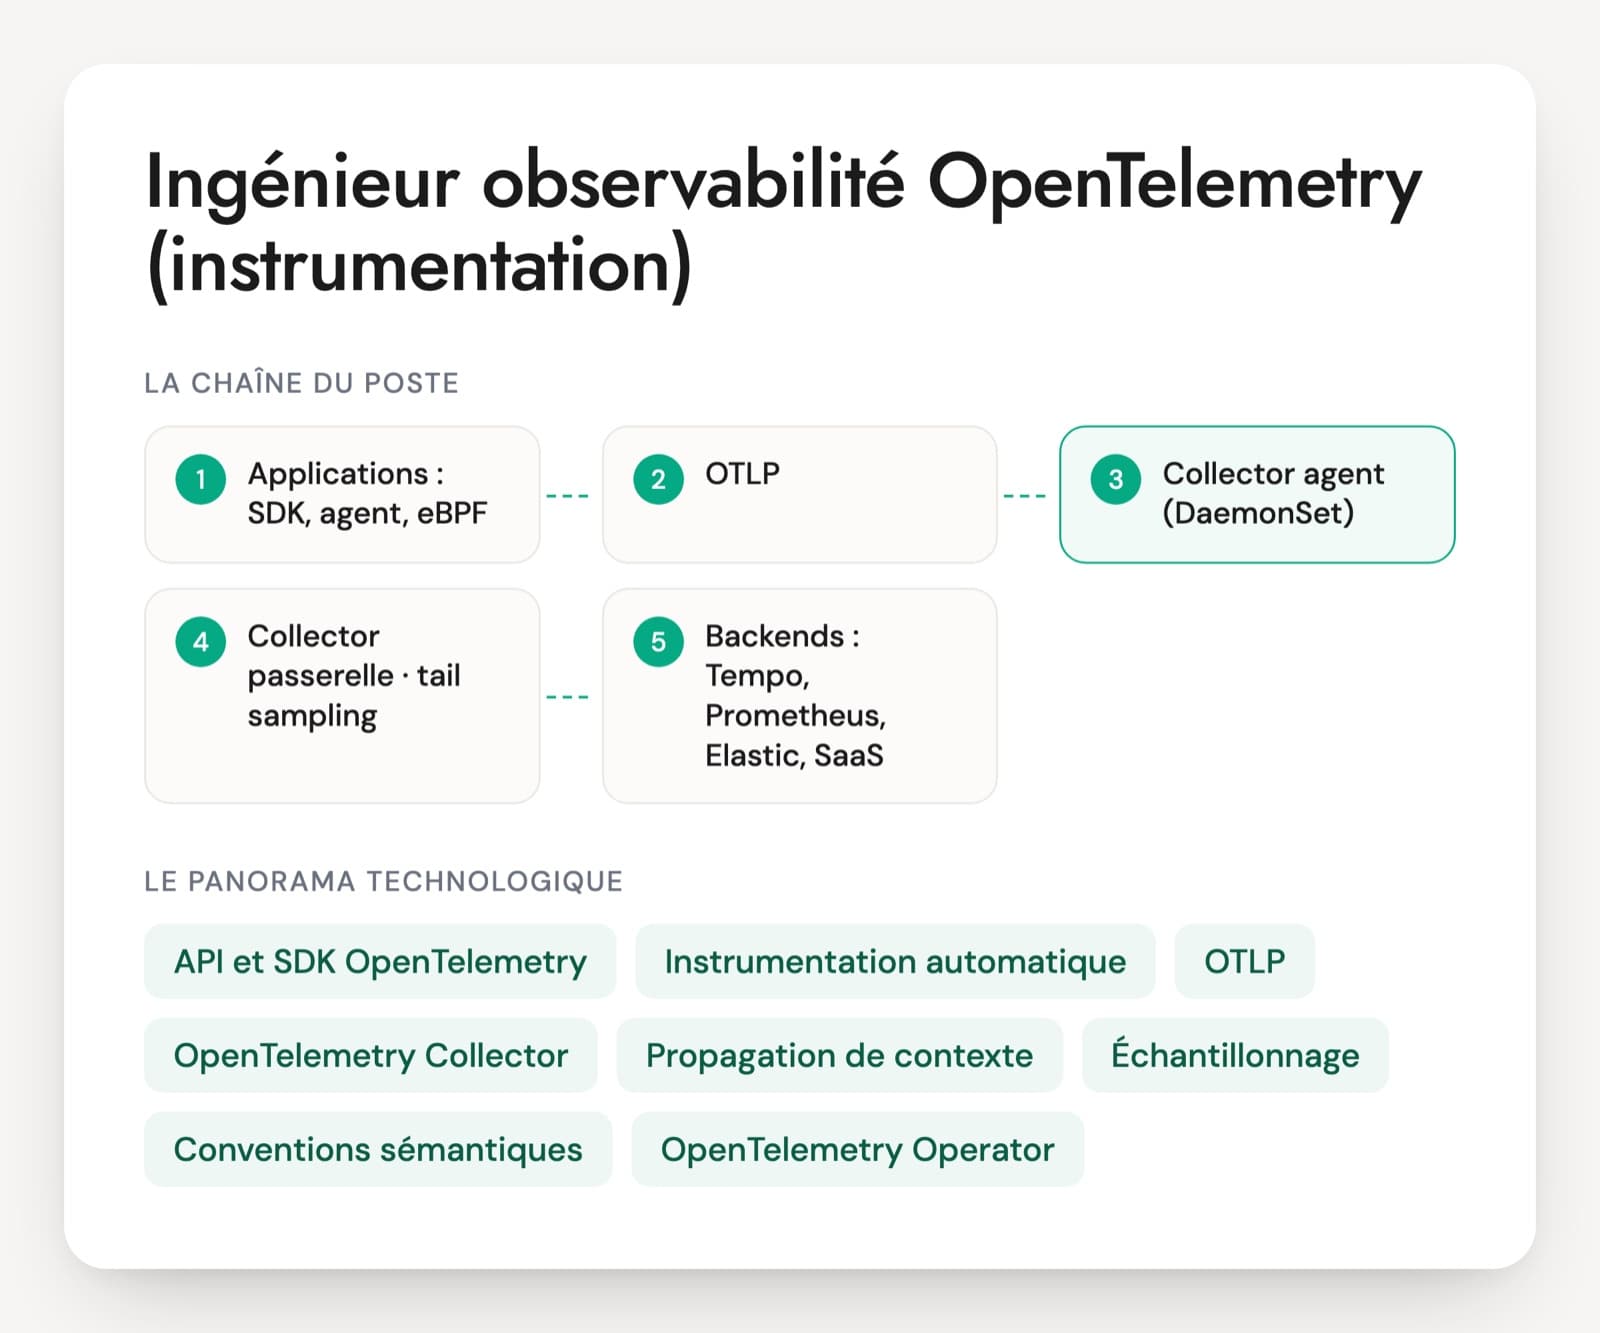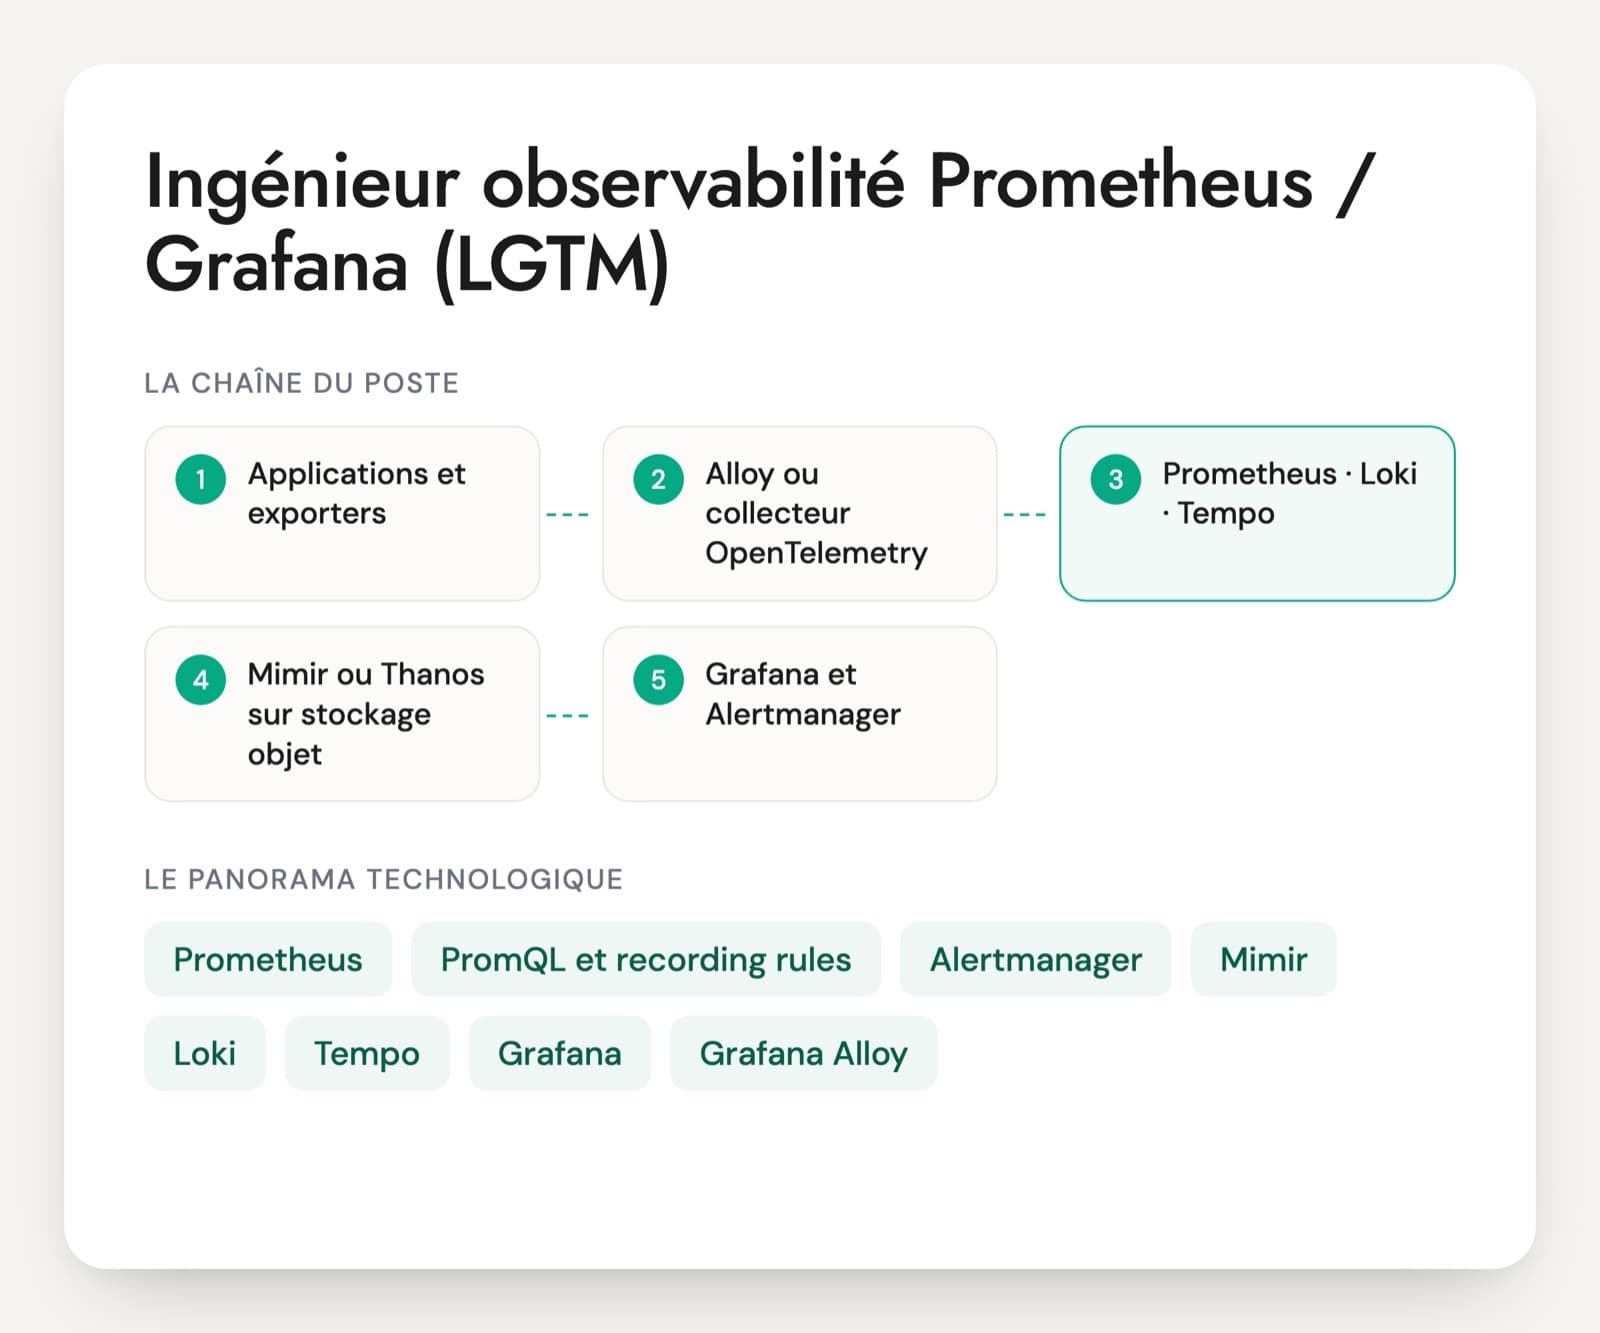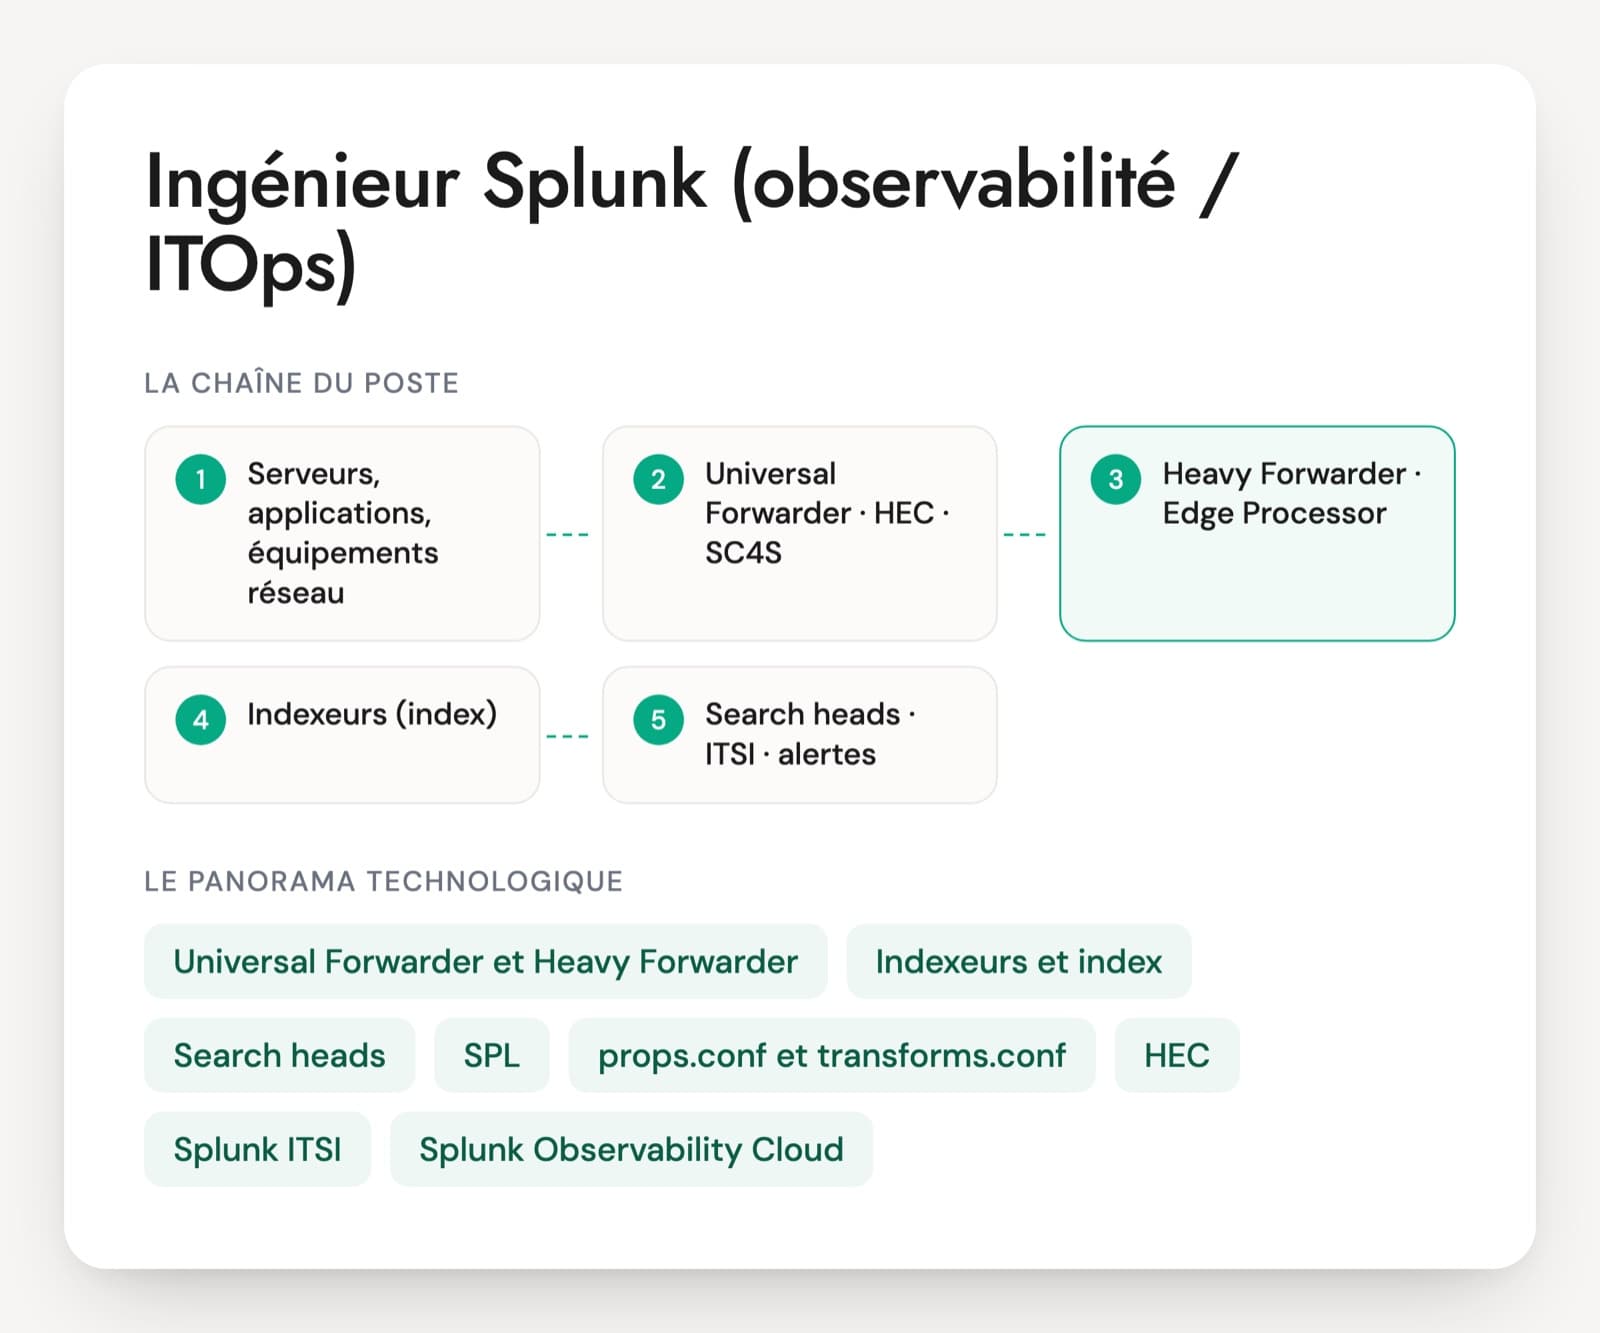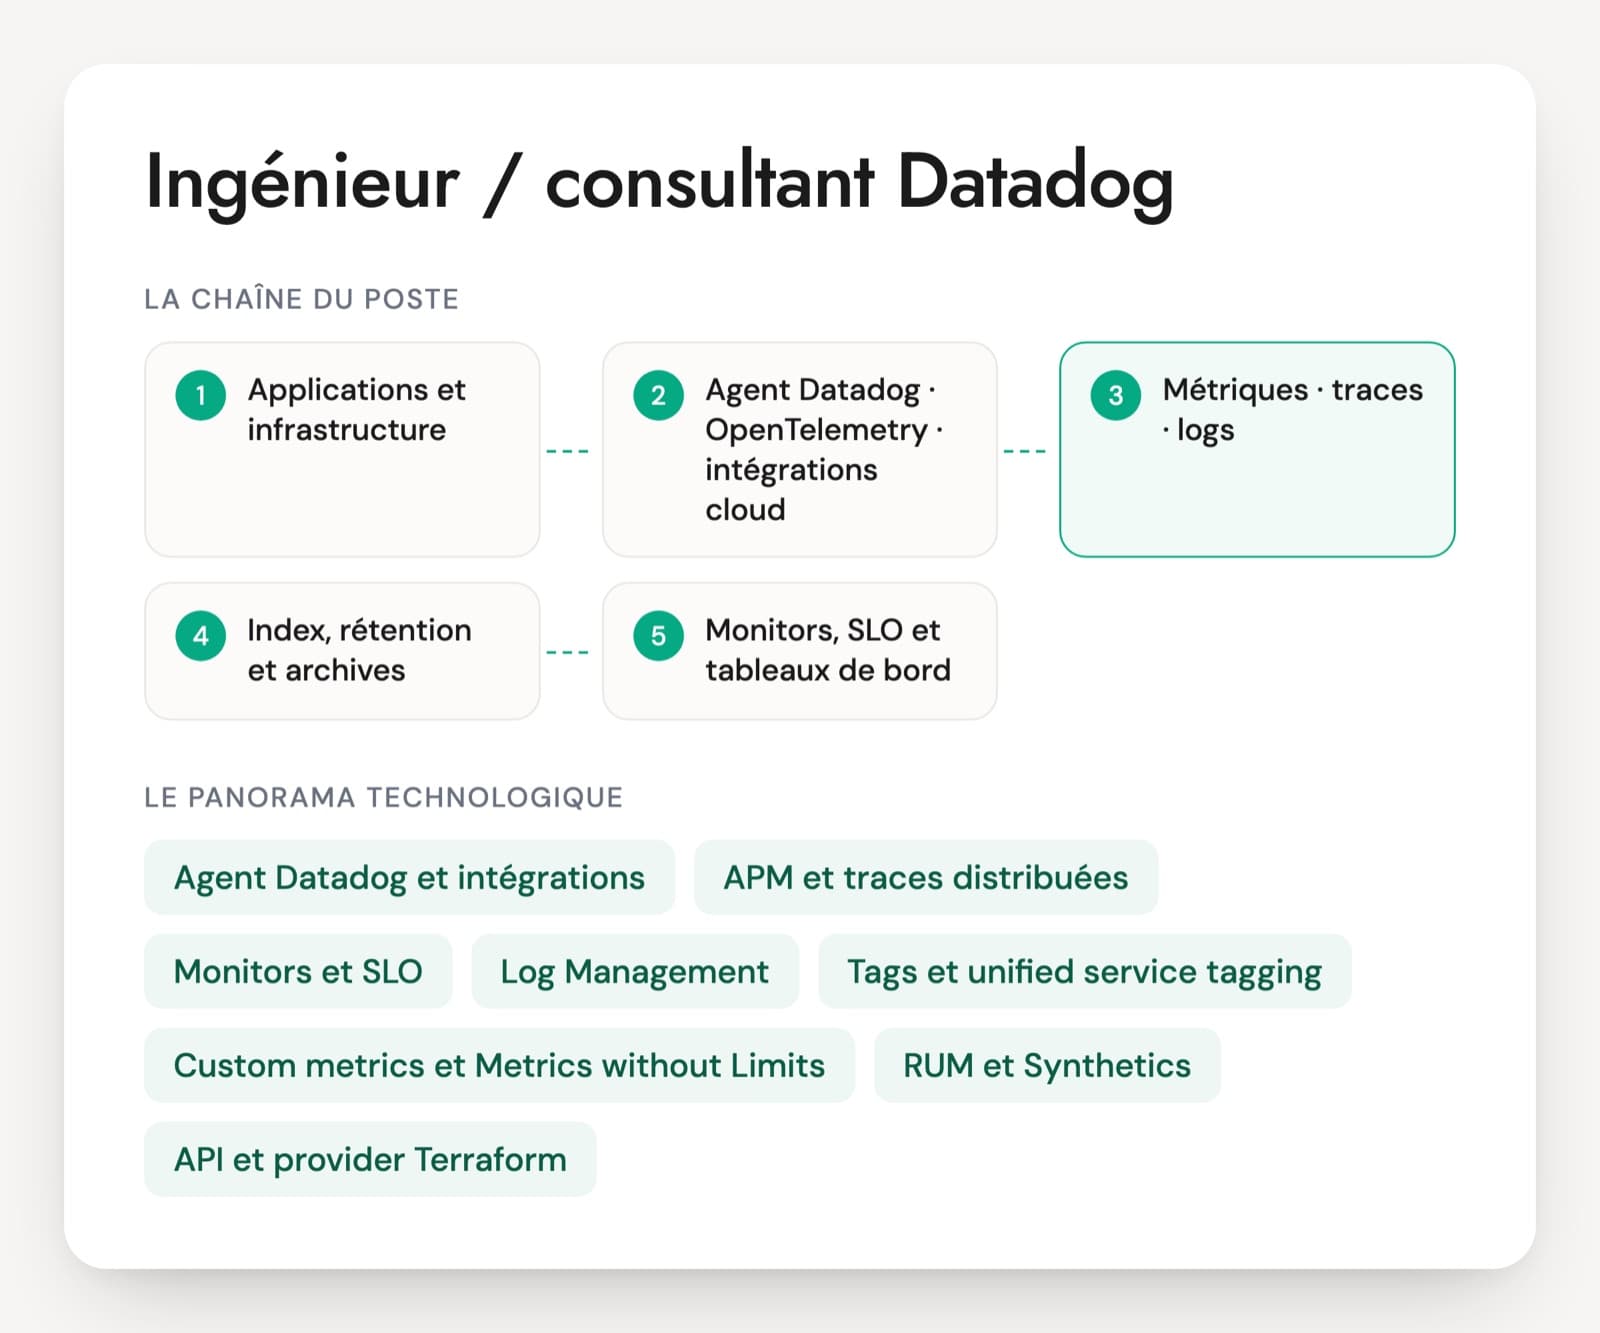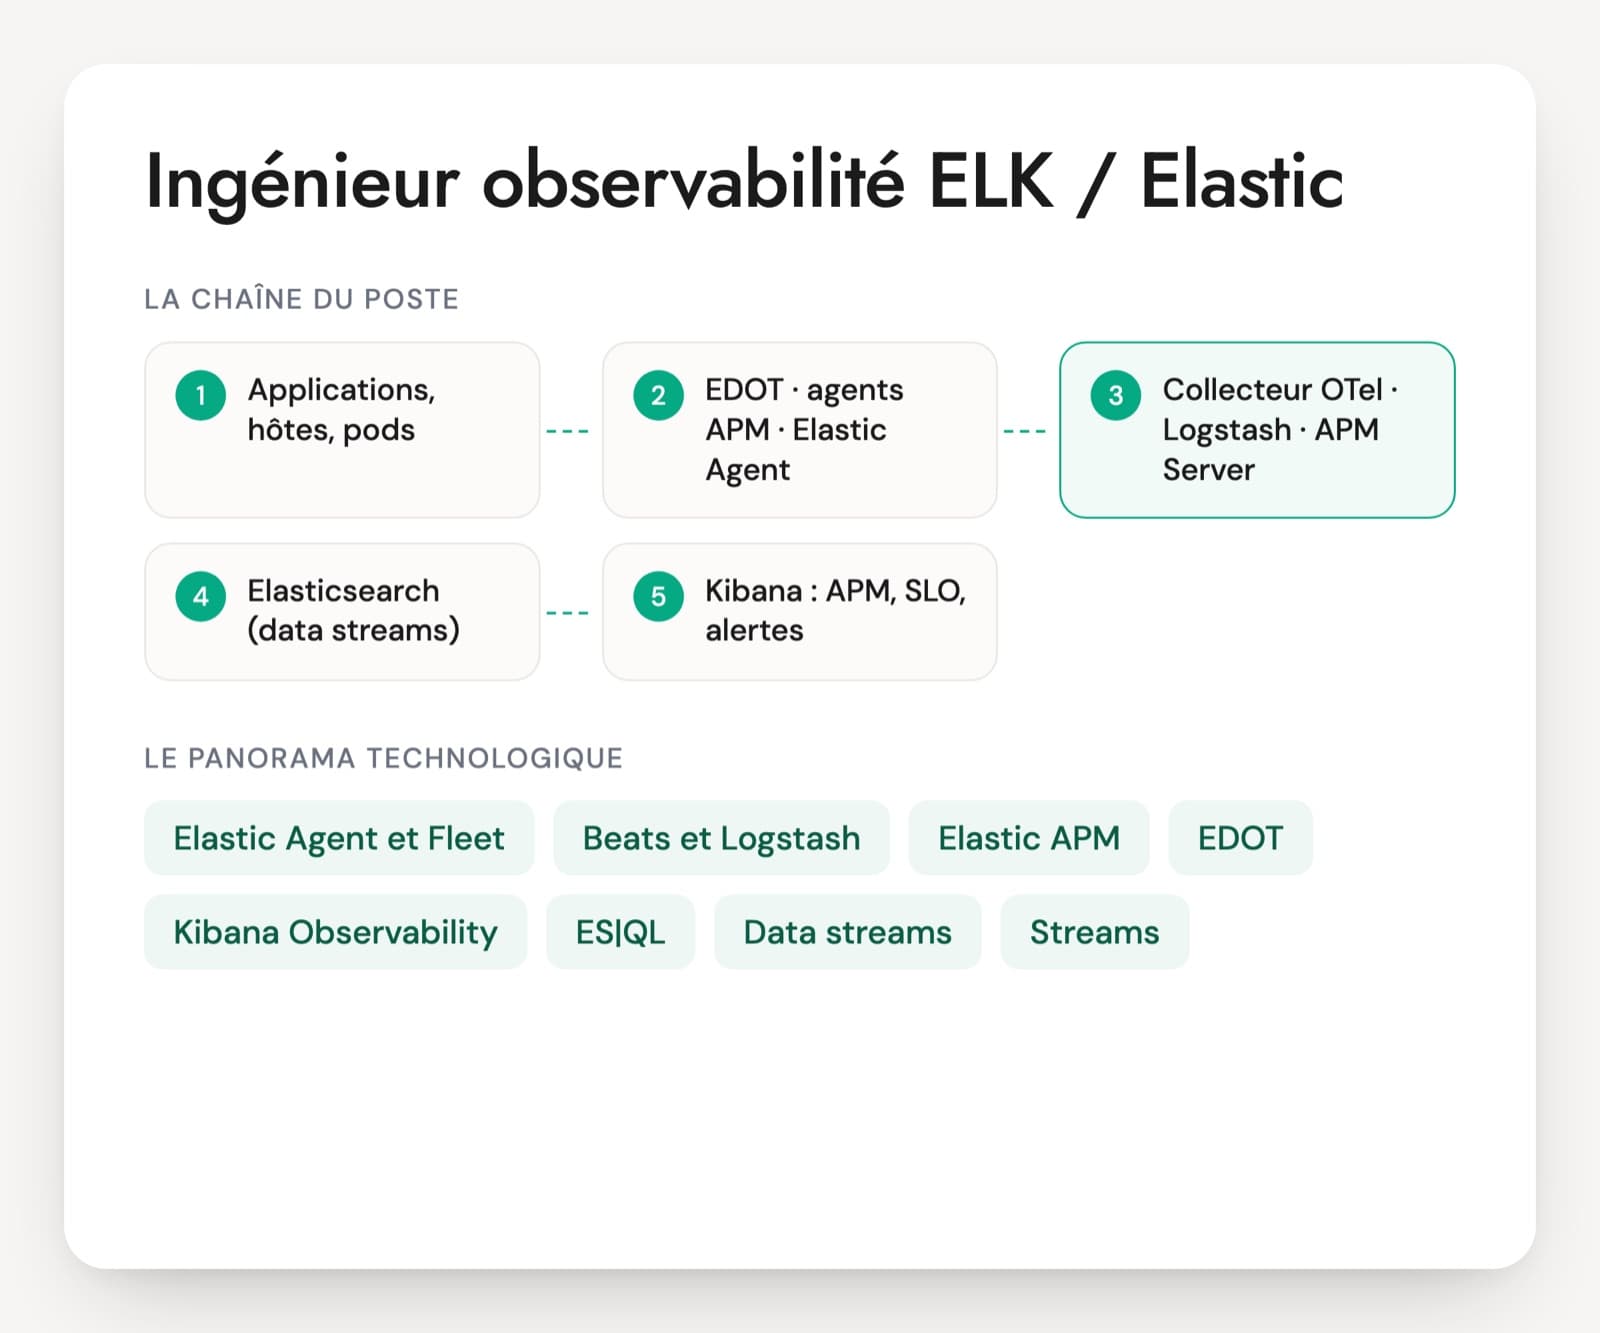
Les annonces parlent de consultant ELK, d'ingénieur ELK ou d'ingénieur observabilité Elastic. Le travail consiste à collecter les logs de dizaines d'applications, instrumenter les services avec Elastic APM ou OpenTelemetry, construire dans Kibana les vues et les règles d'alerte, et suivre des SLO. Les offres citent aussi Logstash, Kubernetes, Python ou Shell, et parfois une reprise de flux venus de Splunk.
La suite a beaucoup changé depuis la version 8. Elastic recommande maintenant ses distributions OpenTelemetry (EDOT) pour instrumenter les applications, et Elastic Cloud reçoit l'OTLP sans passer par APM Server. Depuis Elasticsearch 9.0, les nouveaux flux de logs sont stockés par défaut en mode logsdb, et Streams structure les logs depuis Kibana. Un CV qui s'arrête à Filebeat, Logstash et Kibana décrit souvent une plateforme d'avant ces changements.
Ce profil n'est pas l'administrateur Elasticsearch, qui dimensionne et répare le cluster. L'entretien porte sur une trace qui se coupe entre deux services, un log qui ne remonte pas avec son trace.id, un échantillonnage qui fausse les taux d'erreur, une alerte qui sonne pour rien. Le PDF comprend un cas de 20 minutes sur l'instrumentation d'une application.
Les outils Elastic d'une chaîne logs, métriques et traces
Elastic Agent et Fleet
Un agent par machine, piloté depuis Kibana par Fleet. On lui affecte une politique qui liste ses intégrations : logs système, Nginx, PostgreSQL, Kubernetes, AWS. Il remplace peu à peu les Beats installés un par un, et embarque le collecteur EDOT depuis la version 9.5.
Beats et Logstash
Filebeat et Metricbeat restent très présents dans les parcs existants. Logstash transforme et met en tampon quand les sources sont variées (syslog, files de messages, bases) ou qu'il faut router vers plusieurs destinations. Beaucoup de missions commencent par la reprise de ces chaînes.
Elastic APM
Le suivi des performances applicatives : transactions, spans, erreurs et carte des services dans Kibana. Les agents APM historiques (Java, .NET, Node.js, Python, Go) envoient leurs données à APM Server. L'échantillonnage des traces se règle côté agent, ou côté serveur pour l'échantillonnage en queue.
EDOT (OpenTelemetry)
Les distributions OpenTelemetry d'Elastic : des SDK pour Java, .NET, Node.js, Python, PHP, Android et iOS, et un collecteur. Elastic les recommande pour les nouvelles applications. Les données gardent les conventions OpenTelemetry, ce qui change les noms de champs et les tableaux de bord par rapport aux intégrations historiques.
Kibana Observability
Les applications de Kibana pour l'exploitation : Discover pour les logs, APM pour les services, Infrastructure pour les hôtes et les pods, SLO, règles d'alerte et connecteurs vers Teams, PagerDuty ou ServiceNow. C'est l'écran que les équipes ouvrent pendant un incident.
ES|QL
Le langage de requête par étapes d'Elasticsearch, utilisé dans Discover, les tableaux de bord et les règles d'alerte. Il filtre, calcule et regroupe logs et métriques en une seule requête lisible. Un profil à jour l'utilise à la place de nombreuses agrégations écrites en JSON.
Data streams, logsdb et TSDS
Logs, métriques et traces arrivent dans des data streams nommés par type, jeu de données et espace de noms, par exemple logs-nginx.access-default. Le mode logsdb compacte le stockage des logs, les TSDS font de même pour les métriques. Le coût de la plateforme dépend beaucoup de ces choix.
Streams
Une fonction de Kibana, en disponibilité générale depuis la version 9.2, qui structure les logs depuis l'interface : extraction de champs, rétention par flux, découpage en flux enfants (encore en préversion). Peu de candidats l'ont déjà en production, mais elle reprend une partie du travail fait avant en pipelines d'ingestion et en motifs Grok.
Synthetics et RUM
Les moniteurs synthétiques rejouent une URL ou un parcours dans un navigateur depuis des emplacements gérés par Elastic ou privés. Le RUM mesure les vraies pages côté utilisateur. Ils couvrent ce que l'APM côté serveur ne voit pas.
Le poste se trouve sous plusieurs titres : ingénieur observabilité Elastic, ingénieur ELK, consultant ELK / Kibana, parfois SRE. Selon l'équipe, la personne opère aussi le cluster ou s'appuie sur Elastic Cloud et une équipe plateforme. Les missions mêlent collecte de logs, APM, tableaux de bord pour les équipes applicatives et appui pendant les incidents. OpenSearch apparaît dans certaines offres, avec Data Prepper et OpenSearch Dashboards à la place des outils Elastic. Elastic propose une certification Elastic Certified Observability Engineer, passée sur un environnement réel. Elle atteste la pratique de la suite ; l'expérience de production se vérifie en entretien.
Les compétences d'observabilité à vérifier sur la suite Elastic
- Collecte des logs et des métriques
- Instrumentation APM et OpenTelemetry
- Corrélation logs, traces et métriques
- Requêtes ES|QL et tableaux de bord
- Alertes et SLO dans Kibana
- Volume, échantillonnage et coût des données
Questions d'entretien sur Elastic APM, OpenTelemetry et les logs
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Dans Kibana, la trace d'une commande s'arrête au service panier, alors que celui-ci appelle ensuite le service paiement. Que cherchez-vous ?
Une bonne réponseLa propagation du contexte de trace. Le service paiement est-il instrumenté ? L'appel passe-t-il par un composant qui retire les en-têtes, comme une passerelle ou un proxy ? Puis le format : les agents Elastic récents et OpenTelemetry utilisent W3C Trace Context (l'en-tête traceparent), un agent ancien ou mal configuré peut ne pas le lire ou ne pas l'émettre. Enfin l'échantillonnage : un service qui ne suit pas la décision de son appelant garde ou jette sa partie seul, et la trace paraît coupée.
Signal d'alerteRedémarrer APM Server ou augmenter la rétention, sans jamais parler de propagation du contexte.
Question 2 · junior à confirmé
Les équipes veulent passer de la trace au log de la même requête en un clic. Que faut-il mettre en place ?
Une bonne réponseChaque ligne de log doit porter trace.id et span.id. Avec les agents Elastic, la corrélation des logs les injecte dans le contexte de logging (active d'office ou à activer selon l'agent) ; avec OpenTelemetry, le pont de logs du SDK s'en charge. Les logs doivent aussi porter le même nom de service et le même environnement que les traces. Un format JSON, par exemple avec les bibliothèques ECS logging, évite de reparser le message. Kibana relie ensuite les deux dans la vue de la transaction.
Signal d'alerteChercher le log par horodatage autour de l'heure de la trace, ou ajouter un identifiant maison que Kibana ne sait pas relier.
Question 3 · confirmé
Une équipe démarre un nouveau service Java. L'instrumentez-vous avec l'agent APM Elastic ou avec OpenTelemetry, et comment les données arrivent-elles dans Elastic ?
Une bonne réponsePour un nouveau service, Elastic recommande sa distribution OpenTelemetry (EDOT Java), avec un export OTLP vers un collecteur EDOT ou vers le point d'entrée OTLP managé d'Elastic Cloud, sans APM Server. La personne cite les conséquences : données stockées selon les conventions OpenTelemetry et non plus ECS, tableaux de bord et requêtes à adapter, paquets de contenu OpenTelemetry à installer. Garder l'agent Elastic classique reste défendable pour rester homogène avec un parc existant. Dans les deux cas, service.name, la version et l'environnement sont posés dès le départ.
Signal d'alerteUn choix sans argument, ou l'idée que l'agent APM et OpenTelemetry produisent exactement les mêmes champs dans Kibana.
Question 4 · senior
Pour réduire le volume, une équipe a passé l'échantillonnage des traces à 10 %. Le taux d'erreur affiché dans Kibana est-il encore juste ?
Une bonne réponseAvec un échantillonnage en tête, Elastic pondère les métriques de transaction par l'inverse du taux : chaque trace gardée compte pour dix. Débits et taux d'erreur restent des estimations, moins fiables sur les services à faible trafic, et des traces d'erreurs rares peuvent manquer. Pour garder toutes les traces en erreur ou lentes, la personne propose un échantillonnage en queue dans APM Server ou dans un collecteur, avec son coût (disque local pour APM Server, mémoire pour un collecteur) et la contrainte de réunir toutes les spans d'une trace au même endroit.
Signal d'alerte« Le taux d'erreur est divisé par dix », ou aucune différence faite entre échantillonnage en tête et en queue.
Question 5 · confirmé
Une règle d'alerte Kibana sur le taux d'erreur d'un service se déclenche plusieurs fois par jour pour des pics d'une minute. Comment la réécrivez-vous ?
Une bonne réponseUne fenêtre d'évaluation plus large, un délai qui exige plusieurs vérifications consécutives au-dessus du seuil, et un nombre minimal de requêtes pour ignorer les creux de trafic. Mieux, un SLO sur le service avec une alerte sur la vitesse de consommation du budget d'erreur, sur une fenêtre courte et une longue. Les alertes sont regroupées par service et par environnement, et les connecteurs envoient chaque type d'alerte à la bonne équipe.
Signal d'alerteMonter le seuil jusqu'à ce que l'alerte se taise, ou désactiver la règle.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
ELK et observabilité, les questions fréquentes
Ingénieur observabilité Elastic ou administrateur Elasticsearch : quelle différence ?
L'administrateur tient le cluster : nœuds, shards, montées de version, sauvegardes, performance. L'ingénieur observabilité travaille sur ce qui entre et ce qui sort : collecte, instrumentation des applications, corrélation des signaux, alertes et SLO. Sur une plateforme Elastic Cloud, le second rôle domine. Dans une petite équipe qui héberge son cluster, une même personne fait souvent les deux. L'offre suit la part de chaque activité, et les questions s'y adaptent.
Un profil OpenSearch peut-il tenir un poste Elastic Observability ?
Pour la collecte et les requêtes de base, oui : les deux outils partagent une origine commune. Les écarts portent sur l'observabilité elle-même. Elastic a son APM, ses distributions OpenTelemetry, ES|QL, Fleet, les SLO et Streams dans Kibana, qu'OpenSearch ne propose pas sous la même forme. Un profil OpenSearch solide demandera quelques semaines de prise en main. Le point décisif est sa connaissance d'OpenTelemetry, qui reste commun aux deux mondes.
Comment tester un ingénieur ELK pendant l'entretien ?
Des écrans réels valent mieux qu'un test technique à faire chez soi. Devant une trace coupée dans Kibana, la personne dit ce qu'elle vérifierait, dans l'ordre. Elle écrit ensuite une requête ES|QL courte, comme les erreurs 5xx par hôte sur une heure, puis une règle d'alerte qui ignore un pic d'une minute. Les réponses montrent vite si elle a travaillé sur une version récente de la suite et si elle part des données pour conclure.
Faut-il exiger OpenTelemetry sur le CV ?
Pour une plateforme qui démarre, c'est préférable : Elastic recommande désormais ses distributions OpenTelemetry pour instrumenter les nouvelles applications. Sur un parc existant équipé d'agents APM Elastic et de Beats, l'expérience de ces outils compte davantage à court terme. Dans les deux cas, la question porte sur la façon dont le contexte de trace se propage entre services et comment les logs sont reliés aux traces. Ces deux réponses en disent plus que la ligne du CV.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.