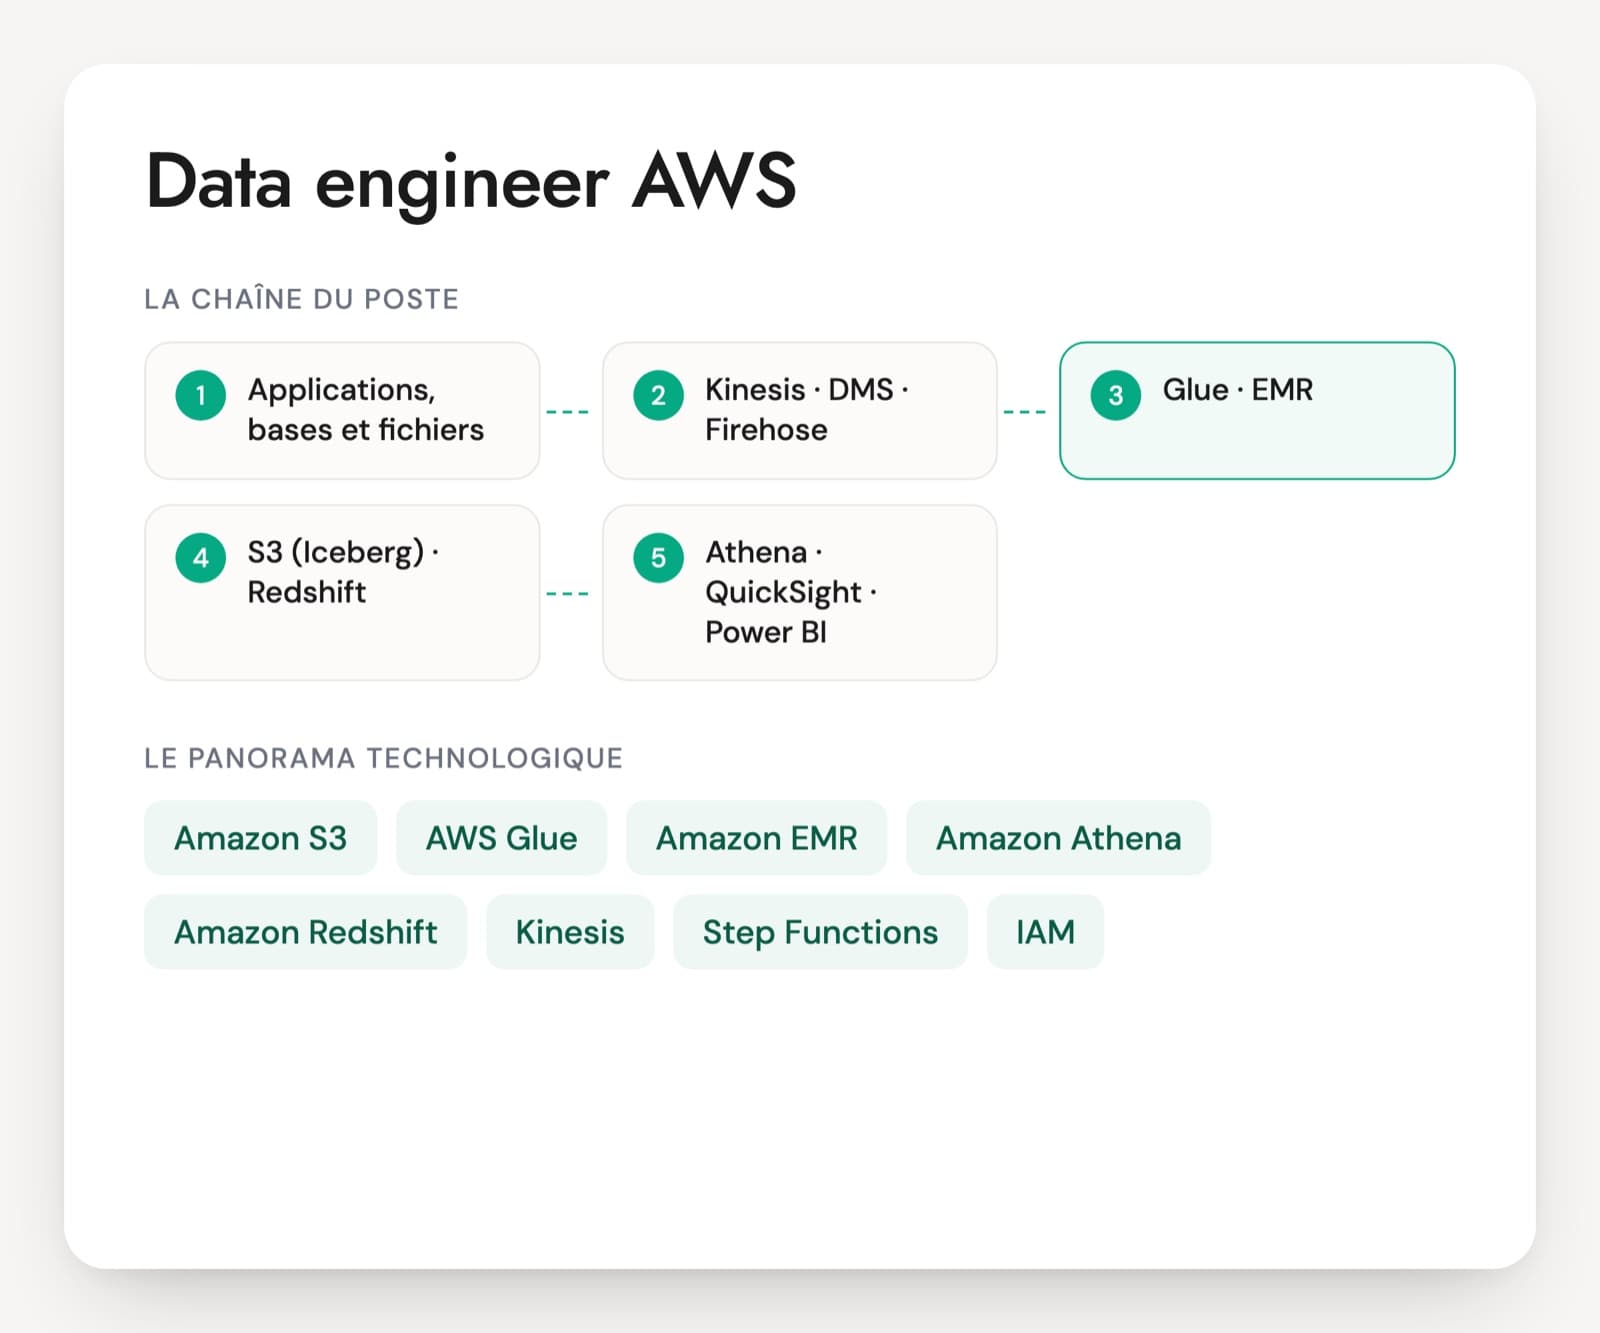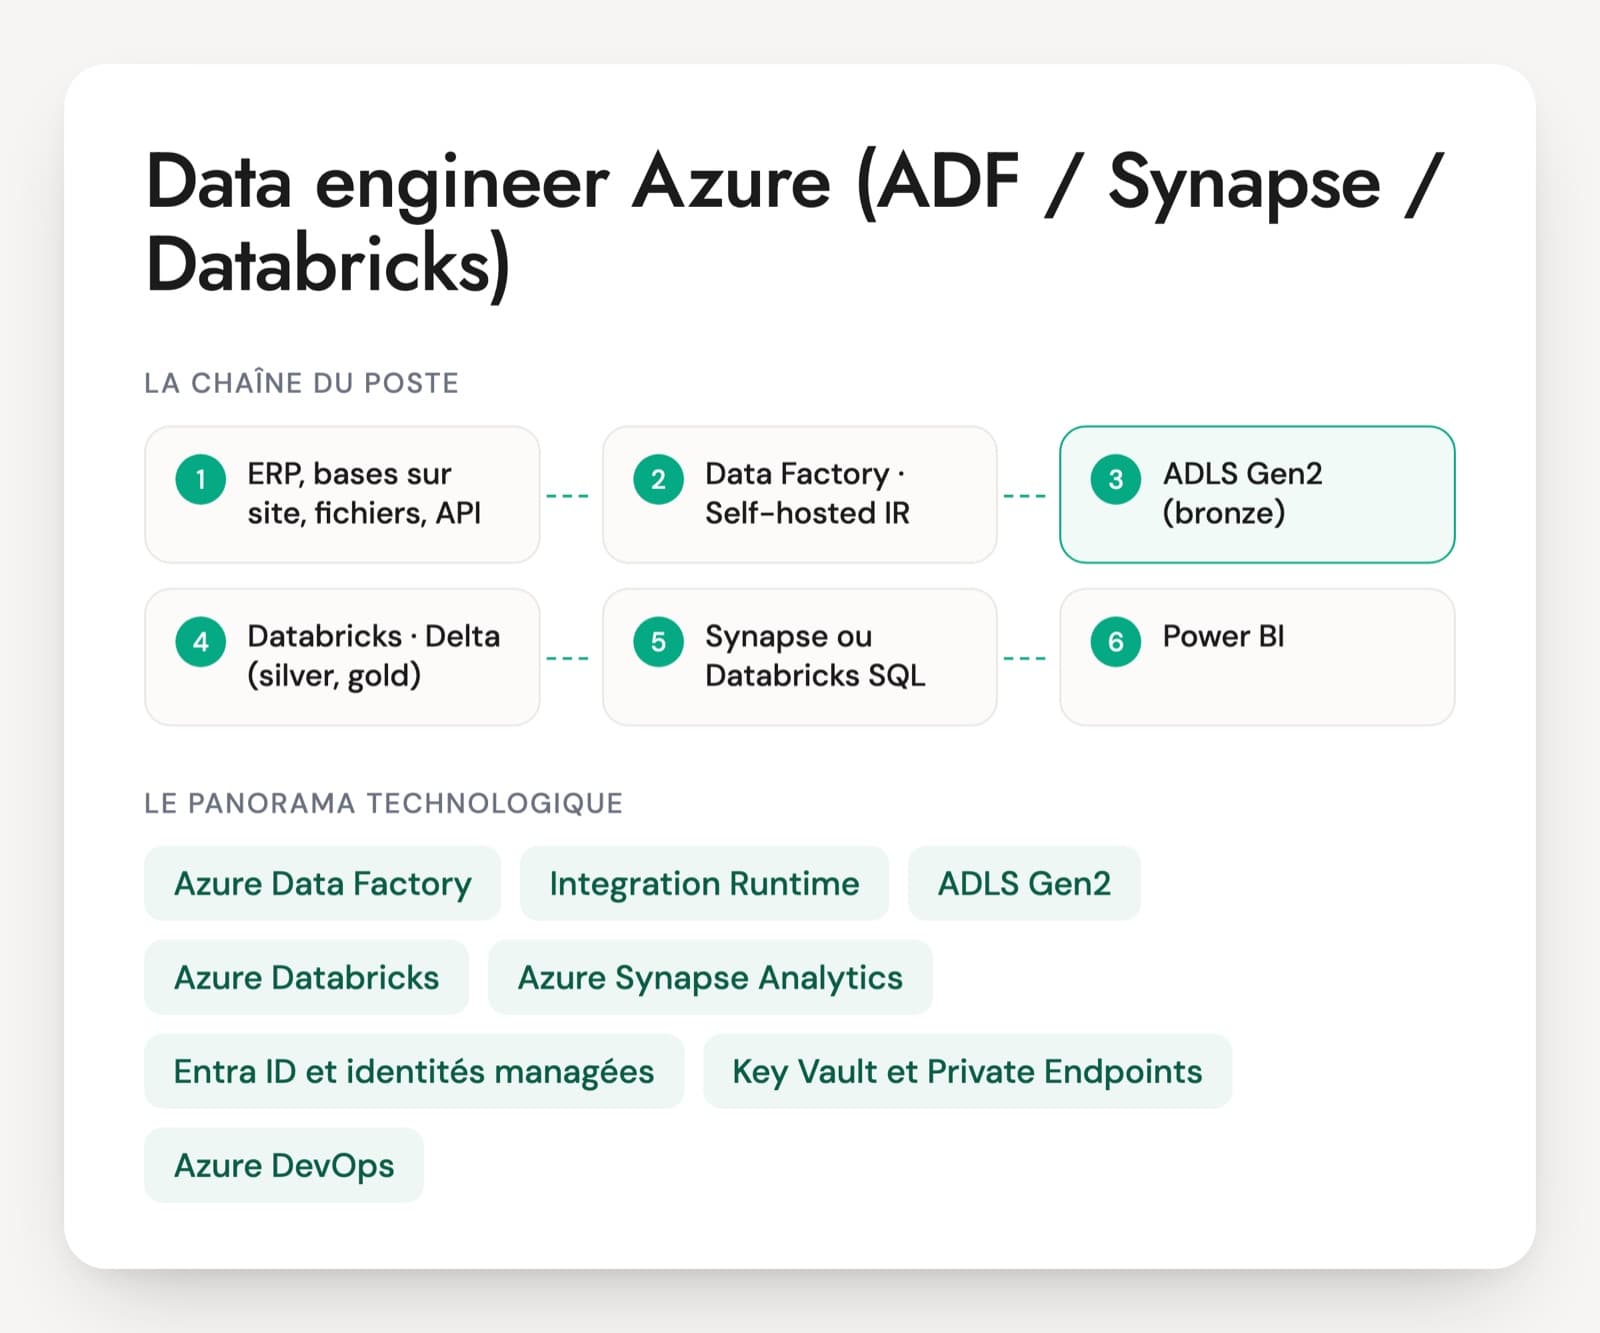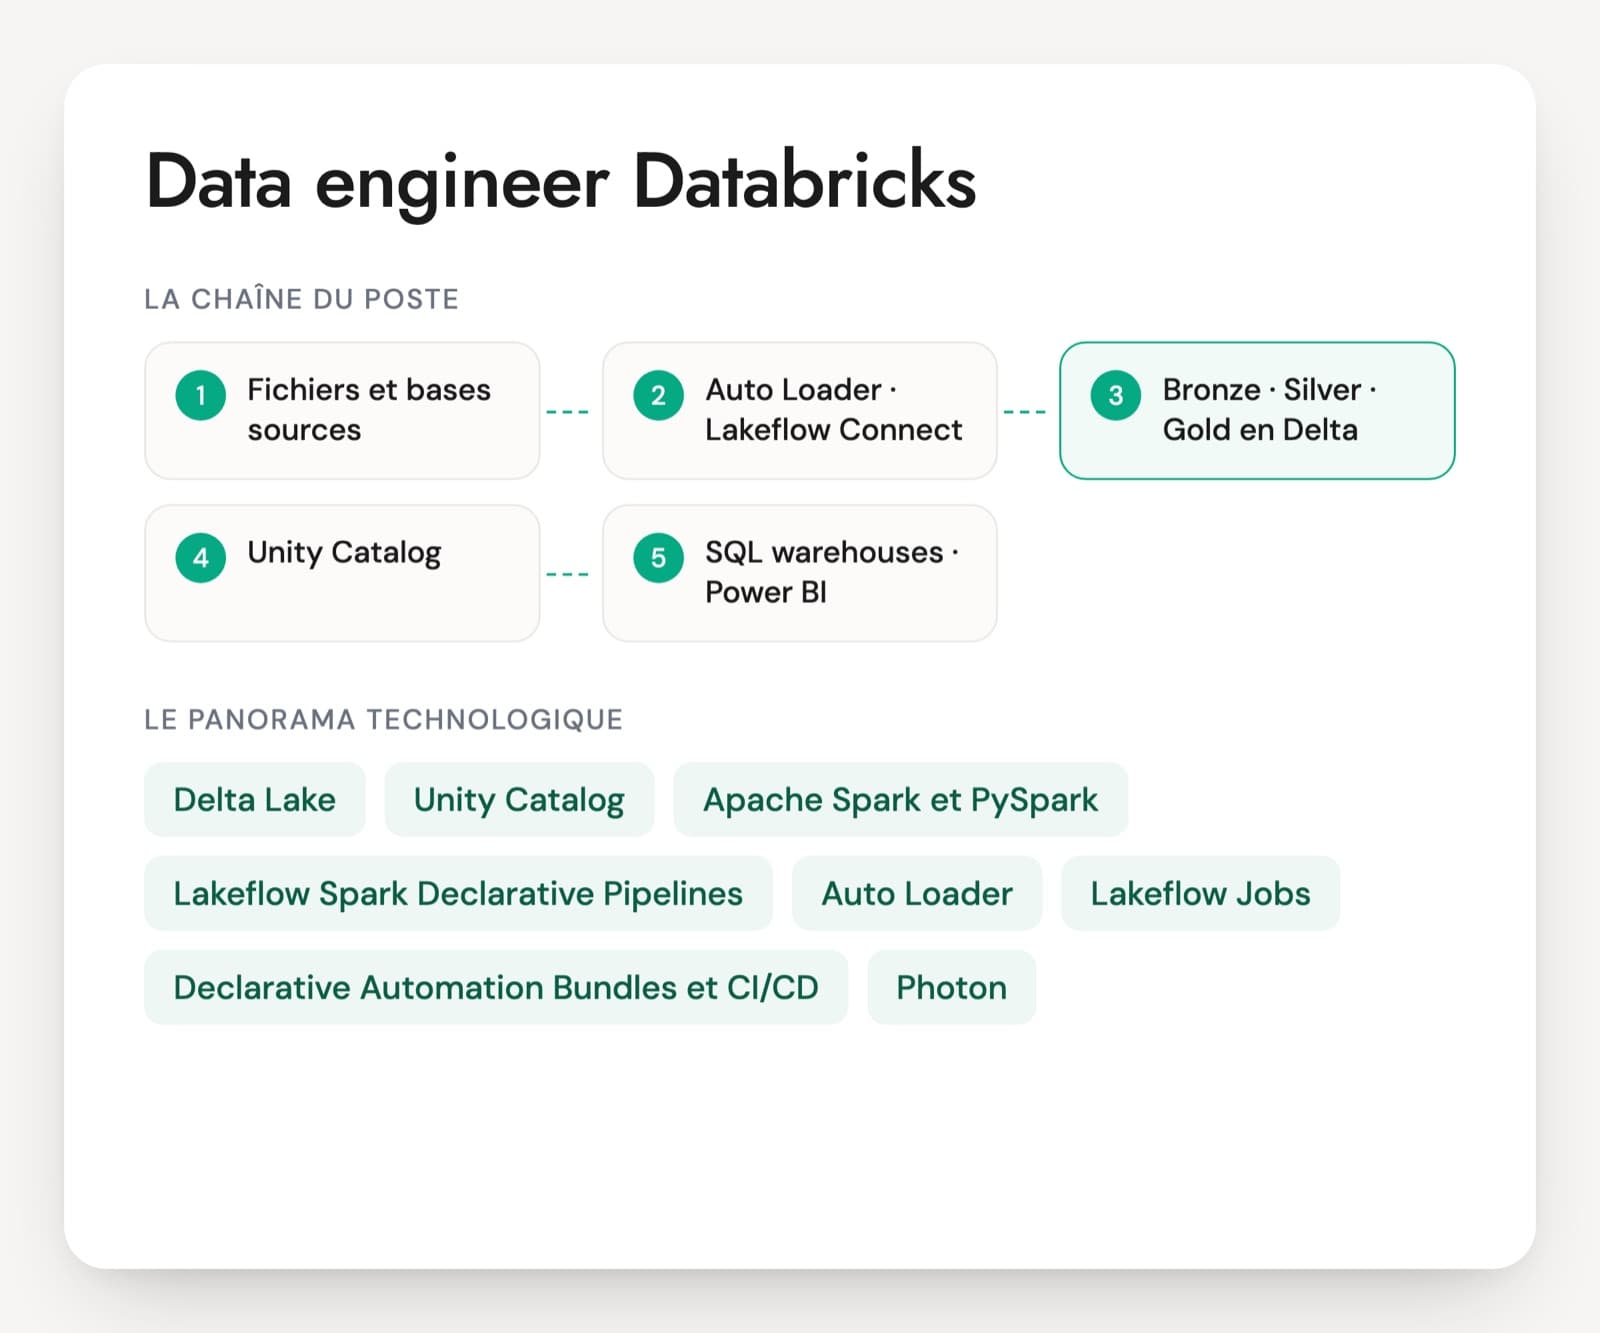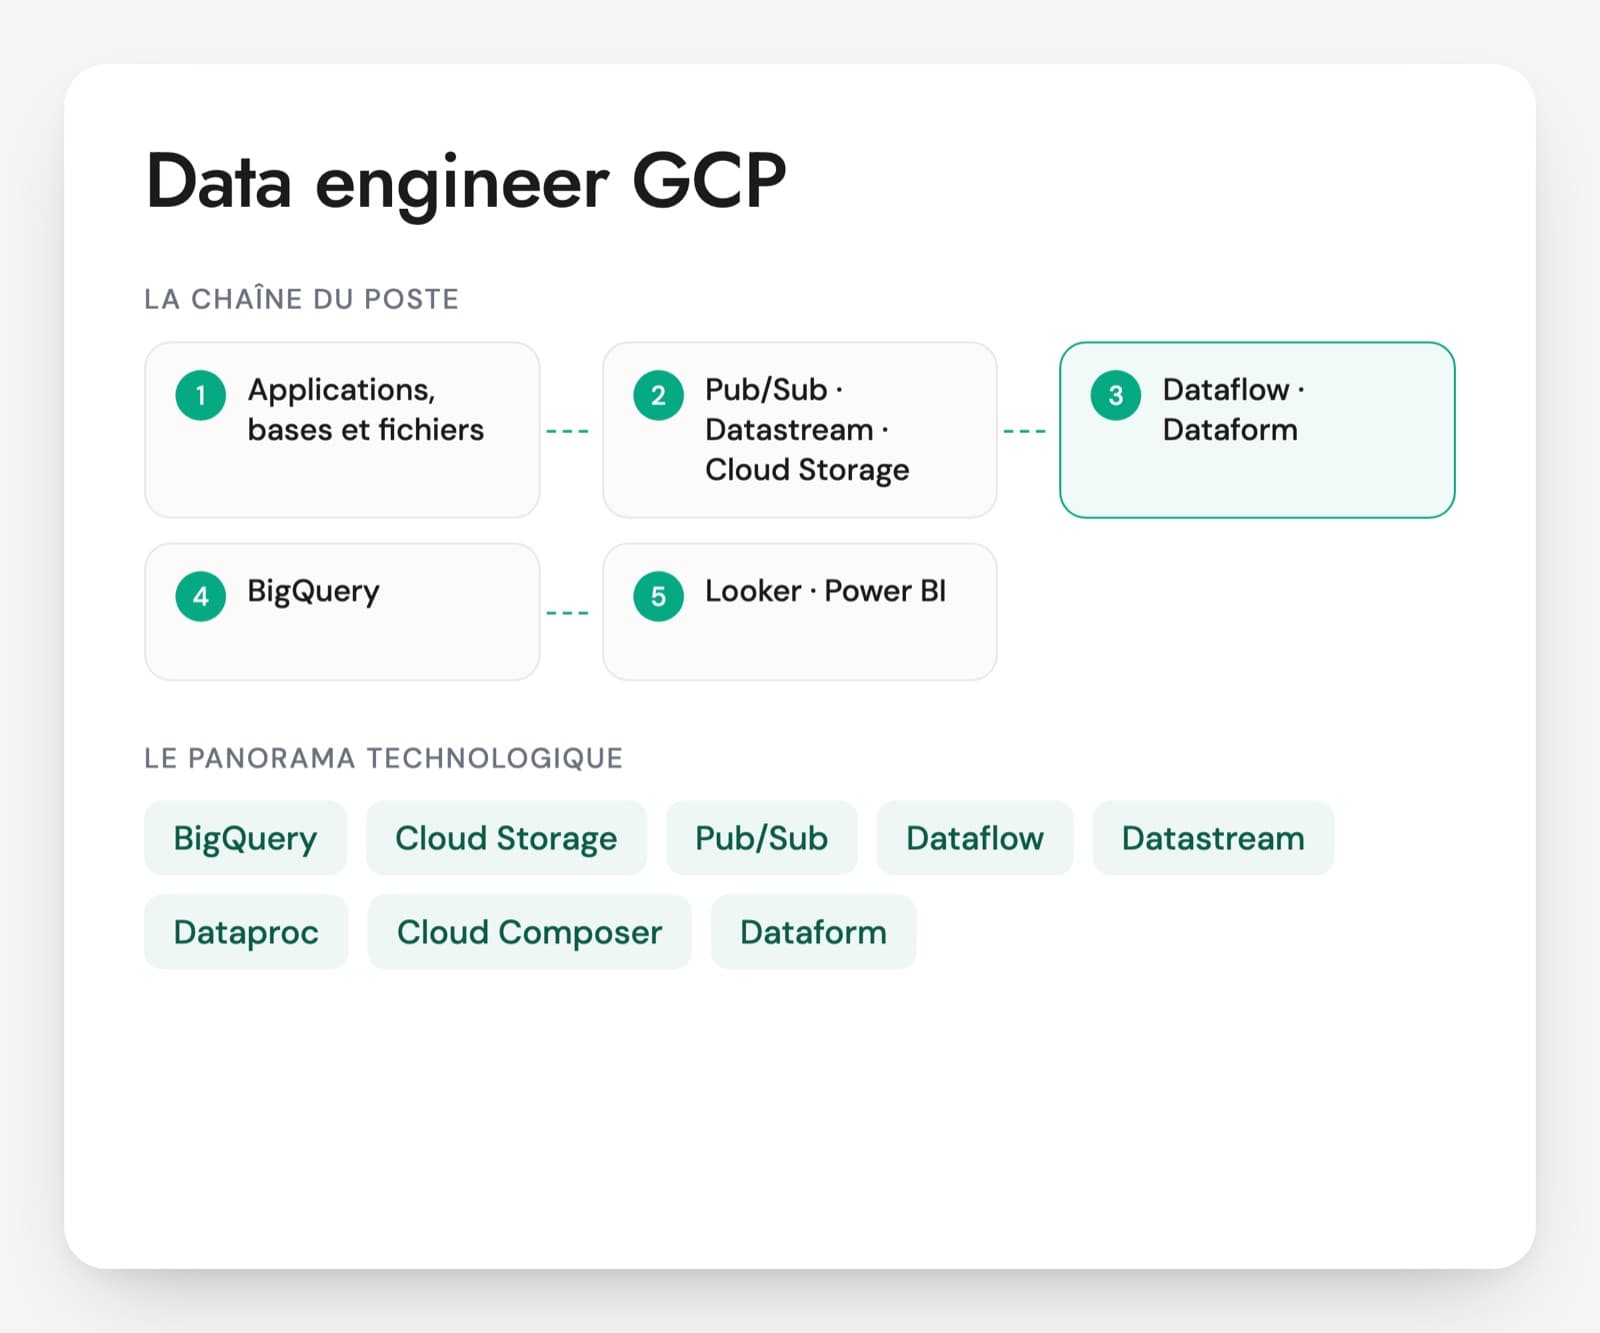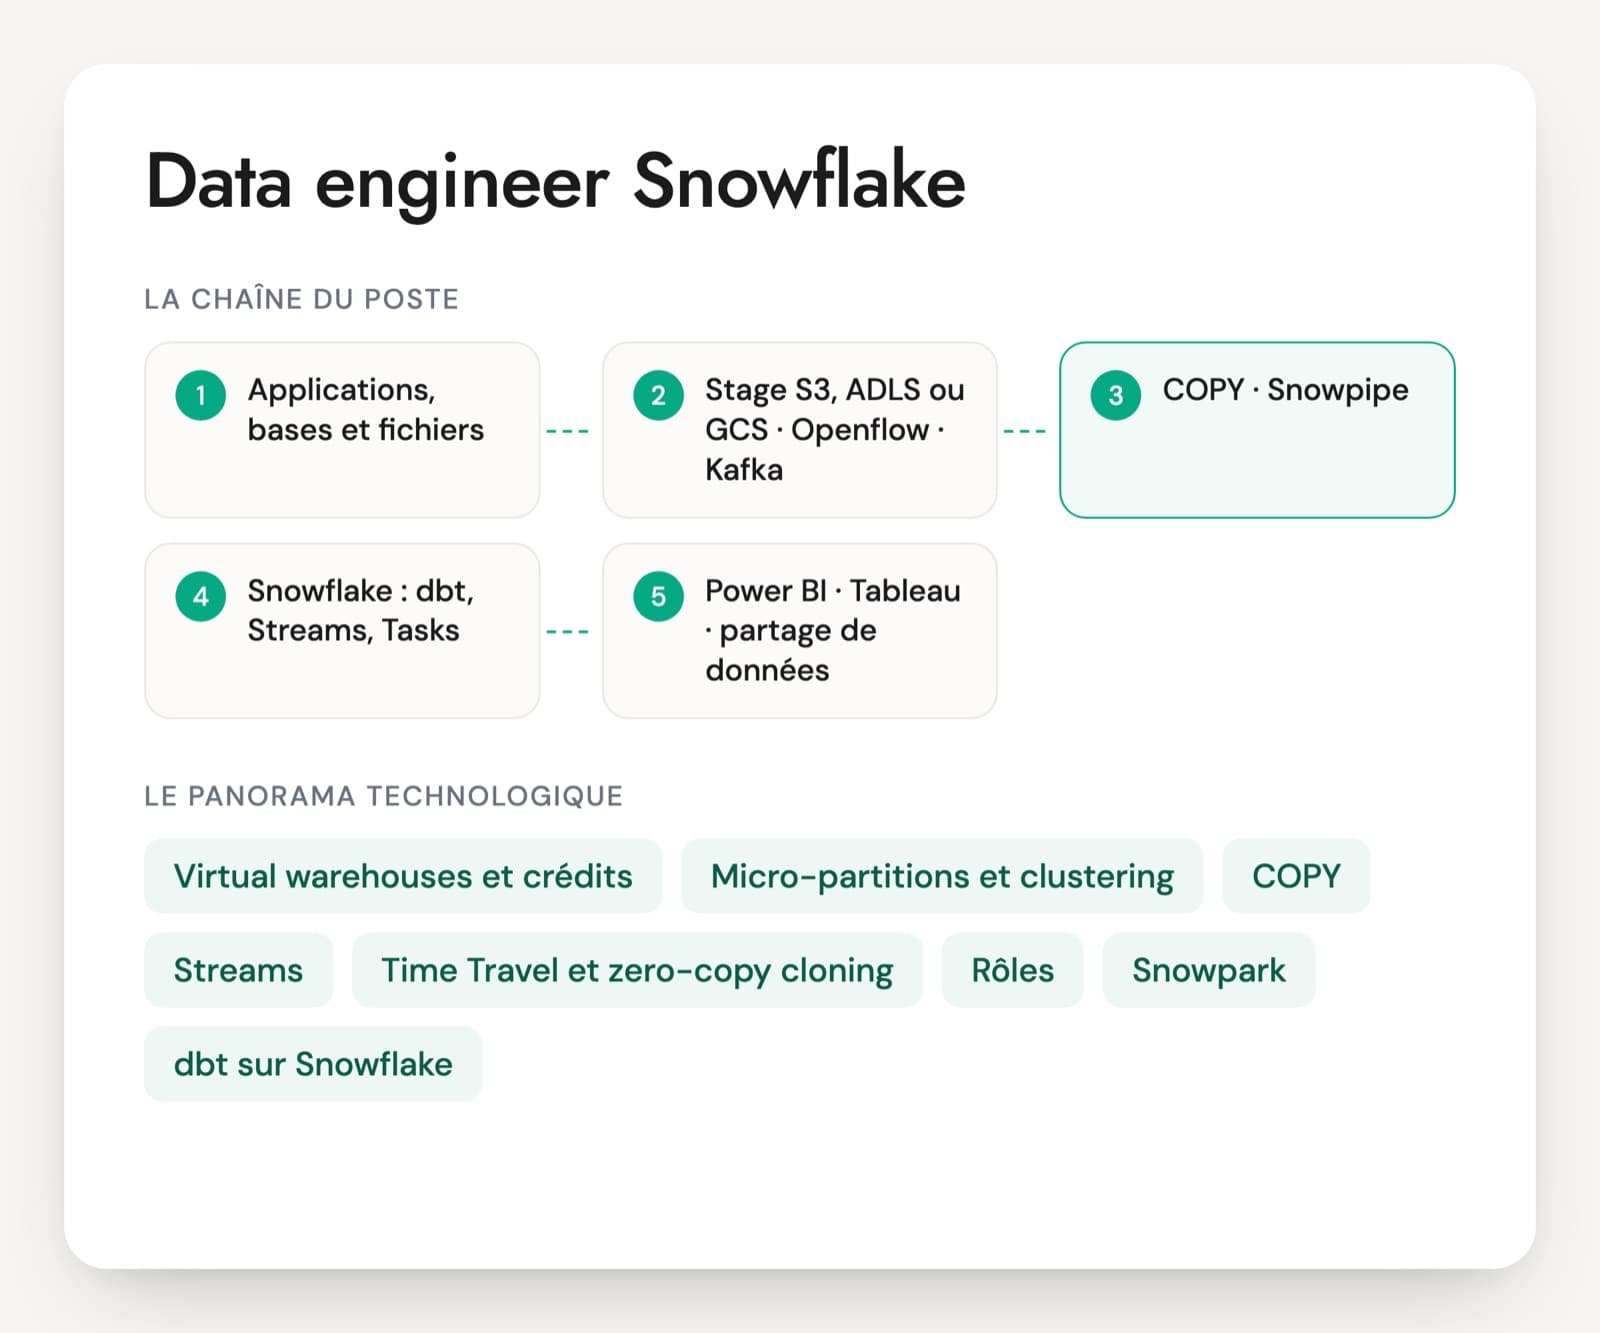
Les offres de data engineer Snowflake publiées en France décrivent presque toutes la même chaîne. Des fichiers arrivent dans un stockage cloud, Snowpipe ou un outil d'ingestion les charge, dbt écrit les transformations et Airflow ordonnance le tout. Snowflake tourne sur AWS, Azure et GCP, on le trouve donc chez des clients de tous les clouds. En ESN, beaucoup de missions portent sur la migration d'un entrepôt Teradata ou Oracle, ou sur le remplacement de Talend. Chez un client final, la facture passe souvent en tête des priorités.
Snowflake se prend en main vite, et c'est ce qui complique le tri des CV. Écrire du SQL dans une feuille de calcul ne demande aucune notion de micro-partitions ni de crédits. La différence se voit sur ce que la plateforme fait payer, comme un warehouse resté allumé tout le week-end ou une table reconstruite chaque heure. La certification SnowPro Core, dont la version COF-C03 a remplacé la précédente en février 2026, couvre toute la plateforme. Elle ne dit rien d'une facture qui a dérapé.
Chaque question vient avec la réponse attendue, le signal d'alerte et une relance. Le PDF déroule l'entretien complet sur six axes et 30 questions, avec une grille de 1 à 4 et un cas de 20 minutes sur les relevés de compteurs d'un fournisseur d'énergie.
Derrière le mot Snowflake sur un CV
Virtual warehouses et crédits
Le calcul est séparé du stockage. Un warehouse est un groupe de machines qu'on allume pour exécuter les requêtes, en tailles de XS à 6XL ; chaque taille au-dessus consomme deux fois plus de crédits. La facturation se fait à la seconde, avec une minute minimum à chaque redémarrage, d'où l'importance de la mise en veille automatique. Commencez l'évaluation ici.
Micro-partitions et clustering
Snowflake découpe chaque table en micro-partitions et garde, pour chacune, les valeurs minimales et maximales des colonnes. Une requête filtrée saute les partitions inutiles, à condition que les données soient rangées dans un ordre utile. Sur les très grosses tables, une clé de clustering maintient cet ordre, contre des crédits.
COPY, Snowpipe et Snowpipe Streaming
Trois façons de charger. COPY INTO charge des fichiers par lots depuis un stage (S3, ADLS ou GCS) sur un warehouse. Snowpipe charge les fichiers au fil de l'eau sans warehouse à gérer. Snowpipe Streaming insère des lignes directement, depuis une application ou le connecteur Kafka. Openflow, basé sur Apache NiFi, ajoute depuis 2025 des connecteurs vers les bases et les applications.
Streams, Tasks et Dynamic Tables
Les outils des pipelines incrémentaux dans Snowflake. Un stream enregistre les lignes modifiées d'une table depuis la dernière lecture, une task exécute du SQL selon un planning ou à la suite d'une autre. Une Dynamic Table se déclare par une requête et un délai de fraîcheur, et Snowflake la rafraîchit seul.
Time Travel et zero-copy cloning
Le Time Travel permet de relire ou de restaurer une table telle qu'elle était dans le passé, un jour par défaut et jusqu'à 90 jours en édition Enterprise. Le clonage crée une copie d'une table ou d'une base en quelques secondes sans dupliquer le stockage, pratique pour les environnements de test.
Rôles, masking et row access policies
Les droits passent par une hiérarchie de rôles. Les masking policies masquent une colonne selon le rôle de la personne, les row access policies filtrent les lignes visibles. Ces fonctions demandent l'édition Enterprise. C'est là que se règle la protection des données personnelles exigée par le RGPD.
Snowpark
Une API en Python, Java ou Scala qui écrit des traitements sous forme de DataFrames, exécutés dans Snowflake sans sortir les données. On s'en sert quand la logique est difficile à écrire en SQL, ou pour préparer des données de machine learning.
dbt sur Snowflake
L'outil le plus cité dans les offres à côté de Snowflake. Les transformations s'écrivent en SQL versionné dans Git, avec des dépendances calculées, des tests et des modèles incrémentaux. Vérifiez que la personne sait ce que chaque modèle coûte en crédits.
Le poste prend des formes différentes. En ESN, les missions Snowflake sont souvent des migrations depuis Teradata, Oracle, SQL Server ou un ETL comme Talend, avec une période où ancien et nouveau système tournent ensemble. Chez un client final, le data engineer Snowflake tient la plateforme dans la durée : coûts, droits, qualité des données. En start-up, il fait aussi l'analytics engineering avec dbt. Comme Snowflake s'installe sur AWS, Azure ou GCP, la connaissance du cloud hôte compte pour le stockage, les droits et le réseau. Snowflake a ajouté en 2025 et 2026 des warehouses de nouvelle génération et un mode Adaptive Compute, qui apparaissent dans les configurations récentes. La certification SnowPro Core, puis SnowPro Advanced: Data Engineer pour aller plus loin, atteste la connaissance de la plateforme ; la production se vérifie en entretien.
Ce qui sépare un bon profil Snowflake d'un profil moyen
- Warehouses et maîtrise des crédits
- Performance des requêtes et micro-partitions
- Ingestion : COPY, Snowpipe, Streaming
- Pipelines incrémentaux : Streams, Tasks, dbt
- Rôles, masquage et partage de données
- Qualité, reprise et industrialisation
Ce que coûte une requête Snowflake, et quatre autres sujets à creuser
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
La consommation de crédits Snowflake a doublé en un mois, sans nouveau projet. Comment trouvez-vous la cause ?
Une bonne réponseIl interroge les vues d'ACCOUNT_USAGE : WAREHOUSE_METERING_HISTORY pour savoir quel warehouse consomme, QUERY_HISTORY pour les requêtes et les utilisateurs en cause. Il vérifie l'auto-suspend (un outil BI qui interroge sans arrêt empêche la mise en veille), une taille de warehouse relevée et oubliée, et les fonctions serverless qui ont leurs propres vues de facturation, comme le clustering automatique ou Snowpipe. Puis il pose des resource monitors et des budgets.
Signal d'alerte« On réduit la taille de tous les warehouses » sans regarder les données, ou ignorer que certaines fonctions consomment des crédits sans warehouse allumé.
Question 2 · confirmé
Une requête filtre sur une seule journée, mais le profil montre qu'elle lit presque toutes les micro-partitions d'une table de deux milliards de lignes. Que regardez-vous ?
Une bonne réponseDans le Query Profile, le rapport entre partitions lues et partitions totales. L'élagage échoue quand les données ne sont pas rangées par date (ordre de chargement), quand une fonction ou une conversion implicite s'applique à la colonne filtrée, ou quand la table a été réécrite dans le désordre. Il mesure l'état avec SYSTEM$CLUSTERING_INFORMATION, puis propose une clé de clustering sur la date si la table est grande et souvent filtrée par date, ou un rechargement trié.
Signal d'alerte« On ajoute un index », alors que Snowflake n'en a pas sur ses tables standard, ou « on passe le warehouse en XL » sans regarder les partitions lues.
Question 3 · confirmé
Des fichiers arrivent toutes les cinq minutes dans un bucket S3. Comment les chargez-vous dans Snowflake ?
Une bonne réponseUn stage externe adossé à une storage integration, qui passe par un rôle IAM au lieu de clés d'accès, et un format de fichier déclaré. Snowpipe en auto-ingest, déclenché par les notifications d'événements S3, charge chaque fichier sans warehouse à gérer. Il vise des fichiers de 100 à 250 Mo compressés, suit les chargements avec COPY_HISTORY et SYSTEM$PIPE_STATUS et décide du sort des lignes en erreur. Pour des lignes isolées à quelques secondes de délai, il cite Snowpipe Streaming.
Signal d'alerteUn COPY lancé par cron toutes les cinq minutes sur un warehouse qui ne s'éteint jamais, ou des clés AWS écrites dans la définition du stage.
Question 4 · senior
Vous alimentez une table de synthèse à partir des seules lignes modifiées d'une table source. Comment le montez-vous avec un stream et une task ?
Une bonne réponseUn stream sur la table source, qui mémorise un point de lecture. Une task planifiée avec la condition SYSTEM$STREAM_HAS_DATA, pour ne pas démarrer de warehouse quand rien n'a changé. Un MERGE qui lit le stream dans une instruction DML, ce qui fait avancer le point de lecture, en traitant les colonnes METADATA$ACTION et METADATA$ISUPDATE (une mise à jour arrive sous forme de suppression puis d'insertion). Il connaît le risque d'un stream non consommé qui devient stale et compare avec une Dynamic Table ou un modèle dbt incrémental.
Signal d'alerteUn simple SELECT sur le stream, qui ne fait pas avancer le point de lecture, ou une task qui tourne chaque minute sur un warehouse sans condition.
Question 5 · confirmé
Les analystes marketing ne doivent voir l'e-mail des clients que partiellement masqué, et seulement pour leur pays. Que configurez-vous ?
Une bonne réponseUne masking policy sur la colonne, qui renvoie la valeur masquée ou en clair selon le rôle de la session, et une row access policy qui s'appuie sur une table de correspondance entre rôles et pays. Pour couvrir toutes les colonnes personnelles d'un coup, une politique de masquage attachée à une étiquette (tag-based masking). Les rôles fonctionnels reçoivent des rôles d'accès, jamais des droits directs. Il sait que ces politiques demandent l'édition Enterprise.
Signal d'alerteUne copie de la table par pays, une vue dupliquée pour chaque équipe, ou le rôle ACCOUNTADMIN donné « pour débloquer ».
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
SnowPro, dbt et coûts dans le choix d'un data engineer Snowflake
Qu'est-ce qui sépare un data engineer Snowflake d'un analytics engineer dbt ?
Les deux postes se recouvrent. L'analytics engineer se concentre sur les modèles dbt, les couches métier, les tests et la documentation. Le data engineer Snowflake prend en plus l'ingestion (Snowpipe, connecteurs, Kafka), l'intégration avec le stockage du cloud, le réglage des warehouses, les rôles, les coûts et la CI/CD. Dans une petite équipe, une seule personne fait souvent les deux. Si votre offre parle d'ingestion et de facture, vous cherchez un data engineer.
La SnowPro Core prouve-t-elle une expérience de production ?
Non. La version COF-C03, en place depuis février 2026, couvre l'architecture, la sécurité, le chargement, la performance et le partage de données. Elle montre une connaissance large de la plateforme. L'expérience de production se prouve par une histoire précise, comme une consommation de crédits réduite, une table restaurée par Time Travel ou un pipeline incrémental remis d'aplomb. La SnowPro Advanced: Data Engineer va plus loin sur l'ingestion et les pipelines, sans remplacer cette conversation.
Pourquoi parler de coûts dès le premier entretien Snowflake ?
Parce que Snowflake facture le calcul à la seconde, en crédits, et qu'une erreur de conception se paie tout de suite. Le data engineer choisit la taille des warehouses, leur mise en veille, la fréquence des tasks et le mode de rafraîchissement des tables. Demandez-lui comment il lirait la consommation du mois dernier. Une personne qui n'a jamais ouvert les vues de facturation n'a probablement pas eu la responsabilité d'une plateforme.
Un test technique Snowflake doit-il se faire sur un vrai compte ?
Ce n'est pas nécessaire. Snowflake propose des comptes d'essai, mais leur mise en place prend du temps et mesure surtout l'aisance dans l'interface. En entretien technique, montrez une capture de Query Profile, ou un script de stream et de task qui contient une erreur, et demandez à la personne de commenter à voix haute. Vous voyez vite si elle pense partitions lues, crédits et reprise, et une réponse apprise par cœur résiste mal à un cas concret.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.