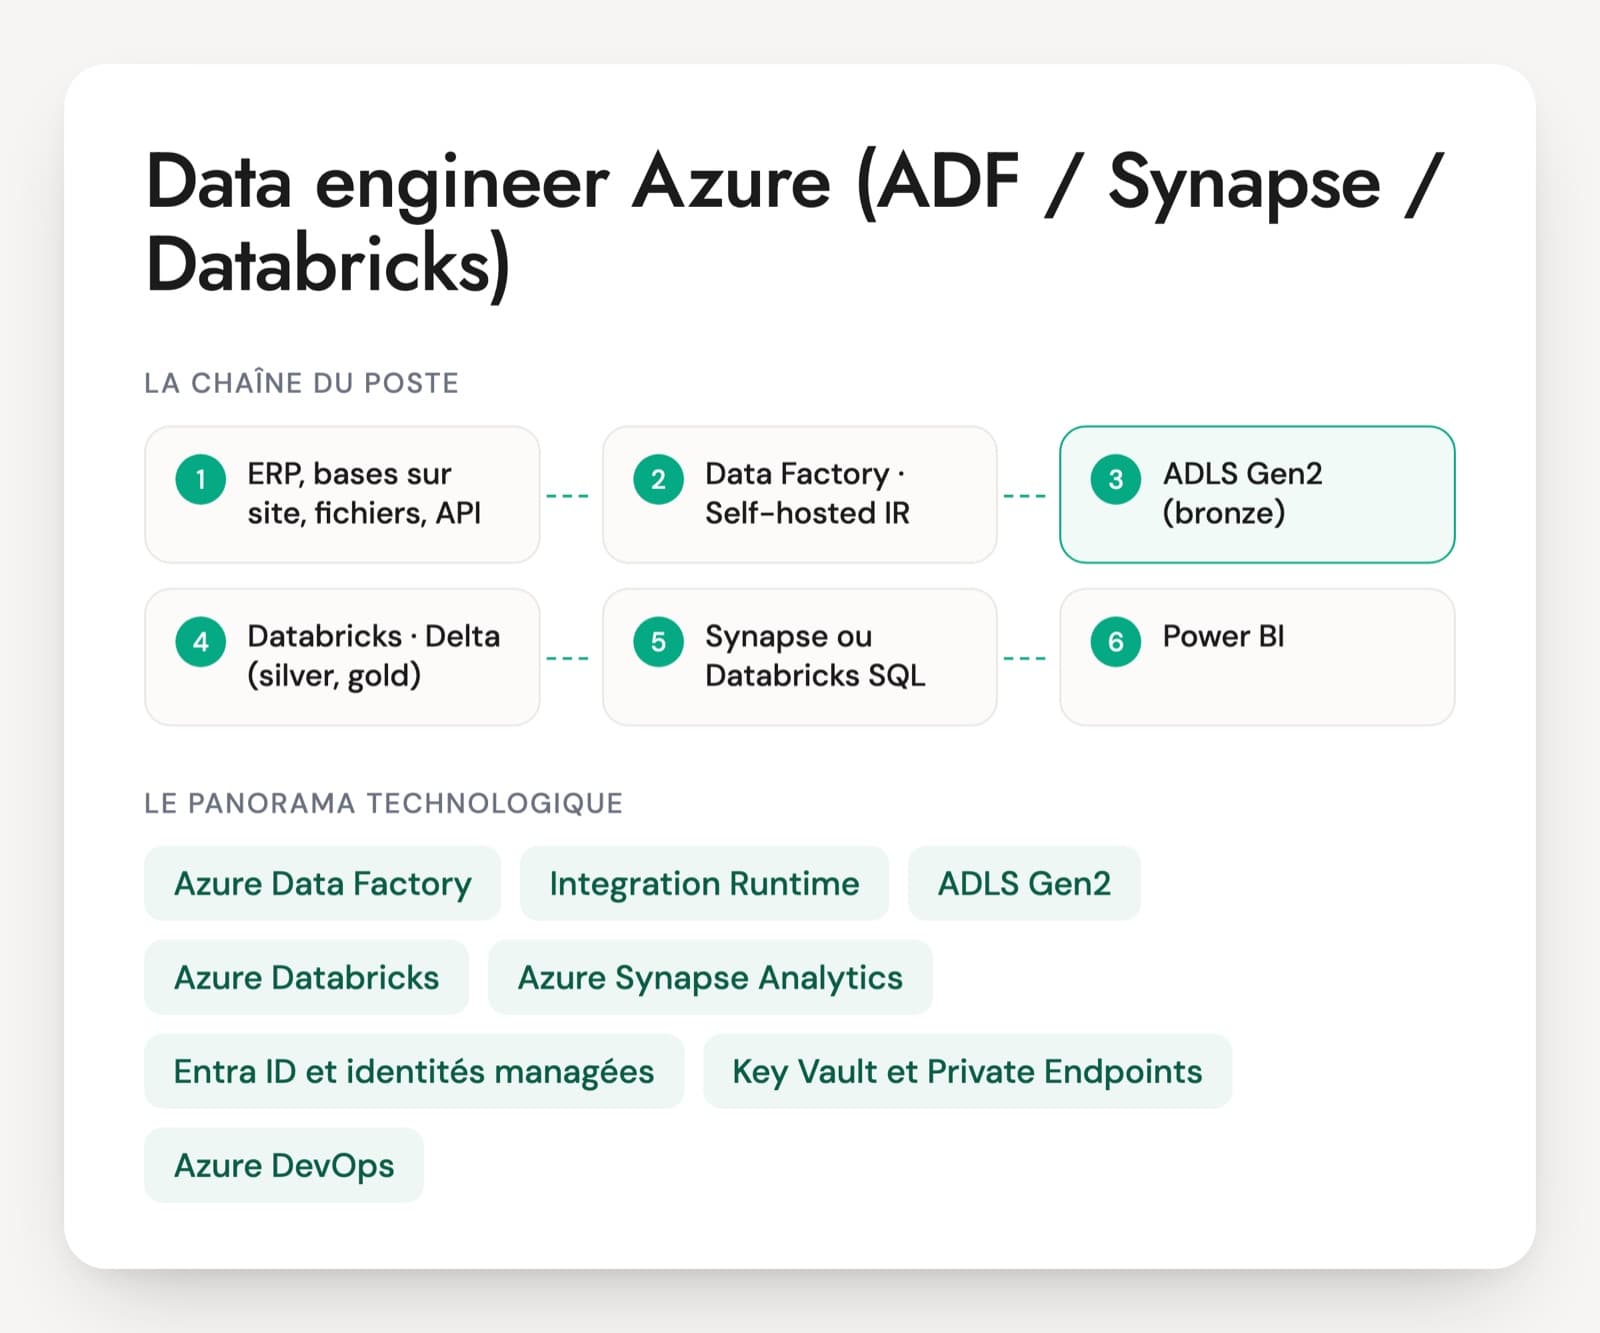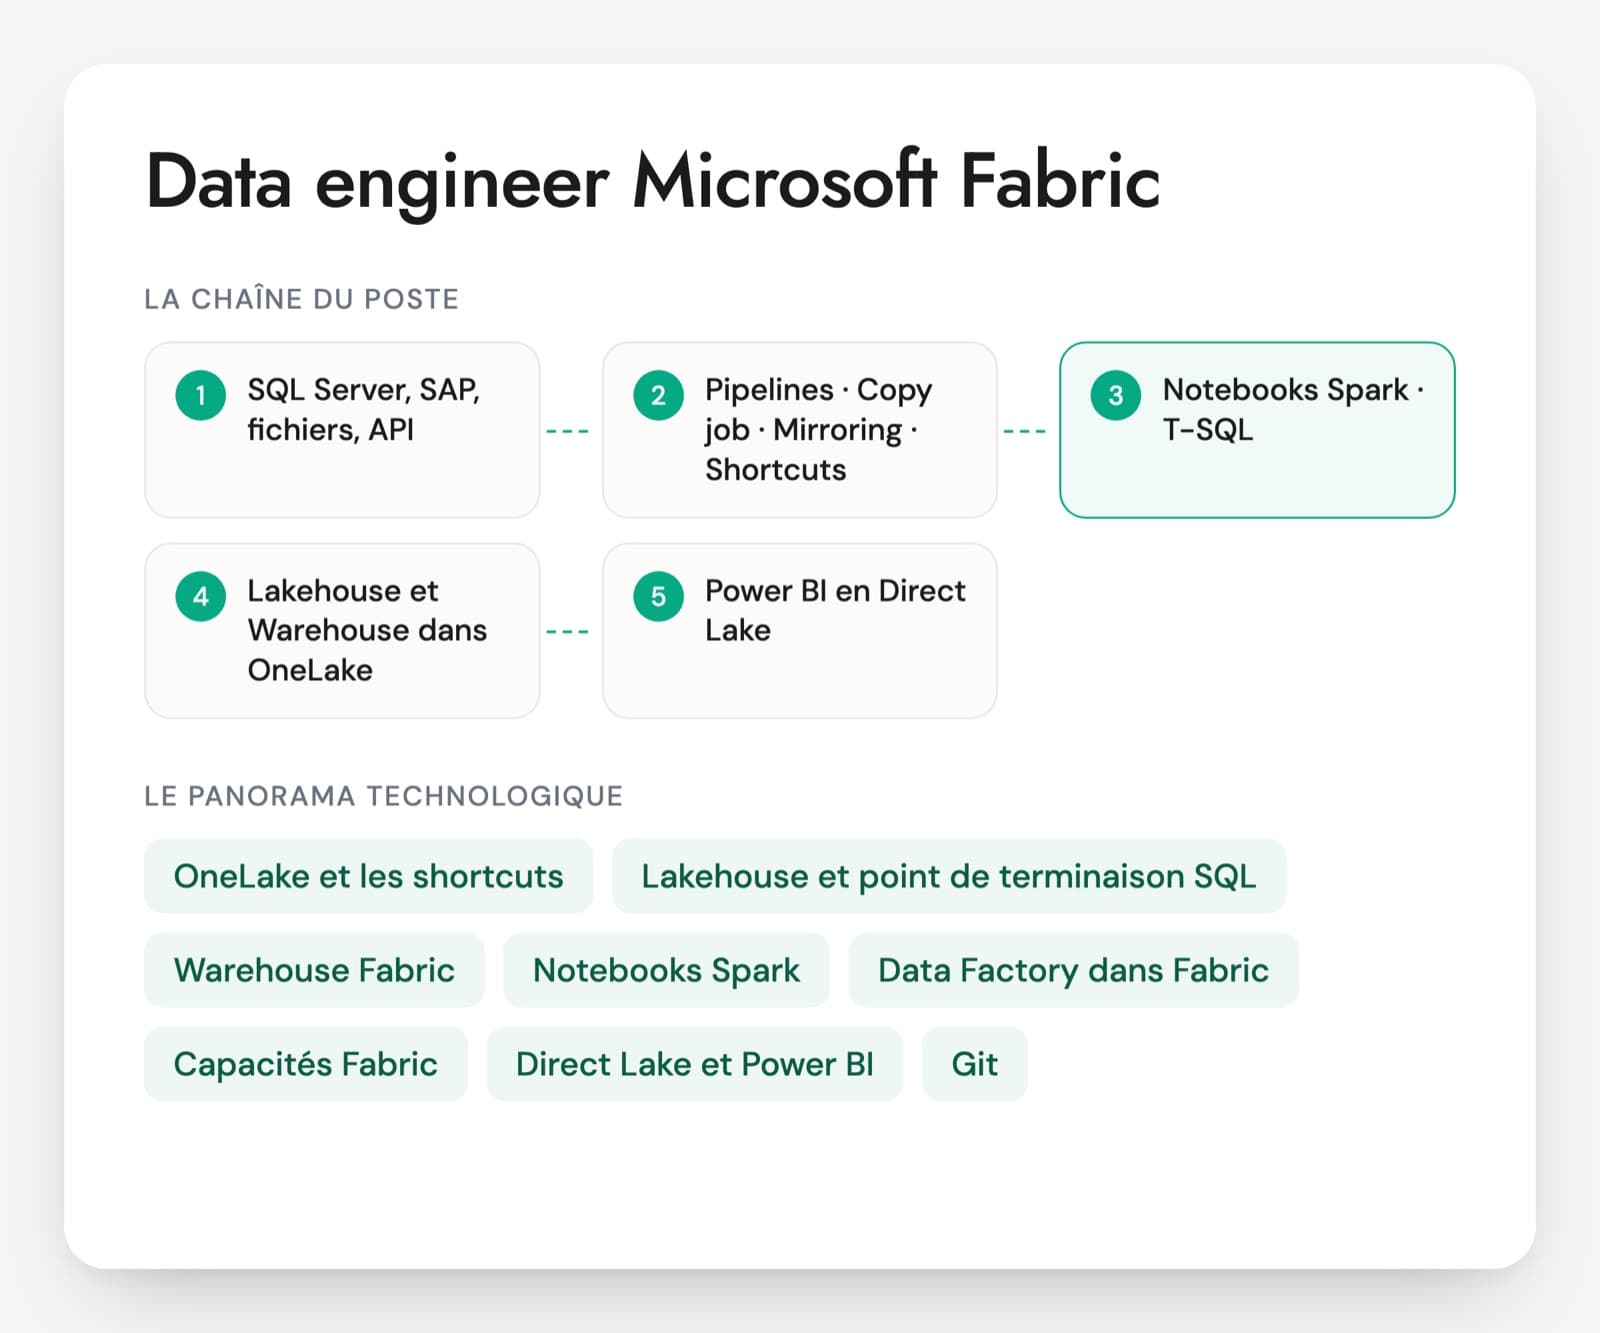
Les offres de data engineer Fabric viennent de deux côtés. Des équipes Power BI veulent sortir de leurs imports, et des équipes Azure lancent dans Fabric les projets qu'elles auraient montés sur Synapse. Au quotidien, le poste consiste à charger les sources avec les pipelines Data Factory, le Copy job ou le mirroring, à transformer en notebooks Spark ou en T-SQL, à organiser les couches bronze, argent et or dans des lakehouses et des warehouses, puis à servir Power BI en Direct Lake.
Le CV ne suffit pas à trier. Un profil Power BI connaît l'interface et les dataflows Gen2 mais n'a parfois jamais écrit de PySpark. Un profil Azure maîtrise Spark et Data Factory mais découvre une capacité unique, avec un lissage de la consommation et un bridage quand elle déborde. La certification DP-700, qui a pris la place de la DP-203 retirée en mars 2025, atteste la connaissance de la plateforme. Les questions sur les shortcuts ou une capacité saturée montrent qui l'a exploitée.
Les cinq questions de la page visent ces deux angles morts, le code et la capacité. Le PDF ajoute 30 questions sur six axes, un cas de 20 minutes sur le reporting d'un groupe industriel qui quitte ses imports Power BI et une grille notée de 1 à 4.
Les briques de Microsoft Fabric côté data engineering
OneLake et les shortcuts
Le stockage unique de Fabric, un seul data lake par organisation, bâti sur ADLS Gen2. Les tables y sont stockées au format Delta Lake, quel que soit le moteur qui les écrit. Les shortcuts exposent des données restées dans ADLS, Amazon S3, Google Cloud Storage ou un autre espace Fabric, sans les copier. Demandez avec quelle identité un shortcut lit sa cible : la réponse change selon le type de source.
Lakehouse et point de terminaison SQL
Le lakehouse range des fichiers et des tables Delta, écrits avec Spark. Chaque lakehouse expose automatiquement un point de terminaison SQL en lecture seule pour interroger ses tables en T-SQL. Ce point de terminaison synchronise ses métadonnées avec un décalage, ce qui explique des tables incomplètes interrogées juste après un chargement.
Warehouse Fabric
L'entrepôt SQL de Fabric, alimenté et interrogé en T-SQL, avec des transactions sur plusieurs tables. Il stocke lui aussi ses tables en Delta dans OneLake. Le choix entre lakehouse et warehouse dépend surtout des compétences de l'équipe (Spark ou T-SQL) et du besoin de transactions.
Notebooks Spark
Le moteur des gros volumes et de la logique complexe, en PySpark, Spark SQL, Scala ou R. Les pools de démarrage ouvrent une session en quelques secondes, les environnements fixent les bibliothèques et la configuration. Vérifiez que la personne écrit du PySpark elle-même, sans dépendre d'un outil visuel.
Data Factory dans Fabric
Les pipelines orchestrent, les dataflows Gen2 transforment en Power Query, le Copy job copie en masse ou en incrémental, et le mirroring réplique en continu une base (Azure SQL, SQL Server, Snowflake, Cosmos DB…) dans OneLake. Les sources hébergées dans les locaux de l'entreprise passent par la passerelle de données locale, qui joue le rôle de l'Integration Runtime auto-hébergé d'Azure Data Factory.
Capacités Fabric (CU)
Fabric se facture par capacité, des références F2 à F2048, mesurée en unités de calcul (CU). Toutes les charges d'un espace de travail, du Spark aux rapports Power BI, puisent dans la même capacité. Les pics sont lissés dans le temps, puis la plateforme retarde et enfin rejette les requêtes quand la consommation dépasse ce qui a été acheté. Un data engineer Fabric doit savoir lire l'application Capacity Metrics.
Direct Lake et Power BI
Le mode qui permet à un modèle Power BI de lire directement les tables Delta de OneLake, sans import ni requête SQL à chaque clic. Ses performances dépendent de l'état des tables (taille des fichiers, V-Order, nombre de lignes) et des limites de la capacité. En Direct Lake sur le point de terminaison SQL, une requête peut basculer en DirectQuery et ralentir.
Git, déploiement et sécurité
Les espaces de travail se relient à Azure DevOps ou GitHub, et les pipelines de déploiement font passer le contenu du développement à la production. La sécurité combine les rôles d'espace de travail, la sécurité OneLake sur les tables et les dossiers, et les étiquettes de confidentialité Purview. Un espace de travail par environnement est l'organisation la plus courante.
Le poste se trouve chez des clients finaux déjà équipés de Power BI et de Microsoft 365, et dans les ESN et cabinets partenaires de Microsoft qui déploient Fabric chez eux. Dans une entreprise de taille moyenne, le data engineer Fabric couvre souvent toute la chaîne, de l'ingestion au modèle sémantique. Dans un grand compte, il travaille à côté d'une équipe Power BI et parfois d'une plateforme Azure Databricks existante, et la répartition entre les deux mérite une question en entretien. Fabric évolue vite et beaucoup de fonctions passent de la préversion à la disponibilité générale en cours d'année, donc demandez sur quelle fonction la personne a travaillé et à quelle date. La certification DP-700 (Fabric Data Engineer Associate) vise ce poste, la DP-600 plutôt l'analytics engineering.
Six acquis qu'un data engineer Fabric doit prouver
- Lakehouse, Warehouse et OneLake
- Notebooks Spark et Delta Lake
- Ingestion avec Data Factory et le mirroring
- Capacités Fabric et coûts
- Direct Lake et modèles Power BI
- Sécurité, Git et déploiement
Interroger un data engineer Fabric sur la capacité et le code
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Une nouvelle table arrive : vous la mettez dans un lakehouse ou dans un warehouse Fabric ? Sur quels critères ?
Une bonne réponseSelon l'équipe et l'usage. Lakehouse quand les transformations s'écrivent en Spark, qu'il y a des fichiers non structurés ou de gros volumes. Warehouse quand l'équipe travaille en T-SQL et a besoin d'écritures SQL ou de transactions sur plusieurs tables. Le candidat rappelle que les deux stockent du Delta dans OneLake, qu'un warehouse peut lire les tables d'un lakehouse du même espace de travail, et que le point de terminaison SQL du lakehouse ne permet pas d'écrire.
Signal d'alerte« Le warehouse pour le SQL, le lakehouse pour le reste », sans critère. Ou l'idée que le point de terminaison SQL permet de modifier les tables.
Question 2 · senior
Le lundi matin, les rapports Power BI rament et des notebooks sont refusés. On vous parle de capacité saturée. Que regardez-vous ?
Une bonne réponseL'application Capacity Metrics : quelles opérations consomment, interactives ou d'arrière-plan, et à quel moment la capacité est passée en retard puis en rejet. Il connaît le mécanisme : la consommation des opérations d'arrière-plan est lissée sur 24 heures, donc un gros traitement du week-end peut encore peser le lundi. Pistes : déplacer ou optimiser le traitement en cause, séparer développement et production sur deux capacités, ou augmenter la taille en connaissant le coût.
Signal d'alerte« On passe en F128 » sans diagnostic, ou l'ignorance que Spark et Power BI partagent la même capacité.
Question 3 · confirmé
Vous créez un shortcut vers un compte ADLS Gen2 d'une autre équipe. Qui voit quoi, et qu'est-ce qui peut casser ?
Une bonne réponseUn shortcut vers ADLS passe par une connexion déléguée : les utilisateurs Fabric lisent les données avec l'identité de cette connexion, pas la leur. Les restrictions se posent donc côté Fabric, avec les rôles de sécurité OneLake. Risques cités : connexion qui expire ou perd ses droits, fichiers supprimés ou déplacés à la source, données hors format Delta qui n'apparaissent pas comme tables. Un shortcut de OneLake vers OneLake utilise par défaut l'identité de l'utilisateur.
Signal d'alerte« Un shortcut copie les données », ou aucune idée de l'identité utilisée pour lire la source.
Question 4 · confirmé
Un notebook a chargé la table, mais une requête sur le point de terminaison SQL ne voit pas les nouvelles lignes. Pourquoi ?
Une bonne réponseLe point de terminaison SQL du lakehouse synchronise ses métadonnées avec les tables Delta en arrière-plan, avec un délai. Il sait forcer la synchronisation (bouton d'actualisation, API d'actualisation des métadonnées appelée en fin de pipeline) et vérifie que la table apparaît bien dans la section Tables au format Delta, et pas comme un simple fichier. Il tient compte de ce délai dans l'enchaînement des traitements.
Signal d'alerteRelancer le chargement en pensant qu'il a échoué.
Question 5 · senior
Un modèle Power BI en Direct Lake sur une table de 300 millions de lignes devient lent. Que vérifiez-vous côté tables ?
Une bonne réponseL'état de la table Delta : nombre et taille des fichiers (beaucoup de petits fichiers après des chargements incrémentaux), V-Order, OPTIMIZE et VACUUM planifiés, colonnes inutiles retirées, cardinalité des colonnes. Il vérifie les limites Direct Lake de la capacité (lignes par table, taille du modèle) et, en Direct Lake sur le point de terminaison SQL, si des requêtes basculent en DirectQuery, par exemple à cause d'une vue ou d'une sécurité au niveau des lignes définie en SQL.
Signal d'alerte« On repasse en import » comme seule réponse, sans regarder la table.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Le data engineer Fabric face au consultant Power BI
Faut-il savoir écrire du PySpark pour travailler sur Fabric ?
Pour un poste de data engineer, dans la plupart des cas, oui. Les dataflows Gen2 et les pipelines couvrent les transformations simples sans code, mais les gros volumes, les chargements incrémentaux et la maintenance des tables Delta passent par des notebooks Spark. Une équipe très orientée SQL peut travailler surtout dans le warehouse, en T-SQL. Regardez la répartition prévue sur votre plateforme avant de fixer l'exigence, puis vérifiez-la avec un exercice de code.
La certification DP-700 prouve-t-elle une pratique de Fabric ?
La DP-700 (Microsoft Certified: Fabric Data Engineer Associate) porte sur la mise en place d'une solution d'analyse, l'ingestion et la transformation des données, la supervision et l'optimisation dans Fabric. Elle a pris la place de la DP-203, retirée le 31 mars 2025, ce qui aide à dater un CV. Elle montre une connaissance de la plateforme, pas l'exploitation d'une capacité en production. Faites raconter une capacité saturée, un modèle Direct Lake lent ou un déploiement entre environnements.
Où s'arrête le consultant Power BI et où commence le data engineer Fabric ?
Le consultant Power BI construit les modèles sémantiques, les mesures DAX et les rapports. Le data engineer Fabric prépare les tables qu'ils consomment : ingestion, transformations en Spark ou en T-SQL, qualité, historisation, performance des tables Delta. Dans Fabric, les deux se croisent sur Direct Lake, car la vitesse d'un rapport dépend de la façon dont les tables sont écrites. Une offre qui demande surtout du DAX et des dataflows Gen2 décrit plutôt un profil BI.
Quel test technique pour un data engineer Fabric ?
Un exercice court suffit souvent. Donnez un notebook PySpark qui recharge une table en écrasant tout et demandez de le passer en incrémental avec un MERGE Delta. Ajoutez une capture de l'application Capacity Metrics à commenter. La personne explique à voix haute ce qu'elle ferait. En une demi-heure, vous voyez si elle écrit du Spark sans aide et si elle sait lire la consommation d'une capacité.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.