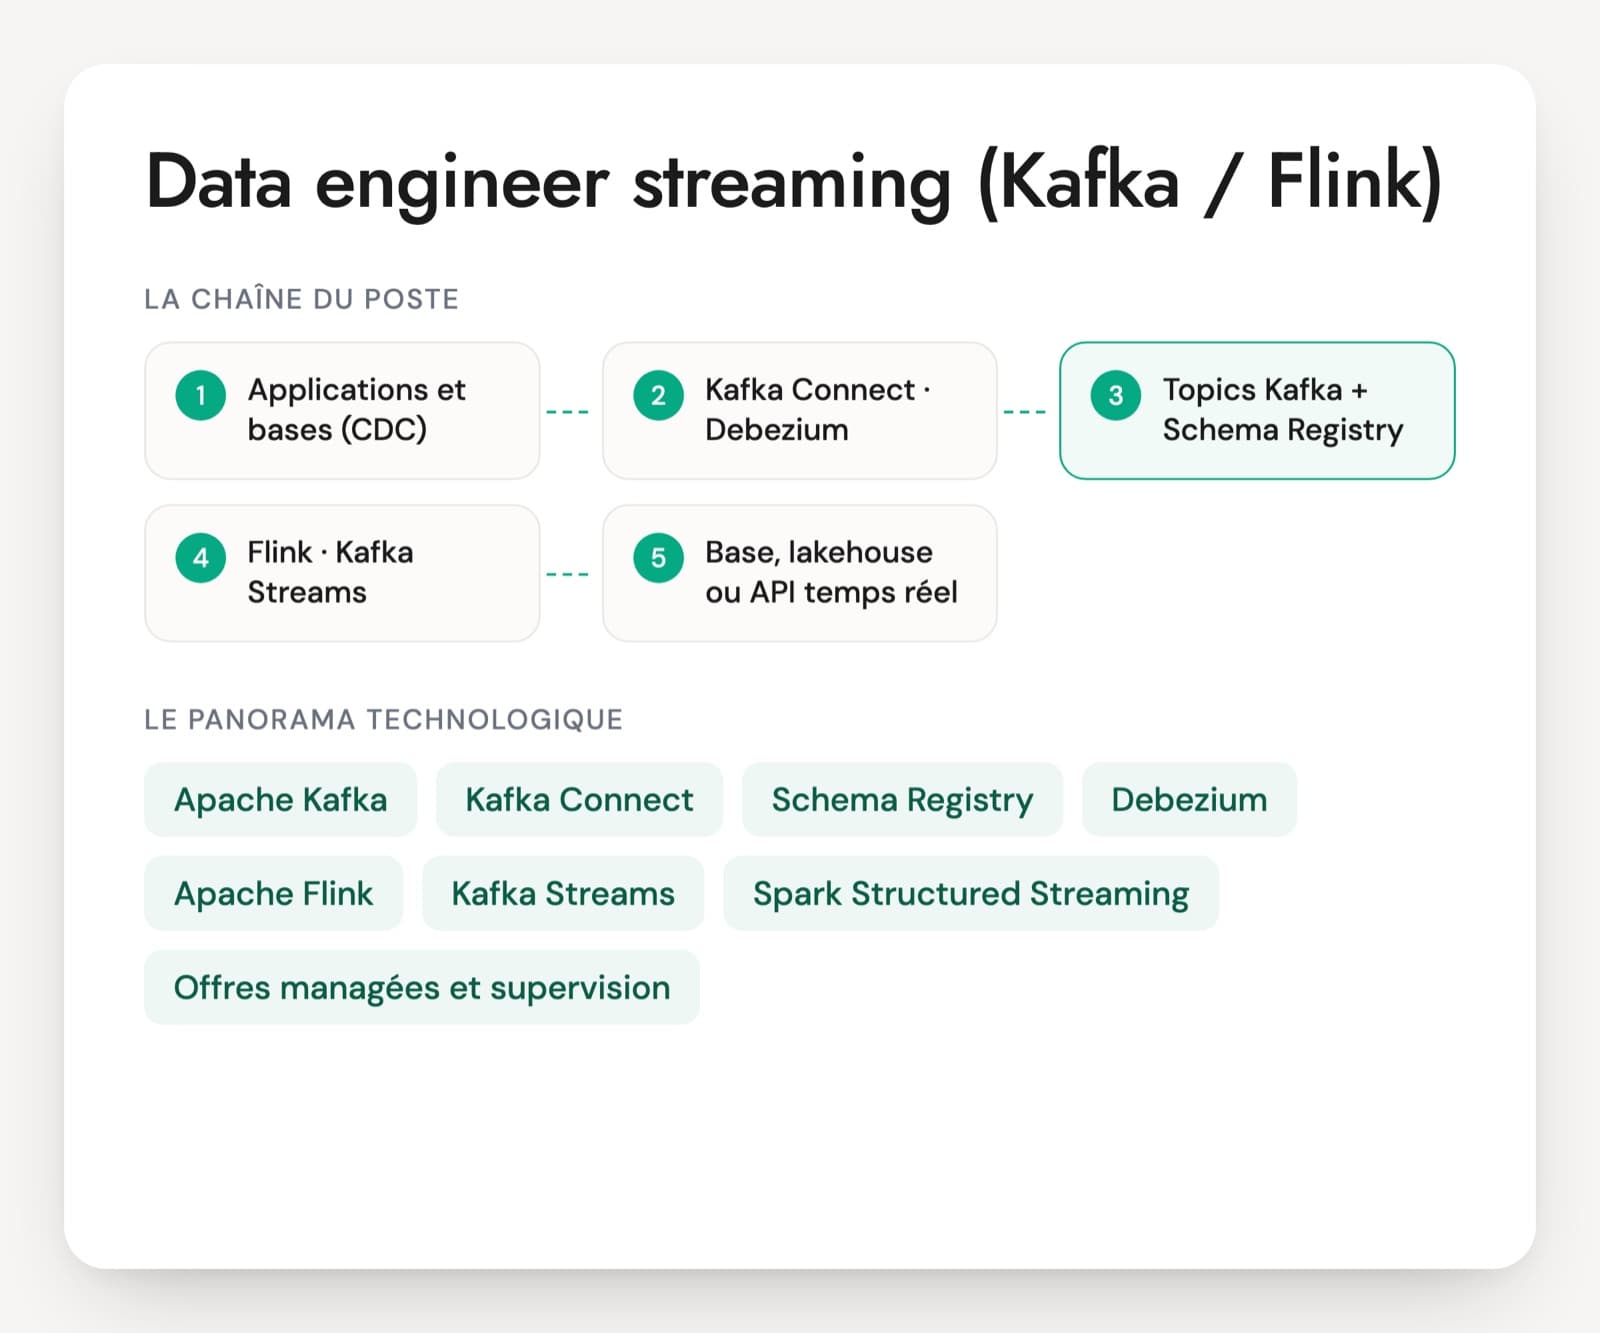
Votre fiche de poste cite Kafka, Debezium et Flink. Un entretien technique de data engineer Kafka doit suivre toute la chaîne du streaming, de la capture des changements des bases avec Debezium aux traitements Flink, Kafka Streams ou Spark Structured Streaming. En France, le profil est recherché en e-commerce pour les stocks, en banque pour les paiements et la fraude, dans les télécoms et l'industrie pour les gros volumes. En ESN, les missions portent souvent sur Kafka Connect.
Presque tous les candidats savent définir un topic. Beaucoup moins savent expliquer un watermark bloqué, un lag qui grimpe depuis le matin ou un rejeu qui a compté deux fois les mêmes ventes. Les profils viennent aussi de deux horizons. Les développeurs Java connaissent bien Kafka Streams et moins l'analytique, les data engineers connaissent Spark et moins le fonctionnement interne de Kafka. Les certifications Confluent valident la connaissance de Kafka, l'entretien sert à vérifier l'exploitation réelle.
Le volume de messages par seconde et l'exigence de latence fixent le niveau attendu. Un candidat qui a vécu un incident sait dire combien de temps le rejeu a pris et comment il a évité les doublons. La mise en situation du PDF porte sur le stock affiché en temps réel par un site e-commerce.
La pile temps réel d'un data engineer streaming
Apache Kafka
Le journal d'événements au centre du temps réel. Des applications y publient commandes, paiements ou clics, et d'autres les lisent à leur propre rythme. Les données sont réparties en partitions, qui fixent l'ordre et le parallélisme. Kafka fonctionne sans ZooKeeper depuis la version 4.0. Vérifiez que le candidat comprend partitions, groupes de consommateurs et réplication.
Kafka Connect
Le cadre qui relie Kafka au reste du système d'information sans écrire de code, avec des connecteurs source (une base, des fichiers) et sink (un entrepôt, un moteur de recherche). Le travail relève surtout de l'exploitation : configurer les connecteurs, les surveiller, relancer une tâche en échec.
Schema Registry (Avro, Protobuf)
Le registre qui stocke la structure des messages et vérifie qu'une nouvelle version reste compatible avec la précédente. Sans lui, une équipe qui supprime un champ peut casser les traitements d'une autre. Faites raconter au candidat une évolution de schéma qu'il a gérée, l'expérience se voit vite sur ce sujet.
Debezium (CDC)
Un ensemble de connecteurs qui lisent le journal des transactions d'une base (PostgreSQL, MySQL, Oracle, SQL Server…) et publient dans Kafka chaque insertion, modification ou suppression. C'est la méthode courante pour alimenter le temps réel sans modifier les applications. Son exploitation a des pièges connus côté base, qu'un profil expérimenté sait citer.
Apache Flink
Le moteur de référence pour les traitements de flux exigeants : agrégats par fenêtre, jointures entre flux, détection de fraude. Il garde un état et le sauvegarde régulièrement (checkpoints) pour reprendre après une panne sans perdre de données. Il se programme en Java ou en SQL. C'est la partie la plus technique du poste.
Kafka Streams
Une bibliothèque Java qui traite les flux à l'intérieur d'une application, sans cluster dédié. Elle lit et écrit uniquement dans Kafka. On la rencontre surtout dans les équipes de développement backend.
Spark Structured Streaming
Le streaming de Spark, qui traite les flux par petits lots. On le trouve souvent dans les entreprises qui ont déjà un lakehouse Spark ou Databricks. Sa latence suffit pour la plupart des usages analytiques. Quand il faut descendre à quelques millisecondes, les équipes lui préfèrent Flink.
Offres managées et supervision
Confluent Cloud, Amazon MSK ou Event Hubs, compatible avec le protocole Kafka, évitent de gérer soi-même les brokers. La supervision s'appuie sur le lag des consommateurs (leur retard de lecture), le débit et la santé des checkpoints. Un confirmé sait lire ces indicateurs en plein incident.
Le poste varie selon le secteur et l'équipe. En e-commerce, on parle stock et paniers en temps réel. En banque et en fintech, ce sont les paiements et la fraude, avec l'exigence de ne rien perdre et de ne rien compter deux fois. Dans les télécoms et l'industrie, les volumes d'événements sont très élevés. En ESN, les missions portent souvent sur Kafka Connect et l'exploitation de plateformes existantes, alors qu'une équipe produit attend aussi la conception de traitements Flink ou Kafka Streams. Certains candidats viennent du développement Java et maîtrisent Kafka Streams sans connaître l'analytique, d'autres viennent de la data et connaissent Spark sans connaître Kafka en profondeur. Les certifications Confluent, développeur ou administrateur, attestent la connaissance de Kafka. Elles ne remplacent pas l'expérience d'un incident en production.
Les exigences techniques pour un data engineer Kafka
- Kafka : partitions, réplication, consommateurs
- Garanties de livraison et exactly-once
- Heure de l'événement, fenêtres et watermarks
- État, checkpoints et reprise
- Schémas et intégration (Connect, CDC)
- Exploitation : lag, débit, incidents
Questions Kafka et Flink sur une panne en production
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · junior à confirmé
Votre topic a 6 partitions et votre groupe de consommateurs compte 10 instances. Que se passe-t-il, et comment accélérez-vous la consommation ?
Une bonne réponseDans un groupe classique, chaque partition n'est lue que par un seul consommateur, donc 4 instances ne font rien. Pour aller plus vite, on augmente le nombre de partitions, en sachant que la répartition des clés change pour les nouveaux messages, ou on accélère le traitement lui-même. Un candidat à jour parle des share groups (Queues for Kafka), prêts pour la production depuis Kafka 4.2, où plusieurs consommateurs lisent la même partition sans garantie d'ordre.
Signal d'alerteAffirmer que Kafka répartit les messages entre les 10 instances dans un groupe classique.
Question 2 · senior
Le métier vous demande du « exactly-once » entre Kafka et une base PostgreSQL. Que lui répondez-vous ?
Une bonne réponseL'exactly-once natif de Kafka (transactions, lecture en read_committed) couvre le trajet de Kafka à Kafka. Vers une base externe, il faut l'obtenir à l'écriture : un upsert sur l'identifiant unique de l'événement, ou l'enregistrement de l'offset dans la même transaction que les données. Le candidat précise que l'on garantit un effet unique. Un message peut être lu deux fois, il ne doit compter qu'une fois.
Signal d'alerte« Il suffit d'activer enable.idempotence », ou « Kafka garantit l'exactly-once de bout en bout ».
Question 3 · senior
Un job Flink calcule des agrégats sur des fenêtres de 5 minutes. En heure creuse, certaines fenêtres ne se ferment jamais. Pourquoi ?
Une bonne réponseLe watermark d'un opérateur est le minimum des watermarks de ses entrées. Une partition Kafka qui ne reçoit plus rien bloque ce minimum, et les fenêtres restent ouvertes. Le candidat déclare les sources inactives avec withIdleness dans la WatermarkStrategy et vérifie l'équilibre entre le nombre de partitions et le parallélisme.
Signal d'alerteAgrandir les fenêtres, ou passer en heure de traitement sans mesurer l'effet sur la justesse des chiffres.
Question 4 · senior
Vous mettez en production une nouvelle version d'un job Flink, sans perdre de données ni en compter deux fois. Comment procédez-vous ?
Une bonne réponseArrêt avec savepoint (stop-with-savepoint), déploiement, puis redémarrage depuis ce savepoint. Les opérateurs portent des uid() stables pour que l'état retrouve sa place, les types d'état restent compatibles, et l'option allowNonRestoredState sert si un opérateur a disparu. En sortie, un sink transactionnel ou idempotent.
Signal d'alerteAnnuler le job et le relancer depuis le dernier offset, ou depuis le début du topic.
Question 5 · confirmé
Une équipe veut retirer un champ d'un événement Avro publié dans Kafka. Que vérifiez-vous avant de donner votre accord ?
Une bonne réponseLe mode de compatibilité du sujet dans le Schema Registry, BACKWARD par défaut chez Confluent. En BACKWARD, le registre accepte la suppression, car un consommateur qui a le nouveau schéma sait lire les anciens messages. Les consommateurs restés sur l'ancien schéma, eux, ne liront les nouveaux messages que si le champ avait une valeur par défaut. On met donc à jour les consommateurs d'abord, le producteur ensuite, et on passe en BACKWARD_TRANSITIVE si l'on rejoue tout l'historique.
Signal d'alerte« On modifie le schéma et on redéploie le producteur », sans un mot sur les consommateurs.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Ce que les recruteurs demandent sur les profils Kafka et Flink
Sur Kafka, qu'est-ce qui distingue un confirmé d'un débutant ?
Tout candidat doit maîtriser les partitions, les groupes de consommateurs, la réplication et les réglages de durabilité des producteurs. Pour un confirmé, ajoutez les garanties de livraison, l'évolution des schémas avec un Schema Registry et la capture de changements avec Debezium. Si l'équipe calcule des agrégats en temps réel, il faut aussi Flink ou Kafka Streams, avec les fenêtres, les watermarks et la reprise sur checkpoint. Côté exploitation, la personne doit savoir lire le lag et le débit pendant un incident.
Faut-il connaître Flink pour un poste de data engineer streaming ?
Cela dépend des traitements. Une équipe qui transporte des données entre systèmes avec Kafka Connect et Debezium peut se passer de Flink. Dès qu'il faut des agrégats par fenêtre, des jointures entre flux ou un état conservé d'un message à l'autre, Flink ou Kafka Streams devient nécessaire. Les entreprises déjà équipées d'un lakehouse Spark utilisent souvent Spark Structured Streaming à la place. Relisez la fiche de poste avec le manager pour savoir quel moteur compte vraiment.
Quelle différence entre un administrateur Kafka et un data engineer streaming ?
L'administrateur Kafka s'occupe du cluster : installation des brokers, sécurité, montées de version, dimensionnement et supervision de la plateforme. Le data engineer streaming construit les chaînes qui l'utilisent. Il choisit les clés et les partitions des topics, écrit les traitements et s'assure que les chiffres restent justes après une panne. Les deux rôles se recoupent sur l'exploitation, et certaines missions en ESN les combinent. Précisez dans l'annonce lequel vous cherchez.
Comment évaluer un candidat Kafka sans test technique sur machine ?
Une mise en situation orale fonctionne bien pour ce profil. Décrivez un besoin concret, par exemple afficher un stock à jour en quelques secondes, et demandez au candidat de construire la chaîne : sources, clés de partition, moteur de traitement, protection contre les doublons, supervision. Les questions de panne, comme un lag qui monte ou le redéploiement d'un job Flink, font vite apparaître l'expérience de production. La fiche PDF de Delectus propose ce scénario avec une grille de notation.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.