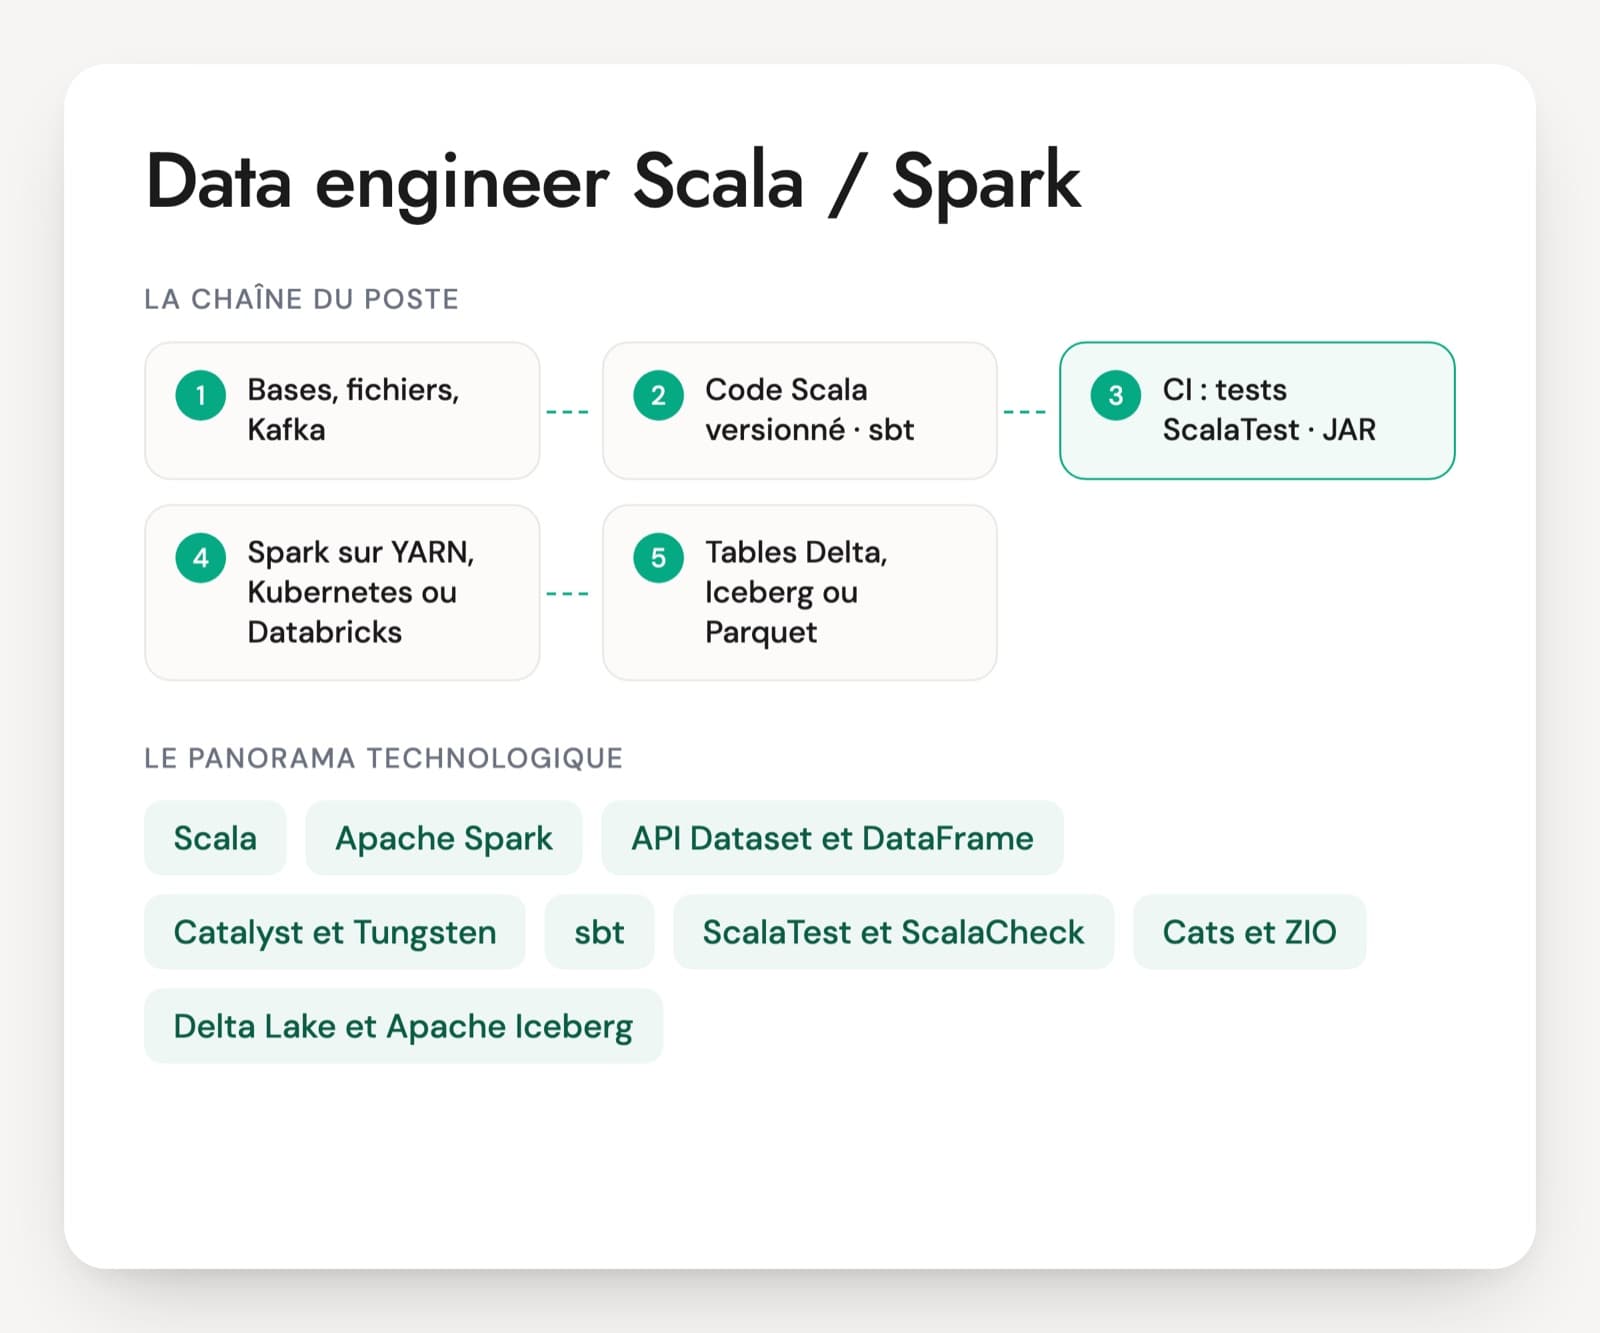
On n'interroge pas un data engineer Scala Spark comme un profil PySpark. Le poste se rapproche du développement logiciel : du code typé, compilé avec sbt, testé avec ScalaTest et livré sous forme de JAR sur un cluster Hadoop, Kubernetes ou Databricks. On le croise surtout en banque et en assurance, sur des plateformes construites il y a plusieurs années, et dans les ESN qui les maintiennent.
La difficulté vient des CV qui affichent Scala après quelques mois de maintenance. Écrire une transformation qui marche ne suffit pas sur ces plateformes. Il faut comprendre pourquoi un job reste bloqué sur une tâche, pourquoi un JAR casse sur le cluster alors qu'il passait en local, et comment tester une transformation sans ouvrir un notebook. Spark 4 ajoute un sujet : il ne fonctionne plus qu'avec Scala 2.13, et les projets restés en 2.12 doivent migrer.
Sans développeur Scala pour mener l'entretien technique, appuyez-vous sur la réponse attendue et le signal d'alerte écrits sous chaque question. Le PDF va plus loin avec 30 questions réparties sur six axes, une étude de cas de 20 minutes sur un rapprochement bancaire trop lent et une grille de notation de 1 à 4.
Le langage Scala et son écosystème Spark en production
Scala
Le langage du poste, qui tourne sur la machine virtuelle Java. Il mêle programmation objet et programmation fonctionnelle, avec un typage strict vérifié à la compilation. La version 2.13 domine sur les projets Spark, puisque Spark n'est pas publié pour Scala 3. Vérifiez que la personne écrit du code immuable et traite les valeurs absentes sans null.
Apache Spark
Le moteur de calcul distribué, qui découpe un traitement en tâches réparties sur plusieurs machines. Spark est écrit en Scala, ce qui donne à ce langage un accès direct à toutes ses API. La version 4, sortie en 2025, exige Java 17 et Scala 2.13 et applique par défaut des règles SQL plus strictes sur les conversions de types.
API Dataset et DataFrame
Les deux façons d'écrire une transformation. Le DataFrame manipule des colonnes nommées, le Dataset associe chaque ligne à une classe Scala dont le compilateur connaît les champs. Le choix pèse sur la performance comme sur la robustesse du code, d'où la première question plus bas.
Catalyst et Tungsten
L'optimiseur de requêtes de Spark et son moteur d'exécution. Catalyst réécrit le plan de calcul, par exemple en appliquant les filtres le plus tôt possible ou en choisissant le type de jointure. Tungsten génère un code compact pour l'exécuter. Un profil solide lit ce plan avec explain() et la Spark UI pour trouver où le temps passe.
sbt
L'outil de build standard en Scala, même si Maven ou Gradle se rencontrent aussi. Il compile, lance les tests, gère les dépendances et produit le JAR envoyé sur le cluster. Beaucoup d'incidents de déploiement naissent là, quand une bibliothèque du projet entre en conflit avec celle déjà installée sur le cluster.
ScalaTest et ScalaCheck
Les bibliothèques de tests les plus répandues. ScalaTest sert aux tests unitaires d'une transformation sur de petits jeux de données écrits dans le code. ScalaCheck génère des données aléatoires pour vérifier qu'une propriété tient toujours, par exemple qu'une déduplication ne laisse aucun doublon.
Cats et ZIO
Deux bibliothèques de programmation fonctionnelle avancée. Cats sert souvent à valider des données en accumulant les erreurs, ZIO ou Cats Effect à écrire des services et des orchestrations fiables autour des jobs. Leur présence dépend beaucoup de l'équipe, donc ne les exigez que si le code existant les utilise.
Delta Lake et Apache Iceberg
Des formats de tables posés sur des fichiers Parquet. Ils ajoutent les transactions, les mises à jour par MERGE et l'historique des versions. Un job Scala récent écrit rarement du Parquet brut, et la manière de réécrire une partition sans créer de doublon mérite une question.
Plateformes d'exécution
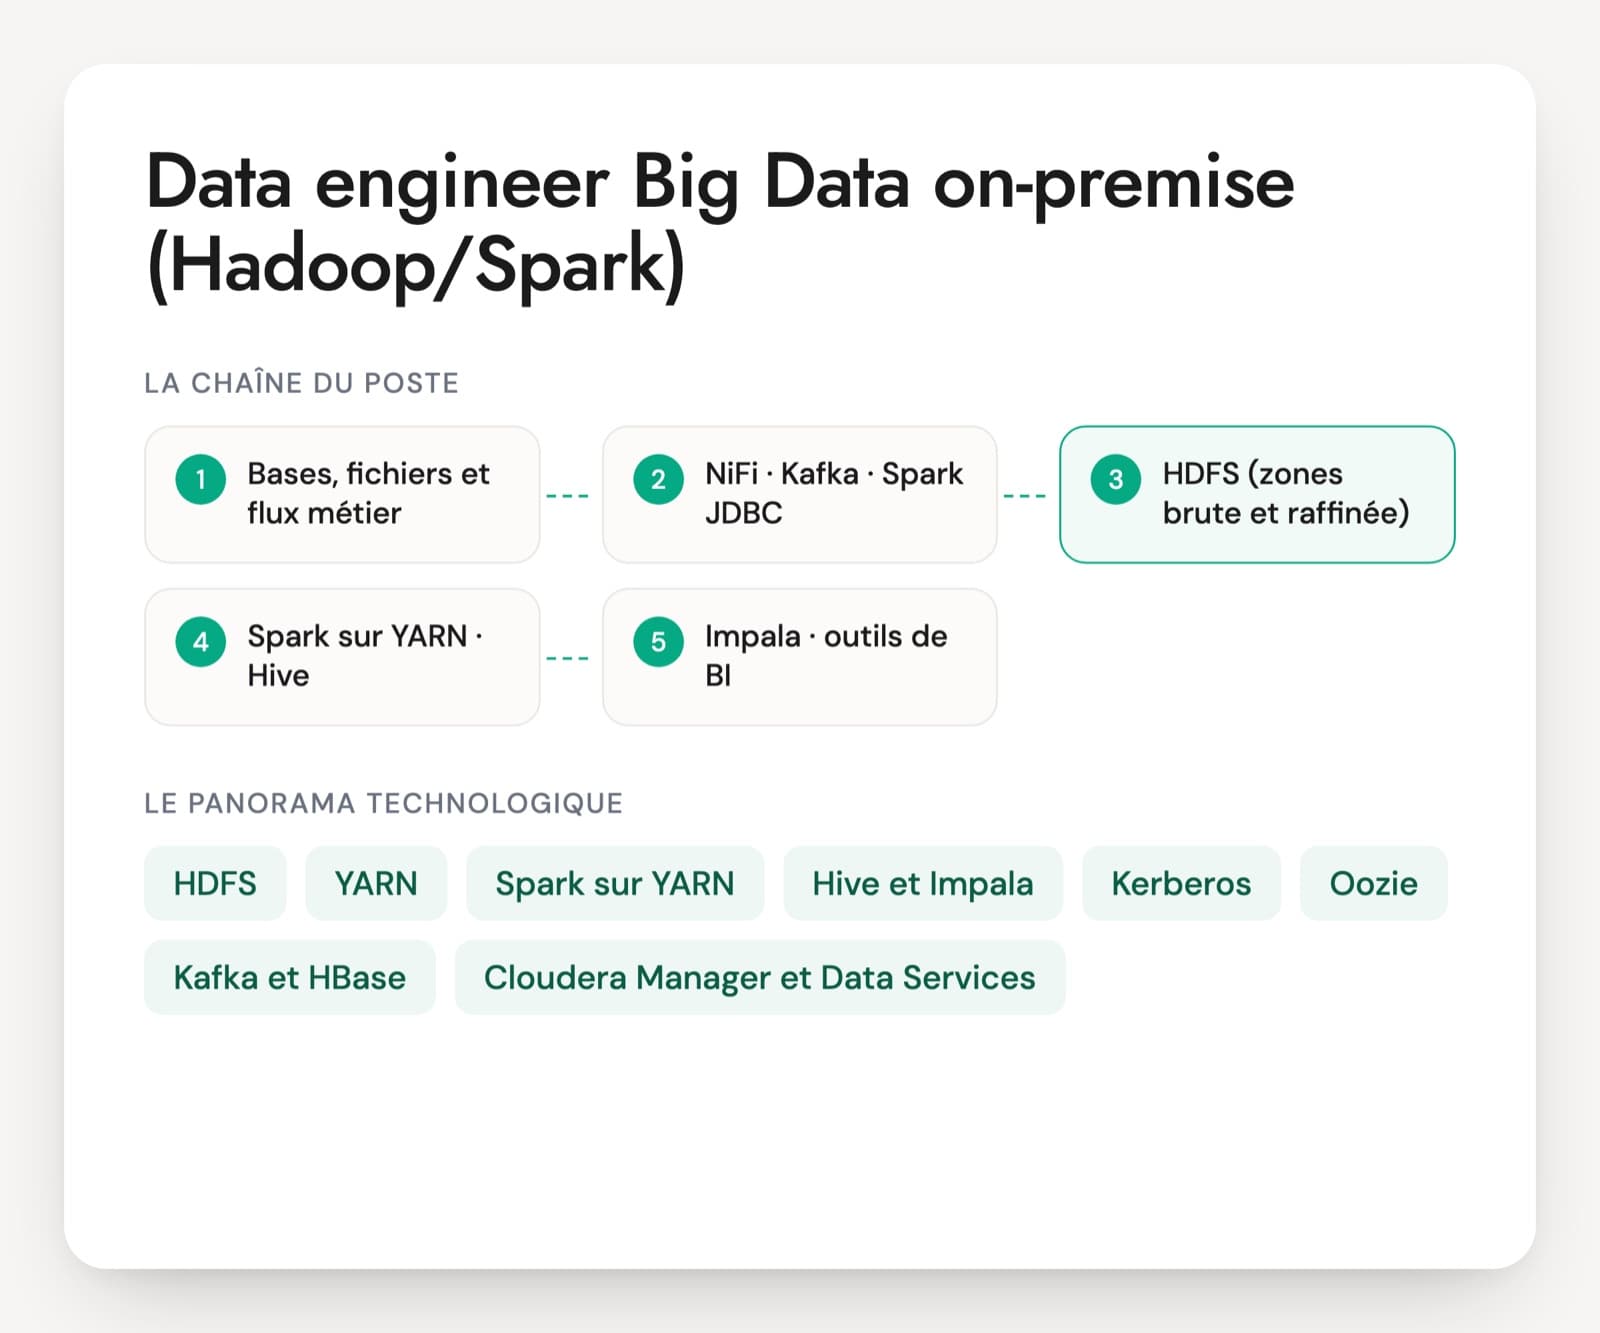
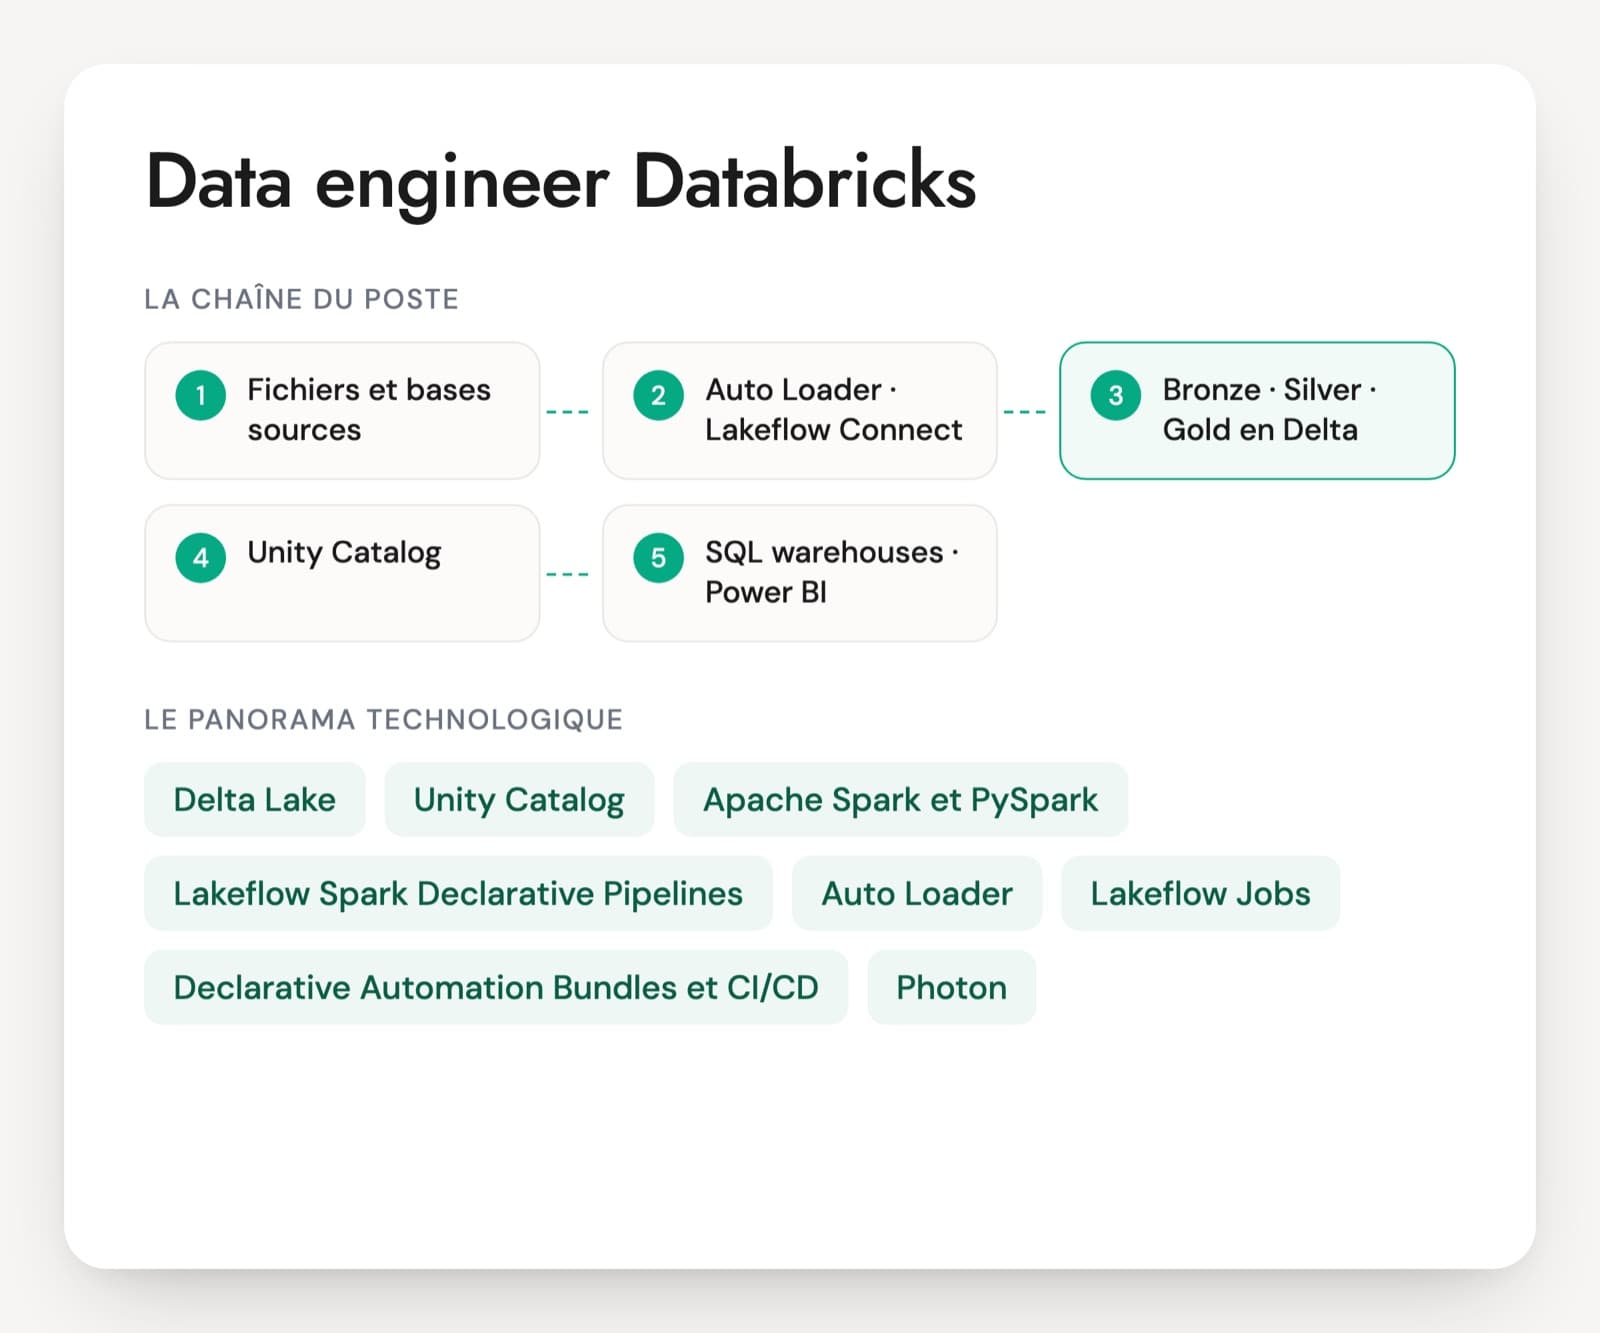
Les jobs tournent sur YARN dans un cluster Hadoop (Cloudera), sur Kubernetes, Amazon EMR, Google Dataproc ou Databricks. Le code Scala reste le même. La livraison du JAR, le réglage de la mémoire et la lecture des journaux changent d'une plateforme à l'autre.
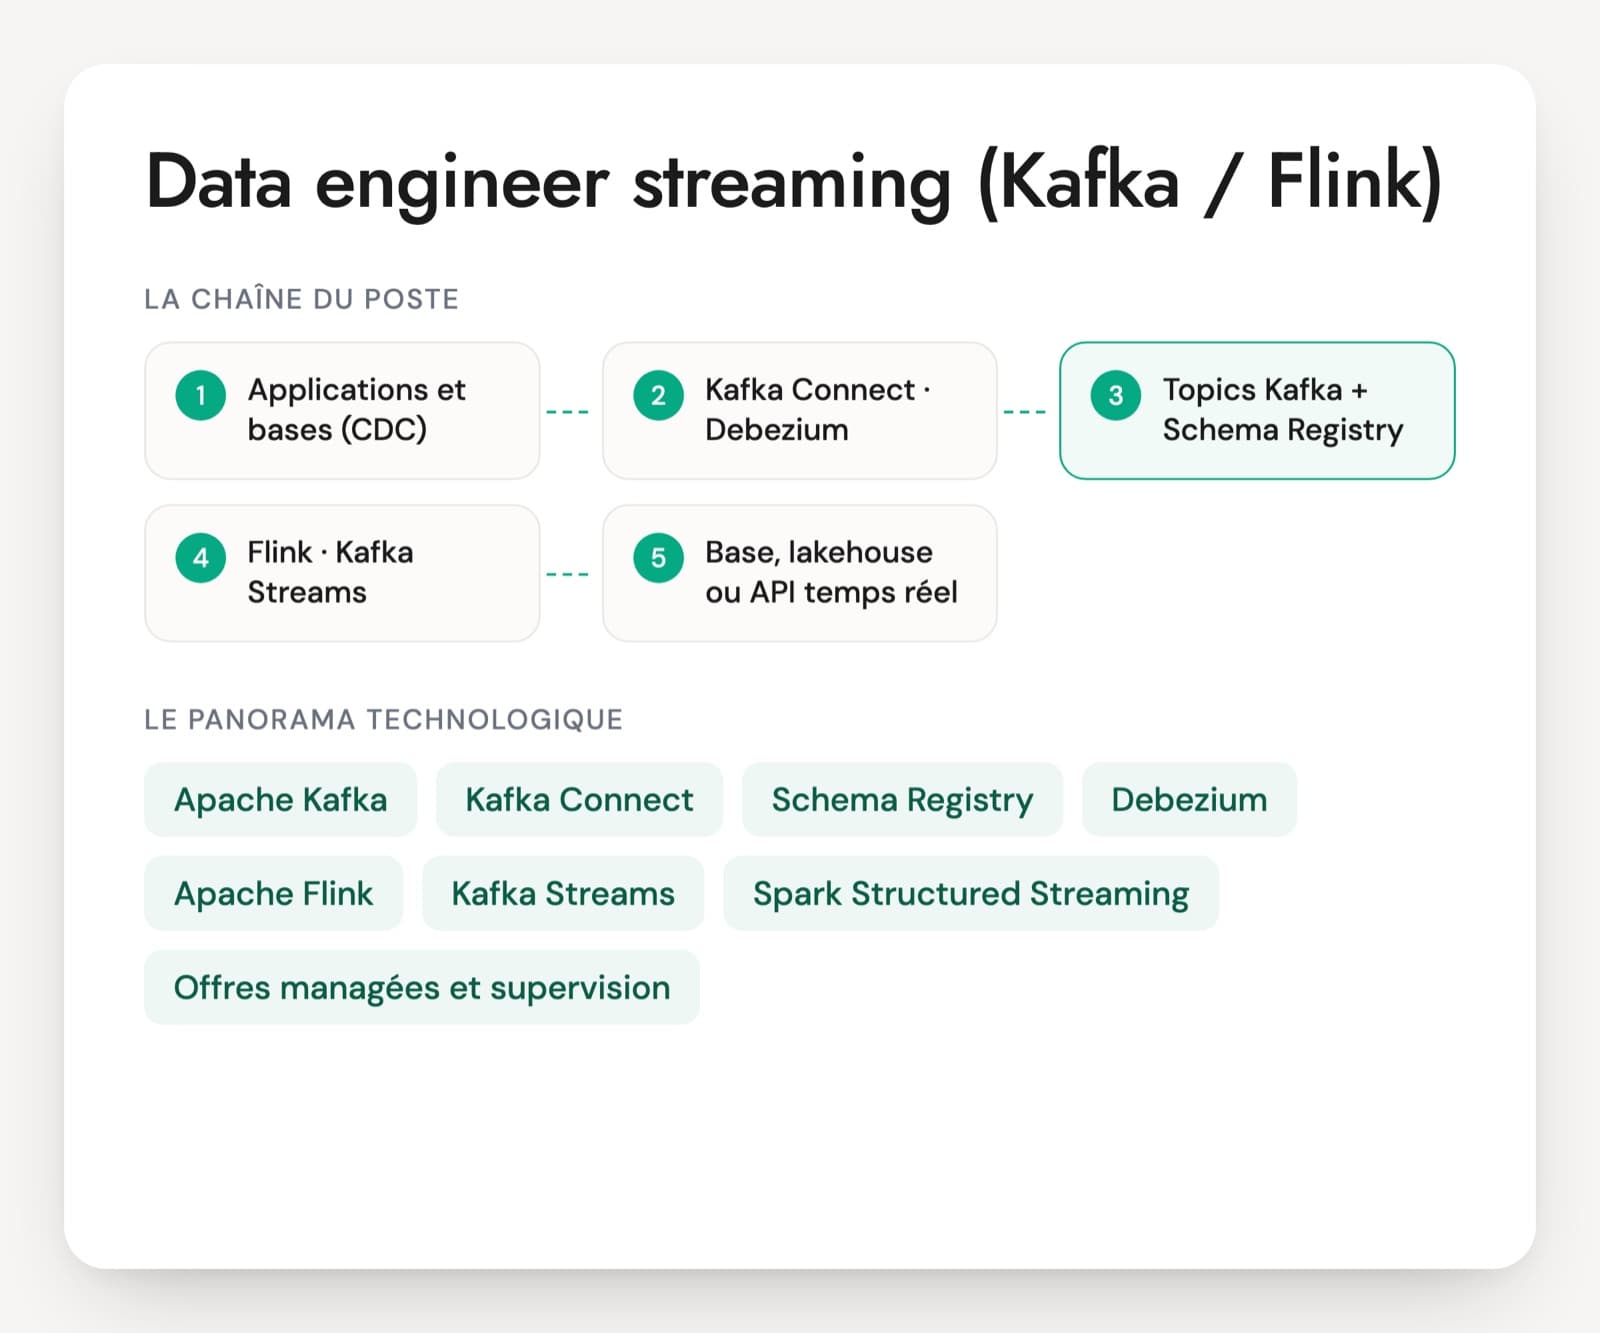
Le poste change de visage selon l'employeur. En banque et en assurance, le data engineer Scala maintient des chaînes de calcul de risque ou de reporting réglementaire écrites il y a plusieurs années, souvent sur Hadoop, et participe à leur migration vers Databricks ou Kubernetes. En ESN, il rejoint une équipe chez un client et doit lire vite un code qu'il n'a pas écrit. Dans une scale-up, Scala sert parfois aussi aux traitements en continu avec Kafka. Les équipes qui ont choisi Scala attendent un niveau de développeur, avec revue de code, tests automatisés et intégration continue, et beaucoup préparent en ce moment le passage à Spark 4.
Les compétences Scala et Spark à vérifier en entretien
- Scala fonctionnel et typé
- API Dataset, DataFrame et encodeurs
- Optimisation Spark (plan, shuffle, skew)
- Build sbt et gestion des dépendances
- Tests automatisés des transformations
- Écriture rejouable et migration vers Spark 4
Lire du code Scala Spark et accélérer un job lent
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Dataset typé ou DataFrame : quand choisissez-vous l'un ou l'autre, et que perdez-vous avec un map sur une case class ?
Une bonne réponseLe DataFrame n'est qu'un Dataset[Row] : les colonnes sont vérifiées à l'exécution. Le Dataset[T] fait vérifier les champs par le compilateur, utile aux frontières du job (entrée, sortie, contrat avec une autre équipe). En revanche, une fonction passée à map ou à filter est opaque pour Catalyst : Spark doit reconstruire des objets Scala, ne peut plus pousser le filtre vers la lecture ni écarter les colonnes inutiles. Un bon profil écrit les étapes lourdes avec des expressions de colonnes et garde le typage pour les contrats.
Signal d'alerte« Le Dataset est toujours plus rapide parce qu'il est typé », ou ignorer qu'un DataFrame est un Dataset de Row.
Question 2 · confirmé
Un job Spark passe 40 minutes sur une seule tâche alors que les 199 autres finissent en deux minutes. Que se passe-t-il, et que faites-vous ?
Une bonne réponseUn déséquilibre des données (skew) sur la clé d'une jointure ou d'une agrégation : beaucoup de valeurs nulles, une valeur par défaut, un très gros client. La personne le confirme dans la Spark UI en comparant la durée et le volume lu par tâche dans l'étape en cause. Pistes : vérifier que l'exécution adaptative (AQE) et sa gestion des jointures déséquilibrées sont actives, diffuser la petite table (broadcast), filtrer les nulls avant la jointure, ou saler la clé pour répartir la valeur dominante.
Signal d'alerte« J'augmente la mémoire des executors » ou un repartition(1000) lancé sans diagnostic. Une réponse qui ne mentionne jamais la Spark UI.
Question 3 · confirmé
Dans une transformation Scala, une colonne source peut être absente ou mal formée. Comment le code le gère-t-il sans faire tomber tout le job ni avaler les erreurs ?
Une bonne réponseOption plutôt que null pour une valeur absente, Either ou Try pour séparer les lignes valides des lignes en erreur, voire Validated de Cats pour accumuler plusieurs erreurs sur une ligne. Les rejets partent dans une table de quarantaine avec le motif, et un compteur suit leur part à chaque exécution. Côté Spark, un schéma explicite à la lecture et try_cast pour les conversions, d'autant que Spark 4 lève une erreur sur un cast invalide là où Spark 3 renvoyait null.
Signal d'alerteUn try/catch sur Exception qui renvoie null partout, ou des .get sur des Option qui font planter le job à la première valeur manquante.
Question 4 · confirmé
Votre JAR fonctionne en local mais plante sur le cluster avec une NoSuchMethodError. Où cherchez-vous ?
Une bonne réponseDans les dépendances. D'abord la version de Spark et la version binaire de Scala (_2.12 ou _2.13) du projet face à celles du cluster. Ensuite les dépendances Spark, qui doivent être déclarées en « provided » pour ne pas être embarquées dans le JAR. Enfin les bibliothèques transitives (Jackson, Guava, Protobuf) en conflit avec celles du cluster, repérées avec sbt dependencyTree ou evicted, puis alignées ou renommées par shading dans sbt-assembly.
Signal d'alerte« Je relance le job », ou ne pas savoir ce que signifie une dépendance provided.
Question 5 · junior à confirmé
Comment testez-vous une transformation Spark écrite en Scala avant sa mise en production ?
Une bonne réponseLa transformation est une fonction pure, de DataFrame à DataFrame ou de Dataset[A] à Dataset[B], séparée de la lecture et de l'écriture. Des tests ScalaTest l'appellent sur de petits jeux fabriqués dans le code (Seq(...).toDF), avec une SparkSession locale partagée entre les tests. On compare le schéma et le contenu sans dépendre de l'ordre des lignes, on couvre les nulls, les doublons et l'entrée vide. sbt test tourne dans la CI à chaque merge request.
Signal d'alerte« Je vérifie dans un notebook », ou un test qui ne contrôle que le nombre de lignes.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Scala, PySpark, Spark 4 : réponses aux recruteurs
Pourquoi certaines équipes data restent-elles sur Scala plutôt que PySpark ?
Souvent parce que la plateforme a été construite en Scala et que réécrire des années de code coûte cher. Les équipes y trouvent aussi la vérification des types à la compilation, un accès direct aux API internes de Spark et des UDF qui restent dans la JVM. Avec l'API DataFrame, les performances des deux langages sont proches. Le choix tient donc surtout à l'existant, aux bibliothèques utilisées et aux compétences de l'équipe.
Quels signes sur un CV montrent une vraie pratique de Scala ?
Des projets où la personne a construit les jobs, pas seulement corrigé des requêtes : un build sbt, des tests ScalaTest, une CI qui publie le JAR, une migration de version de Spark ou de Scala. La mention de Cats, de ZIO ou d'une bibliothèque interne publiée indique aussi un travail de développeur. Un CV qui cite Scala et Spark sans aucun outil de test ni de build mérite d'être creusé en entretien.
Quelle forme donner au test technique d'un data engineer Scala ?
Un exercice court en direct fonctionne bien : une transformation à écrire sur un petit jeu de données, puis le test unitaire qui la vérifie. Une variante consiste à faire relire un extrait de code réel, avec un collect() mal placé ou une UDF inutile, et à écouter les remarques. Un devoir de plusieurs jours à la maison décourage les bons profils et ne montre pas le raisonnement.
Spark 4 change-t-il quelque chose pour ce recrutement ?
Oui, si votre plateforme tourne encore sur Spark 3. Spark 4 ne fonctionne qu'avec Scala 2.13 et Java 17 au minimum, et son mode SQL strict lève des erreurs là où Spark 3 renvoyait des valeurs nulles. Une migration demande de recompiler le code et ses dépendances, puis de comparer les résultats sur des données réelles. Un candidat qui a déjà mené ce chantier sera opérationnel plus vite.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.