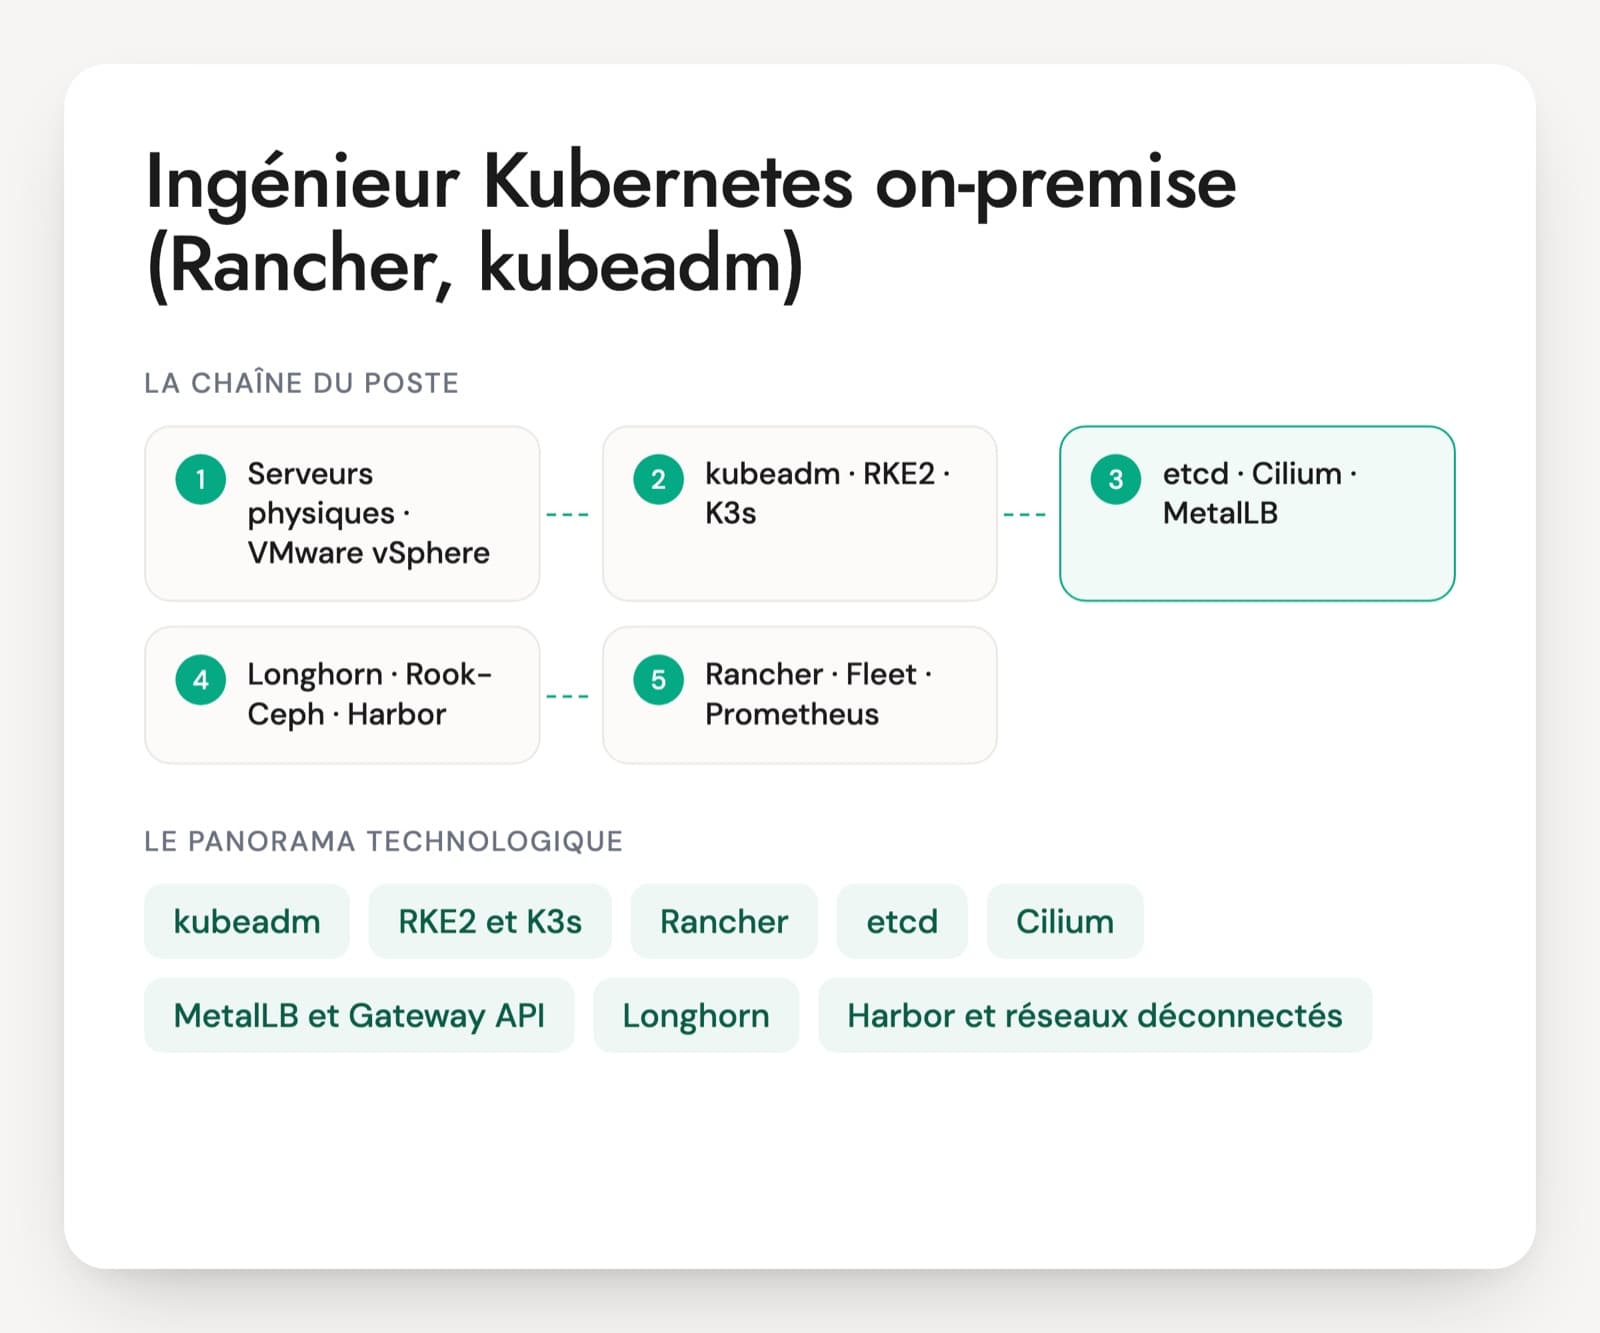
Un ingénieur Kubernetes on-premise installe et fait vivre des clusters que l'organisation héberge elle-même. Les offres françaises citent surtout RKE2 et K3s pilotés par Rancher, kubeadm quand l'équipe veut maîtriser chaque composant, sur vSphere ou sur serveurs physiques. Les questions d'entretien utiles portent sur ce qu'un service managé fait d'habitude en silence : le quorum etcd, la rotation des certificats, l'exposition des services sans load balancer cloud, le stockage des volumes, l'installation dans un réseau fermé.
Un CV EKS, AKS ou GKE ressemble beaucoup à celui-ci. L'écart apparaît dès qu'il faut décrire une restauration d'etcd, une montée de version kubeadm ou ce qui arrive quand le nœud qui portait l'adresse d'un service tombe. La CKA atteste les bases de l'administration. L'exploitation d'un parc sur plusieurs années se vérifie autrement.
Le nombre de clusters tenus, la durée et la distribution utilisée en disent long. Trois VM de test ne préparent pas à une mise à jour en production avec des bases de données dans des StatefulSets. Le PDF contient l'entretien complet : 30 questions sur six axes, un cas de 20 minutes et une grille de 1 à 4.
Les briques d'un cluster Kubernetes hébergé chez soi
kubeadm
L'outil officiel du projet Kubernetes pour créer un cluster et le monter de version, une version mineure à la fois. Il laisse le reste à l'équipe : réseau, stockage, load balancer, sauvegardes. Les certificats qu'il génère durent un an par défaut, et un cluster jamais mis à jour s'arrête le jour où ils expirent.
RKE2 et K3s
Les deux distributions de SUSE. RKE2 vise les datacenters et les exigences de sécurité, avec etcd intégré et des snapshots planifiés toutes les douze heures par défaut. K3s est un binaire léger pour les petits nœuds et les sites distants. RKE1, l'ancienne distribution, est en fin de vie depuis juillet 2025 : un CV qui la cite au présent décrit un parc à migrer.
Rancher
La console qui crée, met à jour et supervise plusieurs clusters, qu'ils aient été créés par Rancher ou importés. Les droits par projet et l'authentification d'entreprise (Active Directory, LDAP, SAML) s'y règlent. Rancher tourne lui-même sur un cluster dédié, qu'il faut sauvegarder.
etcd
La base clé-valeur qui contient tout l'état du cluster. Elle tourne sur trois ou cinq membres et a besoin d'une majorité pour accepter les écritures. Elle supporte mal les disques lents. Sa sauvegarde et sa restauration sont les premières choses à vérifier en entretien.
Cilium ou Calico
Les plugins réseau (CNI) les plus répandus. Ils donnent une adresse à chaque pod et appliquent les politiques réseau. Cilium peut aussi remplacer kube-proxy grâce à eBPF. En on-premise, les plages d'adresses des pods et des services doivent cohabiter avec le réseau existant de l'entreprise.
MetalLB et Gateway API
Sans cloud, un Service de type LoadBalancer attend une adresse qui ne vient jamais. MetalLB lui en attribue une dans une plage réservée et l'annonce en L2 (ARP) ou en BGP vers les routeurs. Devant les applications, un contrôleur Ingress ou une implémentation de Gateway API. Le projet Ingress NGINX a été retiré en mars 2026, beaucoup de clusters doivent donc en changer.
Longhorn, Rook-Ceph, CSI vSphere
Le stockage des volumes persistants. Longhorn réplique les volumes sur les disques des nœuds, Rook déploie Ceph dans le cluster, et sur VMware le pilote CSI vSphere crée des disques dans les datastores. Ce choix pèse sur la performance des bases de données et sur la façon de remplacer un nœud.
Harbor et réseaux déconnectés
Harbor est le registre d'images privé le plus courant, avec scan de vulnérabilités et réplication entre sites. Dans un réseau sans accès à internet, il faut y recopier les images du cluster, les charts Helm et chaque mise à jour avant de les installer. Reste à savoir comment la personne prépare ce lot.
Velero
Sauvegarde les objets Kubernetes et les volumes vers un stockage objet compatible S3, et restaure un namespace sur un autre cluster. Il complète la sauvegarde d'etcd sans la remplacer.
Ce profil travaille là où les applications et les données restent dans les datacenters de l'organisation : contraintes réglementaires, réseaux isolés, ou retour d'un cloud public pour des raisons de coût. Il vient souvent de l'administration Linux et de la virtualisation, puis a monté ses premiers clusters. Selon l'équipe, il construit la plateforme ou en assure le run, avec des astreintes. Les offres françaises associent Rancher et RKE2 à VMware et Ansible, plus rarement kubeadm seul. La CKA et les certifications Rancher de SUSE attestent les bases. La tenue d'un parc dans la durée se vérifie en entretien, par des pannes racontées et des mises à jour menées jusqu'au bout.
Les points techniques à valider chez un ingénieur Kubernetes on-premise
- etcd : quorum, sauvegarde et restauration
- Installation et montées de version (kubeadm, RKE2)
- Réseau du cluster : CNI, MetalLB, Gateway API
- Stockage persistant : Longhorn, Ceph, CSI vSphere
- Durcissement et installation hors ligne
- Exploitation d'un parc de clusters avec Rancher
Cinq questions d'exploitation pour un ingénieur Kubernetes on-premise
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Sur un cluster à trois nœuds de contrôle, deux machines tombent en même temps. Que se passe-t-il, et comment repartez-vous ?
Une bonne réponseAvec un seul membre sur trois, etcd perd le quorum : il refuse les écritures, l'API ne peut plus rien modifier, mais les pods déjà lancés continuent de tourner. Si les deux nœuds reviennent, le cluster se rétablit seul. Sinon, il faut restaurer à partir d'un snapshot récent : réinitialisation d'etcd sur un nœud (cluster-reset avec RKE2, restauration avec etcdutl puis nouveau membre initial avec kubeadm), puis les autres nœuds rejoignent le cluster après avoir été vidés de leurs données etcd. La personne sait que tout ce qui a changé depuis le snapshot est perdu.
Signal d'alerte« On ajoute un quatrième nœud », sans savoir qu'un nombre pair n'améliore pas la tolérance aux pannes. Ou une confusion entre la perte du plan de contrôle et l'arrêt des applications.
Question 2 · confirmé
Vous devez monter un cluster kubeadm de deux versions mineures. Comment procédez-vous ?
Une bonne réponseUne version mineure à la fois, kubeadm ne permet pas de sauter une version. D'abord les notes de version pour repérer les API retirées, et une vérification des manifests et des charts qui les utilisent. Puis un snapshot etcd, kubeadm upgrade apply sur un premier nœud de contrôle, kubeadm upgrade node sur les autres, et enfin les workers un par un : drain, mise à jour de kubeadm et du kubelet, uncordon. Il vérifie avant que le CNI, le pilote CSI et le contrôleur d'entrée supportent la version cible, et il respecte les PodDisruptionBudgets.
Signal d'alerteMettre à jour tous les paquets en même temps sur tous les nœuds, ou viser directement la dernière version sans étape intermédiaire.
Question 3 · junior à confirmé
Un Service de type LoadBalancer reste en Pending sur votre cluster. Pourquoi, et que mettez-vous en place ?
Une bonne réponseSans fournisseur cloud, aucun composant n'attribue d'adresse externe. MetalLB, kube-vip ou le load balancer intégré de Cilium s'en chargent, à partir d'une plage réservée avec l'équipe réseau. En mode L2, un seul nœud répond en ARP pour chaque adresse : tout le trafic de ce service passe par lui, et sa panne provoque une courte coupure le temps qu'un autre nœud reprenne l'adresse. En BGP, les nœuds annoncent l'adresse aux routeurs et le trafic se répartit, à condition que l'équipe réseau configure les sessions.
Signal d'alertePasser tous les services en NodePort et communiquer les ports aux utilisateurs, ou ne pas comprendre qu'il manque un composant.
Question 4 · senior
Une base PostgreSQL tourne dans le cluster sur un volume Longhorn. Le nœud qui l'héberge tombe. Que se passe-t-il ?
Une bonne réponseLe pod ne repart pas tout de suite : Kubernetes attend avant de déclarer le nœud perdu, et le volume reste attaché à l'ancien nœud tant que rien ne prouve qu'il ne peut plus écrire. Longhorn garde des répliques sur d'autres nœuds, et le volume peut être rattaché ailleurs une fois l'attachement libéré, par exemple avec le taint out-of-service posé sur le nœud mort. La personne compare avec une réplication faite par la base elle-même (un opérateur comme CloudNativePG avec un réplica), qui bascule plus vite sans dépendre du stockage.
Signal d'alerte« Le pod redémarre tout seul ailleurs », sans connaître le délai ni le problème d'attachement, ou ignorer le risque de deux pods qui écrivent sur le même volume.
Question 5 · confirmé
Le cluster doit être installé dans un réseau sans accès à internet. Comment préparez-vous l'installation ?
Une bonne réponseUn inventaire de tout ce qui se télécharge : binaires ou paquets de la distribution, images du système et des add-ons, charts Helm, images des applications. Tout est recopié dans un registre privé du réseau isolé, souvent Harbor, et les nœuds sont configurés pour le consulter à la place des registres publics (registries.yaml pour RKE2 et K3s, miroirs containerd sinon). RKE2 publie des archives d'images prévues pour ce cas. Le même circuit sert à chaque mise à jour et à chaque correctif, avec un contrôle des empreintes ou des signatures.
Signal d'alerteDécouvrir le jour de l'installation que les nœuds cherchent à joindre docker.io, ou copier les images à la main sur chaque nœud.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Les questions fréquentes sur le Kubernetes on-premise
Un ingénieur Kubernetes EKS peut-il tenir un cluster on-premise ?
Il connaît les objets Kubernetes, le déploiement des applications et le dépannage des pods, ce qui couvre une bonne part du travail. Il lui manque souvent ce que le service managé faisait pour lui : etcd et ses sauvegardes, les certificats, l'adresse de l'API server, le load balancer, le stockage des volumes. La question du quorum etcd et celle du Service en Pending le montrent vite. S'il y répond bien, la transition sera rapide. Sinon, une montée en compétence encadrée par l'équipe s'impose.
La CKA est-elle un bon filtre pour ce poste ?
La Certified Kubernetes Administrator est un examen pratique en ligne de commande : installation avec kubeadm, sauvegarde d'etcd, dépannage, réseau. C'est un bon signal pour un profil junior ou confirmé. Elle ne mesure ni l'exploitation d'un parc sur plusieurs années, ni la connaissance de Rancher, de Ceph ou d'un réseau isolé. La date d'obtention compte : elle est valable deux ans et l'examen suit les versions récentes de Kubernetes.
Quel test technique est donné à un ingénieur Kubernetes on-premise ?
Un cluster à réparer en dit plus qu'un questionnaire. Le test part de trois VM avec une panne simple : un certificat expiré, un nœud NotReady ou un Service sans adresse externe. En quarante-cinq minutes, la personne commente ce qu'elle tape. Ses commandes se voient, comme l'ordre dans lequel elle cherche et sa prudence avant de supprimer quoi que ce soit. Pour un profil senior, s'y ajoute une restauration d'etcd à partir d'un snapshot.
Rancher doit-il figurer sur le CV ?
Pas forcément. Rancher simplifie la gestion de plusieurs clusters, mais beaucoup d'équipes s'en passent avec kubeadm, Cluster API, Ansible et un outil GitOps comme Argo CD. Si le parc tourne sous Rancher, un profil solide sur RKE2, etcd et le réseau prendra vite la console en main. L'inverse est moins vrai : savoir créer un cluster dans l'interface de Rancher ne dit rien de la capacité à restaurer un cluster en panne.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.