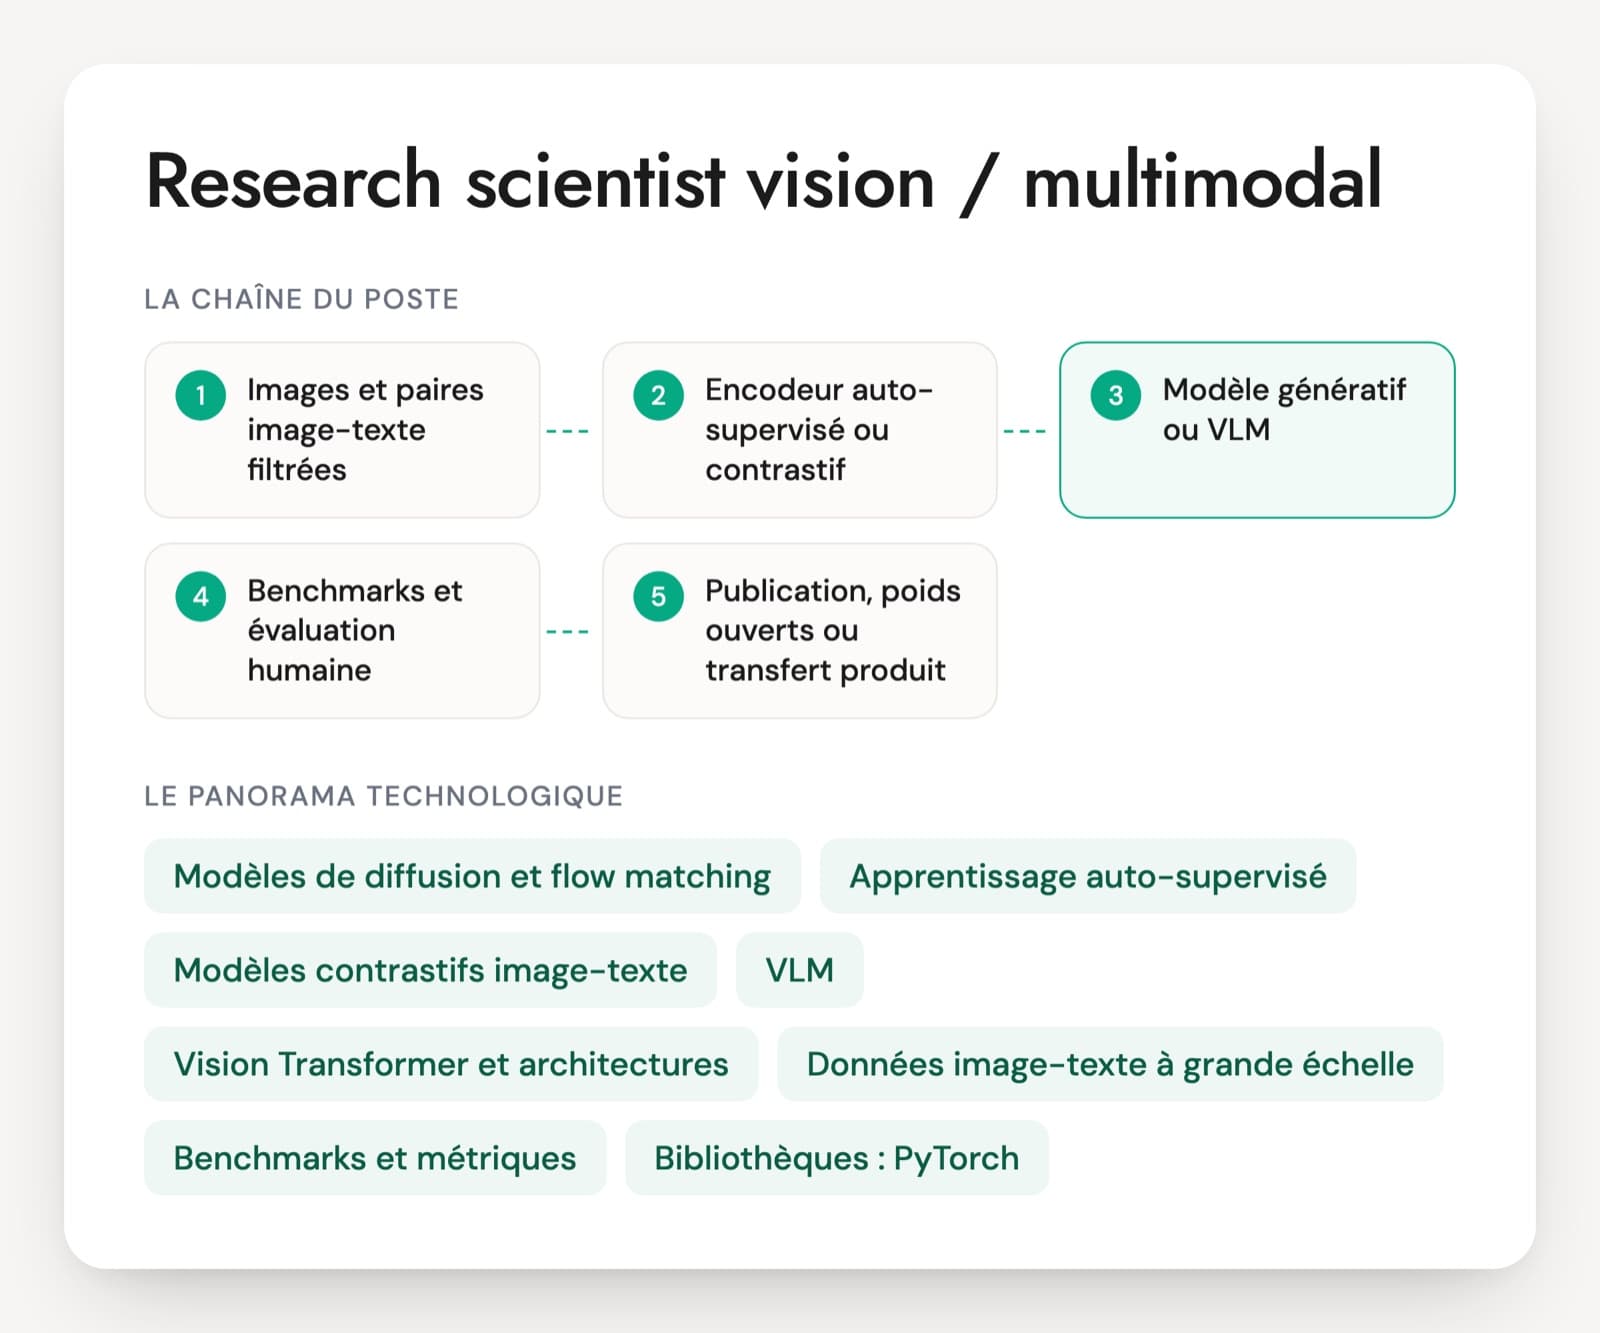
Un entretien de research scientist vision porte sur trois familles de modèles. Les modèles génératifs d'images (diffusion, flow matching), les encodeurs appris sans étiquettes (DINO, MAE) et les modèles qui relient image et texte (CLIP, SigLIP, VLM). La personne choisit un objectif d'entraînement, constitue des milliards de paires image-texte, entraîne sur des dizaines de GPU et publie à CVPR, ICCV, ECCV ou NeurIPS. En France, ces postes se trouvent dans les laboratoires industriels (FAIR à Paris, NAVER LABS Europe à Meylan), les laboratoires de modèles ouverts et quelques équipes de recherche appliquée.
La confusion la plus fréquente se fait avec l'ingénieur computer vision. Un CV qui cite YOLO, la détection et le déploiement sur caméra décrit un métier d'application, pas de recherche. À l'inverse, un chercheur peut connaître la théorie de la diffusion sans avoir jamais réglé une échelle de guidage ni vérifié un FID. Les réponses sur l'effondrement des représentations, les hallucinations d'un VLM ou la ligne de base sans image tranchent vite.
Le PDF associé reprend ces questions dans un entretien complet : 30 questions sur six axes, un cas de 20 minutes sur un VLM pour documents administratifs français et une grille de notation de 1 à 4. Les questions de la page en sont la première partie.
Familles de modèles et jeux de référence en vision et multimodal
Modèles de diffusion et flow matching
Les modèles qui génèrent des images en partant du bruit, étape par étape. La diffusion apprend à débruiter, le flow matching apprend un trajet direct entre bruit et image. La plupart travaillent dans l'espace compressé d'un autoencodeur, avec un Transformer (DiT) à la place de l'ancien U-Net. Faites expliquer ce que prédit le réseau et comment on réduit le nombre d'étapes.
Apprentissage auto-supervisé (DINOv2, DINOv3, MAE)
Des encodeurs entraînés sur des images sans étiquettes, qui servent ensuite de base à la segmentation, à la profondeur ou à la recherche d'images. DINO apprend par auto-distillation, MAE en reconstruisant des zones masquées. DINOv2 et DINOv3 viennent des équipes de Meta, en partie à Paris.
Modèles contrastifs image-texte (CLIP, SigLIP)
Ils placent images et textes dans un même espace pour la recherche et la classification sans exemple. SigLIP remplace la perte de CLIP par une perte plus économe en mémoire. Leurs encodeurs servent souvent de base aux VLM.
VLM (modèles vision-langage)
Un encodeur d'images relié à un LLM par un projecteur, entraîné à répondre à des questions sur des images, des documents ou des graphiques. Les sujets de recherche portent sur la résolution, les données d'instruction et les hallucinations. Certains modèles intègrent l'image dès l'entrée du Transformer (fusion précoce).
Vision Transformer et architectures
Le ViT découpe l'image en patches traités comme des tokens et sert de base à la plupart des travaux récents. Les réseaux convolutifs modernes (ConvNeXt) restent des points de comparaison. Un chercheur doit savoir écrire un ViT et expliquer ses limites en résolution.
Données image-texte à grande échelle
Des milliards de paires collectées sur le web, à dédupliquer, filtrer et parfois re-légender avec un VLM. Les questions de droit d'auteur, de données personnelles et de contenus illicites font partie du travail depuis le retrait de LAION-5B fin 2023.
Benchmarks et métriques
ImageNet en linear probing, COCO et ADE20K pour la détection et la segmentation, FID et GenEval pour la génération, DocVQA ou MMMU pour les VLM. Chaque métrique a ses biais, et la contamination des benchmarks par les données web est un sujet en soi.
Bibliothèques : PyTorch, timm, diffusers, open_clip
Les briques open source les plus utilisées pour reproduire et étendre les travaux publiés, avec PyTorch comme base. Demandez à la personne ce qu'elle a modifié dans ces bibliothèques, pas seulement ce qu'elle a appelé.
Les postes de recherche en vision se répartissent entre laboratoires qui publient beaucoup (FAIR, NAVER LABS Europe, équipes académiques comme celles de l'Inria) et équipes qui entraînent des modèles destinés à un produit, génération d'images, VLM pour documents ou robotique. Les intitulés varient : research scientist, research engineer, applied scientist, deep learning scientist. Les offres demandent des publications dans les grandes conférences de vision et d'apprentissage, une maîtrise de PyTorch et l'habitude des entraînements multi-GPU. Une thèse est fréquente. L'entretien sert à vérifier que la personne sait défendre ses choix expérimentaux, pas seulement les résultats publiés.
Six compétences à évaluer chez un research scientist vision
- Modèles de diffusion et flow matching
- Apprentissage auto-supervisé
- VLM et apprentissage contrastif
- Données image-texte à grande échelle
- Métriques et benchmarks de vision
- Implémentation et protocole expérimental
Cinq questions de recherche en vision et en multimodal
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · senior
Diffusion ou flow matching : qu'est-ce qui change dans l'objectif d'entraînement et au moment de générer ?
Une bonne réponseEn diffusion, on bruite l'image selon un schedule et le réseau apprend à prédire le bruit (ou l'image propre, ou une vitesse) pour débruiter en de nombreuses étapes. Le flow matching, et le rectified flow, apprennent un champ de vitesse le long d'un chemin entre bruit et données, souvent rectiligne, puis intègrent une équation différentielle, ce qui permet moins d'étapes. Il sait que les deux se rejoignent sous certaines paramétrisations, et que des modèles récents comme Stable Diffusion 3 utilisent le rectified flow.
Signal d'alerteRéciter DDPM sans savoir ce que prédit le réseau, ou présenter le flow matching comme une architecture.
Question 2 · senior
DINO et MAE apprennent sans étiquettes. Comment chacun évite-t-il de produire une représentation triviale ?
Une bonne réponseDINO fait de l'auto-distillation : un élève imite un professeur mis à jour par moyenne mobile, et le centrage et l'affûtage des sorties du professeur empêchent l'effondrement, avec des vues multiples à plusieurs échelles. MAE masque une grande partie des patches (75 % dans le papier) et reconstruit les pixels : la tâche n'a pas de solution triviale. Les features MAE demandent un fine-tuning, celles de DINO marchent bien gelées. Il cite les ajouts de DINOv2 (perte au niveau des patches, KoLeo) et le Gram anchoring de DINOv3 pour les features denses.
Signal d'alerteConfondre contrastif, distillation et reconstruction, ou ne pas savoir ce qu'est l'effondrement.
Question 3 · confirmé
Comment construisez-vous un VLM à partir d'un encodeur d'images et d'un LLM existants ?
Une bonne réponseUn encodeur visuel (SigLIP, CLIP), un projecteur (souvent un MLP) qui place les tokens d'image dans l'espace d'embedding du LLM, une première étape où seul le projecteur s'entraîne sur des légendes, puis une phase d'instruction où le LLM, voire l'encodeur, est dégelé. Il traite la résolution (découpage en tuiles, résolution dynamique) et son coût en tokens, et évalue sur des questions visuelles, l'OCR et les hallucinations.
Signal d'alerte« On ajoute l'image au prompt », sans projection ni étapes d'entraînement.
Question 4 · confirmé
Vous entraînez un modèle image-texte sur des paires collectées sur le web. Comment filtrez-vous les données ?
Une bonne réponseDéduplication (hash perceptuel, embeddings), filtrage par score CLIP en connaissant son biais vers ce que CLIP connaît déjà, contrôle de la qualité des légendes ou re-légendage par un VLM, filtrage des contenus pour adultes et des abus sur mineurs, retrait des images des jeux d'évaluation, respect des opt-out. Il sait que LAION-5B a été retiré fin 2023 après la découverte de tels contenus, puis republié nettoyé (Re-LAION).
Signal d'alerteTout le crawl tel quel, ou un seul filtre CLIP présenté comme suffisant.
Question 5 · confirmé
Le FID baisse de deux points avec votre nouvelle méthode. Est-ce suffisant pour conclure qu'elle est meilleure ?
Une bonne réponseNon sans précautions. Le FID dépend du nombre d'échantillons, de l'implémentation (redimensionnement, poids d'Inception, d'où clean-fid) et du jeu de référence. Les features Inception sont biaisées vers ImageNet et le FID ne mesure pas le respect du prompt. Il ajoute précision et rappel, une distance calculée avec d'autres features comme DINOv2, plusieurs graines et une évaluation humaine.
Signal d'alerteLe FID comme seul juge, calculé sur mille images.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Profil, travaux, test : recruter un chercheur en vision
Research scientist vision ou ingénieur computer vision : quelle différence pour le poste ?
L'ingénieur computer vision applique des modèles existants à un problème précis : détection sur une ligne de production, lecture de documents, vidéo. Il s'occupe des données métier, du déploiement et des contraintes matérielles. Le research scientist fait progresser les modèles eux-mêmes : nouvel objectif d'entraînement, nouvelle architecture, nouveau protocole d'évaluation, avec publication à la clé. Si votre besoin est un produit à livrer dans l'année sur des modèles connus, l'ingénieur convient mieux.
Quels travaux demander à un chercheur en vision avant l'entretien ?
Ses deux ou trois papiers les plus représentatifs avec sa contribution précise, le code publié, les modèles ou jeux de données mis en ligne. Lisez au moins les figures et la section expérimentale du papier principal pour préparer des questions. Un dépôt de code maintenu, utilisé par d'autres, dit beaucoup sur la qualité d'ingénierie. Pour un profil junior, un mémoire ou un projet de reproduction bien documenté peut remplacer les publications.
Faut-il un test technique quand le candidat a déjà publié à CVPR ?
Oui, sous une forme courte. Une publication montre un travail abouti, souvent collectif, pas la capacité à coder seul ni à raisonner en direct. Demandez l'écriture d'un bloc de ViT ou d'une étape d'échantillonnage de diffusion, puis une discussion sur un papier récent : baselines, métriques, ablation manquante. Une heure suffit. Les grilles du PDF de Delectus aident à noter cet échange de façon comparable d'un candidat à l'autre.
Un spécialiste des modèles génératifs d'images peut-il passer aux VLM ?
Souvent, car les bases sont communes : Transformers, entraînement distribué, données image-texte, encodeurs comme CLIP ou SigLIP. Les VLM demandent en plus une bonne connaissance des LLM, du post-entraînement et de l'évaluation des réponses textuelles, dont les hallucinations. Vérifiez en entretien que la personne sait construire et évaluer un VLM, en particulier la ligne de base sans image et la gestion de la résolution.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.