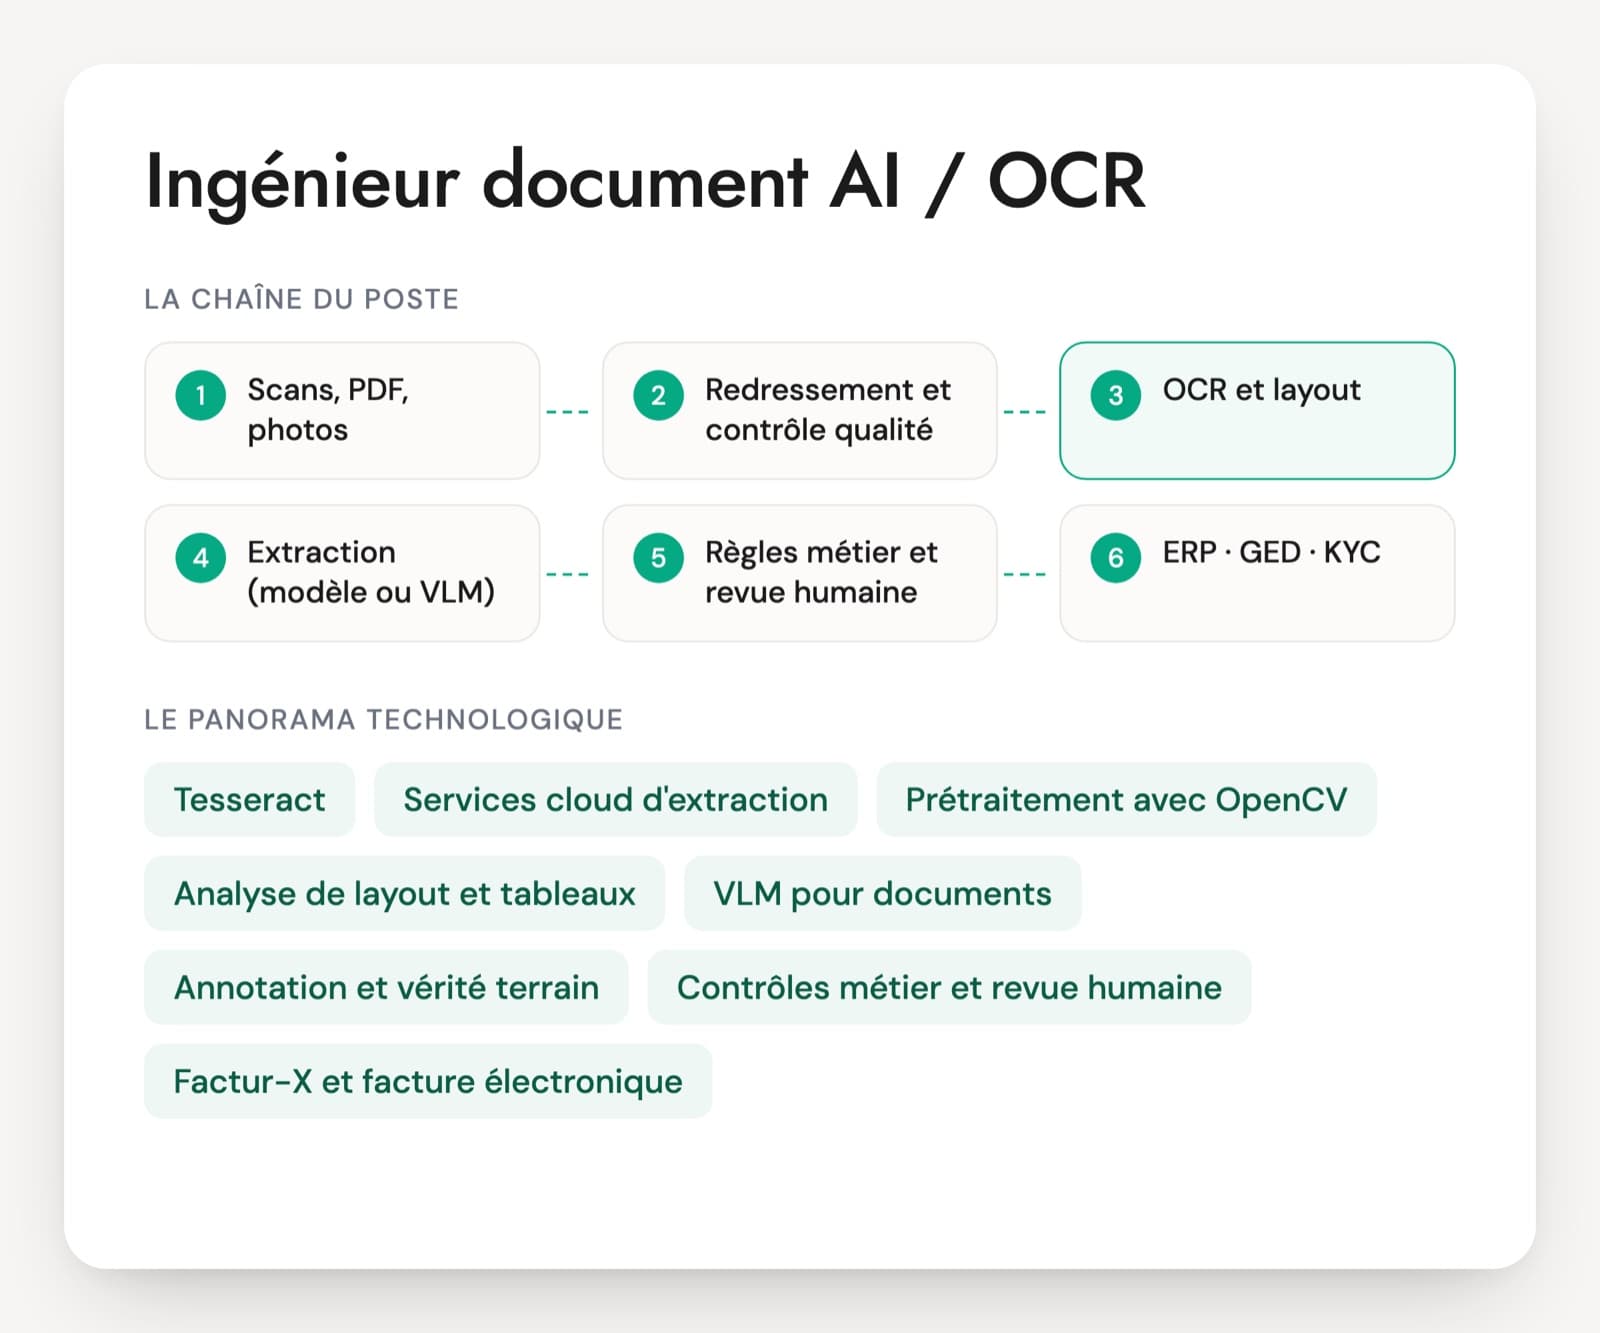
Un ingénieur document AI transforme des PDF, des scans et des photos prises au téléphone en données propres pour un ERP, une GED ou un parcours KYC. Il redresse les images, choisit un moteur OCR, reconstruit les tableaux, puis extrait les champs avec un modèle entraîné ou un modèle vision-langage. Les offres viennent des fintechs, des assureurs, des éditeurs de dématérialisation et des ESN qui portent des projets d'automatisation.
Une démo réussie sur dix documents ressemble beaucoup, sur le papier, à une chaîne qui tient sur cent mille. La différence se voit dans la façon de mesurer. Un profil de production parle de vérité terrain annotée, de précision par champ, de scores de confiance calibrés et de règles métier qui attrapent un IBAN faux. Il sait aussi qu'un VLM peut remplir un champ illisible avec une valeur plausible.
Types de documents, volume mensuel, taux d'erreur toléré par le métier : ces trois données, à obtenir du manager, fixent le cadre de l'entretien. Avec un junior, restez sur le prétraitement et le choix du moteur OCR. Avec un senior, faites expliquer comment il a construit sa vérité terrain et qui l'a annotée. Les factures fournisseurs d'un groupe industriel servent de support au cas pratique.
Moteurs OCR, modèles et services d'un ingénieur document AI
Tesseract, docTR et PaddleOCR
Les moteurs OCR open source les plus cités dans les offres. Tesseract est le plus ancien, docTR (porté par Mindee) et PaddleOCR reposent sur des réseaux de neurones pour détecter puis lire le texte. On les choisit quand les documents ne doivent pas quitter l'infrastructure du client ou quand le volume rend un service payant trop cher.
Services cloud d'extraction
Azure Document Intelligence (désormais rattaché aux Foundry Tools de Microsoft), Amazon Textract et Google Document AI proposent des modèles prêts pour les factures, les reçus ou les pièces d'identité, et des modèles personnalisés entraînés sur quelques dizaines de documents annotés. Demandez sur quels critères la personne a choisi l'un plutôt qu'un moteur hébergé.
Prétraitement avec OpenCV
Avant l'OCR, l'image est redressée, recadrée, débruitée, parfois binarisée. Pour une photo de téléphone, il faut aussi détecter les bords du document et corriger la perspective. Une bonne partie des erreurs de lecture se règle ici, avant de toucher au modèle.
Analyse de layout et tableaux
Retrouver les blocs, l'ordre de lecture, les titres et surtout la structure des tableaux. LayoutLMv3 combine texte, position et image, Docling convertit un PDF en document structuré, et les services cloud renvoient des cellules avec leurs coordonnées. C'est la partie qui casse le plus souvent sur les factures à lignes multiples.
VLM pour documents
Les modèles vision-langage lisent une page et rendent directement un JSON de champs, en API (Mistral OCR, Gemini, GPT) ou en open-weight comme Qwen-VL, fine-tunable. Ils couvrent la longue traîne des mises en page sans annotation, mais coûtent plus cher par page et peuvent inventer une valeur. L'entretien doit vérifier comment ce risque est contrôlé.
Annotation et vérité terrain
Des outils comme Label Studio servent à annoter les champs et les zones sur un échantillon de documents. Ce jeu de référence, tenu à part de l'entraînement, est la seule base honnête pour comparer deux moteurs ou deux versions. Un candidat sérieux en parle sans qu'on le lui demande.
Contrôles métier et revue humaine
Clé de contrôle de l'IBAN, numéro SIREN, cohérence HT, TVA et TTC, MRZ d'une pièce d'identité : ces vérifications attrapent des erreurs sans regarder l'image. Combinées aux scores de confiance, elles décident si un document part en traitement automatique ou dans une file de relecture.
Factur-X et facture électronique
Depuis septembre 2026, toutes les entreprises françaises doivent pouvoir recevoir des factures électroniques structurées (Factur-X, UBL, CII), et l'émission se généralise jusqu'en 2027. Une facture Factur-X contient déjà ses données en XML. Un ingénieur à jour le lit avant de lancer un OCR sur le PDF.
Le poste porte plusieurs titres selon l'employeur : ingénieur computer vision, ML engineer document AI, ingénieur IDP (intelligent document processing), parfois développeur IA sur un projet d'automatisation. Chez un éditeur, la personne améliore un produit d'extraction utilisé par de nombreux clients et suit ses métriques dans la durée. En ESN, elle monte une chaîne pour un client précis, souvent avec un service cloud ou une plateforme RPA comme UiPath Document Understanding. Dans la banque et l'assurance, les pièces d'identité et les justificatifs ajoutent des contraintes RGPD fortes sur l'hébergement et la conservation. L'arrivée des VLM a déplacé le métier vers l'évaluation et le contrôle des sorties, plus que vers l'entraînement de modèles from scratch.
Les points à contrôler chez un ingénieur OCR
- OCR et prétraitement d'image
- Analyse de layout et tableaux
- Extraction par modèles entraînés et VLM
- Évaluation champ par champ
- Scores de confiance et revue humaine
- Industrialisation et données sensibles
Cinq questions d'entretien pour un ingénieur document AI
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Sur un lot de factures scannées, l'OCR se trompe surtout sur les montants. Comment cherchez-vous la cause ?
Une bonne réponseEn triant les erreurs avant de changer quoi que ce soit. Un échantillon annoté permet de mesurer le taux d'erreur par caractère sur les montants et sur le reste. Puis on regarde les images fautives : résolution trop basse, page de travers, compression JPEG, ligne coupée à la détection, confusion entre virgule et point ou entre 0 et O, séparateur de milliers mal normalisé. Selon la cause, on corrige le prétraitement, la normalisation ou le moteur, et on ajoute un contrôle de cohérence sur les totaux.
Signal d'alerte« On change de moteur OCR » ou « on passe à un VLM » sans avoir regardé une seule image fautive. Aucune mesure avant et après la correction.
Question 2 · confirmé
Comment mesurez-vous la qualité d'une chaîne qui extrait quinze champs d'un contrat ?
Une bonne réponseAvec une vérité terrain annotée sur un échantillon représentatif (types de contrats, qualité de scan, émetteurs), jamais utilisée pour l'entraînement. Pour chaque champ : précision et rappel après normalisation des dates et des montants, en séparant valeur fausse, valeur manquante et valeur inventée pour un champ absent. Au niveau document, la part de contrats dont tous les champs sont justes, celle qui compte pour l'automatisation. Le taux d'erreur par caractère sert à juger l'OCR brut, pas l'extraction.
Signal d'alerteUn seul chiffre de précision global, ou une évaluation sur les documents qui ont servi à mettre au point le modèle.
Question 3 · senior
Vous recevez des factures de 3 000 fournisseurs aux mises en page toutes différentes. Gabarits, modèle entraîné ou VLM : comment choisissez-vous ?
Une bonne réponseDes gabarits seulement pour quelques gros fournisseurs à mise en page stable. Pour la variété, un modèle de facture prêt à l'emploi ou un modèle personnalisé entraîné sur des exemples annotés par famille de mise en page. Un VLM avec un schéma de sortie imposé pour la longue traîne ou en secours quand la confiance est basse, en tenant compte du coût par page, de la latence et du risque de valeur inventée. La décision se prend sur le même jeu d'évaluation pour les trois options.
Signal d'alerteUn gabarit par fournisseur pour 3 000 fournisseurs, ou « un VLM pour tout » sans chiffrer le coût ni mesurer les erreurs.
Question 4 · senior
Un VLM extrait les champs d'une carte d'identité. Comment l'empêchez-vous d'inventer une date de naissance illisible ?
Une bonne réponseUn schéma de sortie où la valeur nulle est permise et demandée quand le champ est illisible, des contraintes de format, puis des vérifications indépendantes du modèle : la bande MRZ et ses chiffres de contrôle, la comparaison avec le texte réellement lu par l'OCR sur la zone. En cas de désaccord ou de doute, le document part en relecture. Le taux de valeurs inventées se mesure sur un jeu d'images dégradées construit exprès.
Signal d'alerteFaire confiance à la sortie parce qu'elle a le bon format, ou « je baisse la température » comme seule protection.
Question 5 · confirmé
Sur quels critères décidez-vous qu'un document part sans relecture humaine ?
Une bonne réponseUn score de confiance par champ, calibré sur un jeu de validation pour qu'un score de 0,9 corresponde à peu près à 90 % de valeurs justes. Un seuil par champ selon le coût d'une erreur, plus strict pour un IBAN que pour une date d'émission. Des règles métier en plus : clé IBAN, SIREN, totaux, fournisseur connu du référentiel. Un seul champ critique sous le seuil envoie tout le document en revue. En production, on suit la part automatisée et on audite un échantillon des documents passés sans relecture.
Signal d'alertePrendre le score brut du modèle comme une probabilité, ou un seuil unique pour tous les champs, fixé au jugé.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Recruter un ingénieur OCR : réponses aux questions fréquentes
Quelle différence entre un ingénieur document AI et un développeur RPA ?
Le développeur RPA automatise un processus avec une plateforme comme UiPath et branche un module d'extraction existant. L'ingénieur document AI construit ou choisit ce module : prétraitement des images, moteur OCR, modèle d'extraction, mesure de la qualité et seuils de relecture. Sur un projet de dématérialisation, les deux profils travaillent souvent ensemble. Si votre besoin se limite à configurer un module fourni par l'éditeur, un profil RPA expérimenté suffit.
Faut-il chercher un profil computer vision ou un profil NLP ?
Le poste est à la frontière. La partie image (redressement, détection de zones, tableaux, écriture manuscrite) relève de la computer vision. L'extraction des champs, le découpage pour un moteur de recherche et l'usage des VLM touchent au traitement du langage. Partez de vos documents : des scans de mauvaise qualité et des formulaires manuscrits demandent un profil vision, des contrats longs en PDF natif un profil plus orienté texte.
Comment organiser un test technique pour un ingénieur OCR ?
Donnez une dizaine de documents réels anonymisés, dont quelques-uns de mauvaise qualité, avec la vérité terrain de deux ou trois champs. Demandez une extraction et surtout une mesure de ses erreurs, en une heure ou deux. La façon de compter les erreurs et d'expliquer les échecs vous en apprend plus que le score obtenu. Débriefez ensuite à l'oral sur ce qu'il faudrait pour passer à cent mille documents.
Les VLM rendent-ils l'OCR classique inutile ?
Non. Un VLM couvre bien les mises en page variées sans annotation, mais il coûte plus cher par page, répond plus lentement et peut inventer une valeur plausible. Beaucoup de chaînes combinent les deux : lecture directe du texte pour les PDF natifs, OCR et modèle léger pour le volume courant, VLM pour les cas difficiles. Un bon candidat sait justifier ce partage avec des mesures et un coût par document.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.