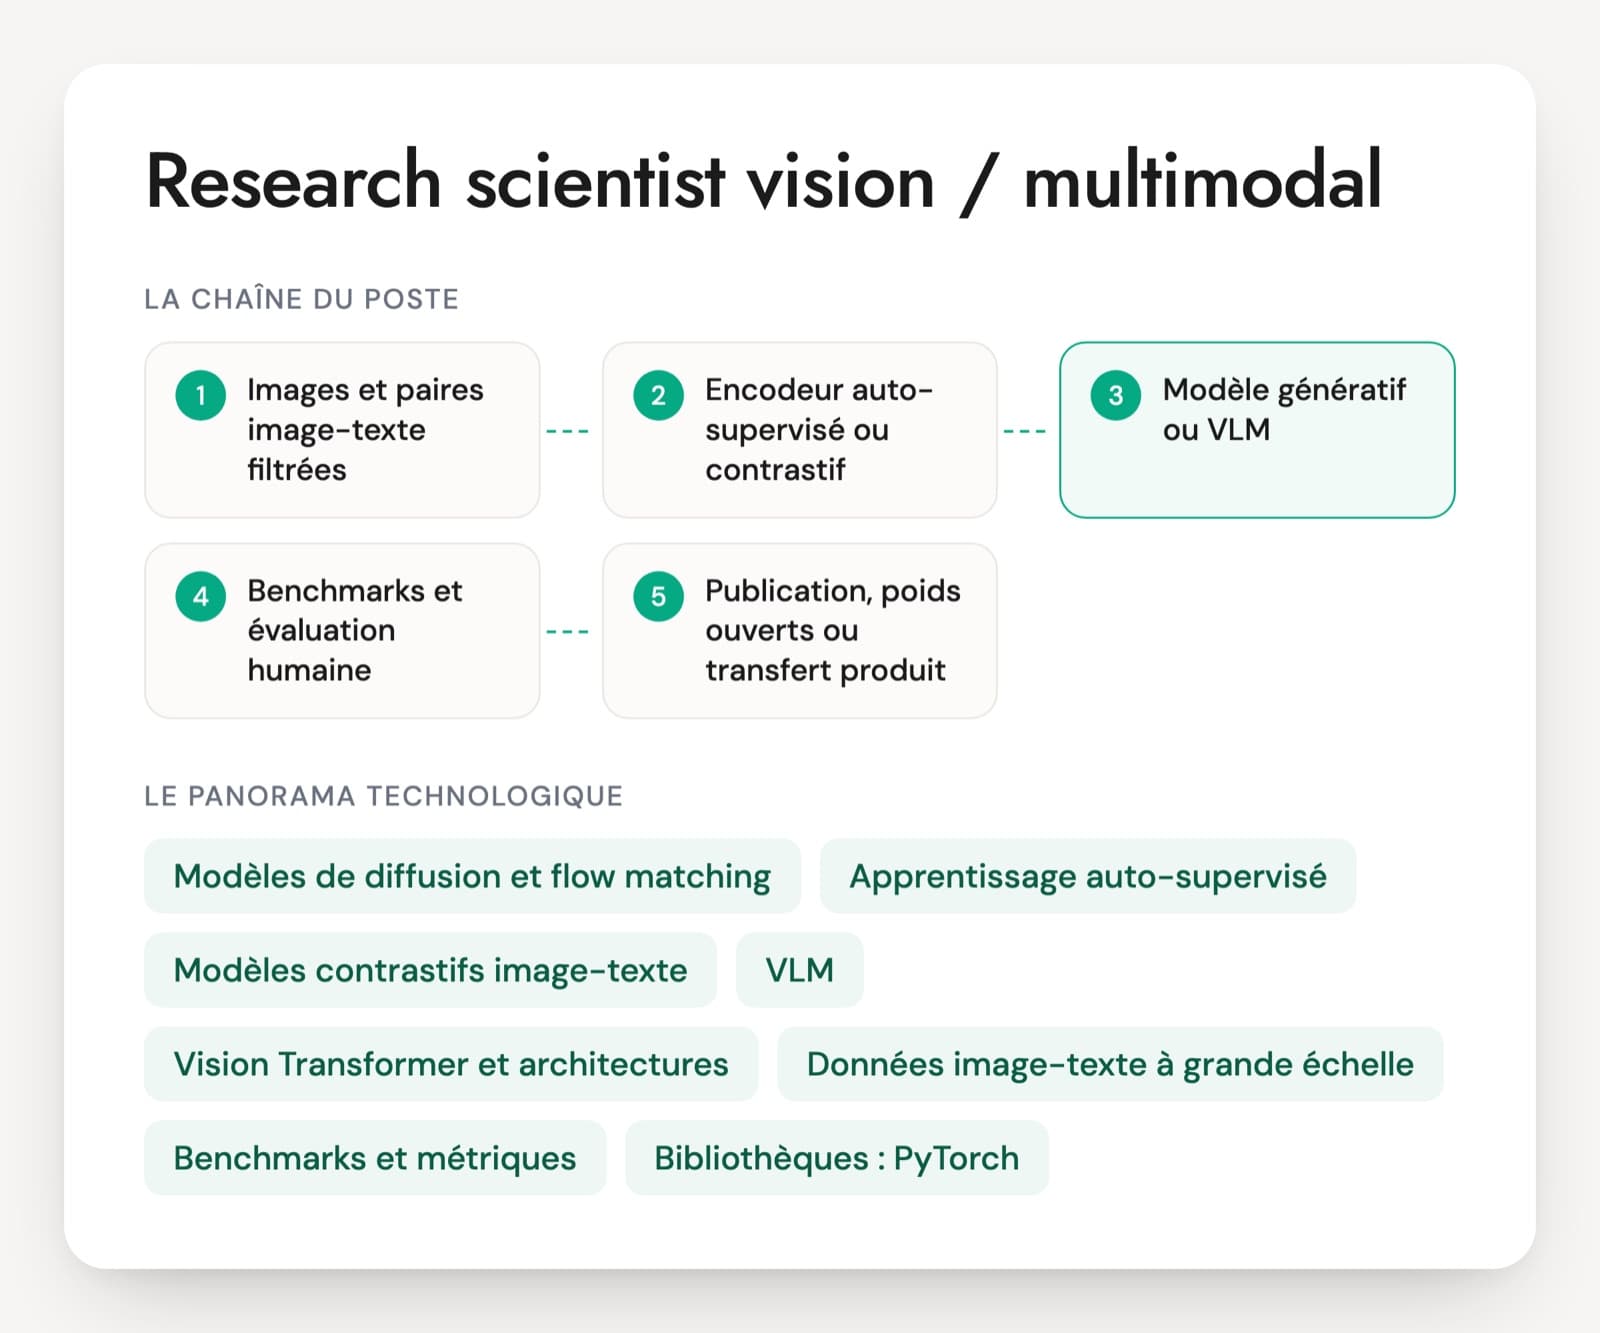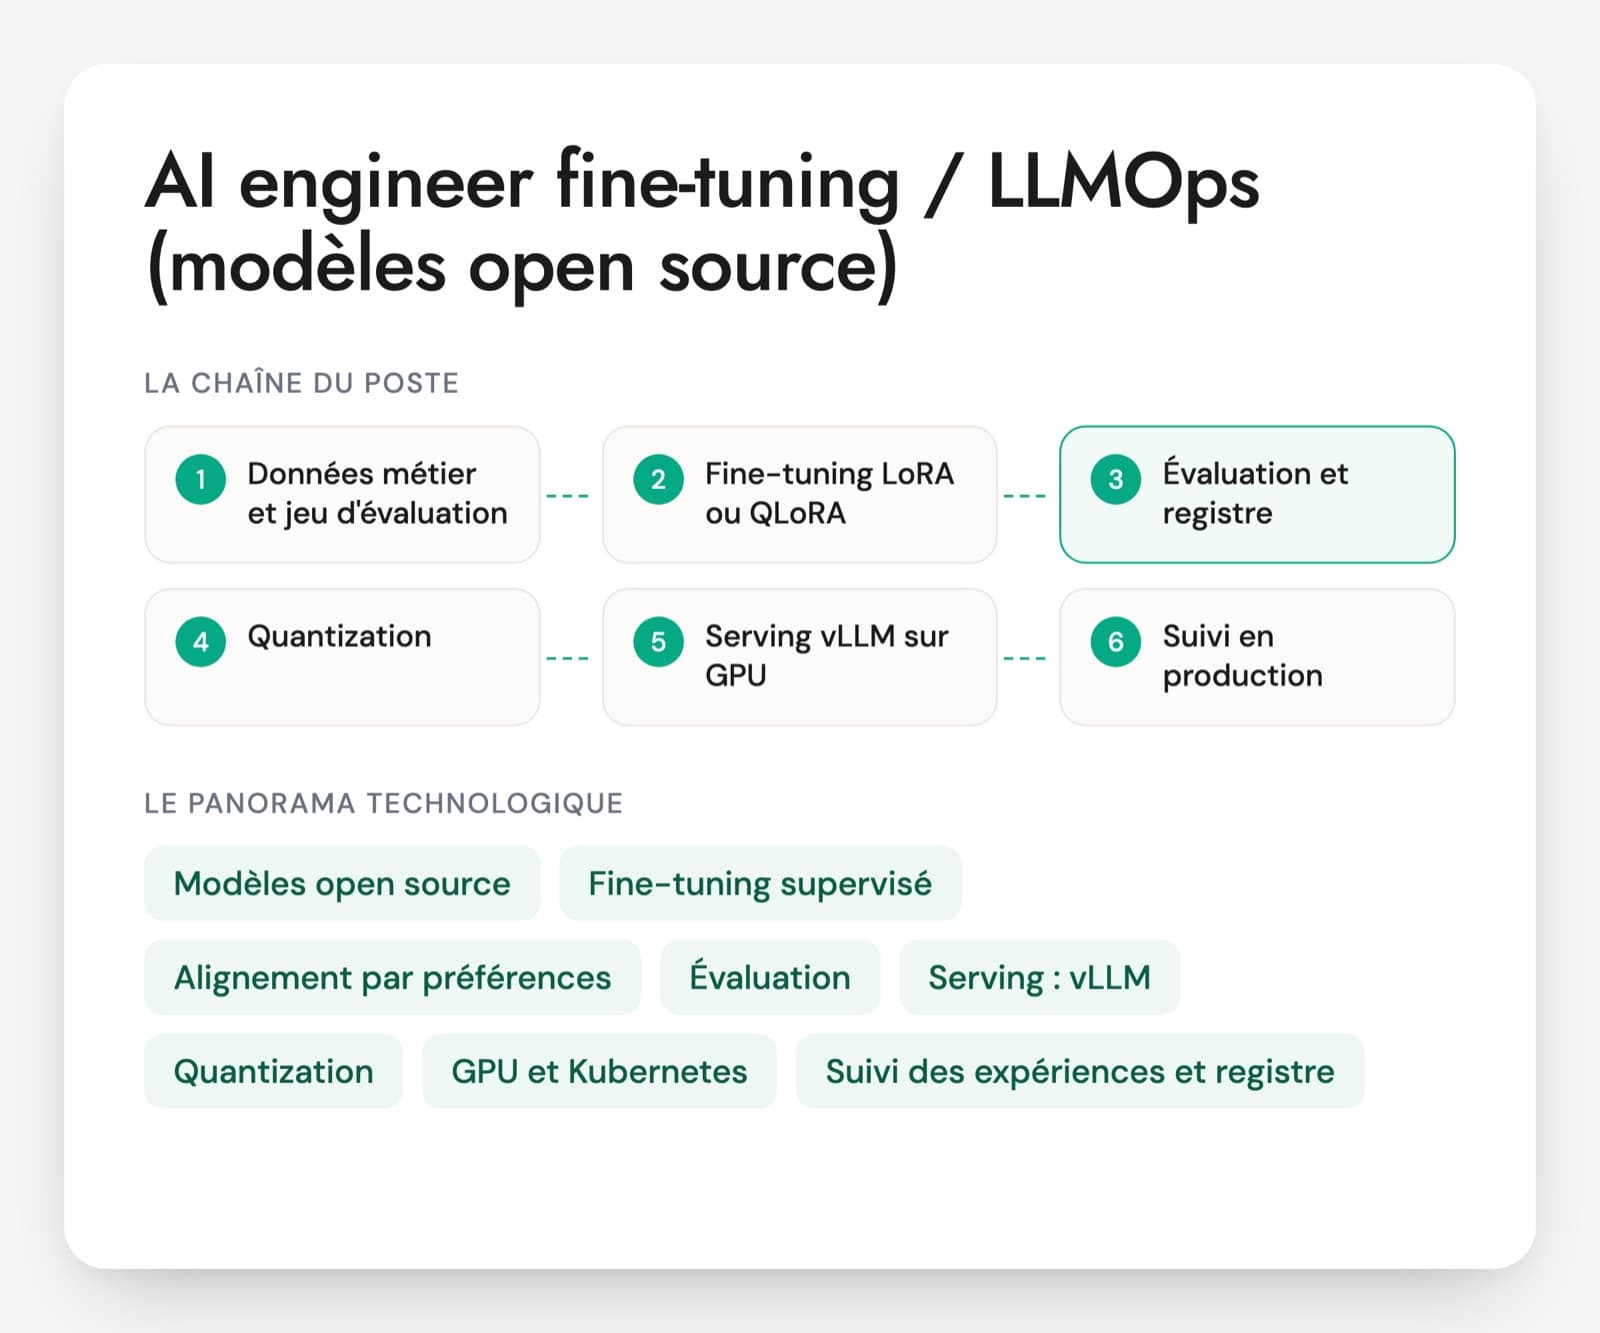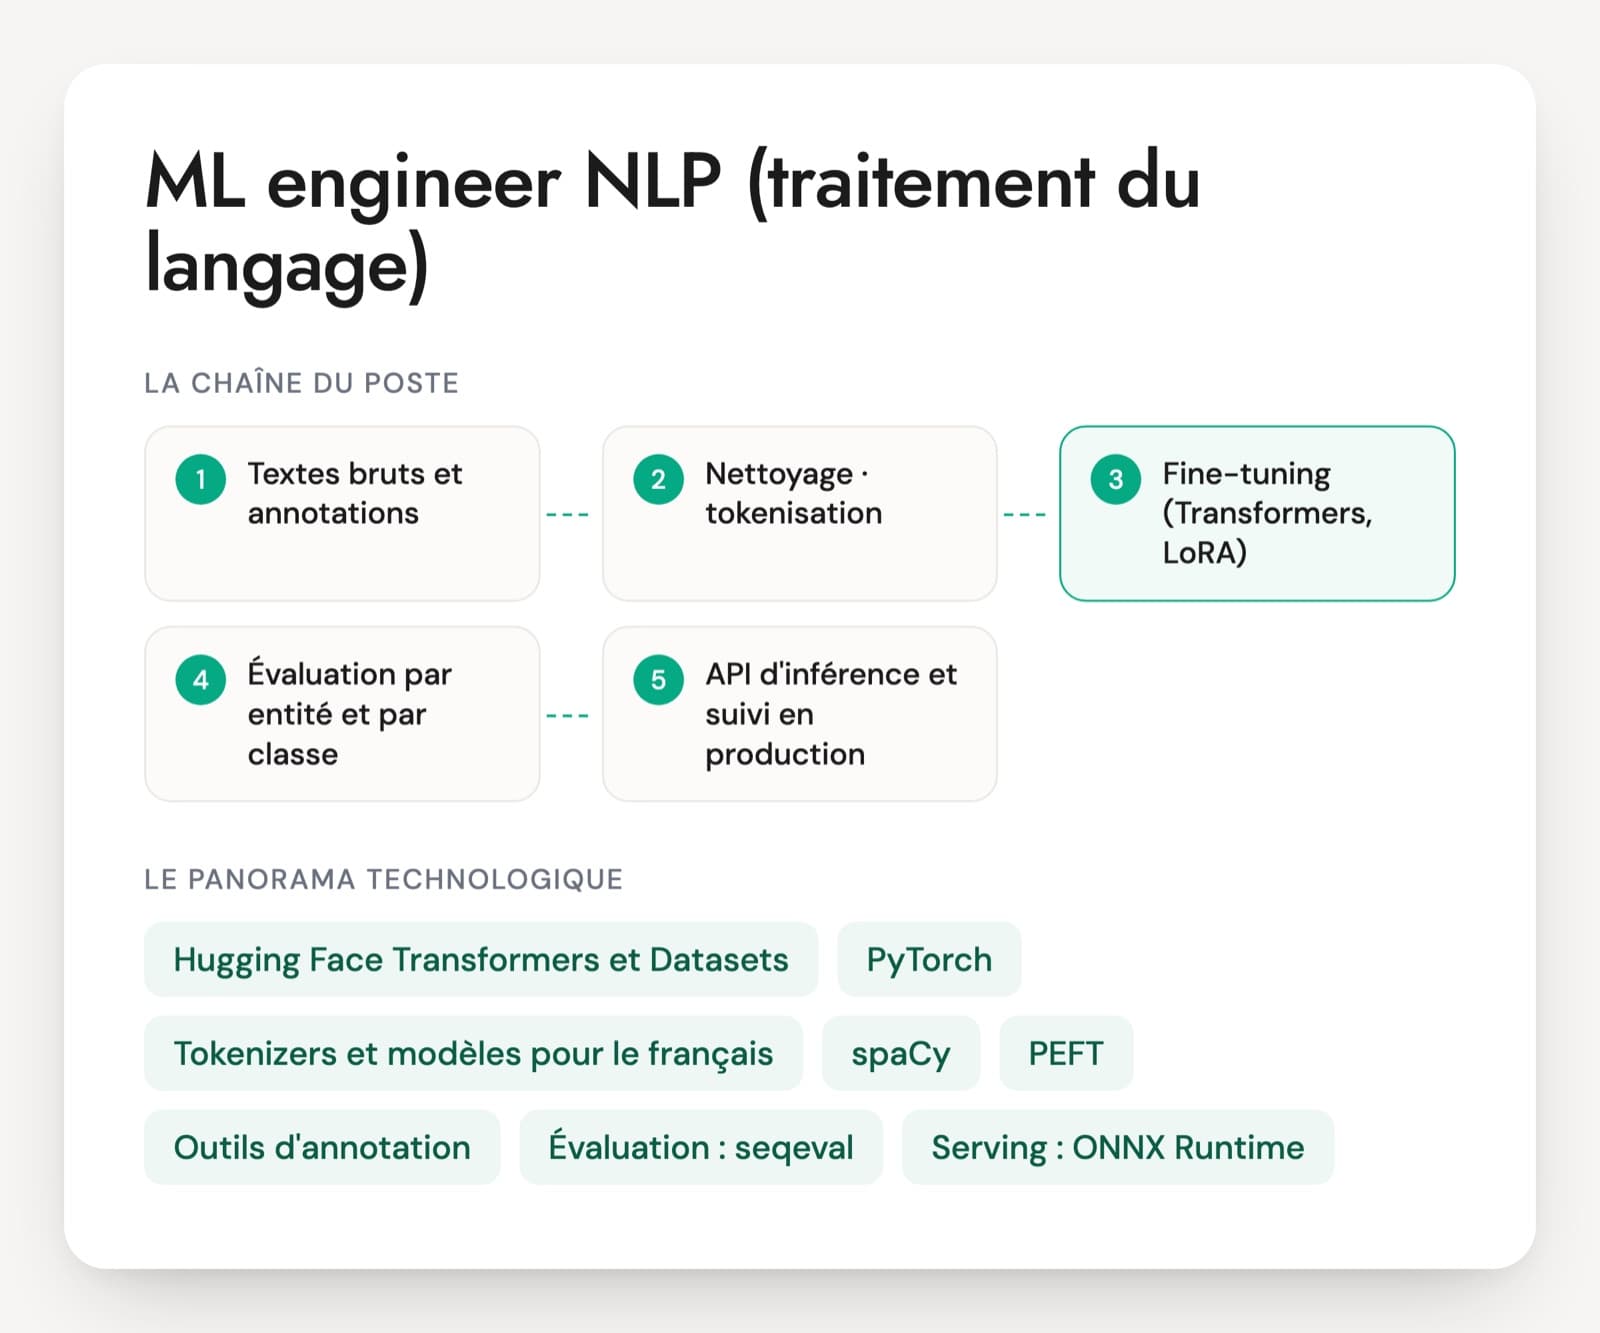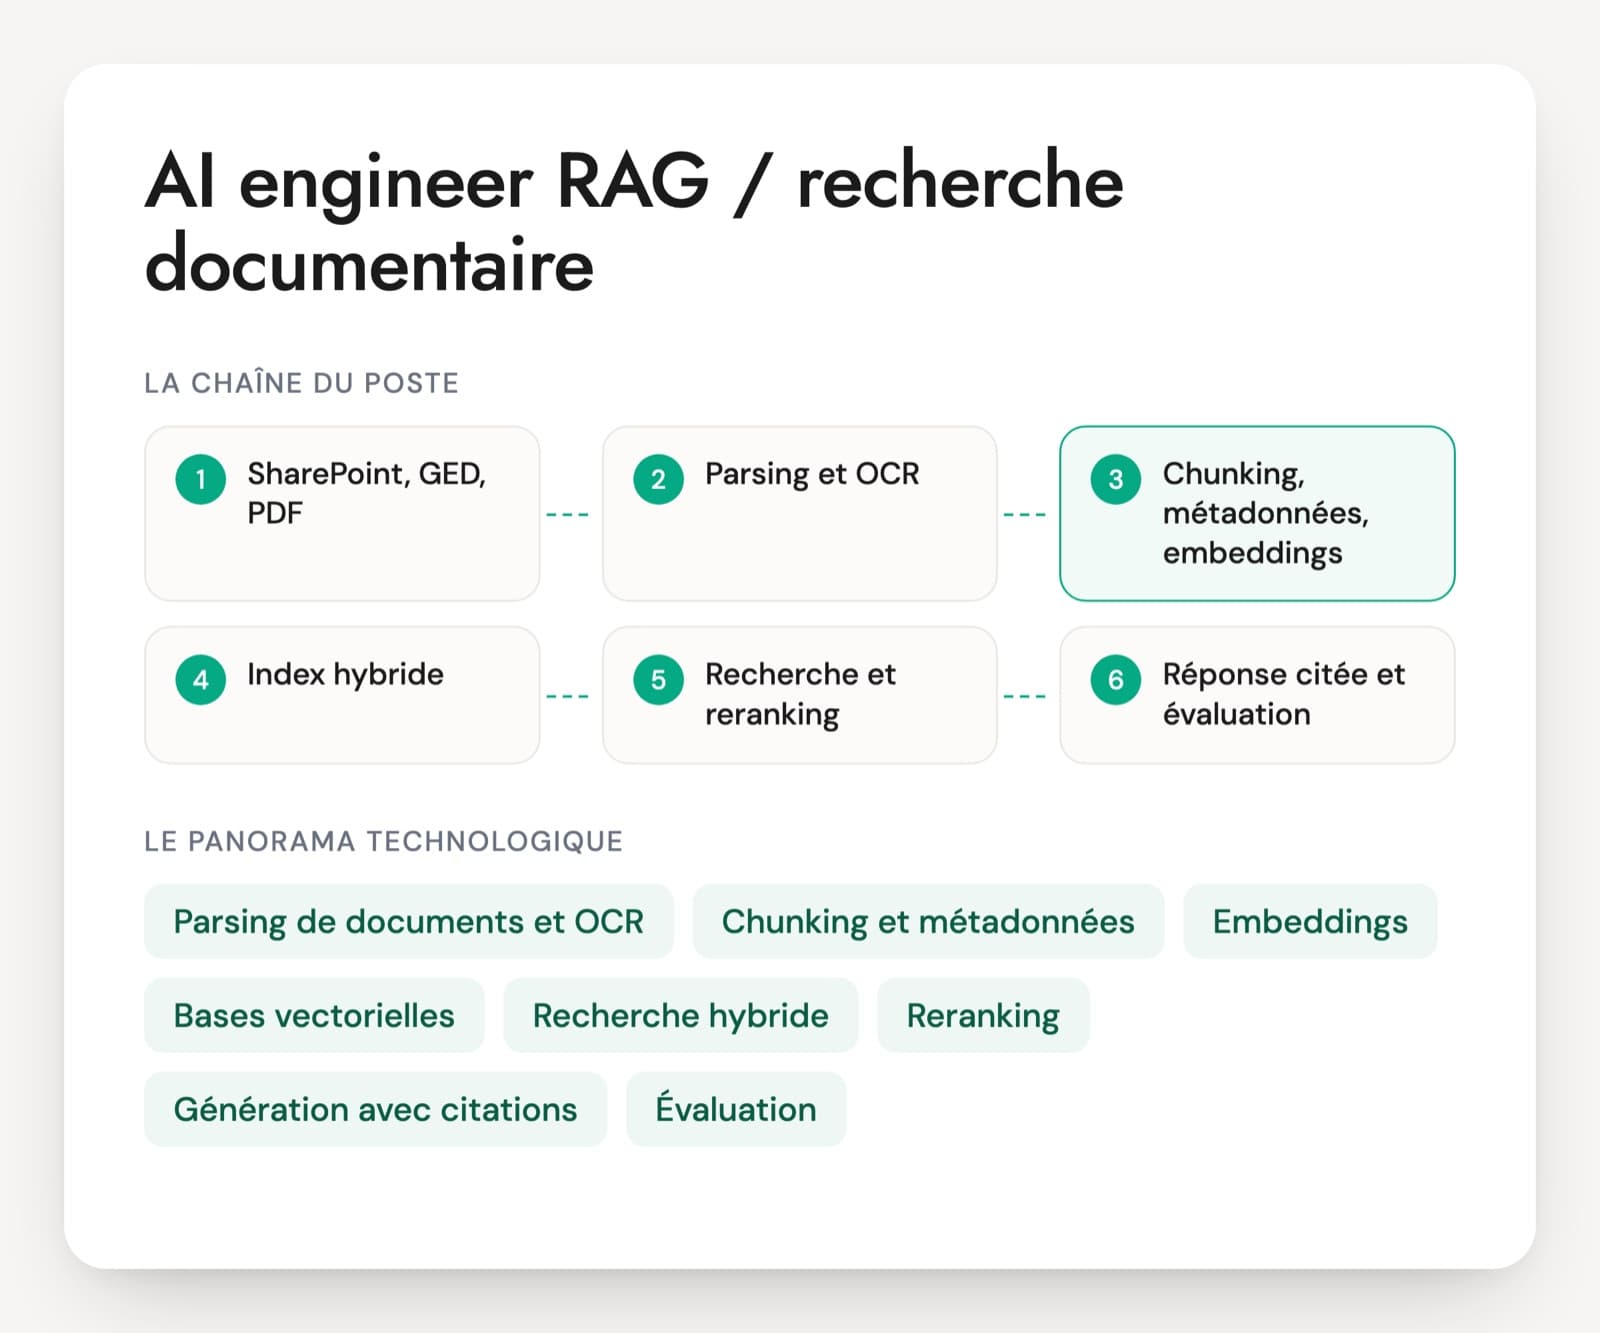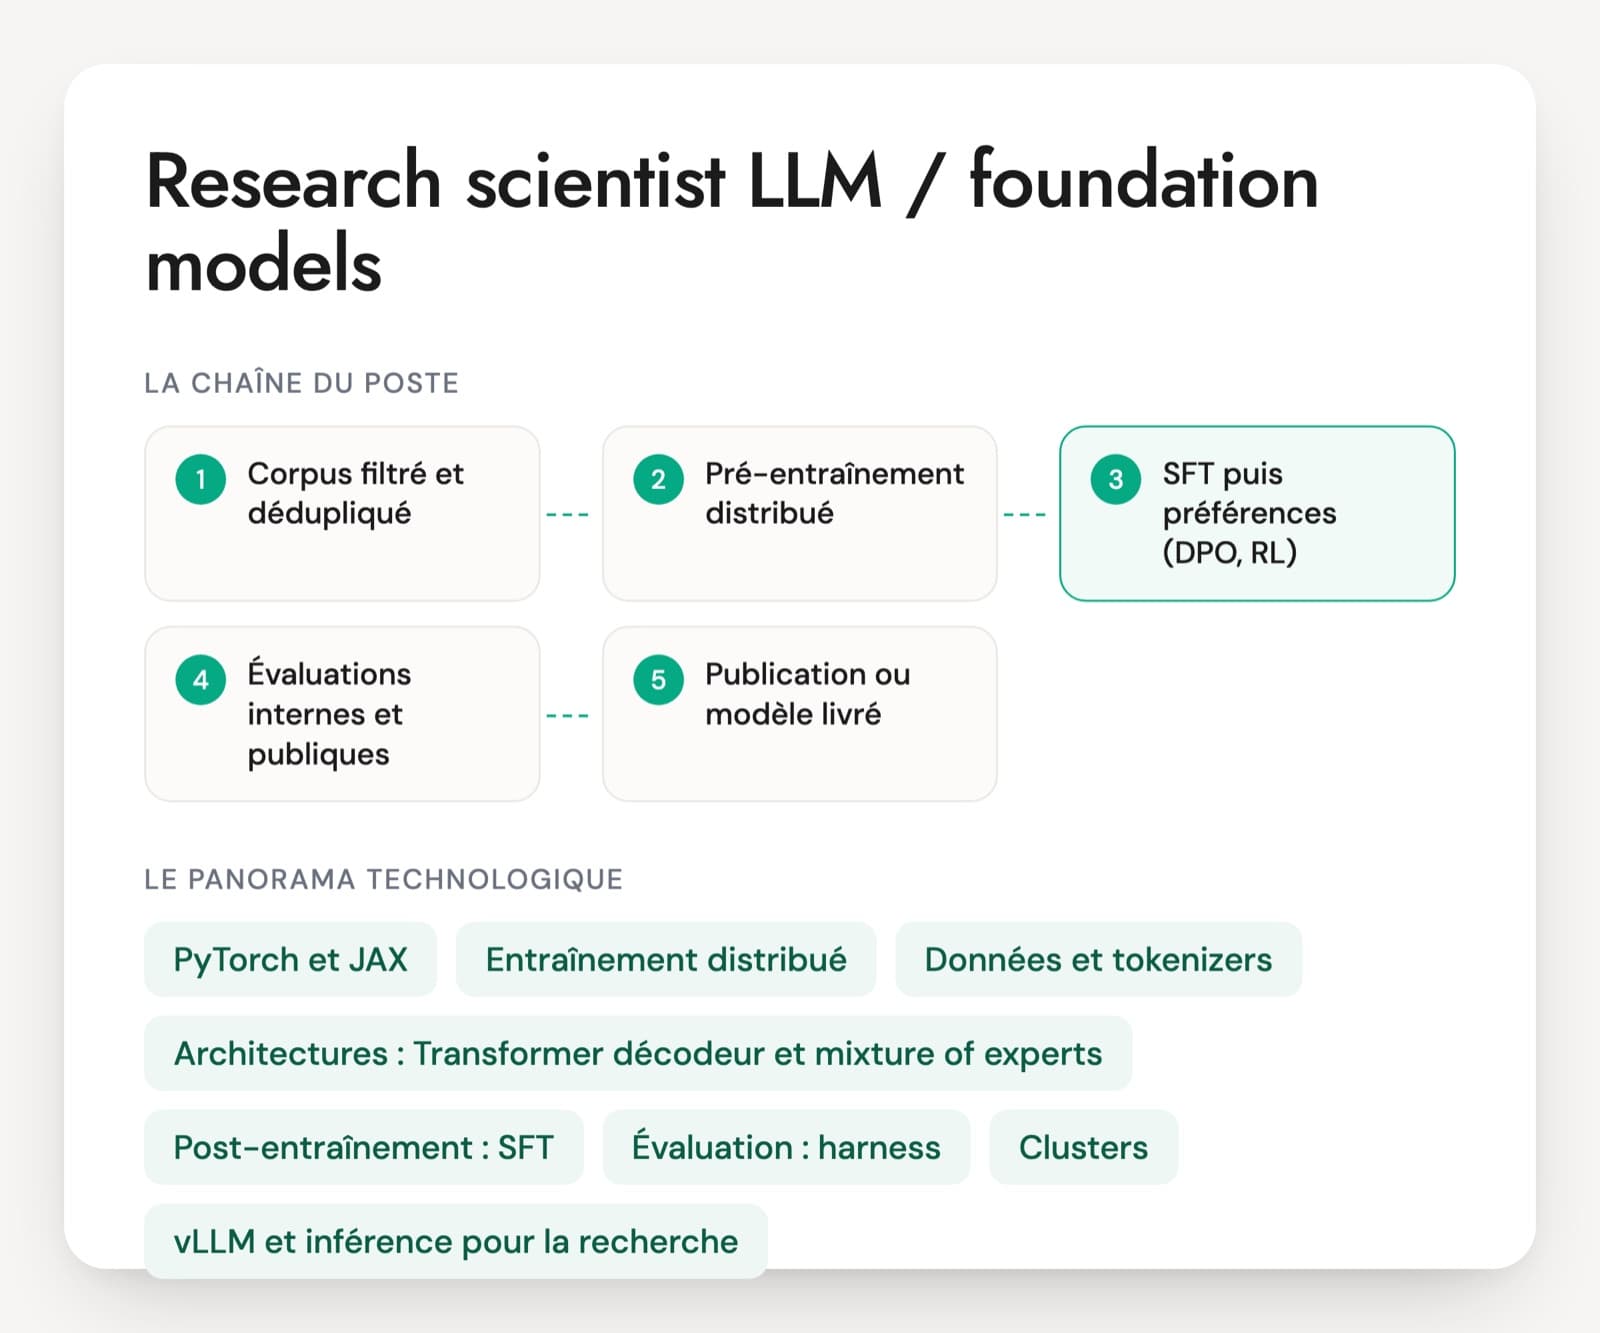
Les questions d'entretien d'un research scientist LLM partent d'un travail concret. La personne fixe la taille d'un modèle à partir de lois d'échelle, prépare des milliers de milliards de tokens, lance et surveille des entraînements distribués, puis aligne le modèle par SFT, DPO ou renforcement et mesure ce qu'il vaut vraiment. En France, ces postes s'ouvrent surtout dans les laboratoires parisiens (Mistral AI, Kyutai, H Company, FAIR chez Meta) et dans les équipes de recherche de grands éditeurs, sous des intitulés variés (research engineer, AI scientist, member of technical staff).
La difficulté tient au CV. Une thèse et des publications à NeurIPS, ICML ou ACL montrent une capacité de recherche, pas forcément l'expérience d'un entraînement qui diverge à trois heures du matin sur 256 GPU. À l'inverse, un ingénieur sans publication peut avoir tenu des pré-entraînements entiers. Les réponses sur le budget de calcul, la mémoire, les pics de loss ou les scores contaminés font la différence.
Sans chercheur dans votre jury, commencez par la question sur MMLU et celle sur la divergence, plus faciles à juger avec la réponse attendue sous les yeux. Le PDF complète l'entretien avec 30 questions sur six axes, un cas de 20 minutes sur un modèle de 3 milliards de paramètres pour le français et le code, et une grille de 1 à 4.
L'outillage d'un laboratoire de modèles de fondation
PyTorch et JAX
Les deux cadres de calcul de la recherche sur les LLM. PyTorch domine dans la plupart des laboratoires, JAX reste présent dans les équipes issues de Google. Un chercheur doit savoir écrire un bloc de Transformer à la main et lire un profil d'exécution, pas seulement appeler une bibliothèque.
Entraînement distribué (FSDP, DeepSpeed, Megatron-LM, TorchTitan)
Les outils qui répartissent un modèle et son entraînement sur des dizaines ou des centaines de GPU : partitionnement des poids, parallélisme de tenseurs, de pipeline et de séquence. C'est là que se jouent le coût et la durée d'un pré-entraînement. Demandez quel était le taux d'utilisation des GPU sur le dernier run de la personne.
Données et tokenizers
Le corpus de pré-entraînement vient surtout du web (Common Crawl), complété par du code, des mathématiques et des livres. Il faut l'extraire, le dédupliquer, le filtrer et le décontaminer, puis entraîner un tokenizer (BPE, SentencePiece). Les ablations sur les filtres de données occupent une bonne part du travail d'une équipe de pré-entraînement.
Architectures : Transformer décodeur et mixture of experts
La base reste le Transformer décodeur, avec des choix de détail qui comptent (encodage de position RoPE, normalisation, variantes d'attention). Les modèles mixture of experts n'activent qu'une partie de leurs paramètres pour chaque token. Ils changent la mémoire, la communication entre GPU et la stabilité de l'entraînement.
Post-entraînement : SFT, RLHF, DPO, GRPO
Après le pré-entraînement viennent l'ajustement sur des instructions (SFT), puis l'alignement sur des préférences humaines (RLHF avec PPO, ou DPO) et le renforcement sur des tâches vérifiables (GRPO et ses variantes) pour le raisonnement. Des bibliothèques comme TRL, OpenRLHF ou verl les implémentent.
Évaluation : harness, benchmarks, LLM juge
Des outils comme lm-evaluation-harness lancent des centaines de benchmarks (MMLU, GSM8K, HumanEval et bien d'autres). Les scores dépendent du format du prompt et peuvent être gonflés par la contamination. Un LLM juge sert à comparer des réponses ouvertes, avec ses propres biais.
Clusters, Slurm et suivi d'expériences
Les entraînements tournent sur des clusters GPU ordonnancés par Slurm ou Kubernetes, et chaque run est suivi dans un outil comme Weights & Biases. Checkpoints, relances automatiques et nœuds défaillants font partie du quotidien. Vérifiez que la personne a déjà géré un run de plusieurs jours.
vLLM et inférence pour la recherche
Générer des milliers de réponses pour l'évaluation ou le renforcement demande un moteur d'inférence rapide comme vLLM ou SGLang. En RL, la génération prend souvent la plus grande part du temps de calcul, et sa maîtrise distingue les profils qui ont mené ces entraînements.
Le poste change selon l'endroit. Dans un laboratoire qui entraîne ses propres modèles, la personne travaille sur une partie de la chaîne (données, pré-entraînement, post-entraînement, évaluation) avec une forte exigence d'ingénierie. Dans une équipe de recherche appliquée, elle adapte des modèles ouverts à un domaine et publie moins. Les laboratoires académiques et les équipes comme FAIR attendent des publications régulières. Le niveau d'anglais écrit compte partout, les papiers et la documentation interne étant rédigés en anglais. Une thèse reste fréquente sans être obligatoire, et l'entretien sert surtout à vérifier la pratique des expériences à grande échelle.
Les compétences à vérifier chez un research scientist LLM
- Pré-entraînement et lois d'échelle
- Entraînement distribué multi-GPU
- Données et tokenisation
- Alignement : SFT, RLHF, DPO
- Évaluation et contamination
- Rigueur expérimentale et lecture critique
Cinq questions sur les runs d'un chercheur en LLM
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · senior
Votre budget de calcul est fixé. Comment décidez-vous de la taille du modèle et du nombre de tokens d'entraînement ?
Une bonne réponseIl part des lois d'échelle : des petits entraînements à budgets croissants, une courbe de loss en fonction du calcul, puis une extrapolation (approche isoFLOP). Il cite le résultat de Chinchilla (Hoffmann et al., 2022), de l'ordre de vingt tokens par paramètre à l'optimum de calcul, et l'approximation du coût en 6 × paramètres × tokens. Il ajoute que le coût d'inférence pousse souvent à entraîner un modèle plus petit bien au-delà de ce point, et que la quantité de données de qualité disponible limite le nombre de passes.
Signal d'alerte« Le plus gros modèle qui tient sur le cluster », ou Chinchilla présenté comme une règle fixe, sans lien avec l'usage prévu du modèle.
Question 2 · senior
Au milieu d'un pré-entraînement, la loss fait des pics, puis diverge. Que faites-vous ?
Une bonne réponseIl revient au dernier checkpoint sain, saute ou inspecte les batches au moment du pic, baisse le learning rate et vérifie le clipping des gradients. Il cherche les causes connues : croissance des logits d'attention (QK-norm, z-loss), epsilon d'Adam, problèmes de précision en bf16, données aberrantes. Il suit en continu la norme des gradients et les activations par couche.
Signal d'alerteRelancer depuis zéro avec une autre graine, sans diagnostic.
Question 3 · confirmé
Comment construisez-vous un corpus de pré-entraînement à partir de Common Crawl ?
Une bonne réponseExtraction du texte depuis le HTML, identification de la langue, déduplication exacte et approximative (MinHash), filtres heuristiques puis classifieurs de qualité, retrait des données personnelles et des contenus toxiques, décontamination par rapport aux benchmarks. Chaque filtre est validé par une ablation sur un petit modèle. Il mentionne les opt-out des ayants droit et le résumé des données d'entraînement que l'AI Act demande aux fournisseurs de modèles d'IA à usage général.
Signal d'alerte« On prend tout le crawl », sans déduplication ni mesure de l'effet des filtres.
Question 4 · senior
DPO ou RLHF avec PPO : comment choisissez-vous la méthode pour aligner un modèle sur des préférences ?
Une bonne réponsePPO demande un modèle de récompense, un modèle de valeur et un échantillonnage en ligne : c'est coûteux et instable, mais le modèle explore ses propres réponses. DPO apprend directement sur des paires de préférences hors ligne, avec un modèle de référence et un paramètre β, plus simple mais sans exploration et sujet au surapprentissage. Il cite les variantes en ligne ou itératives et, pour les tâches vérifiables (maths, code), le RL avec récompenses vérifiables comme GRPO. Le choix dépend des données, du calcul et de l'objectif.
Signal d'alerte« DPO a remplacé RLHF », sans nuance, ou une confusion entre SFT et DPO.
Question 5 · confirmé
Votre nouveau modèle gagne trois points sur MMLU. Qu'est-ce qui vous fait douter de ce résultat ?
Une bonne réponseLa variance due au format du prompt, au nombre d'exemples et à la graine, une contamination possible, la saturation du benchmark, des écarts entre outils d'évaluation (log-vraisemblance ou génération). Il veut un intervalle de confiance, le même outil d'évaluation pour les deux modèles et des tâches plus proches de l'usage visé, ou une version plus difficile comme MMLU-Pro.
Signal d'alerteAnnoncer le gain sans intervalle ni vérification de fuite.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Ce que se demandent les recruteurs d'un research scientist LLM
Un ingénieur sans thèse peut-il tenir un poste de chercheur en LLM ?
Oui, surtout sur les postes de research engineer, où l'ingénierie de l'entraînement et des données pèse autant que les idées. Les laboratoires recrutent des profils sans doctorat qui ont mené des entraînements distribués, construit des pipelines de données ou contribué à des projets open source reconnus. Demandez ce que la personne a lancé elle-même, à quelle échelle, et ce qu'elle a appris des échecs. Une thèse aide surtout pour définir un programme de recherche en autonomie.
Research scientist ou research engineer : quel intitulé publier ?
Le research scientist propose les pistes, conçoit les expériences et publie. Le research engineer rend ces expériences possibles à grande échelle : code d'entraînement, données, performance des GPU, évaluation. Dans les laboratoires de LLM, la frontière est floue et beaucoup d'équipes utilisent un intitulé unique, comme member of technical staff. Choisissez selon le besoin principal de l'équipe, et décrivez dans l'offre la part de recherche et la part d'ingénierie attendues.
Quel exercice proposer à un chercheur LLM pendant le processus ?
Un test technique en deux temps fonctionne bien. D'abord du code en direct : une attention causale, une boucle d'entraînement ou un calcul de mémoire à mener sans aide. Ensuite une discussion sur un papier récent choisi par le jury, où la personne critique les baselines et propose une expérience pour vérifier le résultat. Un projet à rendre sur plusieurs jours pèse lourd pour une personne déjà en poste ou engagée dans d'autres processus.
Les publications à NeurIPS ou ICML suffisent-elles pour juger un candidat ?
Elles prouvent qu'un travail a passé une relecture par les pairs, sans dire quelle part revient à la personne ni à quelle échelle elle a travaillé. Sur un papier à dix auteurs, demandez sa contribution précise. Regardez aussi le code publié, les modèles ou jeux de données mis en ligne et les rapports techniques. Pour un poste centré sur l'entraînement, faites raconter un run mené de bout en bout.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.