Un administrateur systèmes Linux passe ses journées sur des serveurs que d'autres utilisent : une base de données, un serveur web, un cluster applicatif. Les questions d'entretien d'un ingénieur systèmes Linux doivent donc partir de pannes concrètes. Un serveur qui ne redémarre plus, un /var plein, un refus SELinux, une charge qui explose. Sur la plupart des postes, le parc est en RHEL ou en Rocky Linux, parfois en Debian ou en Ubuntu, sur VMware ou sur du matériel physique.
Les CV listent souvent les mêmes mots : Ansible, Bash, SELinux, LVM. La différence se voit dans le détail. Un profil expérimenté sait qu'un load de 40 peut venir des disques et non du processeur, qu'un fichier supprimé reste parfois ouvert, qu'on ne désactive pas SELinux pour régler un problème de droits. Les profils qui n'ont connu que des conteneurs appellent la prudence : ils manquent souvent de pratique sur le démarrage, le multipath ou un cluster Pacemaker.
Le calendrier Red Hat compte aussi. CentOS Linux 7 n'a plus de correctifs depuis le 30 juin 2024 et RHEL 10 est sorti en mai 2025, donc beaucoup d'équipes migrent. La montée de version menée par la personne, et l'outil utilisé, comptent. Le PDF reprend l'entretien complet sur six axes.
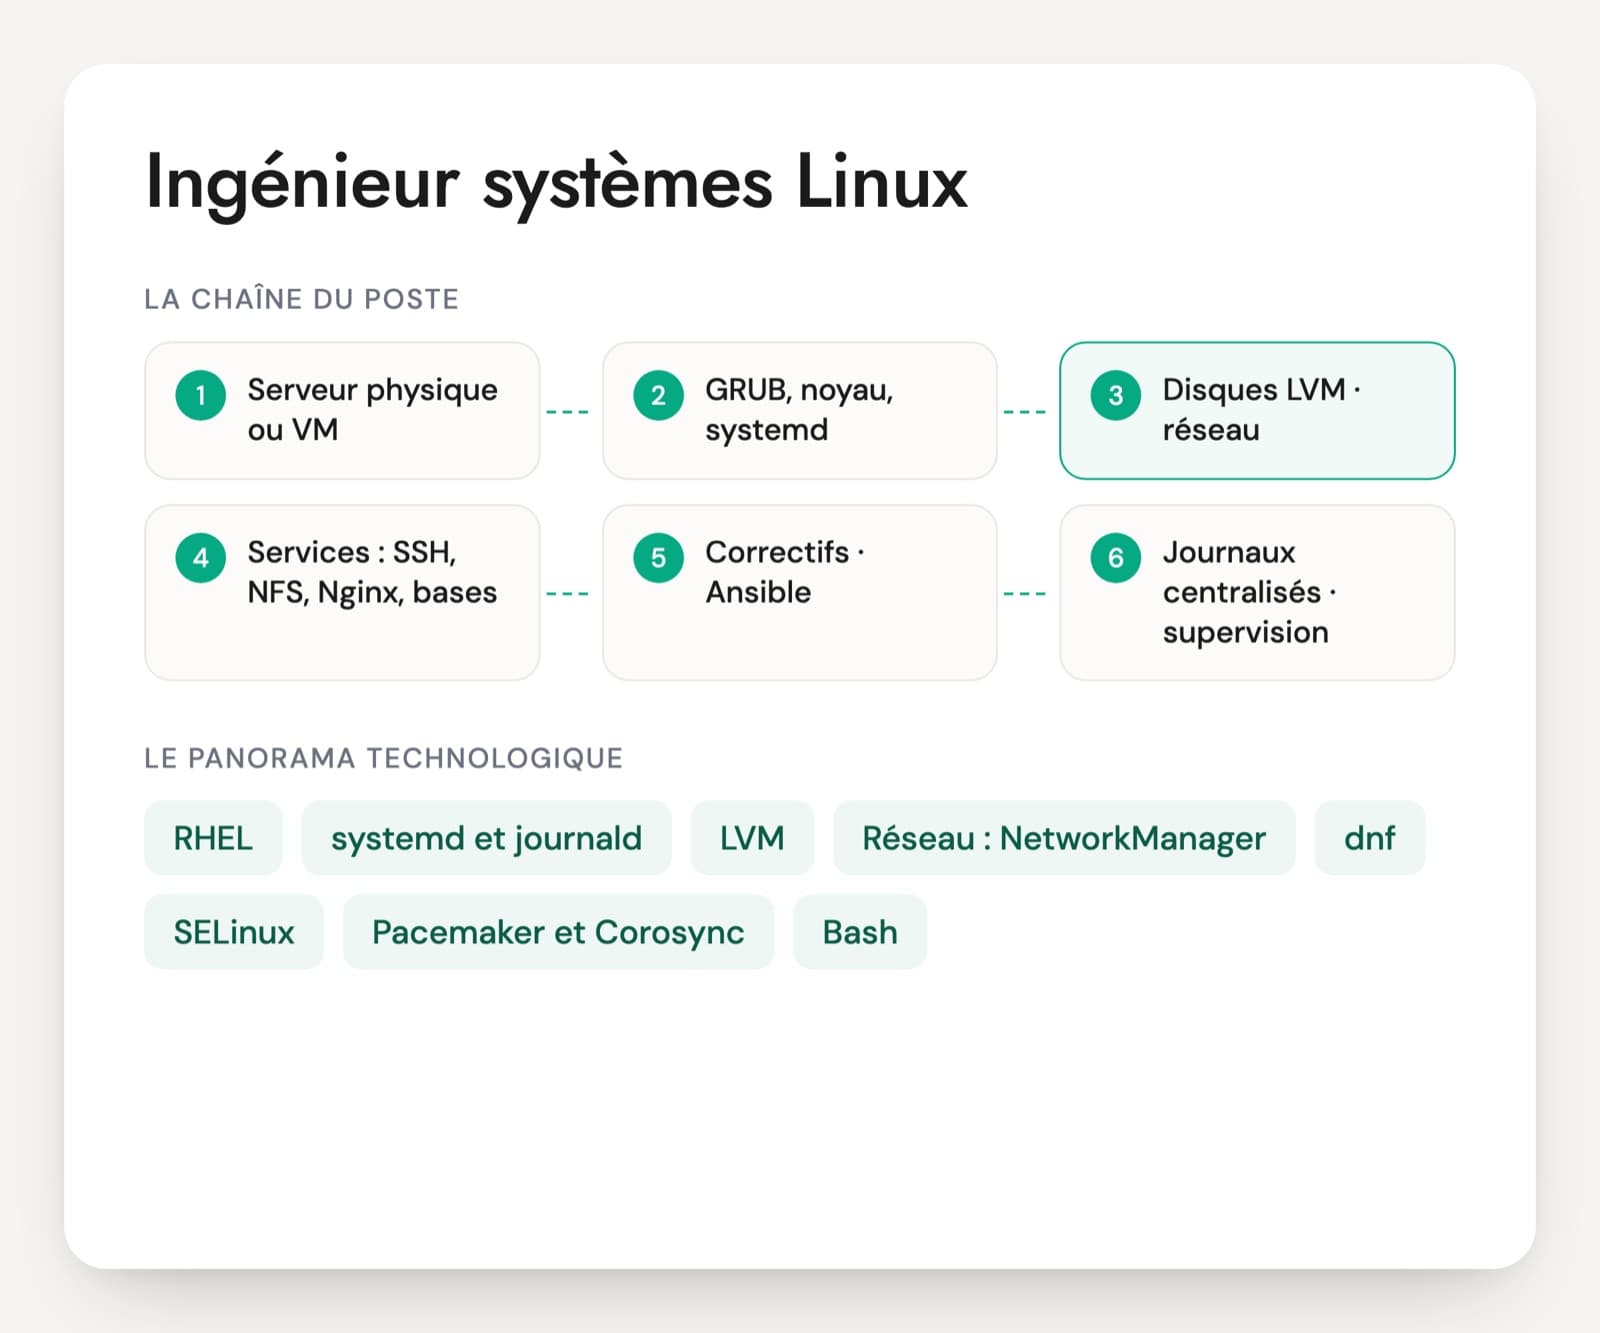
Le socle technique d'un administrateur Linux en production
RHEL, Rocky Linux, Debian, Ubuntu
Les distributions du poste. Red Hat Enterprise Linux domine en entreprise, avec Rocky Linux et AlmaLinux comme équivalents gratuits. Debian et Ubuntu sont fréquents sur les plateformes web. RHEL 9 et RHEL 10 sont les versions en cours, RHEL 8 reste maintenue jusqu'en mai 2029. Reste à savoir sur quelles versions la personne a réellement travaillé.
systemd et journald
Le gestionnaire de démarrage et de services de toutes les distributions actuelles. Il lance les services dans l'ordre, les relance en cas d'arrêt et centralise les journaux avec journald. Un profil solide sait écrire une unité de service et lire un démarrage raté avec journalctl.
LVM, XFS, ext4 et multipath
La gestion des disques. LVM permet d'agrandir un volume sans arrêt, XFS est le système de fichiers par défaut de RHEL, ext4 celui de Debian. Sur les serveurs reliés à une baie SAN, multipath gère les différents chemins vers un même disque. Les questions de disque plein arrivent tôt dans la vie d'un administrateur.
Réseau : NetworkManager, bonding, nftables
La configuration des interfaces se fait avec nmcli sur RHEL, où les anciens fichiers ifcfg sont dépréciés depuis la version 9. Le bonding agrège deux cartes pour la redondance. Le filtrage passe par firewalld ou directement par nftables, qui remplace iptables.
dnf, apt et Red Hat Satellite
Les gestionnaires de paquets et l'outil de Red Hat pour distribuer les correctifs à un parc. Satellite fige un lot de paquets testé avant de le pousser en production. Les postes à plusieurs centaines de serveurs le demandent souvent.
SELinux, CIS et OpenSCAP
SELinux restreint ce que chaque service peut faire, même lancé en root. Les référentiels CIS et les recommandations de l'ANSSI fixent les règles de durcissement, qu'OpenSCAP contrôle automatiquement. Un candidat qui désactive SELinux par habitude pose un problème de sécurité.
Pacemaker et Corosync
Le couple qui assure la haute disponibilité sous Linux : Corosync fait communiquer les nœuds, Pacemaker décide où tournent les ressources (adresse IP, système de fichiers, base). On le croise sur les bases de données et les serveurs NFS critiques.
Bash, Python et Ansible
Les outils d'automatisation au quotidien. Bash pour les scripts d'exploitation, Python pour ce qui dépasse quelques dizaines de lignes, Ansible pour appliquer la même configuration à tout un parc. Pour ce poste, un usage solide d'Ansible suffit, sans attendre le niveau d'un spécialiste.
Le titre varie d'une offre à l'autre : administrateur Linux, ingénieur Unix/Linux, expert Linux Red Hat. Les postes de niveau 2 ou 3 attendent la résolution des incidents transmis par le support, les correctifs et les changements planifiés. Les postes d'expert ajoutent le durcissement, la haute disponibilité et la conception des modèles de serveurs. Les certifications Red Hat reposent sur des examens pratiques, ce qui leur donne du poids : la RHCSA pour l'administration, la RHCE pour le niveau ingénieur, désormais déclinée par domaine (Ansible ou Enterprise Linux). Elles ne remplacent pas un incident de production raconté avec sa cause.
Les six compétences Linux évaluées en entretien
- Démarrage, systemd et journaux
- Stockage LVM, XFS et multipath
- Réseau et pare-feu Linux
- SELinux et durcissement
- Diagnostic de performance
- Correctifs, automatisation et haute disponibilité
Les pannes Linux à diagnostiquer en entretien
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Après un correctif, un serveur RHEL redémarre en mode emergency et ne va pas plus loin. Que faites-vous ?
Une bonne réponseIl prend la main par la console (iLO, iDRAC, console de l'hyperviseur), lit journalctl -xb et systemctl --failed. La cause la plus fréquente est un montage de /etc/fstab qui échoue : disque absent, UUID changé, partage NFS injoignable. Il corrige la ligne, ajoute nofail ou _netdev quand le montage n'est pas indispensable au démarrage. Si c'est le nouveau noyau qui pose problème, il démarre sur le précédent depuis GRUB et le garde par défaut le temps d'analyser.
Signal d'alerte« Je réinstalle le serveur », ou aucune idée de la façon d'accéder à une console quand SSH ne répond plus.
Question 2 · junior à confirmé
Le /var d'un serveur de production est plein à 100 %. Comment libérez-vous de la place sans casser les applications ?
Une bonne réponseIl cherche d'abord ce qui grossit, avec du ou ncdu limité au système de fichiers (-x). Il vide les journaux proprement : journalctl --vacuum-size, logrotate, troncature d'un fichier ouvert plutôt que suppression. Il vérifie les fichiers supprimés mais encore ouverts par un processus avec lsof +L1. Si le groupe de volumes a de l'espace libre, lvextend -r agrandit le volume et le système de fichiers à chaud. Il sait qu'un XFS ne se réduit pas.
Signal d'alerteUn rm -rf sur /var/log au hasard, ou supprimer le journal d'une application en cours d'exécution puis s'étonner que df n'ait pas bougé.
Question 3 · confirmé
Une application renvoie « permission denied » alors que les droits Unix sont corrects, et SELinux est en mode enforcing. Comment procédez-vous ?
Une bonne réponseIl lit les refus dans le journal d'audit (ausearch -m AVC, ou sealert s'il est installé) et compare le contexte du fichier avec ls -Z. Un fichier déplacé avec mv garde son ancien contexte : restorecon le corrige. Pour un répertoire non standard, semanage fcontext puis restorecon. Pour un comportement autorisé par un booléen (httpd_can_network_connect, par exemple), setsebool -P. Pour un port inhabituel, semanage port. Un module audit2allow vient en dernier, relu ligne par ligne.
Signal d'alertesetenforce 0, puis SELINUX=disabled dans la configuration « pour que ça marche ».
Question 4 · confirmé
Le load average d'un serveur de 8 cœurs monte à 40 et les utilisateurs se plaignent de lenteurs. Que regardez-vous, et dans quel ordre ?
Une bonne réponseIl sait que le load compte aussi les processus en attente d'entrée-sortie (état D), donc un load élevé ne veut pas dire CPU saturé. vmstat 1 pour la file d'exécution (r), les processus bloqués (b), le wa et le swap (si, so). iostat -x pour await et %util par disque, top ou pidstat pour les processus en cause. Il regarde la mémoire et les traces de l'OOM killer dans le journal du noyau. Un partage NFS qui ne répond plus crée aussi des processus en état D.
Signal d'alerte« On ajoute des CPU », ou tuer le processus qui consomme le plus sans avoir identifié la ressource saturée.
Question 5 · confirmé à senior
Vous devez appliquer chaque mois les correctifs de sécurité sur 300 serveurs RHEL. Comment l'organisez-vous ?
Une bonne réponseUn dépôt maîtrisé, par exemple Red Hat Satellite avec des content views et des environnements de cycle de vie, pour que la production reçoive exactement le lot testé en recette. Des vagues successives (développement, recette, production), orchestrées par Ansible, avec redémarrage seulement quand c'est nécessaire (needs-restarting -r). Un retour arrière prévu : ancien noyau dans GRUB, dnf history undo, snapshot de VM. Un rapport de conformité qui montre les serveurs en retard.
Signal d'alertednf update -y en cron sur tous les serveurs en même temps, ou aucun correctif tant que « ça marche ».
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Ingénieur Linux : les questions fréquentes
Administrateur Linux et ingénieur systèmes Linux, est-ce le même poste ?
Souvent oui, le titre dépend surtout de l'employeur. Quand une différence existe, l'administrateur traite davantage le run : incidents, comptes, correctifs, demandes courantes. L'ingénieur systèmes conçoit en plus les modèles de serveurs, automatise avec Ansible, gère la haute disponibilité et mène les migrations de version. Les missions comptent plus que le titre, et le niveau des questions suit le périmètre réel.
Les certifications RHCSA et RHCE suffisent-elles à juger un profil ?
Elles ont du poids parce que l'examen se passe sur une machine, sans questionnaire à choix multiples. La RHCSA couvre l'administration courante. La RHCE se décline désormais par domaine : en Ansible, avec l'examen EX294 de l'ancienne RHCE, ou en Enterprise Linux, avec l'EX342. Une certification Red Hat se renouvelle pour rester à jour : sa date et son intitulé exact comptent. Elle ne dit rien de l'expérience d'une panne en production : un incident réel, avec sa cause et sa correction, reste nécessaire.
Quel test technique est donné à un ingénieur systèmes Linux ?
Une machine virtuelle cassée à réparer en direct donne plus d'informations qu'un questionnaire. Par exemple un service qui ne démarre pas à cause d'un contexte SELinux, un système de fichiers plein ou une ligne fausse dans /etc/fstab. Trente minutes suffisent. La personne commente ce qu'elle tape : l'ordre des vérifications compte autant que la solution.
Red Hat est-il indispensable si le parc tourne sous Debian ou Ubuntu ?
Non. Le démarrage avec systemd, LVM, le réseau et le diagnostic de performance sont communs à toutes les distributions. Les écarts portent sur les paquets (apt contre dnf), sur la sécurité (AppArmor sur Ubuntu, SELinux sur Red Hat) et sur les outils de gestion de parc. Un bon profil Red Hat s'adapte vite à Debian, l'inverse aussi. La méthode de diagnostic compte davantage.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.