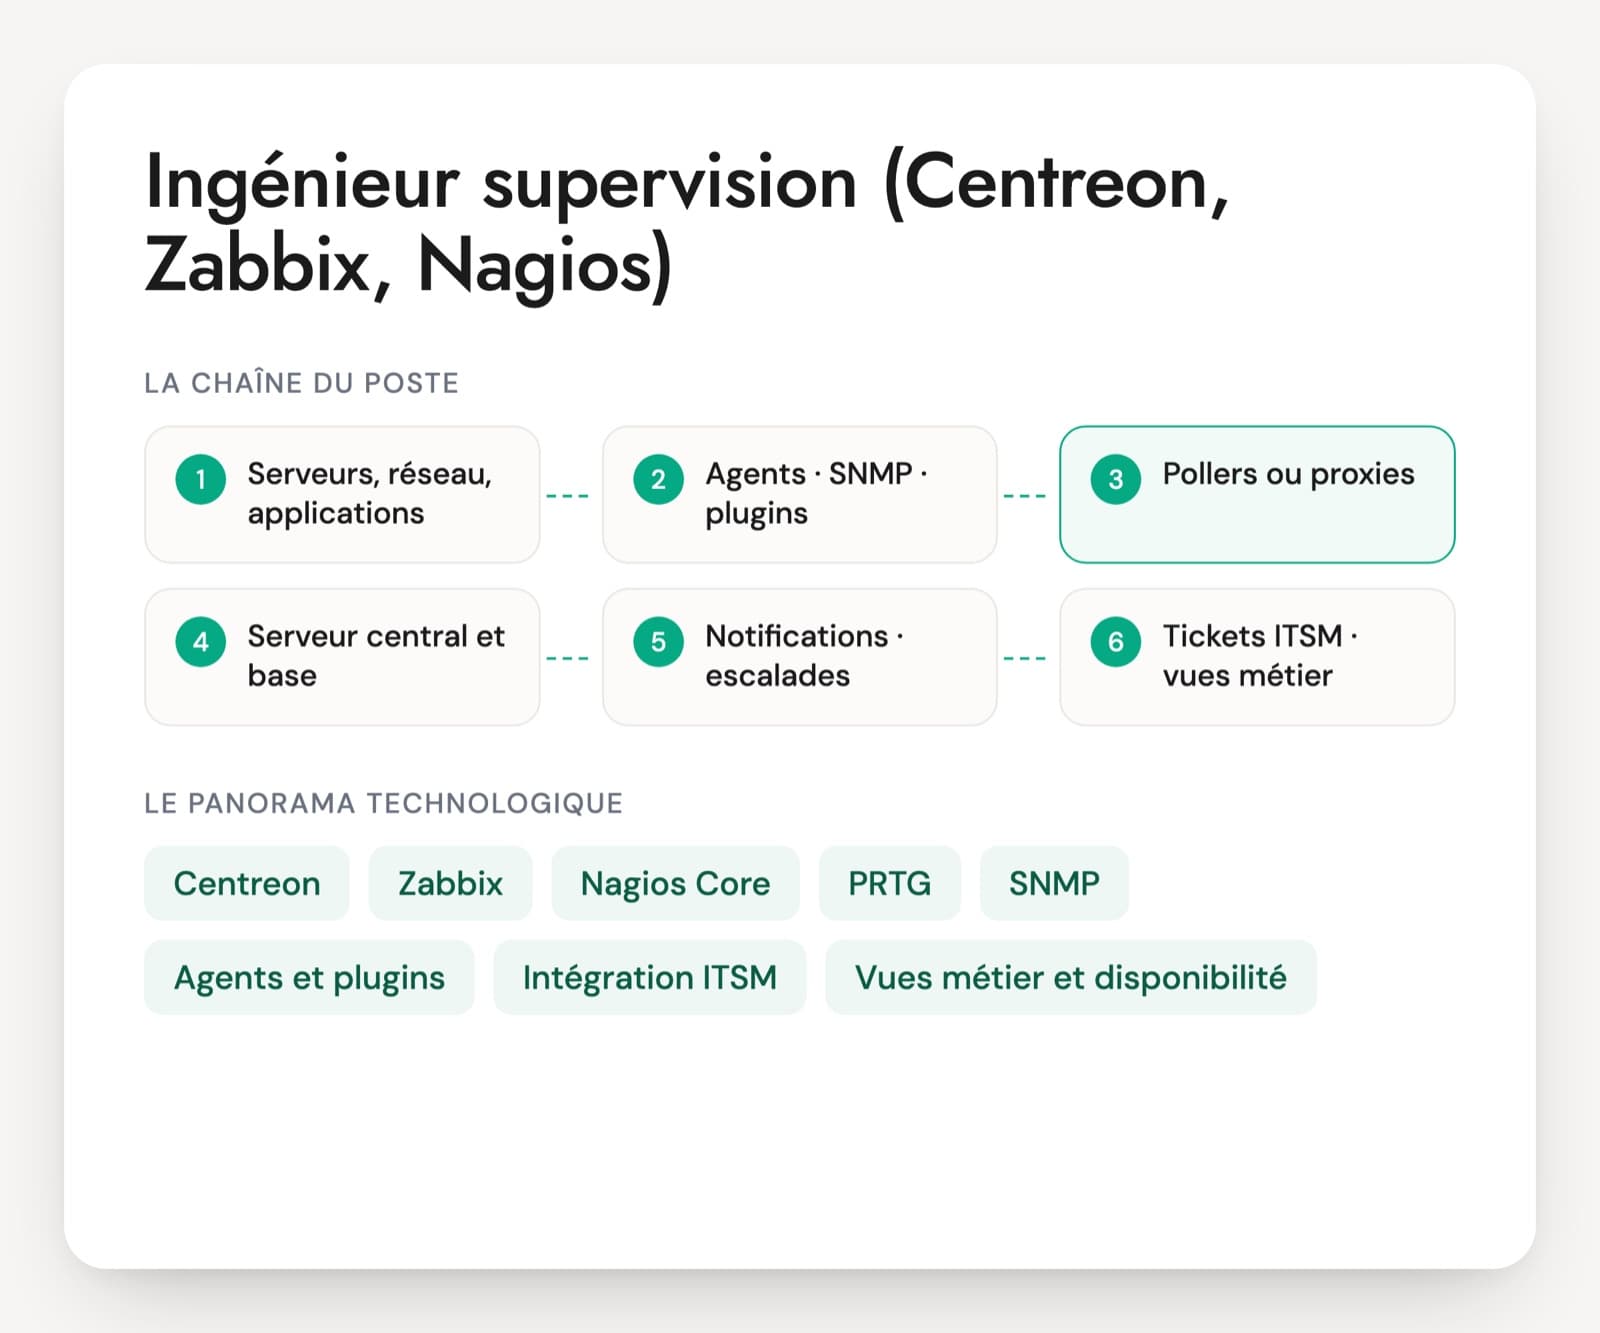
Ce poste se situe entre l'exploitation et l'outillage. Les questions d'entretien d'un ingénieur supervision portent sur des outils d'infrastructure comme Centreon, Zabbix, Nagios ou PRTG, sur les sondes SNMP, les agents et les plugins, sur les modèles et les seuils. Les offres demandent aussi de l'intégration avec l'outil de tickets et des vues par application pour le pilotage.
La confusion la plus fréquente concerne l'observabilité. Un ingénieur observabilité instrumente des applications avec des traces et des métriques détaillées, souvent avec Datadog, Dynatrace ou Prometheus. L'ingénieur supervision s'occupe d'abord de l'état des équipements et des services, avec des contrôles réguliers et des notifications. Certains profils couvrent les deux, mais un expert Centreon n'est pas forcément à l'aise avec OpenTelemetry, et l'inverse est vrai aussi.
Le signal le plus utile en entretien reste le bruit d'alerte. Le nombre de notifications qui partaient chaque nuit sur la dernière plateforme gérée, et ce que la personne a changé, en disent long. L'entretien vérifie aussi le niveau Linux, nécessaire pour administrer les pollers et écrire des sondes. Le PDF contient un cas de 20 minutes sur un site distant à superviser.
Les outils et protocoles de la supervision d'infrastructure
Centreon
Outil de supervision français issu de Nagios, très présent dans les offres. Un serveur central porte l'interface et la configuration, des pollers exécutent les contrôles, des remote servers relaient sur les sites distants. Depuis la 24.10, une version majeure sort chaque année, en octobre. Reste à savoir sur quelle version et quelle taille de plateforme la personne a travaillé.
Zabbix
Outil open source qui collecte par agents, SNMP ou API, avec des proxies pour les sites distants. Les déclencheurs (triggers) définissent quand une valeur devient un problème. La 7.0 LTS est très déployée, la 8.0 LTS est sortie en novembre 2026. Sa base de données grossit vite et demande de l'attention.
Nagios Core
L'outil historique, toujours en version 4.5. Son format de plugins, avec ses quatre codes retour, est repris par Centreon et par de nombreux autres outils. Beaucoup de plateformes anciennes tournent encore dessus et sont à migrer.
PRTG
Outil commercial de Paessler, organisé en capteurs (sensors), apprécié pour la supervision réseau et les parcs Windows. Il se prend en main vite, mais se pilote différemment des outils à base de plugins. Un profil PRTG pur aura un temps d'adaptation sur Centreon.
SNMP
Le protocole standard pour interroger les switchs, routeurs, pare-feux, onduleurs et baies. Chaque valeur a un identifiant (OID) décrit dans une MIB fournie par le constructeur. La version 3 apporte l'authentification et le chiffrement, que les versions 1 et 2c n'ont pas.
Agents et plugins
Sur les serveurs, la collecte passe par un agent (Zabbix agent 2, NSClient++ sous Windows, le Centreon Monitoring Agent) ou par des plugins lancés à distance en SSH. Les plugins Centreon couvrent des centaines d'équipements. Savoir en écrire un en Shell, Python ou Perl reste une compétence attendue.
Intégration ITSM
La supervision ouvre automatiquement des tickets dans ServiceNow, GLPI ou un autre outil de gestion des services. L'enjeu est d'ouvrir un ticket par incident, de le mettre à jour, puis de le clore au retour à la normale, sans créer de doublons.
Vues métier et disponibilité
Les outils agrègent les états techniques en indicateurs par application : module BAM et cartes MAP chez Centreon, services et SLA chez Zabbix. Ces vues servent au pilotage et aux rapports de disponibilité mensuels.
Le titre change selon les équipes : administrateur supervision, expert Centreon, ingénieur de production et supervision, expert outillage monitoring. Sur certains postes, la personne administre la plateforme et écrit les sondes. Sur d'autres, elle définit aussi les règles d'alerte avec les équipes d'exploitation et produit les rapports de disponibilité. La plupart des offres attendent un bon niveau Linux, du scripting et des notions réseau. Les certifications éditeur existent, mais une plateforme réellement administrée, avec son nombre d'hôtes et de contrôles, en dit davantage.
Les compétences attendues d'un administrateur supervision
- Architecture Centreon, Zabbix et Nagios
- Sondes, SNMP et plugins
- Modèles, seuils et découverte
- Notifications, dépendances et escalades
- Intégration ITSM et vues métier
- Exploitation de la plateforme de supervision
Ce qu'un ingénieur supervision doit savoir résoudre, en cinq questions
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · junior à confirmé
Que doit renvoyer un plugin de type Nagios pour que Centreon ou Nagios interprète correctement son résultat ?
Une bonne réponseUn code retour : 0 pour OK, 1 pour WARNING, 2 pour CRITICAL, 3 pour UNKNOWN. Une première ligne de texte lisible par l'exploitant, puis les données de performance après le caractère |, au format label=valeur unité;warning;critical;min;max. Le plugin gère son propre délai et renvoie UNKNOWN s'il ne peut pas conclure. Il tourne avec l'utilisateur du moteur de supervision, donc avec ses droits et son environnement.
Signal d'alerteUn script qui affiche « CRITICAL » dans le texte mais sort avec le code 0, ou aucune idée de ce que sont les données de performance.
Question 2 · confirmé à senior
L'astreinte reçoit 400 alertes par nuit et n'en lit plus aucune. Par quoi commencez-vous ?
Une bonne réponsePar les chiffres : les services et les hôtes qui génèrent le plus de notifications sur un mois. Ensuite, les causes habituelles : seuils trop proches de la valeur normale, contrôles qui oscillent (flapping), absence de dépendances, maintenances non déclarées. Il règle les tentatives avant l'état HARD pour ignorer les pics brefs, déclare les plages de maintenance et ne garde en notification que les alertes qui demandent une action la nuit. Le reste va dans un tableau de bord consulté en journée. Il revoit la liste avec l'équipe d'exploitation.
Signal d'alerteCouper les notifications, ou relever tous les seuils à 99 % pour faire baisser le volume.
Question 3 · confirmé
Un switch d'accès tombe et la supervision remonte 48 serveurs DOWN d'un coup. Comment l'évitez-vous ?
Une bonne réponseEn déclarant le switch comme parent des serveurs qui en dépendent. Le moteur passe alors les serveurs en UNREACHABLE au lieu de DOWN, et les notifications de cet état sont désactivées pour ne garder que celle du switch. Il ajoute des dépendances de services quand une application dépend d'une base ou d'un serveur précis. Sur Zabbix, il utilise les dépendances entre déclencheurs.
Signal d'alerteSupprimer la supervision des serveurs, ou expliquer à l'astreinte qu'il suffit de regarder le switch.
Question 4 · confirmé
Vous supervisez un équipement réseau en SNMP. v2c ou v3, et que configurez-vous de chaque côté ?
Une bonne réponseSNMPv3 en mode authPriv dès que l'équipement le permet, avec authentification SHA et chiffrement AES, un utilisateur dédié en lecture seule et une liste d'accès limitée aux adresses des collecteurs. En v2c, la communauté circule en clair. Il valide avec snmpwalk sur les OID utiles et la MIB du constructeur. Pour les interfaces rapides, il utilise les compteurs 64 bits (ifHCInOctets) pour éviter les débouclages. Il distingue l'interrogation régulière et les traps envoyés par l'équipement.
Signal d'alerteLa communauté « public » en lecture-écriture, ou ne pas savoir ce qu'est un OID.
Question 5 · senior
Comment structurez-vous les modèles d'hôtes et de services pour superviser 2 000 serveurs ?
Une bonne réponseDes modèles en couches : système d'exploitation, rôle, application, combinés par héritage. Les seuils sont portés par des macros, surchargées hôte par hôte quand c'est justifié, plutôt que par des services copiés. Sur Zabbix, des templates liés entre eux, des macros utilisateur avec contexte et la découverte bas niveau pour les disques et les interfaces. La création des hôtes est automatisée depuis la CMDB ou l'outil de déploiement, par l'API ou Ansible, avec une convention de nommage.
Signal d'alerteChaque hôte configuré à la main, avec des services dupliqués et des seuils modifiés directement dans chaque service.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Ingénieur supervision : les questions fréquentes
Ingénieur supervision ou ingénieur observabilité : quelle différence ?
Tout part de ce qu'il faut surveiller. Pour des serveurs, des équipements réseau et des services d'infrastructure, avec des alertes vers une astreinte, c'est un ingénieur supervision. Pour des applications distribuées dont il faut suivre les requêtes de bout en bout, c'est un profil observabilité. Si les deux coexistent, la personne doit savoir relier les alertes d'infrastructure aux indicateurs applicatifs sans dupliquer les notifications.
Un expert Centreon peut-il prendre en main Zabbix rapidement ?
Les notions sont communes : contrôles, seuils, dépendances, modèles, notifications. La logique diffère. Centreon raisonne en services et en plugins hérités de Nagios, Zabbix en éléments collectés et en déclencheurs, avec sa propre découverte automatique. Il faut quelques semaines pour être autonome sur une plateforme existante. L'entretien porte sur l'outil cible si la personne doit le concevoir dès son arrivée.
Quel test technique pour un administrateur supervision ?
Deux exercices courts fonctionnent bien. Écrire une petite sonde en Shell ou en Python qui renvoie les bons codes retour et des données de performance. Puis lire une liste réelle d'alertes d'une nuit, anonymisée, et proposer ce qu'il faut supprimer, regrouper ou garder. Le second montre vite si la personne pense à l'astreinte qui reçoit les alertes.
Quel niveau Linux attendre d'un ingénieur supervision ?
Un niveau d'administrateur. Les serveurs de supervision et les pollers tournent presque toujours sous Linux, avec une base MariaDB ou PostgreSQL à entretenir. La personne doit diagnostiquer un service qui ne démarre plus, lire les journaux, gérer l'espace disque et écrire des scripts. S'y ajoutent des bases réseau : routage, pare-feu, flux à ouvrir entre collecteurs et équipements.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.