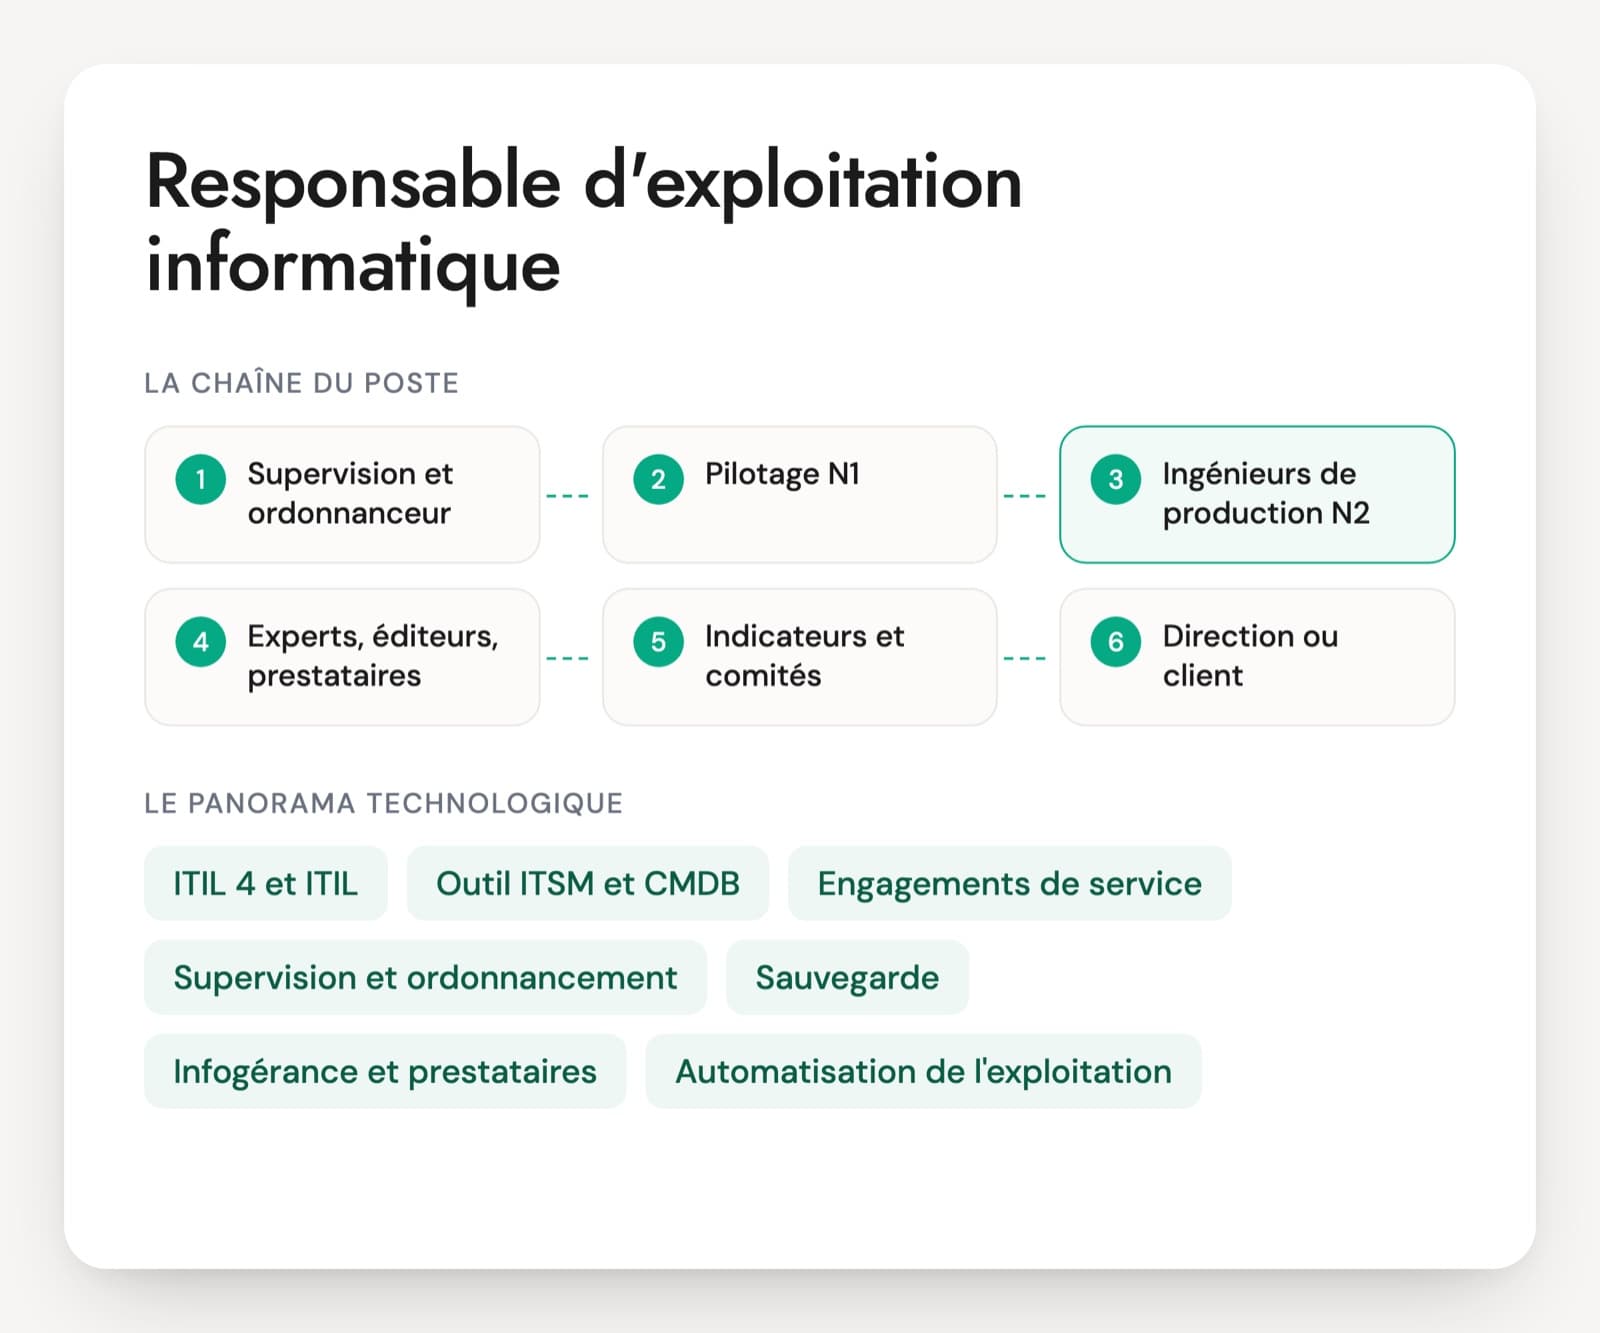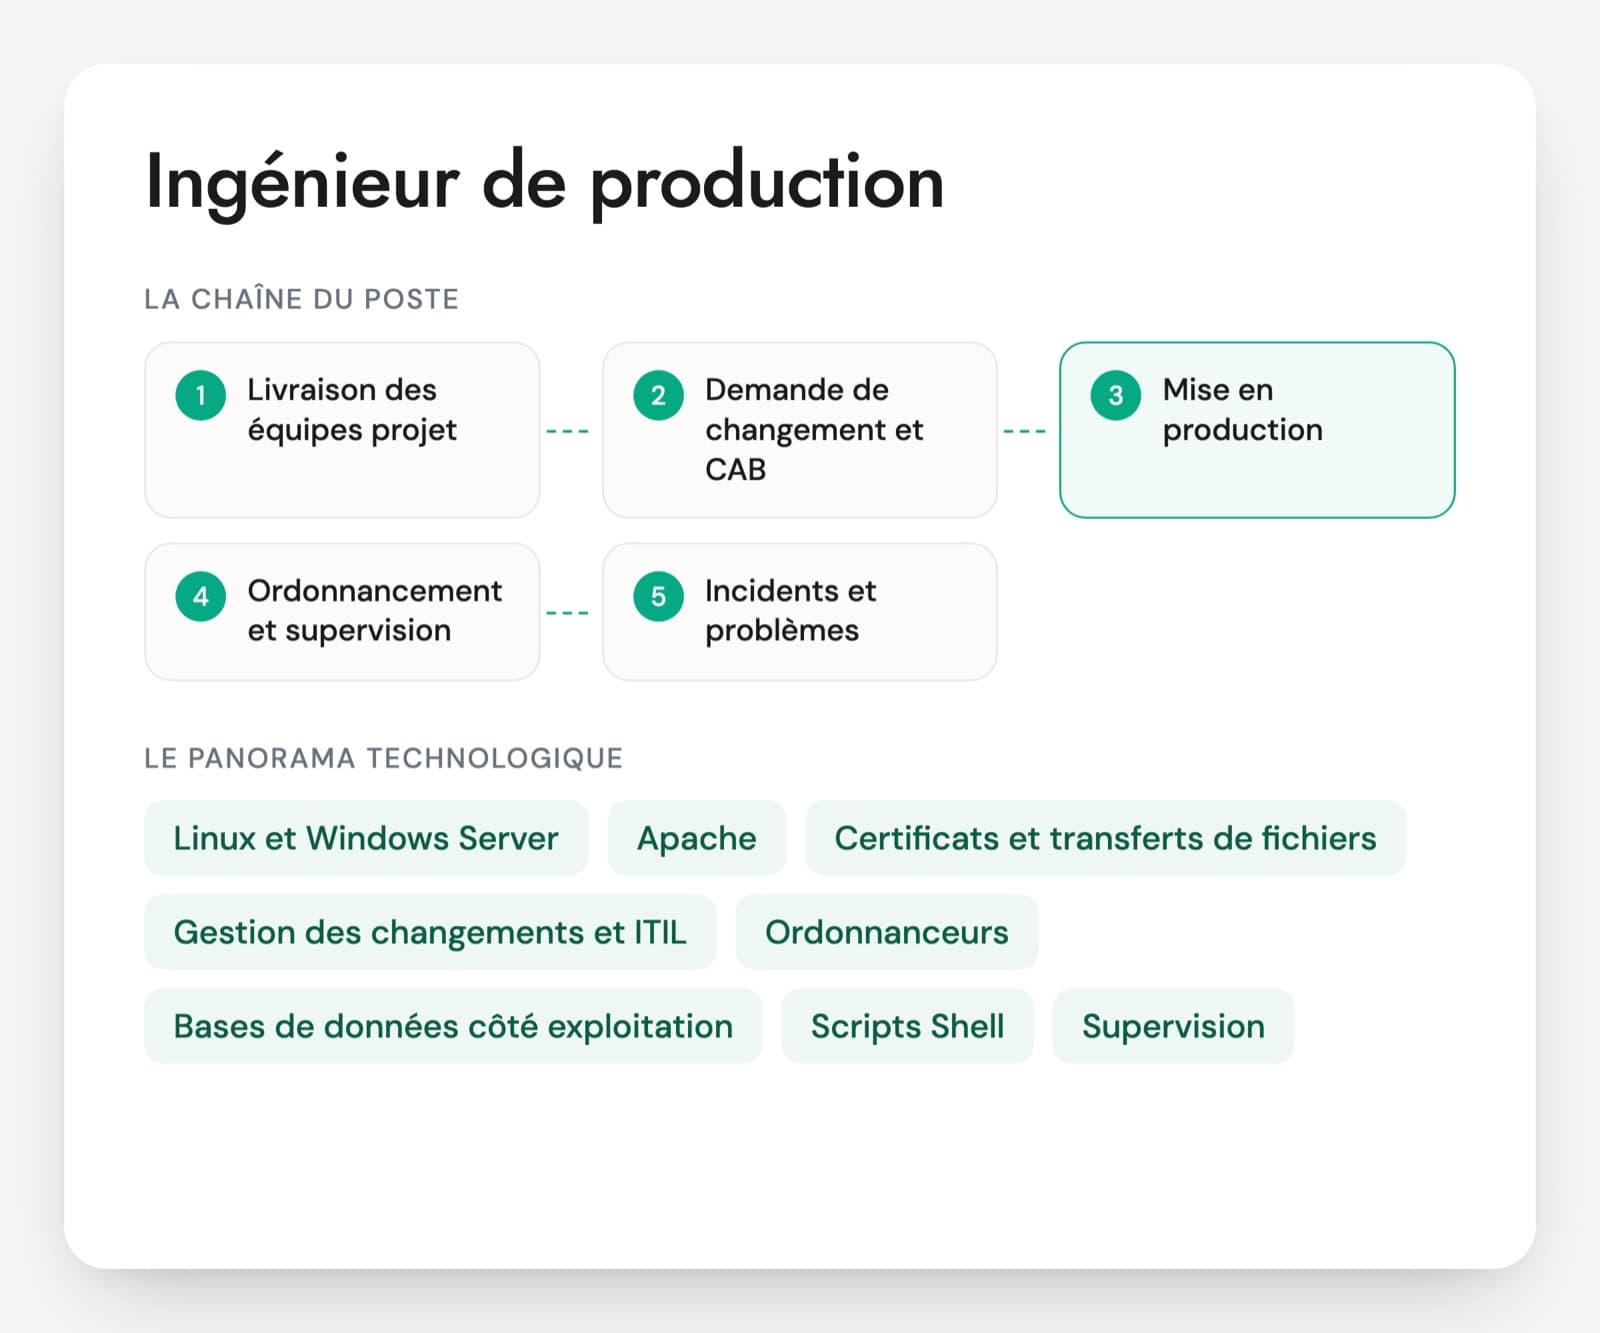
Sous cet intitulé, on trouve aussi ingénieur d'exploitation, ingénieur de production applicative ou ingénieur MCO. Le poste consiste à maintenir en condition opérationnelle des applications installées sur Linux ou Windows Server, derrière Apache, Tomcat, JBoss ou IIS, avec leurs bases, leurs flux de fichiers et leurs traitements lancés par un ordonnanceur. Les questions d'entretien d'un ingénieur de production partent de ce périmètre plutôt que de la liste d'outils de l'offre.
Deux parcours se présentent souvent. Les candidats venus du pilotage ou du support connaissent les procédures, sans toujours savoir pourquoi elles existent. Ceux qui arrivent du DevOps automatisent vite mais découvrent parfois le dossier de changement, la fenêtre de maintenance et le retour arrière écrit d'avance. Le bon profil lit un journal système, écrit un script qui renvoie un code retour exploitable et refuse une mise en production sans plan de retour.
Une certification ITIL Foundation montre que la personne connaît le vocabulaire des incidents, des problèmes et des changements. Elle ne dit rien de sa capacité à trouver la cause d'une lenteur qui revient chaque lundi. Il faut des cas vécus, avec les commandes lancées, les fichiers de journaux lus et la décision prise. Le PDF contient l'entretien complet en 30 questions, un cas de 20 minutes et une grille de 1 à 4.
Le socle technique d'un ingénieur de production
Linux et Windows Server
Le terrain de travail. Sous Linux, l'ingénieur de production suit les services avec systemctl, lit les journaux avec journalctl, surveille l'espace disque, les processus et les ports. Sous Windows Server, il passe par l'observateur d'événements, la console des services et PowerShell. La plupart des postes demandent les deux, avec une dominante selon le parc.
Apache, Tomcat, JBoss et IIS
Les serveurs web et d'applications qui portent les applications métier. On attend de savoir où se trouvent la configuration, les journaux et les réglages de mémoire de la JVM, de redémarrer proprement une instance et d'expliquer une erreur 502 ou 503 derrière un reverse proxy. JBoss EAP est la version supportée par Red Hat, WildFly sa version communautaire.
Certificats et transferts de fichiers
Les certificats TLS des sites et des flux expirent, et un certificat oublié coupe une application sans prévenir. Les fichiers échangés avec les autres applications et les partenaires passent par SFTP ou par un moniteur de transfert comme Axway CFT. La personne doit savoir lire un certificat avec openssl et reprendre un transfert en échec.
Gestion des changements et ITIL
Toute intervention en production passe par une demande de changement : description, impacts, tests, retour arrière, validation en CAB pour les changements à risque. ITIL 4 reste la référence citée dans les offres, et PeopleCert propose ITIL (Version 5) à côté. L'outil est souvent ServiceNow, parfois Jira Service Management ou EasyVista.
Ordonnanceurs
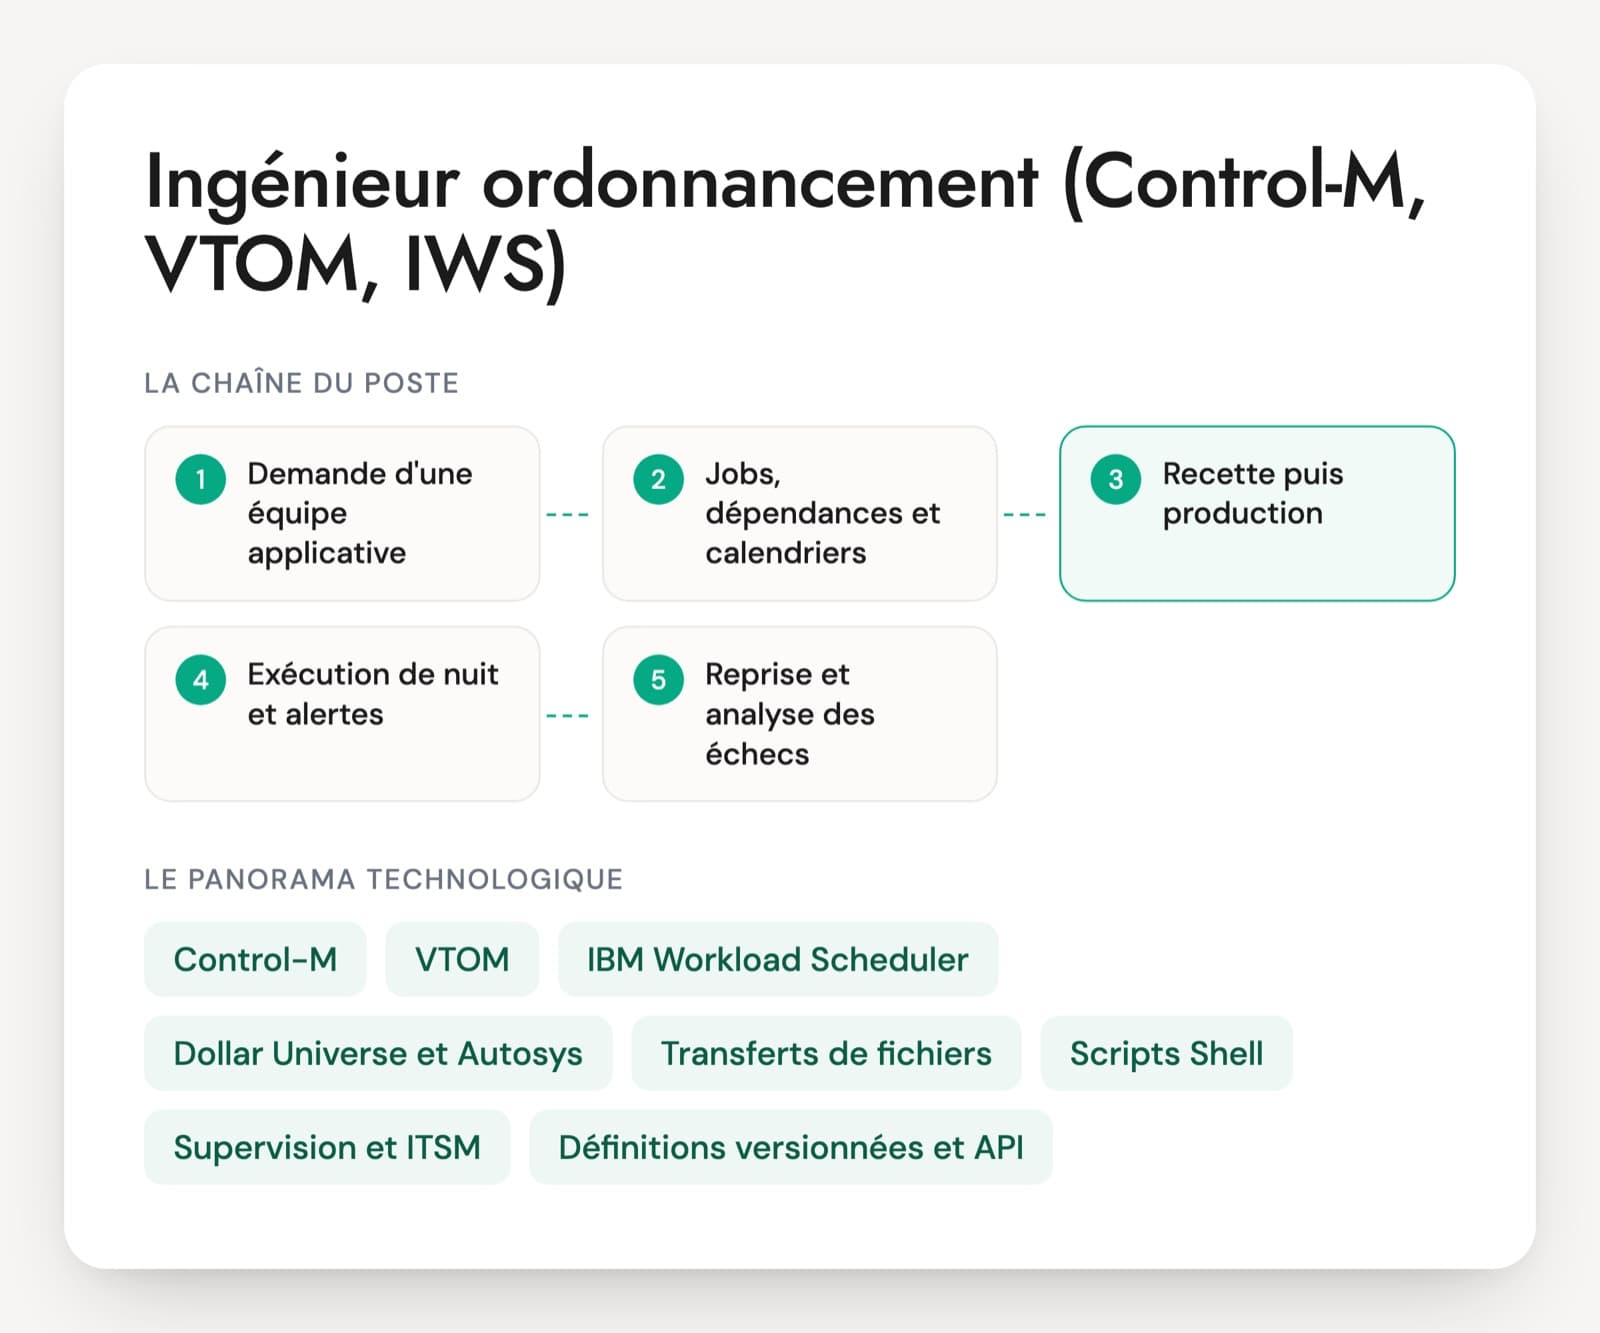
Control-M, VTOM, IBM Workload Scheduler, Dollar Universe ou Autosys lancent les traitements de nuit dans le bon ordre. L'ingénieur de production n'administre pas forcément l'outil, mais il crée ou modifie des jobs, lit leurs sorties et décide d'une relance avec l'équipe applicative. Ses scripts doivent renvoyer un code retour fiable, sinon l'ordonnanceur affiche vert sur un traitement raté.
Bases de données côté exploitation
Oracle, SQL Server, PostgreSQL ou MySQL. Sans être DBA, l'ingénieur de production écrit des requêtes de contrôle, lance des purges validées par le métier, suit le remplissage des tablespaces ou des fichiers de données et sait à quel moment passer la main au DBA.
Scripts Shell, Python et PowerShell
Les scripts servent aux contrôles quotidiens, aux purges, aux redémarrages et aux livraisons répétitives. On regarde la gestion des erreurs, les codes retour, le journal produit et la possibilité de relancer le script sans casser ce qui est déjà fait. Ansible revient dans beaucoup d'offres pour industrialiser les gestes répétés.
Supervision, sauvegardes et PRA
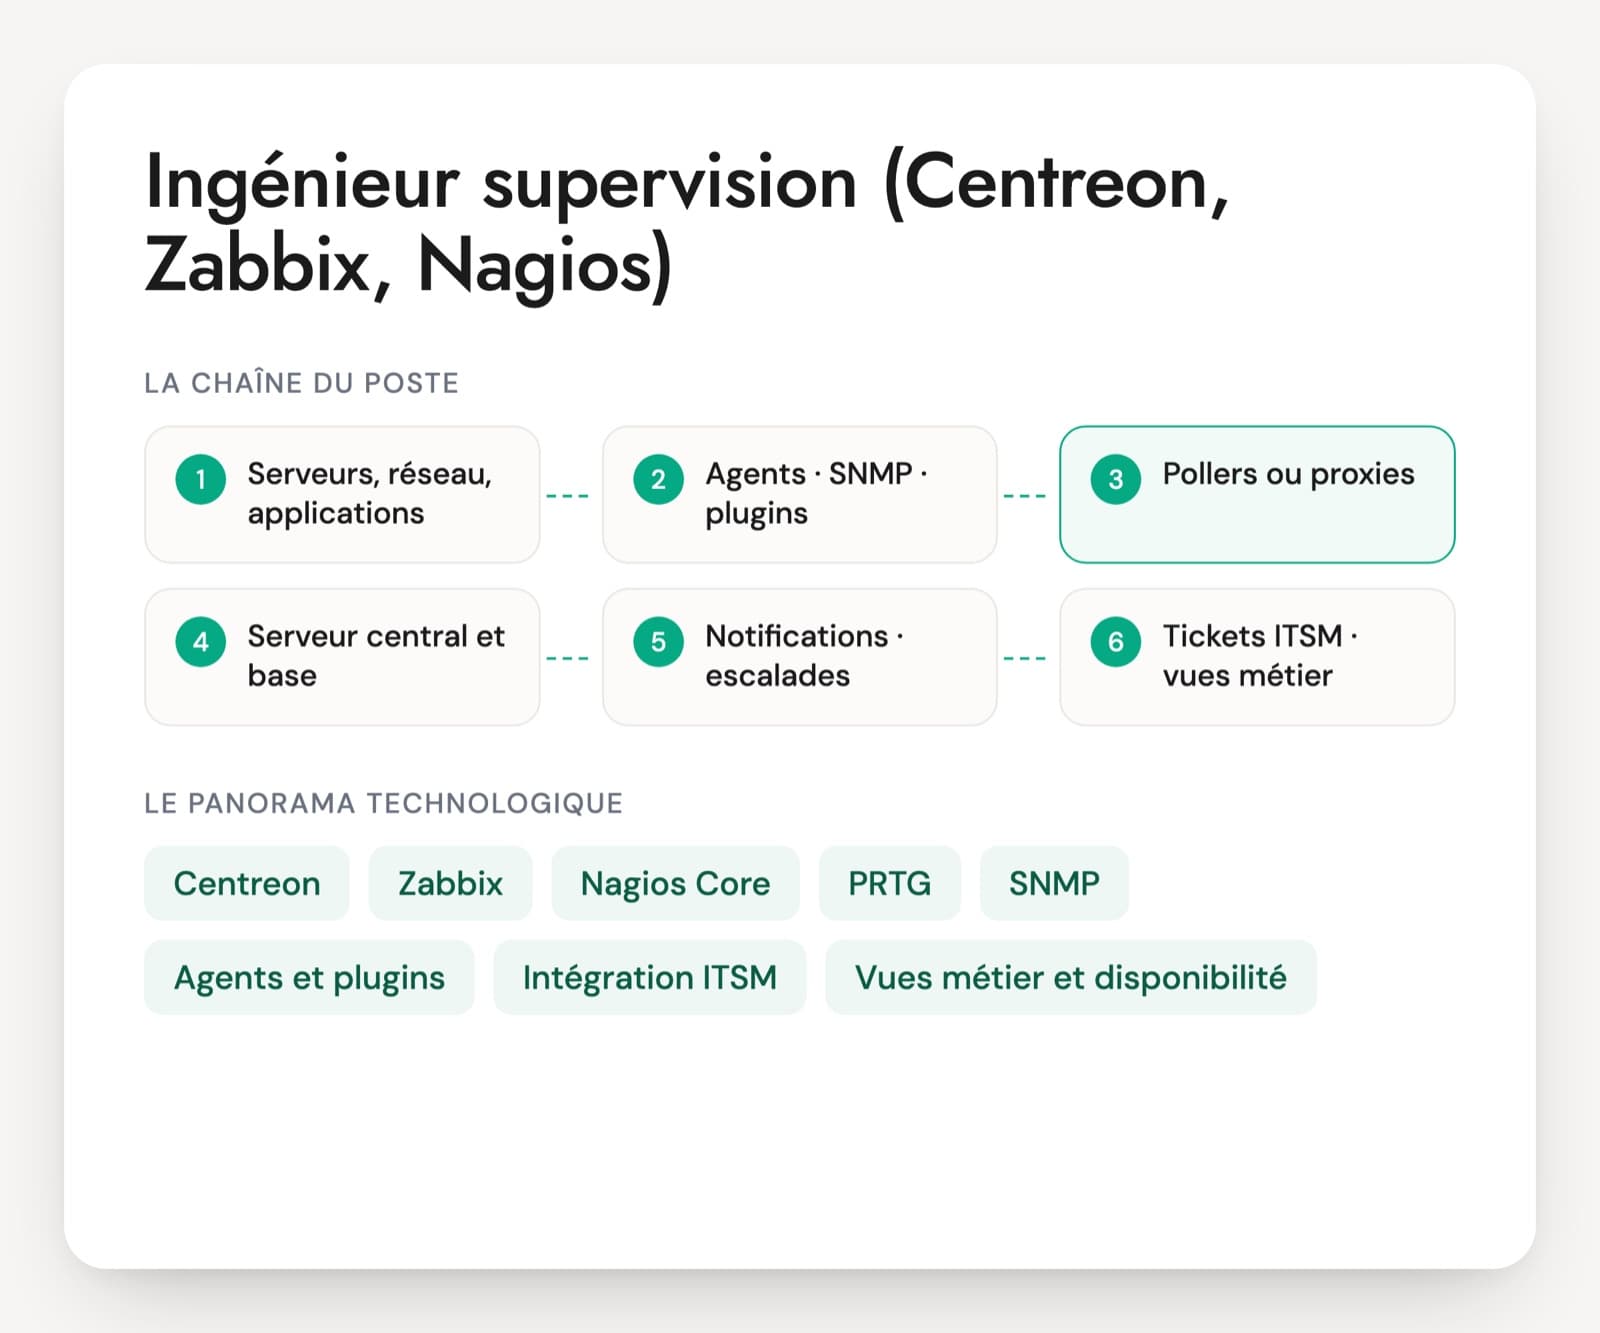
Centreon, Zabbix, Nagios ou Dynatrace remontent les alertes, avec des seuils que l'ingénieur de production ajuste pour ses applications. Les sauvegardes (Veeam, Commvault, NetBackup), les tests de restauration et les exercices de PRA font partie du MCO. Reste à savoir à quand remonte la dernière restauration que la personne a menée elle-même.
Selon l'employeur, l'ingénieur de production exploite les applications de son entreprise ou celles de plusieurs clients en infogérance. Le périmètre varie : certains postes s'arrêtent au niveau 2 et aux mises en production, d'autres ajoutent l'astreinte, les exercices de PRA et l'administration d'un ordonnanceur. Les interventions planifiées tombent souvent le soir ou le week-end. L'intitulé se confond facilement avec ingénieur de production DevOps, qui ajoute pipelines CI/CD et conteneurs, avec intégrateur d'exploitation, centré sur la réception des livraisons, et avec SRE. L'offre précise la part du run quotidien, celle des projets et le niveau d'astreinte attendu.
Six compétences à contrôler chez un ingénieur de production
- Diagnostic Linux et Windows Server
- Serveurs web et d'applications
- Changements et mises en production
- Incidents et analyse de cause
- Scripts, batch et requêtes SQL
- Supervision, sauvegardes et PRA
Des situations de MCO et les réponses attendues
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Le certificat TLS d'une application interne expire dans dix jours. Il est installé sur un Apache en frontal et dans le keystore d'un Tomcat. Comment procédez-vous ?
Une bonne réponseLa personne commence par regarder ce qui est en place : openssl x509 -noout -dates sur le fichier, ou openssl s_client sur le site, pour l'échéance et la chaîne, et keytool -list pour le keystore Java. Elle génère une demande de certificat (CSR) avec tous les noms du site, récupère le certificat et ses intermédiaires, les installe des deux côtés puis recharge proprement les services. Elle passe par un changement, garde l'ancien fichier pour revenir en arrière et ajoute une sonde qui alerte trente jours avant la prochaine échéance.
Signal d'alerteRemplacer le fichier côté Apache et oublier le keystore du Tomcat, oublier la chaîne intermédiaire, ou ne découvrir l'échéance que le jour où le site tombe faute de supervision.
Question 2 · junior à confirmé
Un script shell de nuit copie des fichiers vers un partenaire. Il échoue parfois, mais l'ordonnanceur l'affiche toujours en succès. Que corrigez-vous ?
Une bonne réponseLe script renvoie le code retour de sa dernière commande, souvent un echo ou un rm qui réussit. Il faut tester le code retour de chaque étape qui compte, sortir avec un code non nul documenté en cas d'échec, utiliser set -e et set -o pipefail en connaissant leurs limites, et écrire un journal horodaté. Le job de l'ordonnanceur doit ensuite traiter ce code comme un échec, avec une consigne de reprise.
Signal d'alerteAjouter une ligne d'erreur dans le journal sans changer le code de sortie, ou compter sur l'équipe de nuit pour lire la sortie de chaque job.
Question 3 · confirmé
Vous devez passer dimanche la montée de version d'une application sur trois serveurs Tomcat et une base Oracle. Que contient votre demande de changement ?
Une bonne réponseLe périmètre et les serveurs, l'impact pour les utilisateurs et la fenêtre de coupure validée, les prérequis (sauvegarde ou point de restauration de la base, copie de la version en place), le mode opératoire pas à pas, les tests de validation avec un contact métier, le critère qui déclenche le retour arrière et ce retour arrière écrit et minuté. Pour un changement à risque, le passage en CAB et un coup d'œil aux autres changements prévus sur la même fenêtre. La personne pense aussi à suspendre les jobs concernés dans l'ordonnanceur et à mettre la supervision en maintenance.
Signal d'alerteUn ticket d'une ligne « MEP version 4.2 », un retour arrière résumé à « on restaure », ou aucune heure limite pour décider de revenir en arrière.
Question 4 · confirmé à senior
Depuis trois semaines, l'application de facturation est lente chaque lundi entre 8 h et 10 h, puis tout redevient normal. Les incidents sont clos à chaque fois. Comment trouvez-vous la cause ?
Une bonne réponseLa personne ouvre un problème au sens ITIL au lieu de clore un quatrième incident. Elle rassemble les mesures des lundis (processeur, mémoire, disques, temps de réponse, journaux de l'application et de la base) et cherche ce qui change ce jour-là : un traitement du week-end qui déborde, une sauvegarde, une purge, un pic de connexions, un cache vide après un redémarrage du dimanche. Elle compare avec un autre jour, teste une hypothèse à la fois et enregistre le contournement comme erreur connue en attendant la correction.
Signal d'alerteRedémarrer le serveur chaque lundi à 7 h et clore le ticket, ou réclamer plus de processeurs sans avoir rien mesuré.
Question 5 · confirmé
Le tablespace d'une table de journaux applicatifs Oracle est à 92 % et grossit de plusieurs gigaoctets par jour. Le métier accepte de ne garder que 90 jours. Comment purgez-vous ?
Une bonne réponseD'abord une règle de conservation validée par écrit, puis un comptage des lignes concernées. La suppression se fait par lots avec un commit régulier, en heures creuses, pour ne pas saturer l'undo ni bloquer l'application. Mieux encore, un partitionnement par date permet de supprimer une partition entière. La personne sait qu'un DELETE ne rend pas l'espace au tablespace et voit avec le DBA s'il faut le récupérer. La purge devient ensuite un job planifié.
Signal d'alerteUn DELETE de toutes les lignes anciennes en une seule transaction en pleine journée, un TRUNCATE sans validation du métier, ou agrandir le tablespace à chaque alerte.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Ingénieur de production : les points à trancher
Quelles compétences techniques exiger d'un ingénieur de production ?
L'administration courante de Linux et de Windows Server, la pratique d'au moins un serveur d'applications (Tomcat, JBoss ou IIS), le SQL de contrôle, le scripting Shell ou PowerShell et la lecture des journaux. S'y ajoutent la gestion des changements et des incidents selon ITIL, la manipulation d'un ordonnanceur et d'un outil de supervision. Le reste dépend du parc : Oracle ou SQL Server, CFT, Ansible. L'offre liste ce qui est indispensable dès l'arrivée et ce qui s'apprend sur place.
En quoi ce poste diffère-t-il d'un ingénieur de production DevOps ou d'un SRE ?
L'ingénieur de production tient des applications existantes avec des procédures, des changements validés et des gestes manuels qu'il automatise peu à peu. L'ingénieur de production DevOps ajoute les pipelines de déploiement, les conteneurs et souvent OpenShift ou Kubernetes. Le SRE mesure la fiabilité avec des objectifs chiffrés et écrit davantage de code. Les frontières bougent d'une entreprise à l'autre : les tâches réelles comptent plus que l'intitulé.
Un pilote d'exploitation peut-il passer ingénieur de production ?
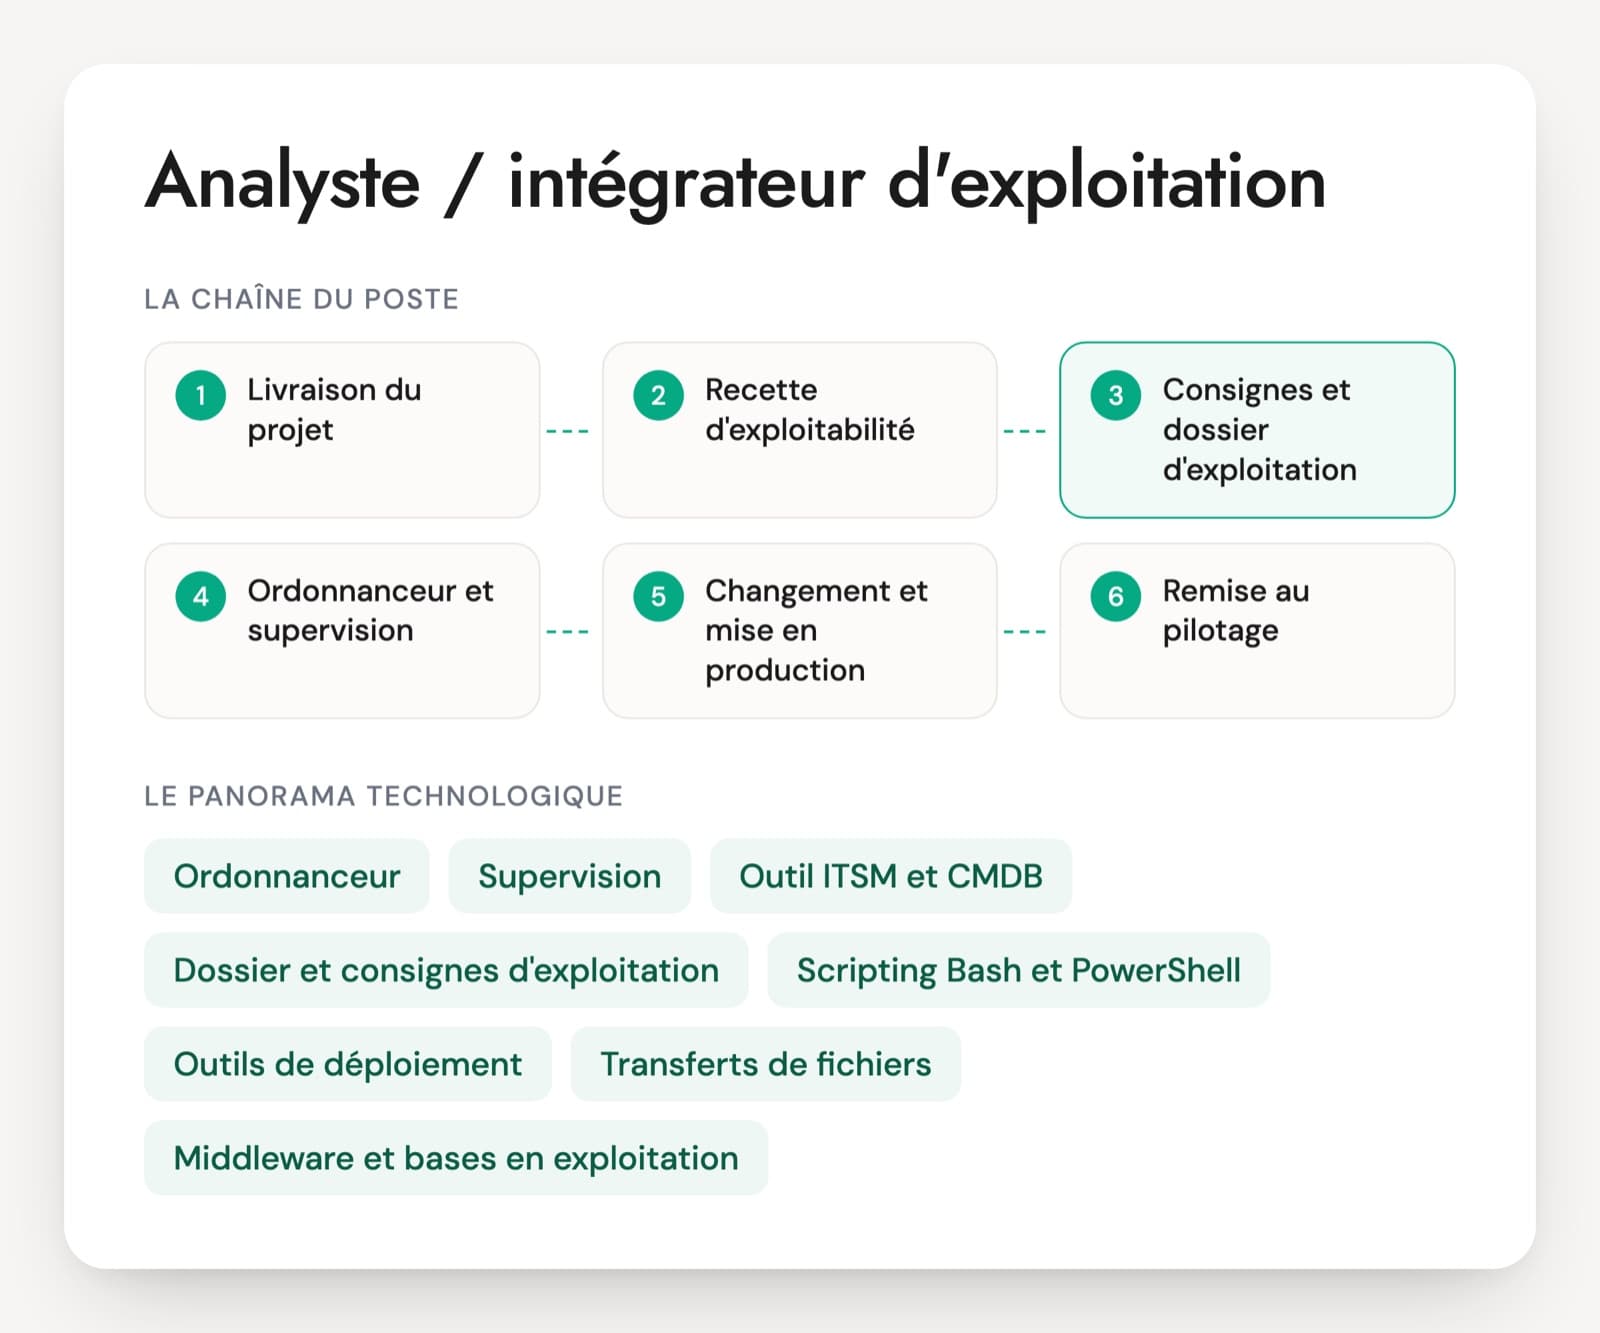
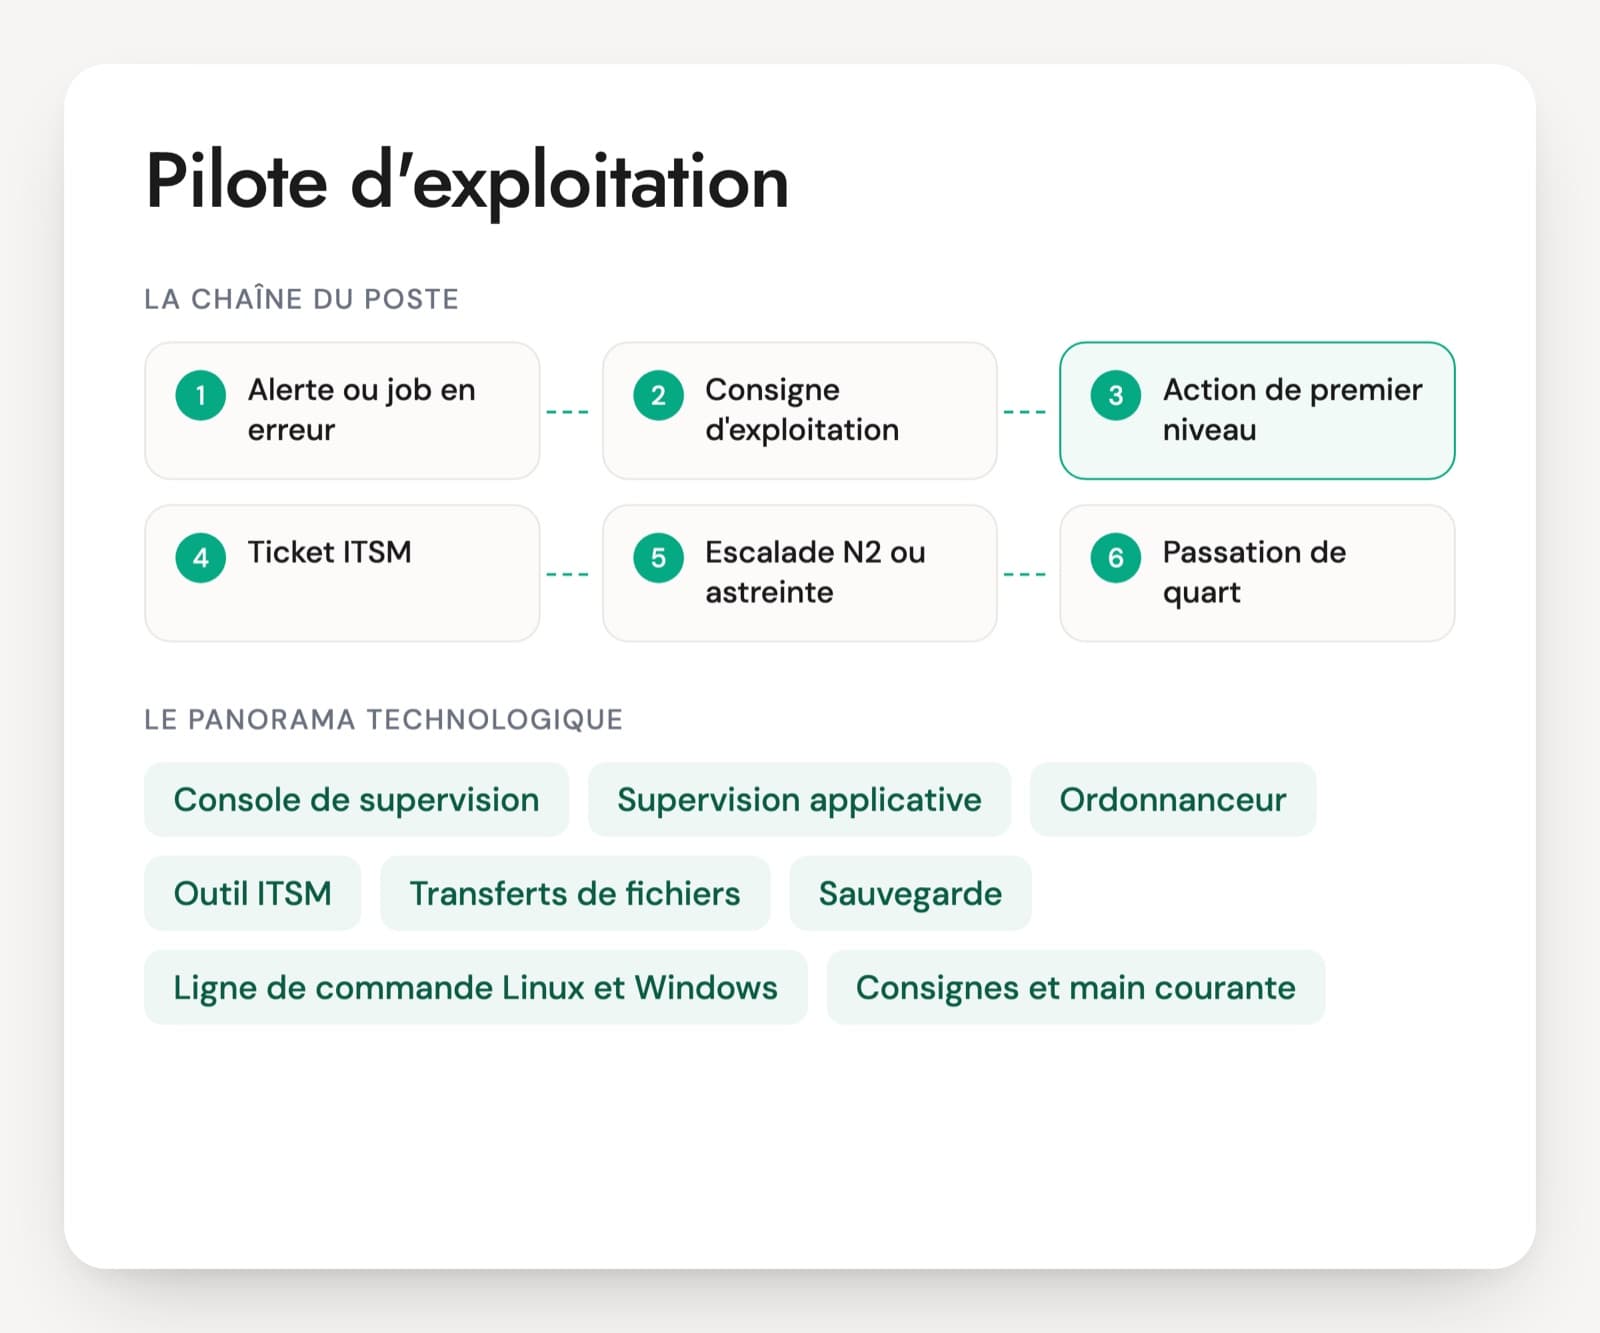
C'est une évolution courante. Le pilote connaît déjà les consoles, les chaînes batch et les procédures de reprise. Ce qui reste à vérifier en entretien : le diagnostic sans procédure écrite, l'écriture de scripts avec gestion d'erreurs, la préparation d'un dossier de changement et la lecture d'un journal applicatif. Face à un incident qu'aucune consigne ne couvre, on regarde comment il cherche, quelles commandes il propose et à quel moment il escalade.
À quoi ressemble un bon exercice pratique pour ce poste ?
Un test technique court en entretien vaut mieux qu'un devoir à la maison. L'exercice part d'un extrait de journal Tomcat avec une erreur, d'un script shell qui masque ses échecs ou d'une demande de changement incomplète : la personne dit ce qu'elle corrige. Vingt minutes suffisent. Elle commente chaque étape : on voit l'ordre de ses vérifications et ce qu'elle ne pense pas à contrôler.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.