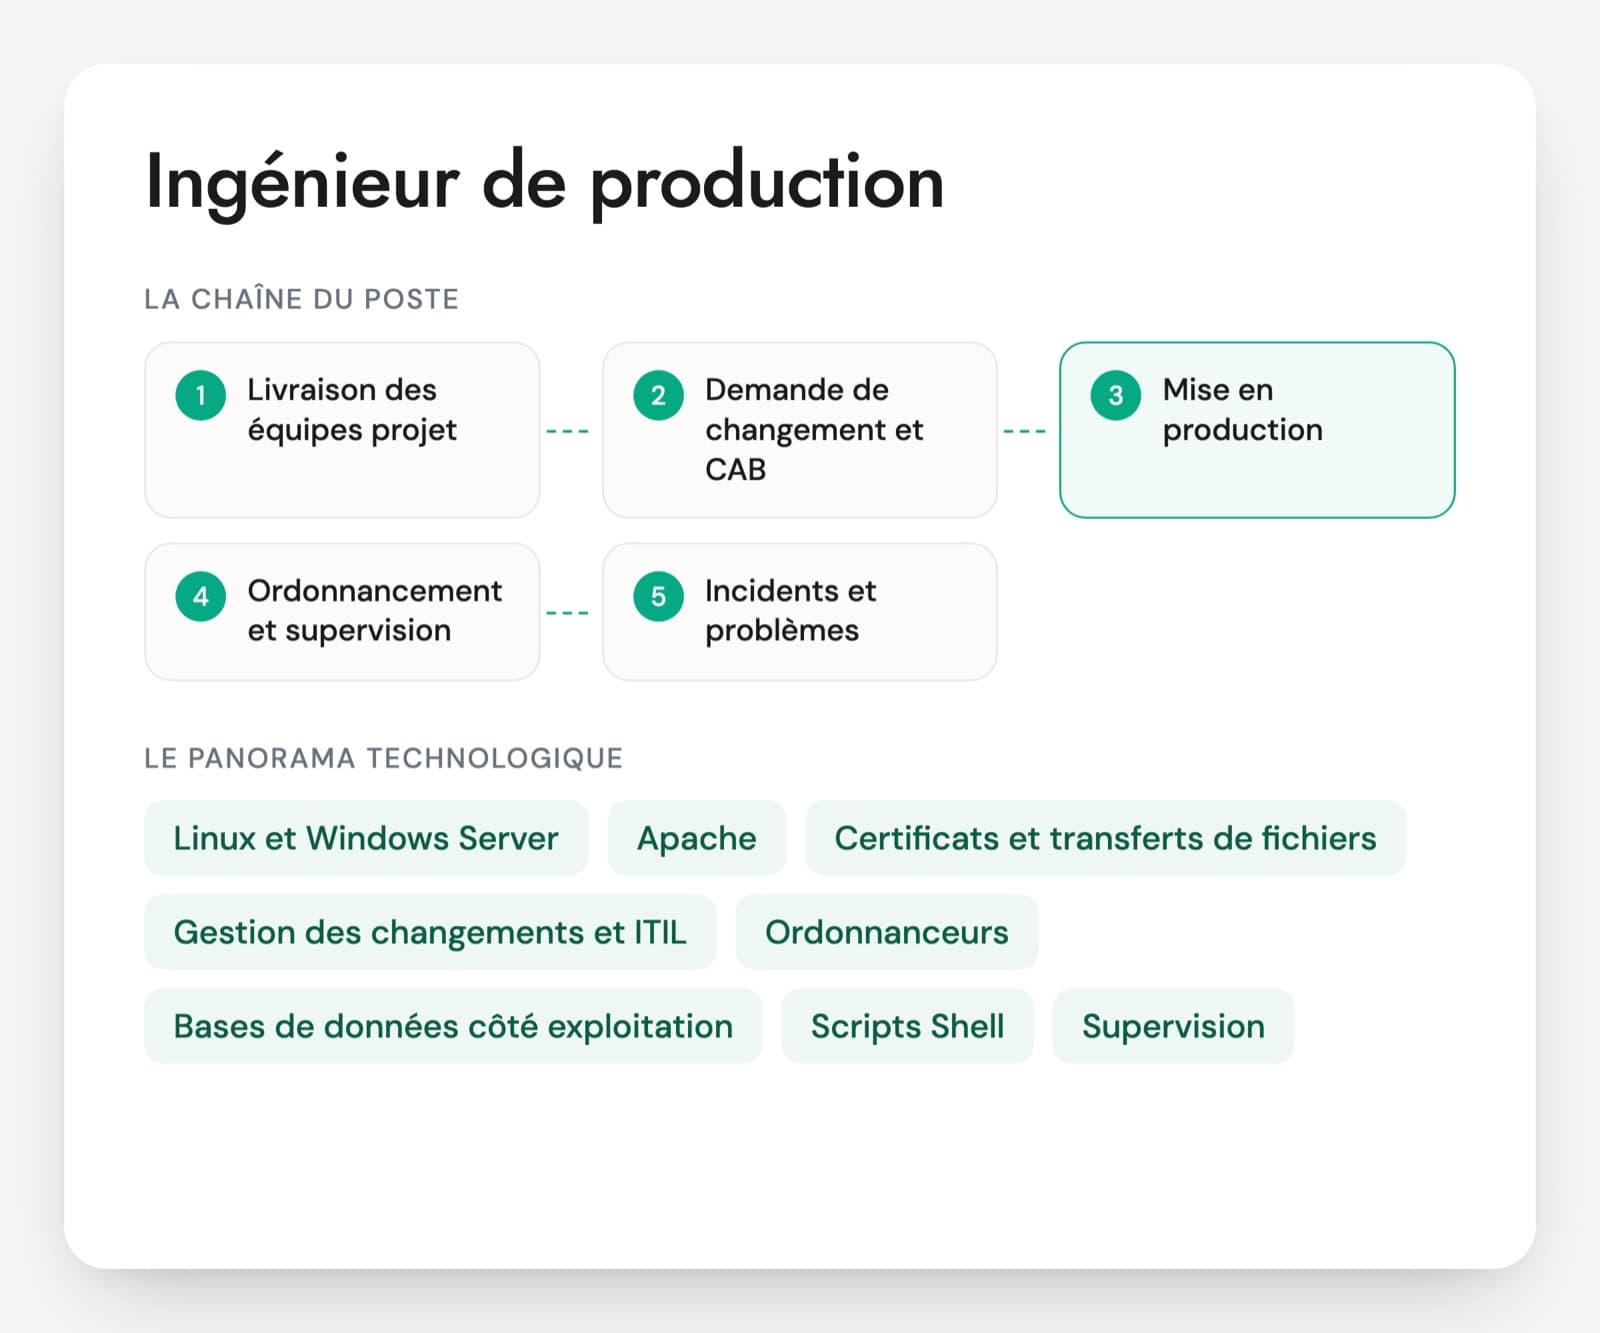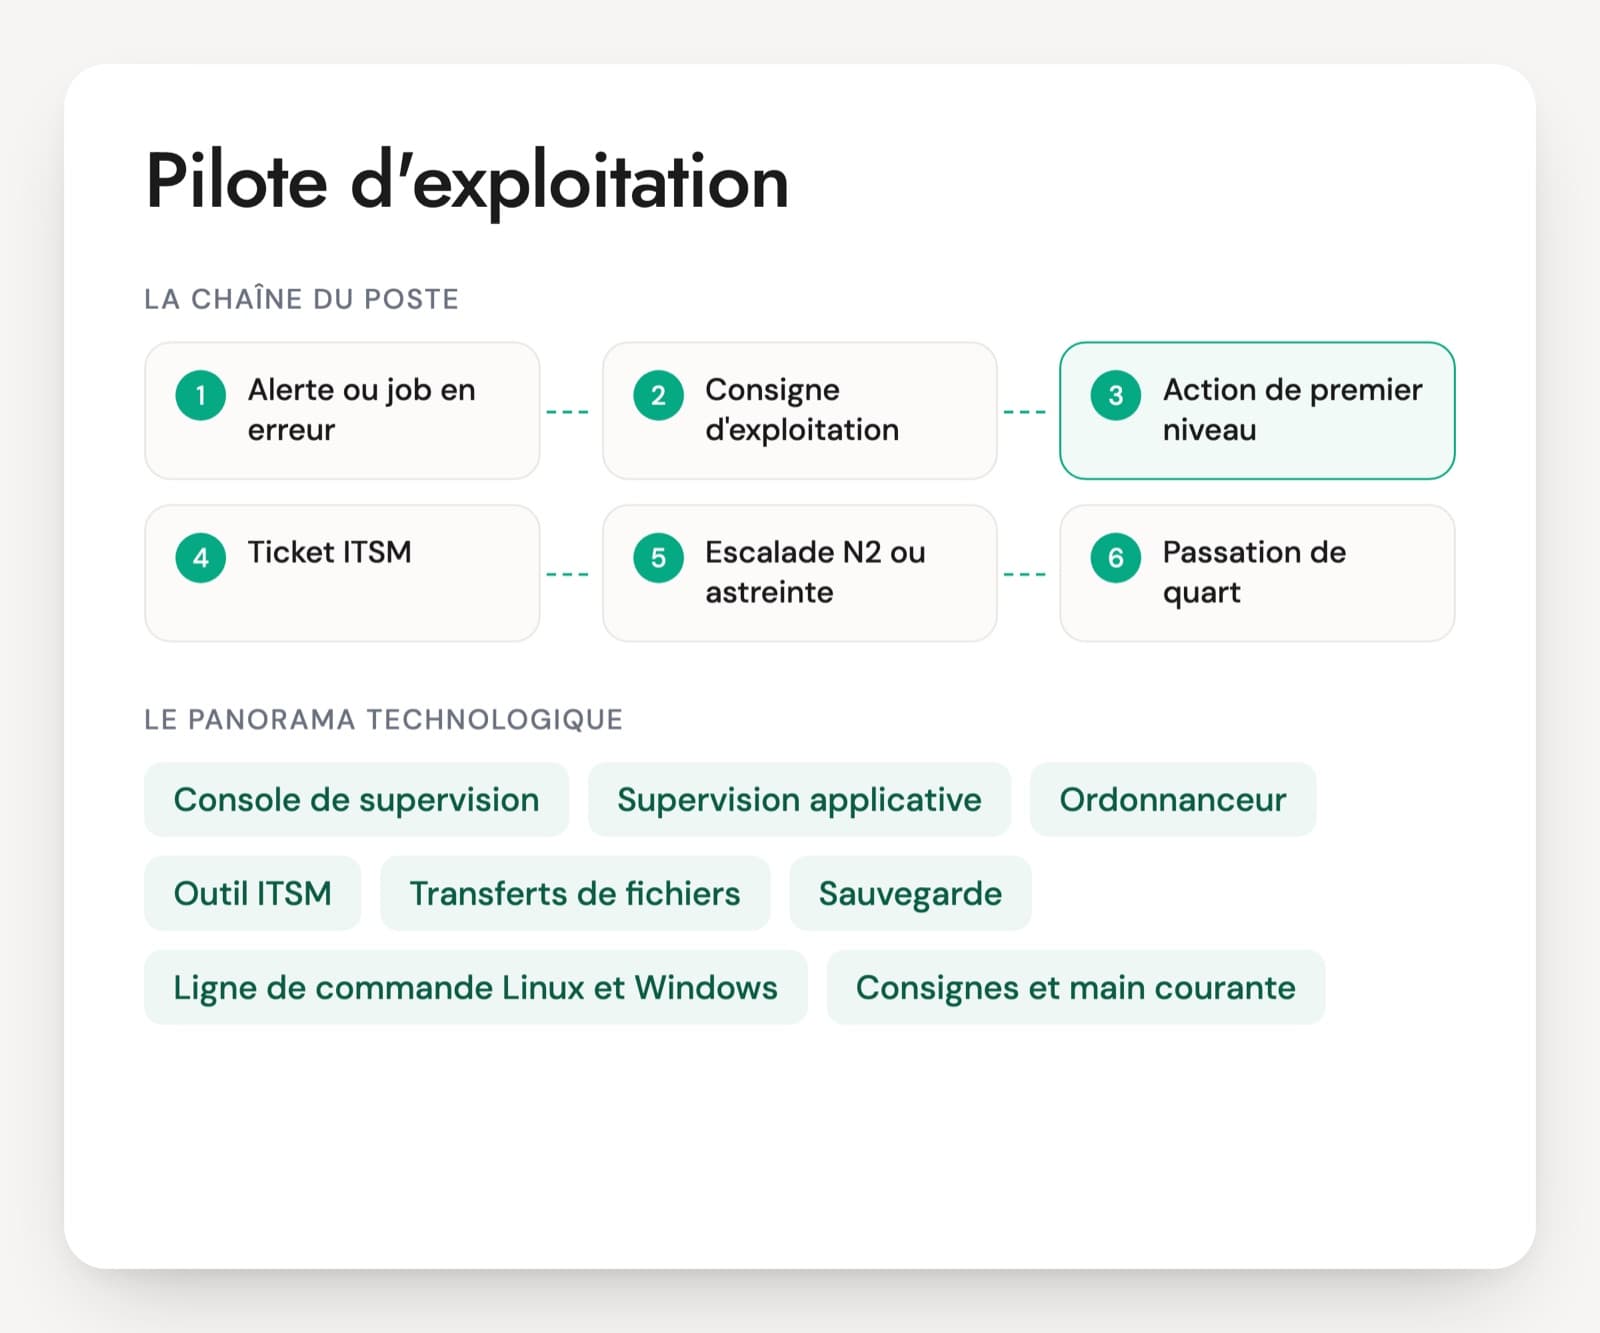
Un pilote d'exploitation tient la salle de pilotage, souvent la nuit et le week-end. Il surveille la console de supervision et l'ordonnanceur, relance les traitements que la consigne autorise, contrôle les sauvegardes et les transferts de fichiers, ouvre et escalade les tickets. Les offres citent Centreon, Zabbix ou Dynatrace pour la supervision, Control-M, VTOM ou Dollar Universe pour le batch, ServiceNow ou GLPI pour les tickets. Selon l'employeur, le rythme va du 3x8 à des horaires de jour décalés.
Le poste reste ouvert aux débutants, souvent après un BTS SIO ou un premier emploi de support. La discipline devant une alerte compte plus que la liste des outils : lire avant d'agir, suivre la consigne, écrire ce qui a été fait, appeler la bonne personne à la bonne heure. Un pilote qui force un job à OK pour débloquer la chaîne peut fausser les chiffres de toute une journée.
Le récit d'une nuit précise est parlant : la première alerte, la consigne appliquée, l'appel à l'astreinte, le contenu du ticket. Deux ou trois commandes Linux de base se tapent pendant l'entretien, df, tail ou systemctl. Un CV qui aligne beaucoup d'outils sans un seul geste détaillé mérite une question de plus sur ce que la personne a réellement fait seule.
Les consoles et outils d'une salle de pilotage
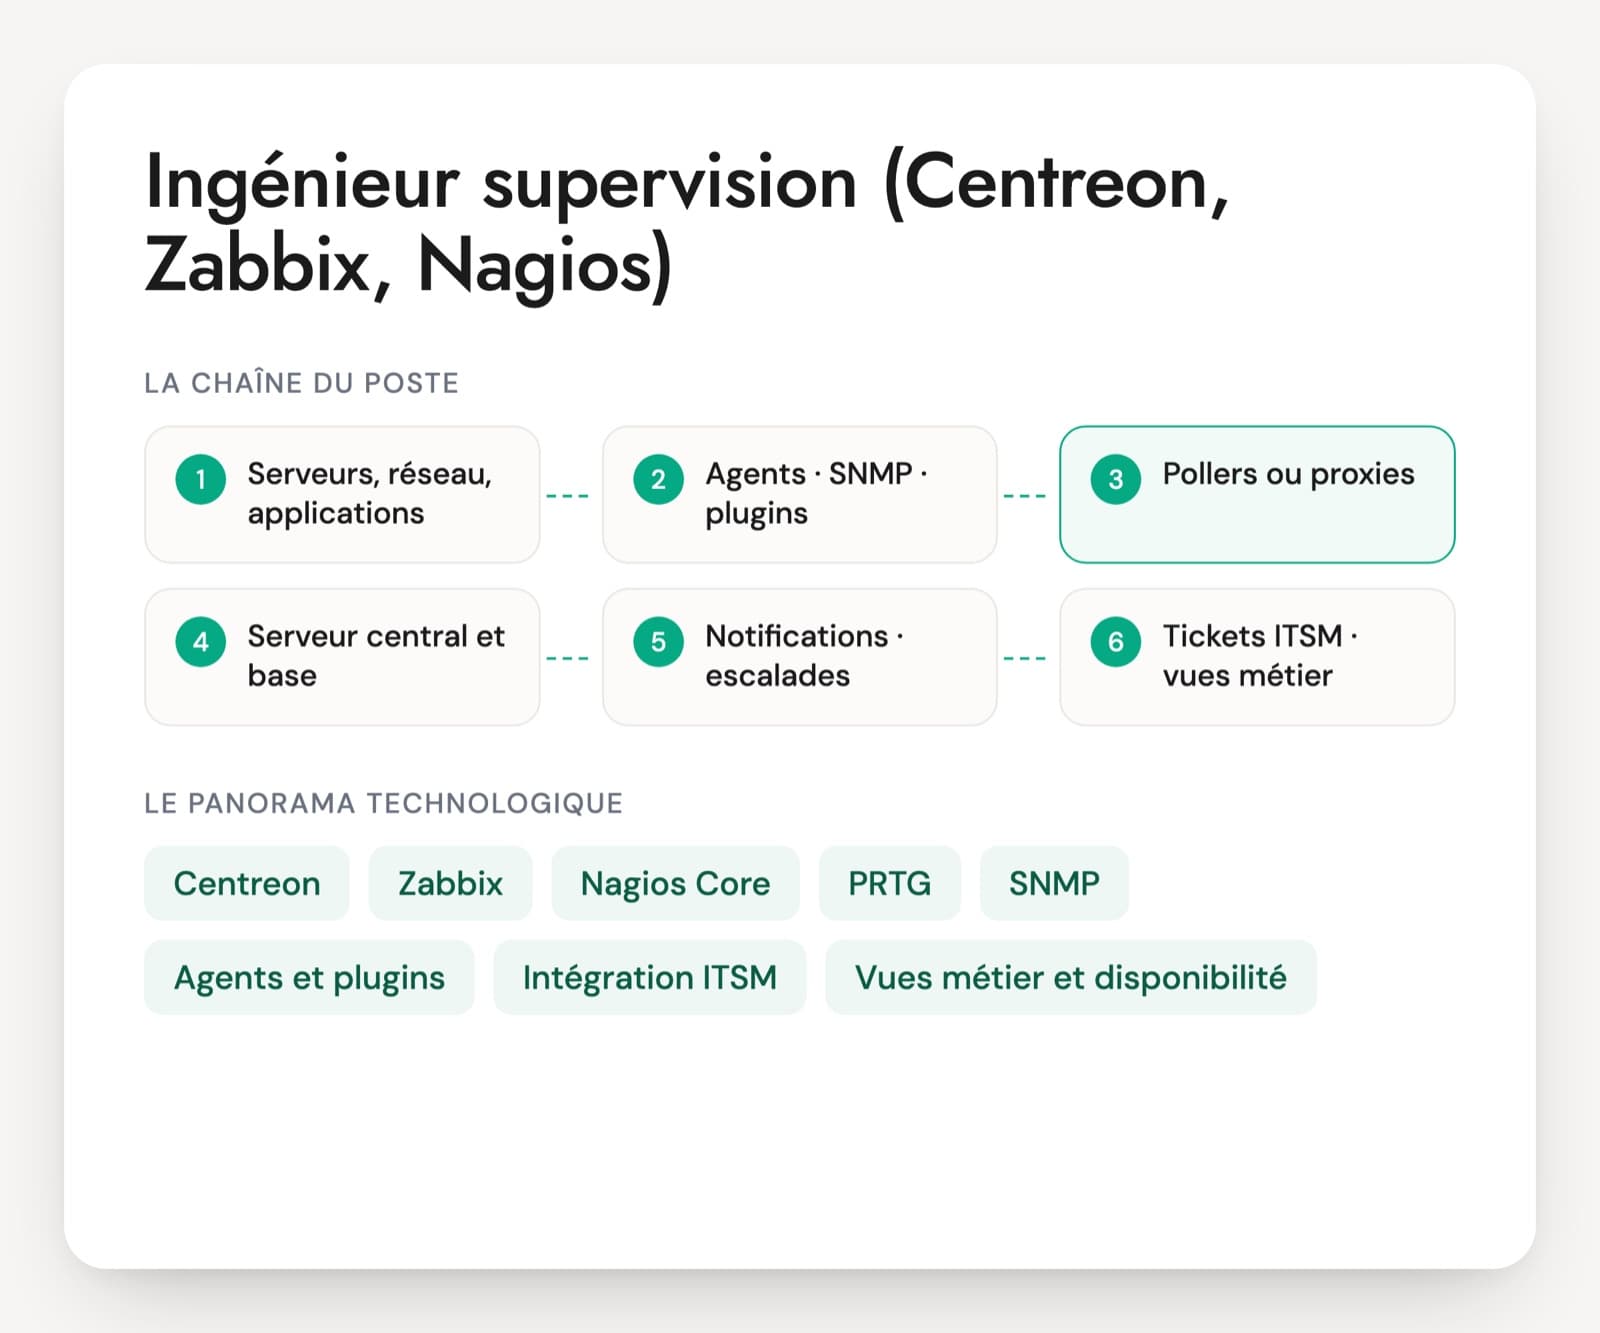
Console de supervision (Centreon, Zabbix, Nagios)
L'écran principal du pilote. Chaque ligne est un contrôle sur un serveur, un service ou un équipement, avec un état OK, WARNING ou CRITICAL. Le pilote acquitte, pose les maintenances prévues et applique la consigne liée à l'alerte. La configuration de l'outil revient à l'équipe supervision.
Supervision applicative (Dynatrace et équivalents)
Plusieurs offres de pilotage citent Dynatrace ou Grafana à côté de la supervision système. Ces outils montrent le temps de réponse d'une application et les erreurs vues par les utilisateurs. Le pilote doit savoir lire un problème ouvert par l'outil et retrouver l'application touchée.
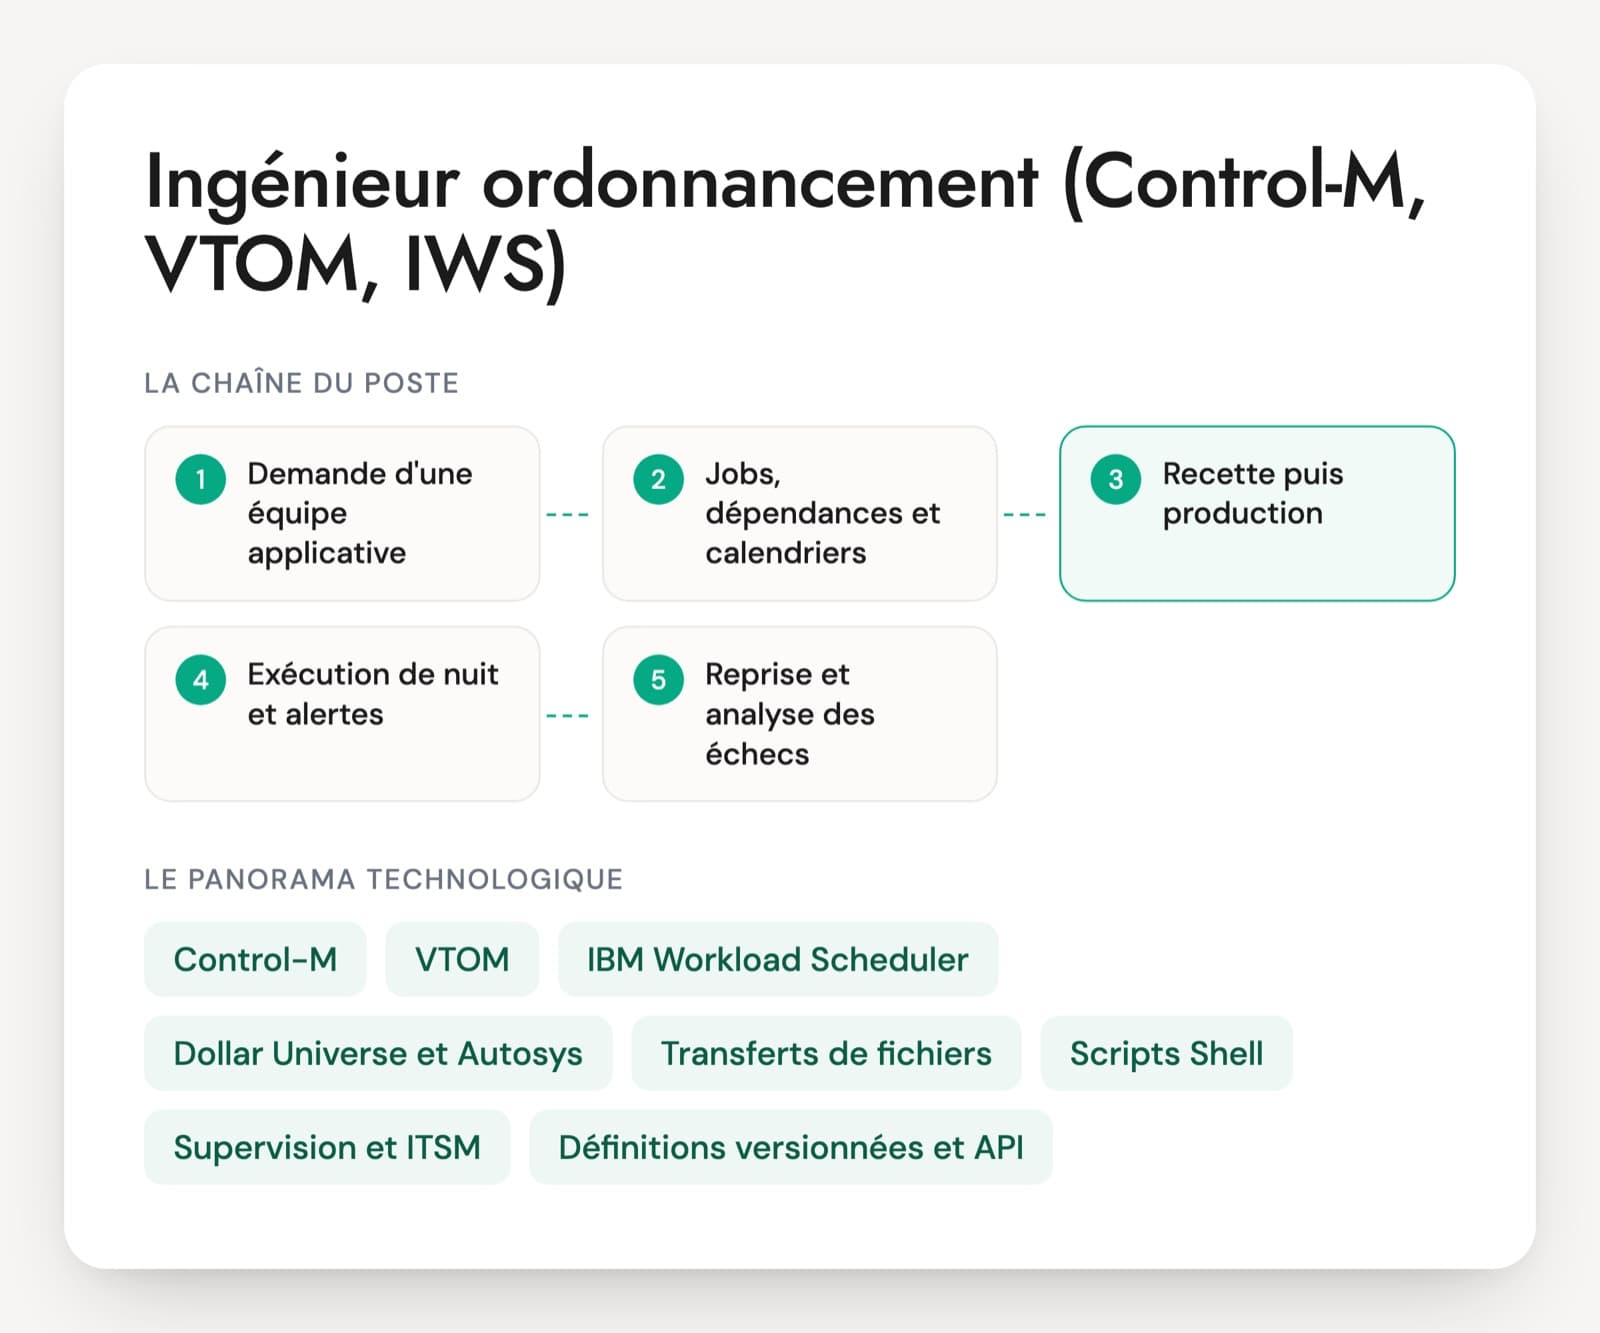
Ordonnanceur (Control-M, VTOM, Dollar Universe, IBM Workload Scheduler)
L'outil qui lance les traitements batch dans l'ordre, chaque nuit. Le pilote suit les chaînes, lit le journal d'un job en erreur, relance ou reprend à une étape selon la consigne, met en attente ou libère un job. Un pilote qui a connu un ordonnanceur prend vite en main un autre.
Outil ITSM (ServiceNow, GLPI, EasyVista)
Les incidents, demandes et changements y sont enregistrés. Le pilote crée le ticket, fixe la priorité avec la matrice impact et urgence, l'affecte au bon groupe et y note chaque action avec l'heure. Un ticket bien rempli fait gagner du temps à l'astreinte qu'il réveille.
Transferts de fichiers (Axway CFT, SFTP, outils MFT)
Les échanges de fichiers avec les partenaires et entre applications passent par un moniteur de transferts. Le pilote vérifie les transferts attendus, relève l'erreur d'un échec et relance selon la consigne, sans renvoyer un fichier déjà reçu.
Sauvegarde (Veeam, Commvault, NetBackup)
Le contrôle des sauvegardes de la nuit fait partie de la routine du matin. Le pilote lit les échecs et les avertissements, relance quand c'est prévu et lance parfois les restaurations de test planifiées. Les restaurations demandées par un utilisateur passent par une demande validée.
Ligne de commande Linux et Windows
Les consignes demandent souvent quelques commandes : df, du, tail, grep, systemctl ou journalctl sous Linux, Get-Service et l'observateur d'événements sous Windows. Le pilote n'administre pas les serveurs, mais il doit lancer ces commandes sans hésiter et comprendre leur résultat.
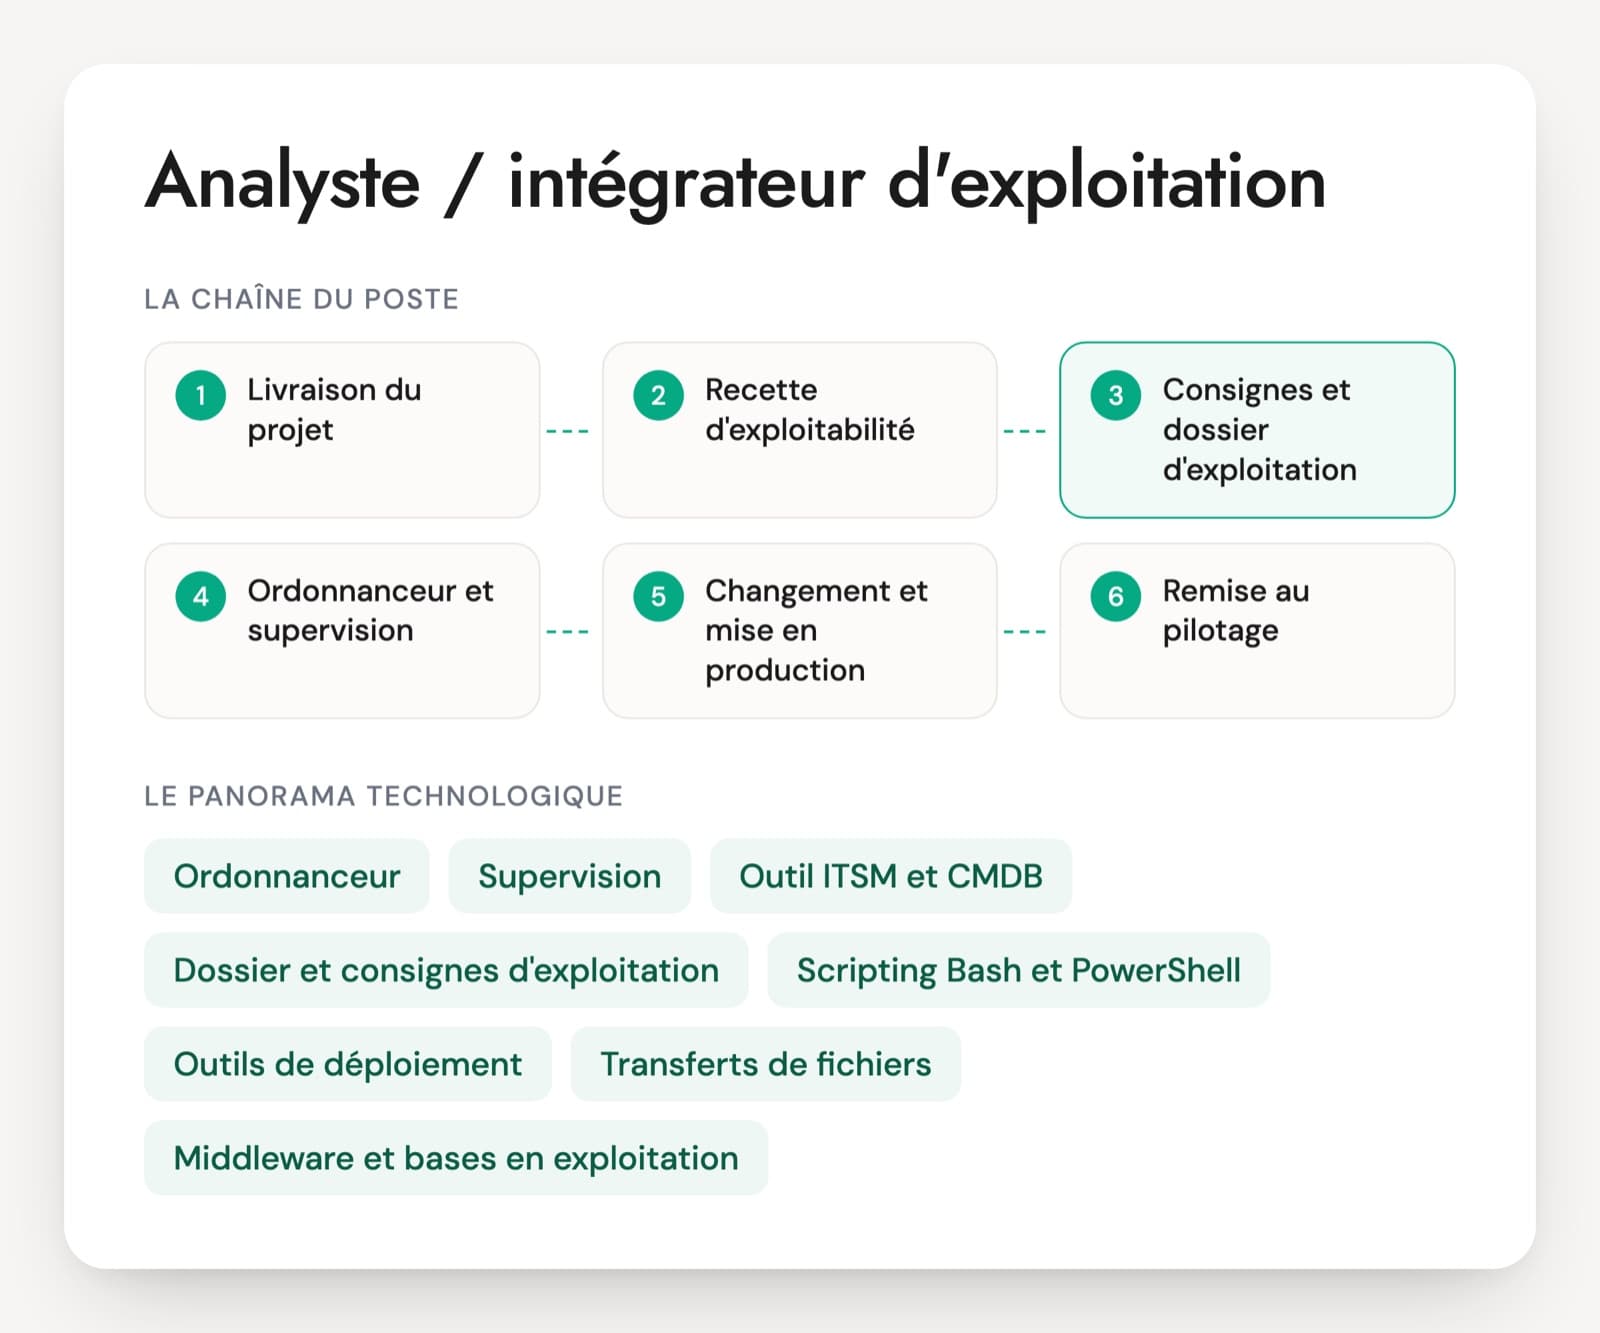
Consignes et main courante
La consigne d'exploitation dit quoi faire pour chaque alerte et chaque job : contrôles, relance autorisée, actions interdites, personne à appeler. La main courante garde la trace du quart et sert à la passation. Un bon pilote sait signaler une consigne fausse au lieu de la contourner.
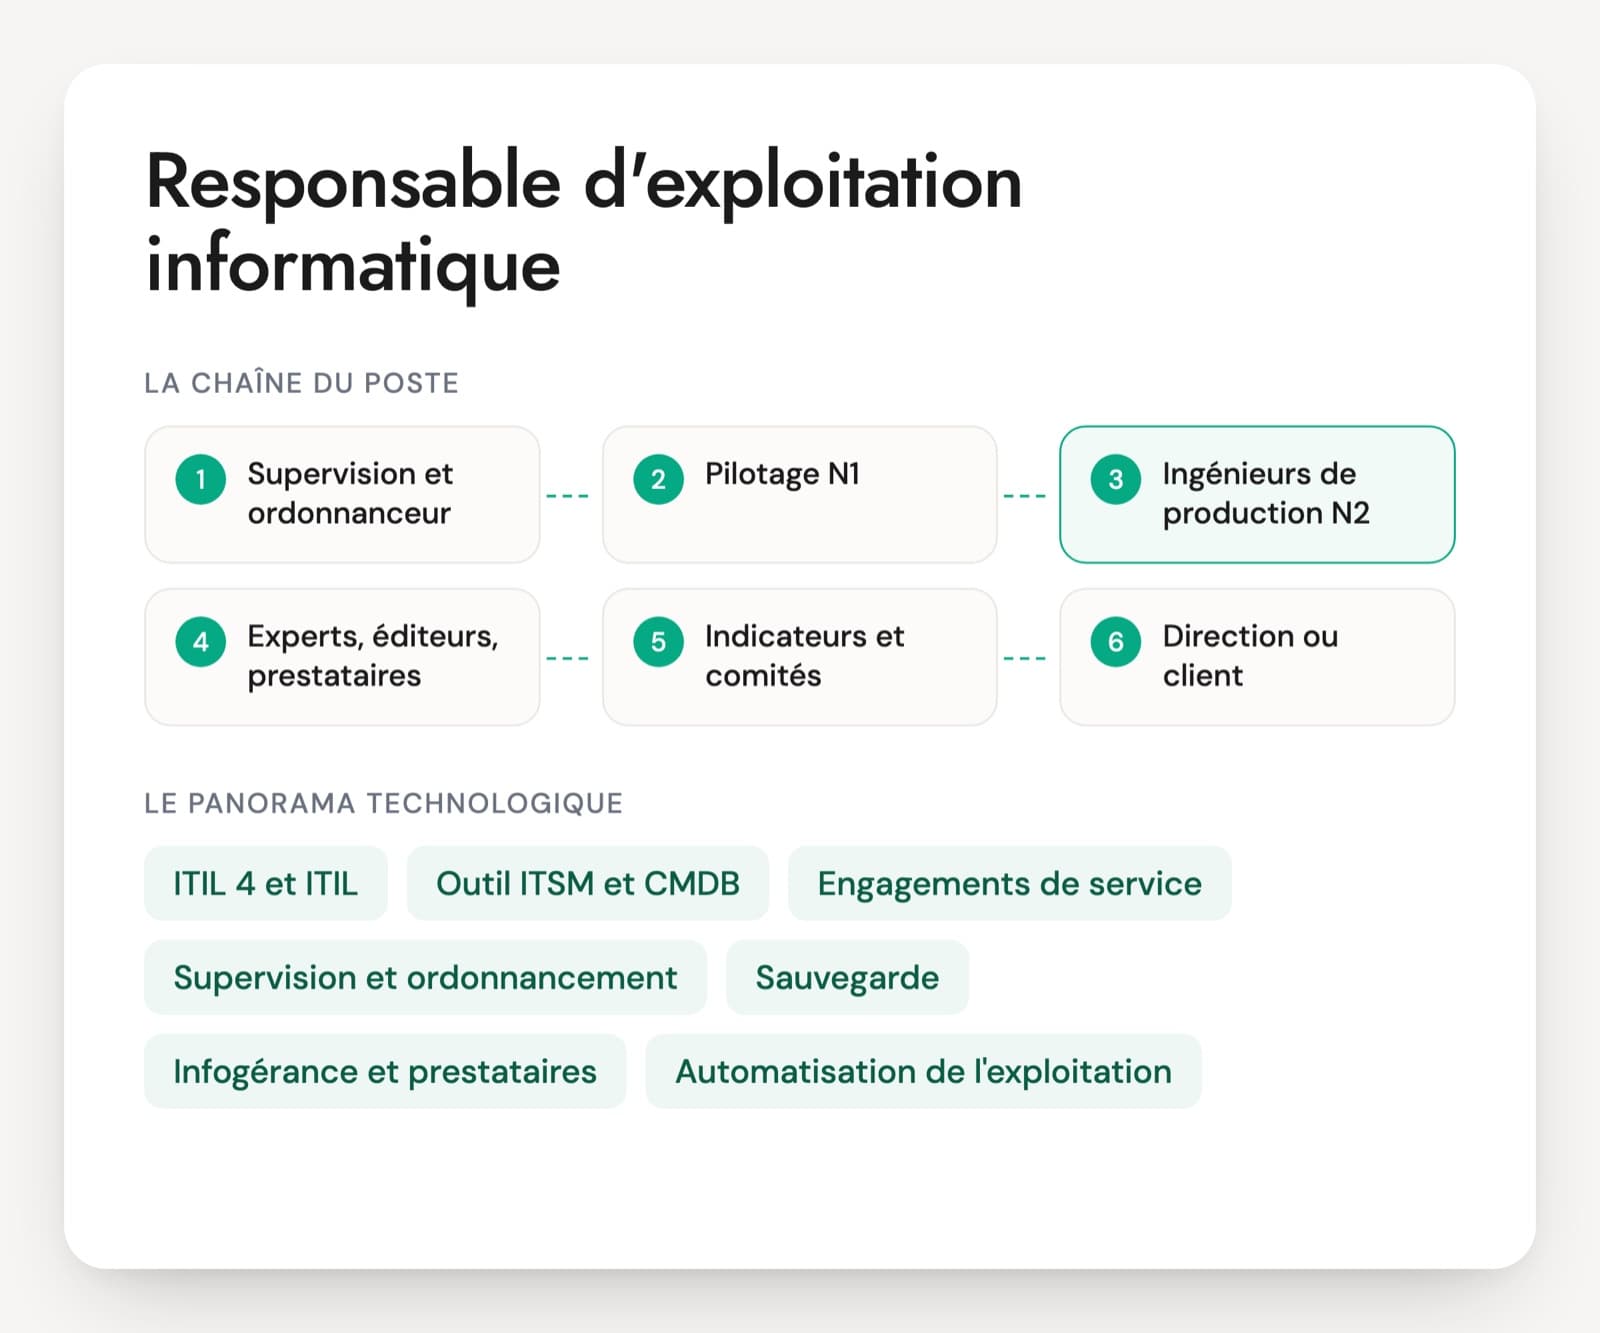
Le titre change d'une offre à l'autre : pilote d'exploitation, opérateur d'exploitation, technicien d'exploitation informatique, pilote d'exploitation et supervision, parfois pilote de production. Le contenu reste proche : surveillance, application de consignes, relance de traitements et premier diagnostic avant escalade. Certains postes sont en 3x8 avec des nuits et des week-ends, d'autres en horaires de jour décalés avec une astreinte. L'environnement technique dépend de l'employeur, du mainframe et de l'IBM i jusqu'aux applications sur Kubernetes, mais la méthode est la même. ITIL 4 Foundation apparaît parfois dans les offres ; elle montre que la personne connaît le vocabulaire des incidents et des changements, pas qu'elle sait tenir une nuit de production.
Les gestes techniques attendus d'un pilote d'exploitation
- Lecture et traitement des alertes de supervision
- Suivi, relance et reprise des chaînes batch
- Commandes Linux et Windows de premier niveau
- Tickets, priorités et escalade
- Contrôle des sauvegardes et des transferts
- Maintenances, changements et passation de quart
Cinq situations de nuit soumises en entretien
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · débutant à confirmé
À 3 h du matin, la console affiche une alerte critique sur un serveur de base de données. Que faites-vous dans les cinq premières minutes ?
Une bonne réponseIl lit l'alerte en entier : hôte, service, valeur remontée, heure de début. Il vérifie qu'aucune maintenance n'est déclarée sur ce serveur, cherche la consigne liée à cette alerte, l'acquitte pour montrer qu'elle est prise en charge et applique les contrôles prévus. Il ouvre ou complète le ticket avec l'heure de chaque action. Si la consigne prévoit l'appel de l'astreinte, il appelle tout de suite avec les faits relevés.
Signal d'alerteRedémarrer le service sans consigne, attendre que l'alerte disparaisse seule, ou l'acquitter sans rien écrire dans le ticket.
Question 2 · débutant à confirmé
Un job de la chaîne de nuit passe en erreur avec un code retour 12. La consigne indique « relance possible une fois ». Comment procédez-vous ?
Une bonne réponseIl lit d'abord le journal du job pour comprendre l'erreur et vérifier qu'elle correspond au cas prévu par la consigne (ressource indisponible, fichier verrouillé). Il contrôle que les jobs suivants n'ont pas démarré sur des données incomplètes. Il relance une seule fois, note l'heure et le résultat dans le ticket, puis escalade si le job échoue de nouveau.
Signal d'alerteRelancer plusieurs fois jusqu'à ce que ça passe, ou forcer le job à OK pour débloquer la suite sans l'accord de personne.
Question 3 · débutant à confirmé
Sur un serveur Linux, on vous signale un système de fichiers plein. Quelles commandes lancez-vous, et que vous autorisez-vous à faire ?
Une bonne réponsedf -h pour voir quel système de fichiers est plein, puis du -sh sur les répertoires ou find avec -size pour trouver ce qui grossit. Il identifie souvent des journaux. Il ne supprime que ce que la consigne autorise, par exemple des journaux archivés de plus de N jours, sinon il escalade. Un bon profil sait qu'un fichier supprimé mais encore ouvert par un processus garde sa place sur le disque.
Signal d'alerteUn rm -rf au hasard dans /var, ou un redémarrage du serveur pour « libérer de la place ».
Question 4 · débutant à confirmé
Vous escaladez un incident à l'astreinte N2 par téléphone à 4 h. Que doit contenir le ticket avant l'appel ?
Une bonne réponseL'élément touché (serveur, application, job), l'heure de début, le symptôme et le message d'erreur copié tel quel, les actions faites selon la consigne avec l'heure et le résultat, l'impact connu et la priorité. Au téléphone, il résume en quelques phrases et note dans le ticket l'heure de l'appel et le nom de la personne jointe.
Signal d'alerte« Ça ne marche pas » comme description, ou un appel passé sans ticket.
Question 5 · débutant à confirmé
Au contrôle du matin, trois sauvegardes de la nuit sont en échec dans la console Veeam ou Commvault. Que faites-vous ?
Une bonne réponseIl identifie les serveurs ou bases concernés et lit le message d'erreur : cible injoignable, dépôt plein, snapshot impossible. Il vérifie la date de la dernière sauvegarde réussie de chacun. Il relance si la consigne le prévoit et si la relance ne gêne pas la production, sinon il ouvre un ticket à l'équipe sauvegarde. Un deuxième échec de suite sur le même serveur est signalé comme plus grave.
Signal d'alerte« On verra si elle passe cette nuit », sans ticket ni vérification de la dernière sauvegarde réussie.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Pilote d'exploitation : les questions fréquentes
Pilote d'exploitation et technicien support : est-ce le même métier ?
Non. Le technicien support répond aux utilisateurs et règle leurs problèmes de poste ou de compte. Le pilote d'exploitation surveille les serveurs, les applications et les traitements batch, et il réagit d'abord à des alertes et à des jobs en erreur. Un technicien support peut évoluer vers le pilotage, à condition d'apprendre l'ordonnanceur, la ligne de commande Linux et la discipline des consignes. Ces trois points se vérifient avant de considérer son expérience comme équivalente.
Peut-on confier ce poste à un débutant ?
Oui, c'est souvent un premier poste en production. Un débutant doit connaître les bases de Linux et de Windows en ligne de commande, comprendre ce qu'est un traitement batch et savoir écrire un ticket clair. Le reste s'apprend avec les consignes et un binôme pendant les premières semaines. Mieux vaut ne pas le placer seul de nuit dès son arrivée, et l'entretien vérifie qu'il sait quand escalader au lieu d'agir seul.
Control-M ou Centreon sont-ils indispensables sur le CV ?
Rarement. Les ordonnanceurs et les consoles de supervision reposent sur les mêmes notions : un job, son état, ses prédécesseurs, une relance, une alerte acquittée ou en maintenance. Un pilote formé sur VTOM ou Dollar Universe prend en main Control-M en quelques semaines. Mieux vaut qu'il décrive comment il trouve pourquoi un job ne démarre pas. S'il répond avec les états et les dépendances, l'outil exact compte peu.
Comment évaluer un pilote d'exploitation pendant l'entretien ?
Une mise en situation de quinze à vingt minutes suffit, à la place d'un long test technique. Une nuit est décrite avec une alerte, un job en erreur et une sauvegarde en échec, et la personne dit dans quel ordre elle agit et ce qu'elle écrit dans le ticket. Deux ou trois commandes Linux à commenter complètent l'exercice. On voit vite qui lit avant d'agir et qui relance par réflexe.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.