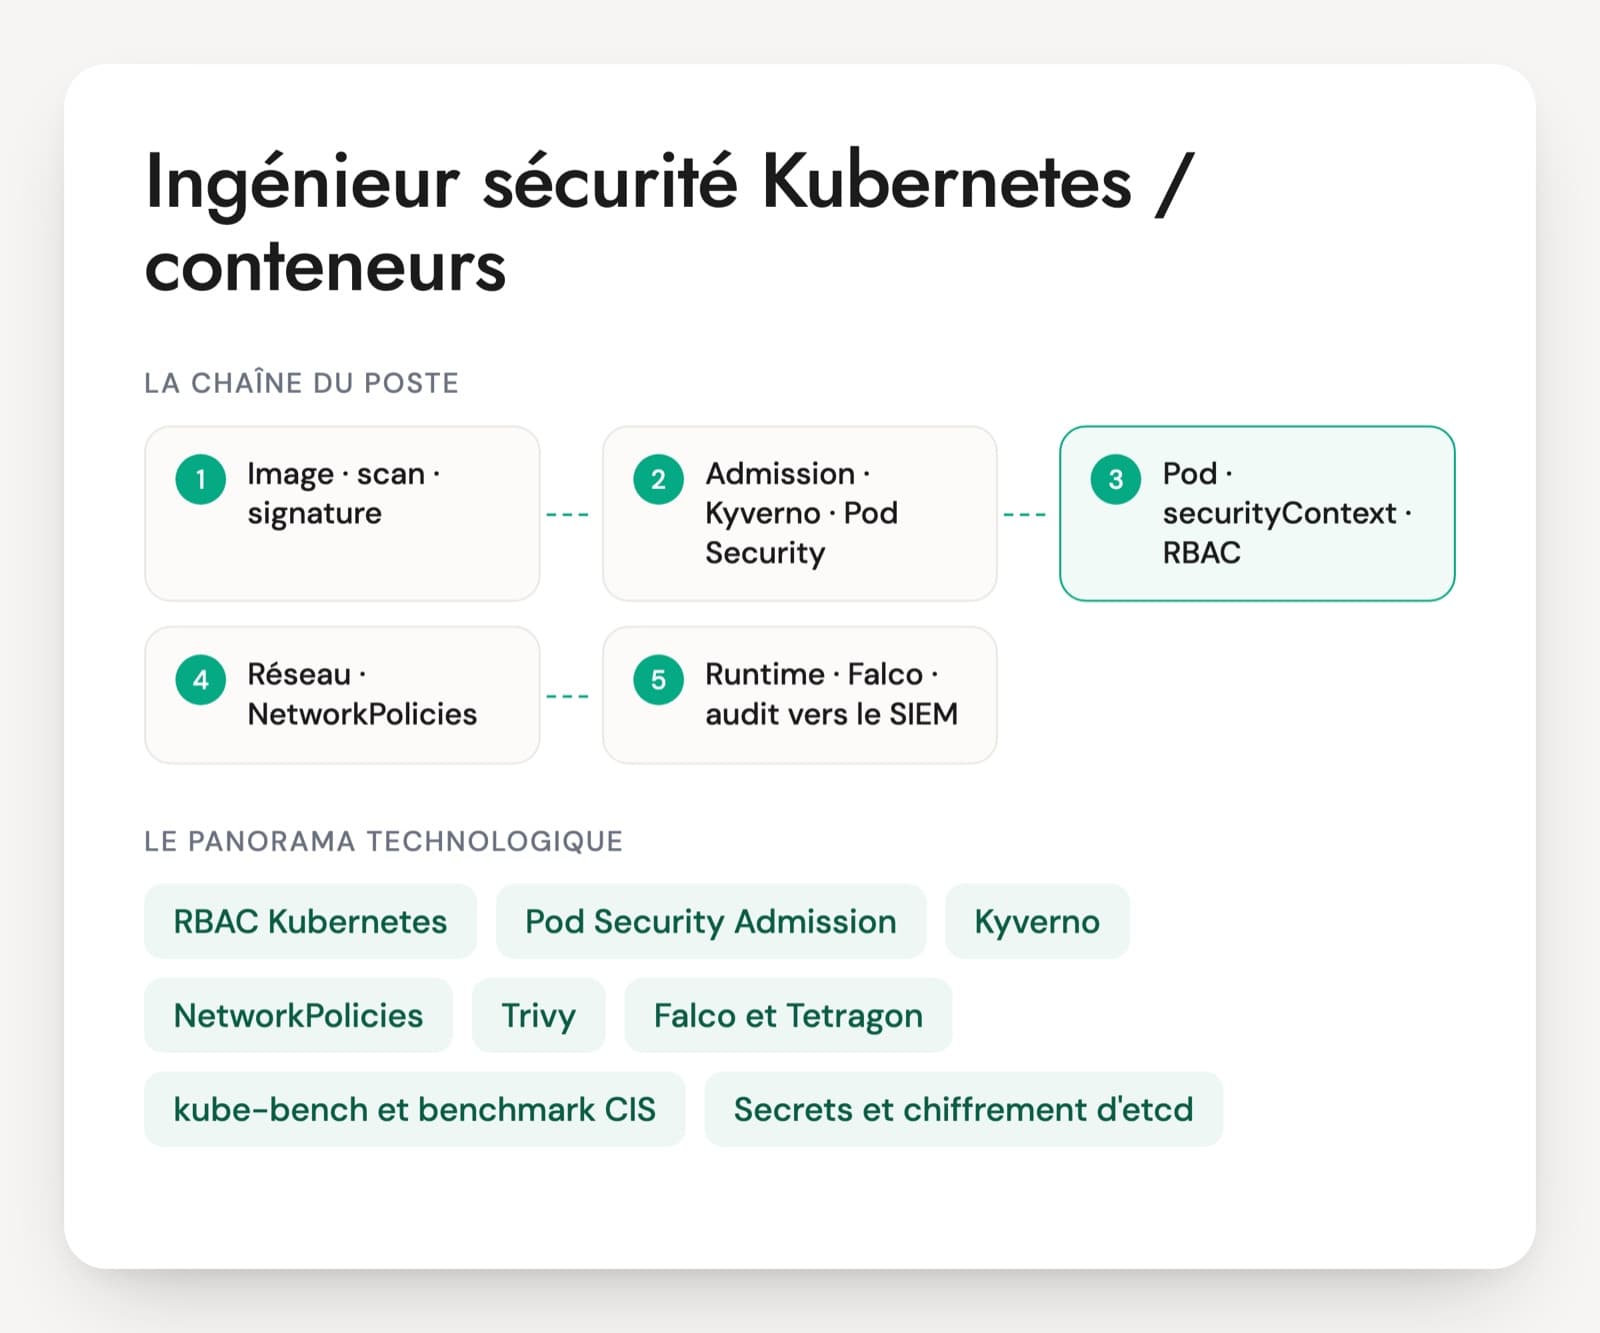
Le poste porte plusieurs titres dans les offres françaises : expert sécurité Kubernetes, expert sécurité OpenShift et conteneurs, ingénieur sécurité conteneurs. Les compétences demandées se recoupent : RBAC, benchmark CIS, scan et signature des images, politiques d'admission avec Kyverno ou OPA Gatekeeper, NetworkPolicies, détection au runtime, journaux d'audit envoyés au SIEM. Les questions d'entretien d'un ingénieur sécurité Kubernetes doivent couvrir ce périmètre, de l'image jusqu'au nœud.
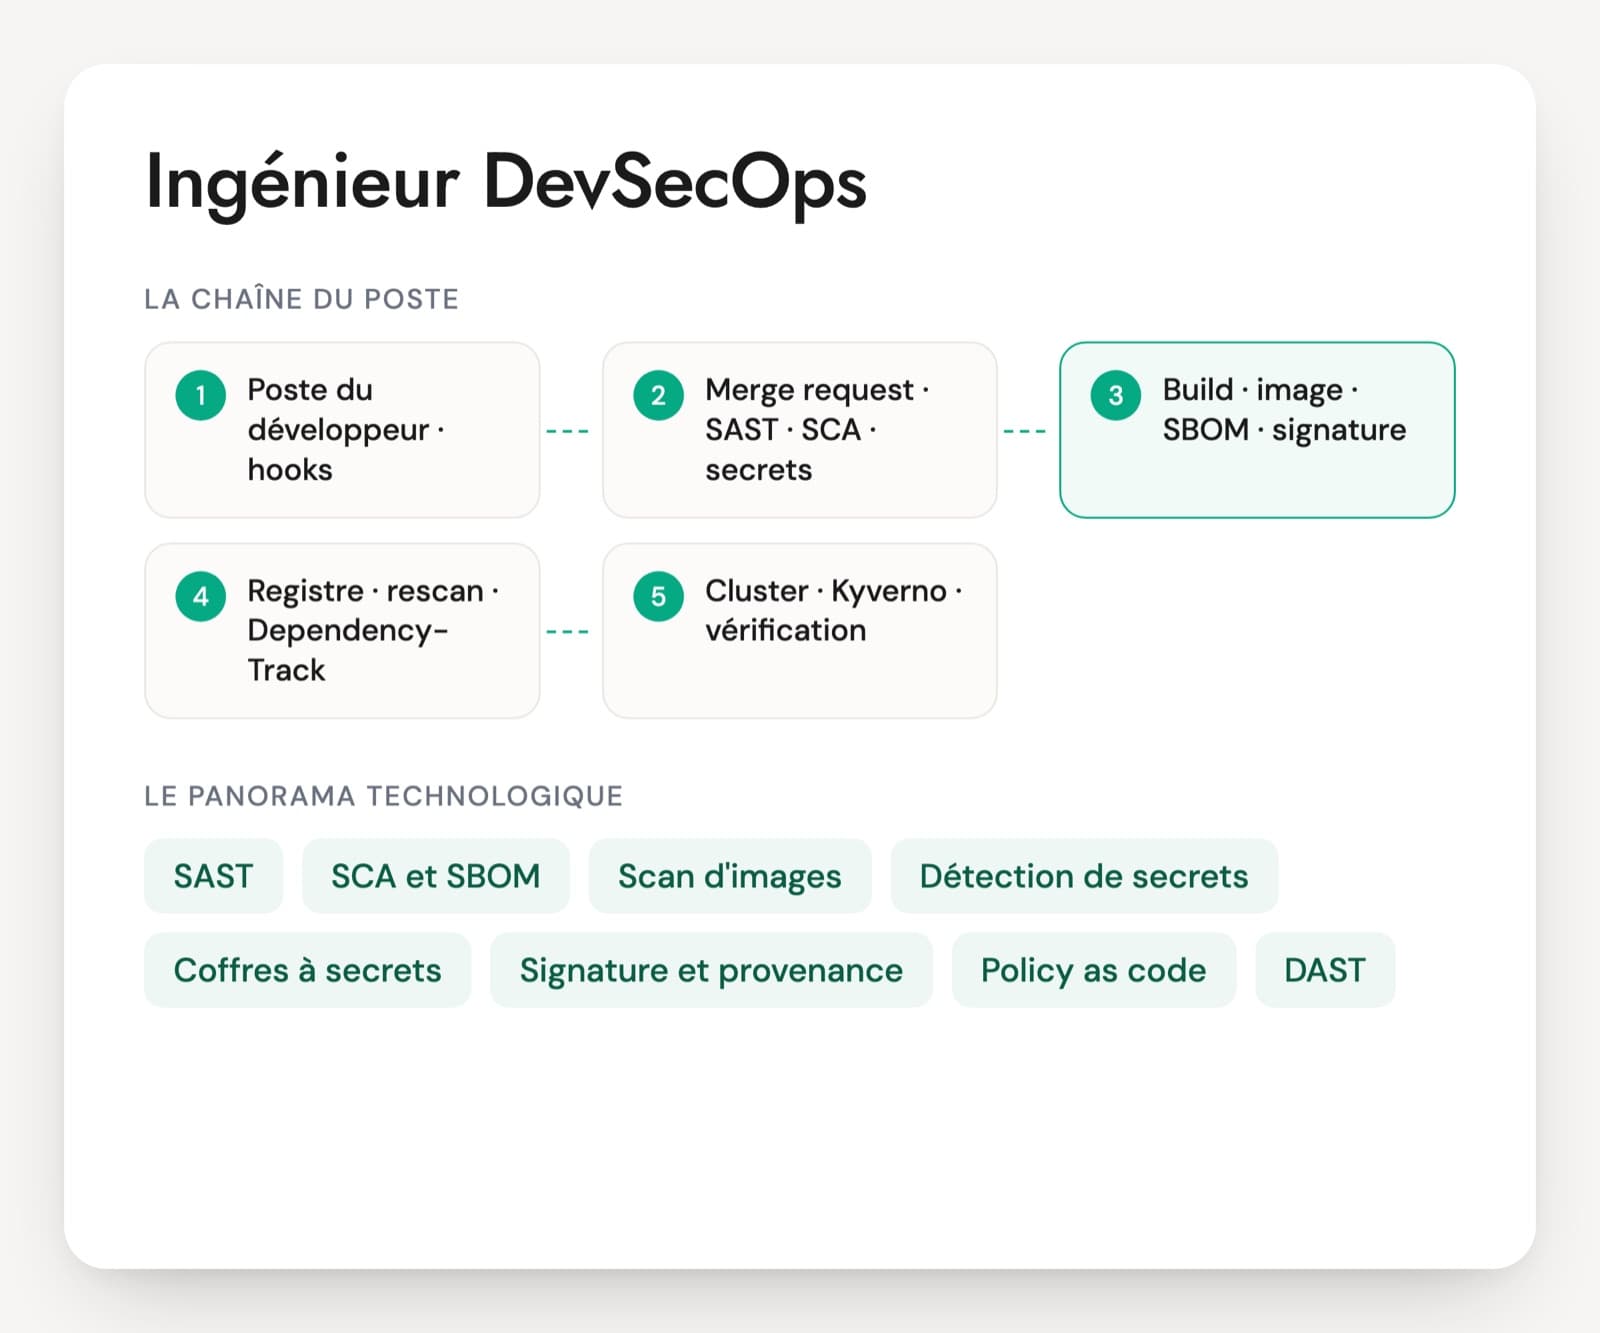
La frontière avec l'ingénieur DevSecOps passe par le cluster. Le DevSecOps sécurise la chaîne qui produit l'image. L'ingénieur sécurité Kubernetes répond de ce que l'image a le droit de faire une fois déployée, et de ce qui arrive si elle est compromise. La personne explique comment un pod peut prendre le contrôle d'un nœud : la réponse montre vite si la personne a déjà durci un cluster ou seulement révisé la CKS.
L'actualité a changé les priorités. En mars 2025, la faille CVE-2025-1974 d'ingress-nginx permettait d'exécuter du code via le webhook d'admission du contrôleur, joignable depuis les pods. En novembre 2025, le projet Kubernetes a annoncé la fin d'ingress-nginx, sans correctif de sécurité après mars 2026. L'état de la migration vers Gateway API ou un autre contrôleur compte aussi.
Outils de sécurité d'un cluster, de l'image au nœud
RBAC Kubernetes
Les droits sur l'API du cluster, donnés par des Roles et ClusterRoles liés à des utilisateurs, des groupes ou des comptes de service. Les erreurs courantes sont des jokers, la lecture des Secrets donnée trop largement et des verbes comme escalate, bind ou impersonate laissés à des équipes. Le candidat doit savoir lire un binding et dire ce qu'il permet vraiment.
Pod Security Admission
Le contrôle intégré qui applique trois niveaux de sécurité des pods (privileged, baseline, restricted), namespace par namespace, en mode blocage, audit ou avertissement. Il a remplacé PodSecurityPolicy, retiré en version 1.25. Sur OpenShift, les Security Context Constraints jouent ce rôle.
Kyverno, OPA Gatekeeper et ValidatingAdmissionPolicy
Les moteurs de politiques d'admission, qui acceptent ou refusent une ressource avant sa création. Kyverno écrit ses règles en YAML, Gatekeeper en Rego, et ValidatingAdmissionPolicy, natif et stable depuis Kubernetes 1.30, en CEL. Les annonces citent surtout Kyverno et Gatekeeper.
NetworkPolicies, Cilium et Calico
Par défaut, tous les pods d'un cluster se parlent. Les NetworkPolicies filtrent ce trafic par label et par namespace, à condition que le plugin réseau les applique. Cilium et Calico ajoutent des politiques à l'échelle du cluster, par nom de domaine ou au niveau HTTP, et le chiffrement entre nœuds.
Trivy, Grype et Cosign
Trivy et Grype listent les vulnérabilités connues des images et des manifestes. Cosign, du projet Sigstore, signe les images après le build, et une politique d'admission vérifie la signature avant le déploiement. Sur ce poste, la question porte moins sur le scan que sur ce que le cluster refuse.
Falco et Tetragon
La détection au runtime : ces outils observent les appels système des conteneurs, par eBPF, et alertent sur un shell ouvert, un fichier sensible lu ou une connexion sortante anormale. Falco alerte, Tetragon peut aussi bloquer. Leur intérêt dépend du réglage des règles et de qui reçoit les alertes.
kube-bench et benchmark CIS
Le CIS publie un benchmark de configuration pour Kubernetes : API server, etcd, kubelet, fichiers de configuration. kube-bench vérifie un cluster par rapport à ce référentiel. Sur un cluster managé, une partie des contrôles relève du fournisseur, et il existe des variantes du benchmark pour EKS, AKS et GKE.
Secrets et chiffrement d'etcd
Un Secret Kubernetes est encodé en base64, pas chiffré. Le chiffrement au repos dans etcd se configure sur l'API server, de préférence avec un KMS externe. Beaucoup d'équipes rangent les secrets hors du cluster, dans Vault ou le coffre du cloud, et les injectent avec External Secrets Operator ou le pilote CSI.
Le poste dépend de l'équipe sécurité ou de l'équipe plateforme, et le périmètre change selon le type de cluster. Sur EKS, AKS ou GKE, le fournisseur durcit le plan de contrôle et le travail porte sur les charges, le lien avec l'IAM du cloud et la configuration des nœuds. Sur un cluster auto-hébergé ou OpenShift, il faut aussi tenir etcd, les certificats, le kubelet et les montées de version. Les missions en ESN mêlent souvent audit, rédaction de règles et accompagnement des équipes applicatives. La certification CKS, de la Linux Foundation, se passe en deux heures sur de vrais clusters, demande d'avoir réussi la CKA et reste valable deux ans. C'est un bon signe de pratique, pas une preuve d'exploitation en production.
Ce qu'un ingénieur sécurité Kubernetes doit pouvoir démontrer
- RBAC et comptes de service
- Sécurité des pods et admission
- Isolation réseau et exposition
- Images et signatures au déploiement
- Détection au runtime et audit
- Durcissement du cluster et des nœuds
Cinq failles de configuration à faire analyser en entretien
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · senior
Un développeur a seulement le droit de créer des pods dans son namespace. Pourquoi est-ce déjà beaucoup, et que limitez-vous ?
Une bonne réponseCréer un pod permet de lui attacher n'importe quel compte de service du namespace, donc d'en récupérer les droits, et de lire tout Secret monté dans ce pod. Sans contrôle d'admission, c'est aussi lancer un pod privilégié ou monter un répertoire du nœud pour en sortir. Il limite avec Pod Security Admission en baseline ou restricted, des comptes de service sans droits et sans montage automatique du jeton, et réserve la création de pods en production à la CI.
Signal d'alerte« Il ne peut que créer des pods, il n'a pas accès aux Secrets. » C'est faux dès qu'il crée un pod qui monte un Secret du namespace.
Question 2 · confirmé
Vous passez un cluster existant de 60 namespaces au niveau restricted de Pod Security Admission. Comment procédez-vous ?
Une bonne réponseD'abord les modes warn et audit, posés par label sur les namespaces, pour voir les pods qui violeraient le niveau sans rien bloquer. Il fait corriger les manifestes (runAsNonRoot, pas d'élévation de privilèges, capabilities retirées, profil seccomp RuntimeDefault), laisse baseline ou privileged aux seuls composants système qui en ont besoin, puis passe enforce namespace par namespace. Il fixe la version du niveau pour qu'une montée de Kubernetes ne change pas les règles en silence.
Signal d'alertePasser enforce sur tous les namespaces d'un coup, ou ignorer que les pods déjà lancés ne sont pas arrêtés : seules les nouvelles créations sont refusées.
Question 3 · confirmé
Le pod d'une application web est compromis. Qu'est-ce qui l'empêche de joindre la base de données d'une autre équipe dans le même cluster ?
Une bonne réponsePar défaut, rien : tous les pods se parlent. Il faut des NetworkPolicies, avec un refus par défaut en entrée et en sortie dans chaque namespace, puis des autorisations explicites par label, DNS compris. Elles n'ont d'effet que si le plugin réseau les applique, comme Calico ou Cilium. Il coupe aussi l'accès à l'API de métadonnées du cloud, et utilise les politiques à l'échelle du cluster de Cilium ou Calico pour les règles que les équipes ne doivent pas pouvoir retirer.
Signal d'alerte« Ils sont dans des namespaces différents, donc isolés. » Un namespace ne filtre aucun trafic.
Question 4 · senior
Kyverno doit refuser toute image non signée par votre CI. Que se passe-t-il le jour où le registre ou le contrôleur d'admission ne répond plus ?
Une bonne réponseTout dépend de la politique d'échec du webhook. En Fail, plus aucun pod concerné ne démarre, même pendant un incident. En Ignore, les images non vérifiées passent. Il choisit Fail pour la production, exclut les namespaces système, fait tourner plusieurs réplicas du contrôleur sur des nœuds différents et alerte sur ses erreurs. Il vérifie les signatures par digest, pas par tag.
Signal d'alertePasser le webhook en Ignore le jour où il gêne et l'oublier, ou ignorer qu'un webhook indisponible peut bloquer le cluster.
Question 5 · confirmé
Falco signale un shell interactif ouvert dans un conteneur de production. Que faites-vous ?
Une bonne réponseIl lit d'abord le contexte de l'alerte : pod, image, utilisateur, processus parent, puis les journaux d'audit de l'API pour voir s'il s'agit d'un kubectl exec légitime. Si rien ne l'explique, il isole le pod par une NetworkPolicy ou en retirant le label qui le relie au Service, le garde en vie pour l'analyse, et regarde le compte de service et les Secrets accessibles depuis ce pod. Ensuite il cherche le point d'entrée.
Signal d'alerteSupprimer le pod tout de suite : le Deployment en recrée un propre et les traces disparaissent. Ou ignorer l'alerte parce que « Falco fait beaucoup de bruit ».
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Ingénieur sécurité Kubernetes : réponses aux questions fréquentes
Comment séparer ce poste de celui d'ingénieur DevSecOps ?
Le critère est l'endroit où se trouvent les risques à traiter. Si les problèmes sont dans les pipelines, les dépendances et la fabrication des images, c'est un poste d'ingénieur DevSecOps. S'ils sont dans les clusters, avec des droits trop larges, des pods privilégiés, aucun filtrage réseau ni détection, c'est un poste d'ingénieur sécurité Kubernetes. Les deux se rejoignent sur la signature des images et les politiques d'admission. Dans une petite équipe, un seul profil couvre souvent les deux, mais il penche presque toujours d'un côté.
La CKS prouve-t-elle qu'un candidat sait sécuriser un cluster ?
Elle prouve davantage que la plupart des certifications, car l'examen se passe sur de vrais clusters, en deux heures, avec des configurations à corriger. Elle couvre le durcissement du cluster et du système, la sécurité des microservices, la chaîne d'approvisionnement et la détection au runtime. Elle ne montre pas comment la personne déploie une règle sur soixante namespaces sans casser la production, ni comment elle traite une alerte réelle. Ces deux questions trouvent leur place en entretien.
À quoi ressemble un bon test technique de sécurité Kubernetes ?
Un cluster de test, kind ou minikube, avec quelques défauts volontaires : un compte de service lié à cluster-admin, un pod privilégié qui monte le socket du runtime, aucun filtrage réseau, des Secrets non chiffrés. Le candidat dispose de trois quarts d'heure pour trouver les défauts, expliquer comment les exploiter et proposer les corrections. Il commente à voix haute. La manière de prioriser compte plus que le nombre de défauts trouvés.
Un profil OpenShift convient-il pour un poste Kubernetes, et l'inverse ?
Oui, avec un temps d'adaptation. OpenShift applique d'office des règles strictes, par les Security Context Constraints et des conteneurs qui ne tournent pas en root par défaut. Un profil OpenShift doit donc apprendre à poser lui-même ce que la plateforme lui donnait, comme Pod Security Admission ou un moteur de politiques. Dans l'autre sens, un profil Kubernetes découvre les SCC, les routes et l'authentification intégrée. La distribution sur laquelle la personne a vraiment exploité des clusters compte.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.