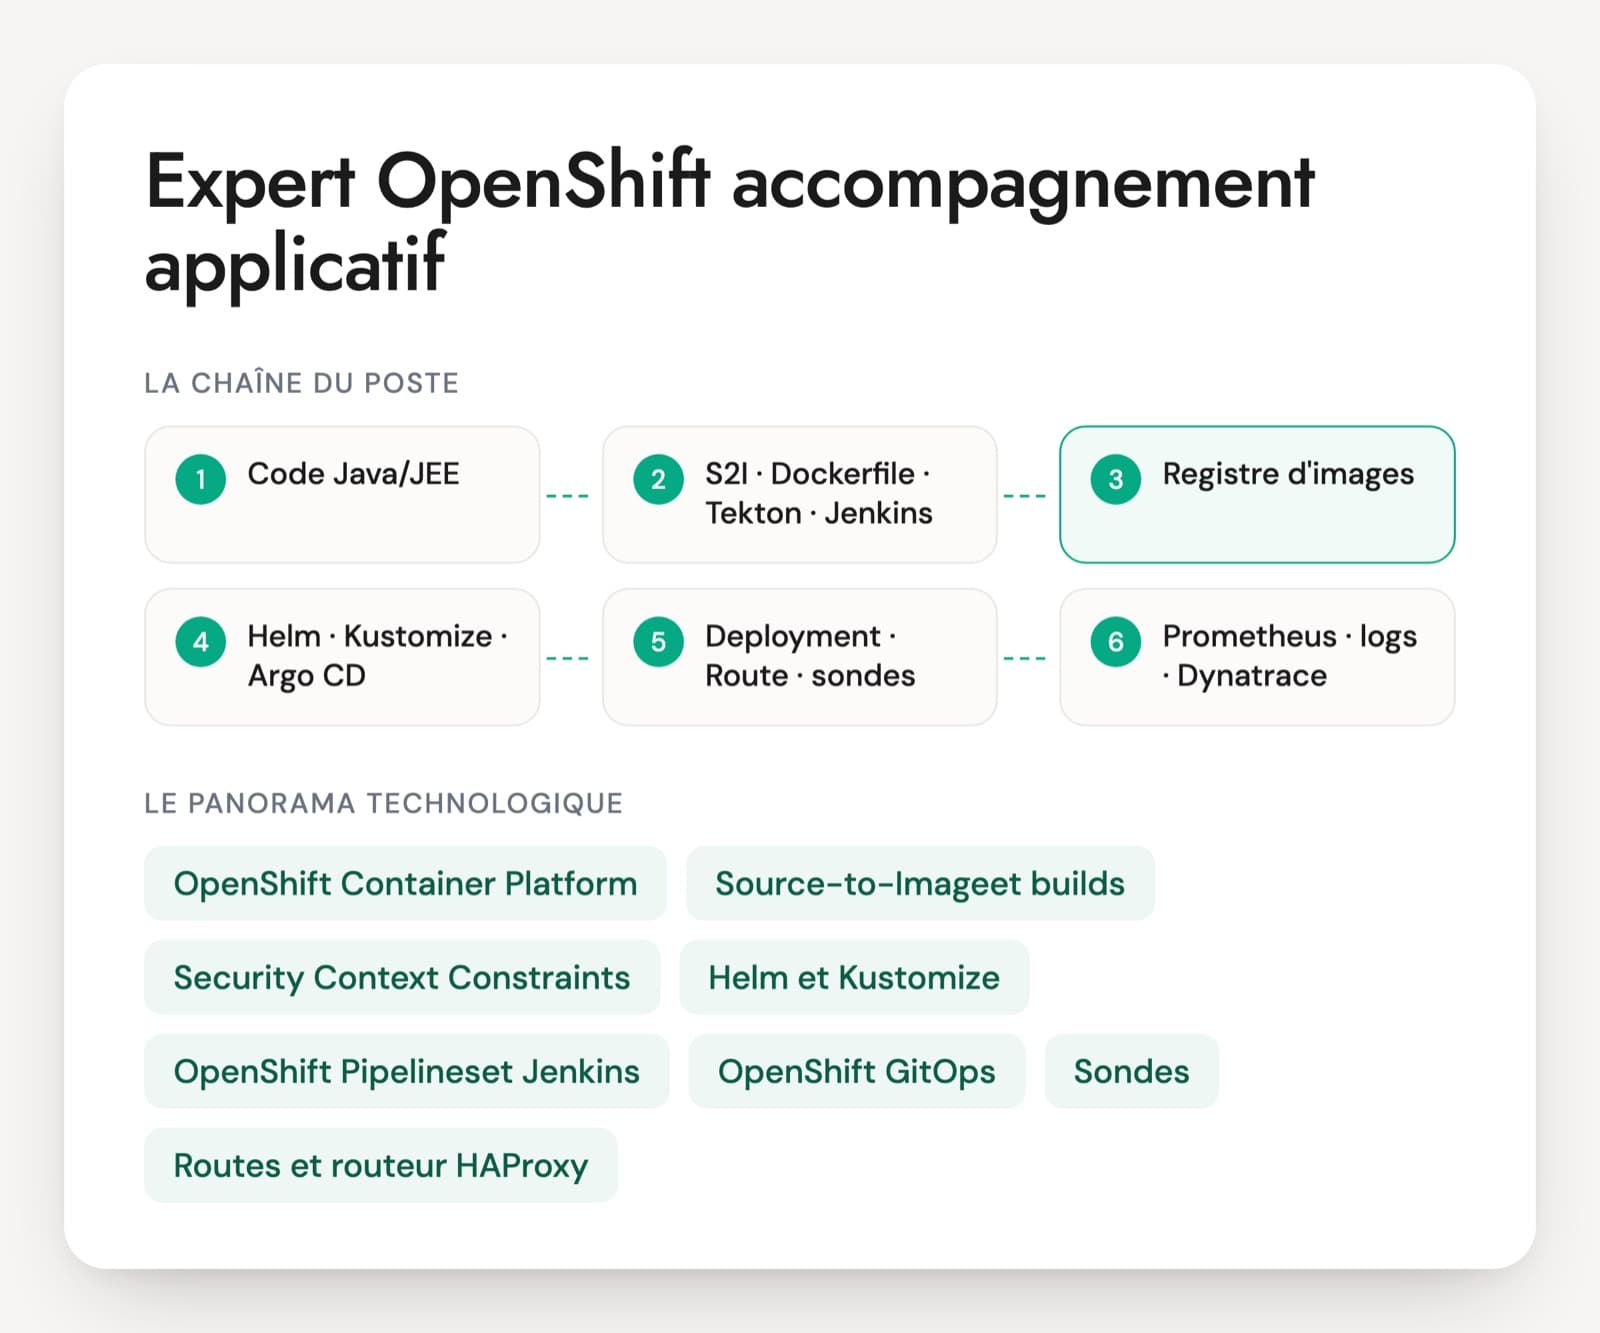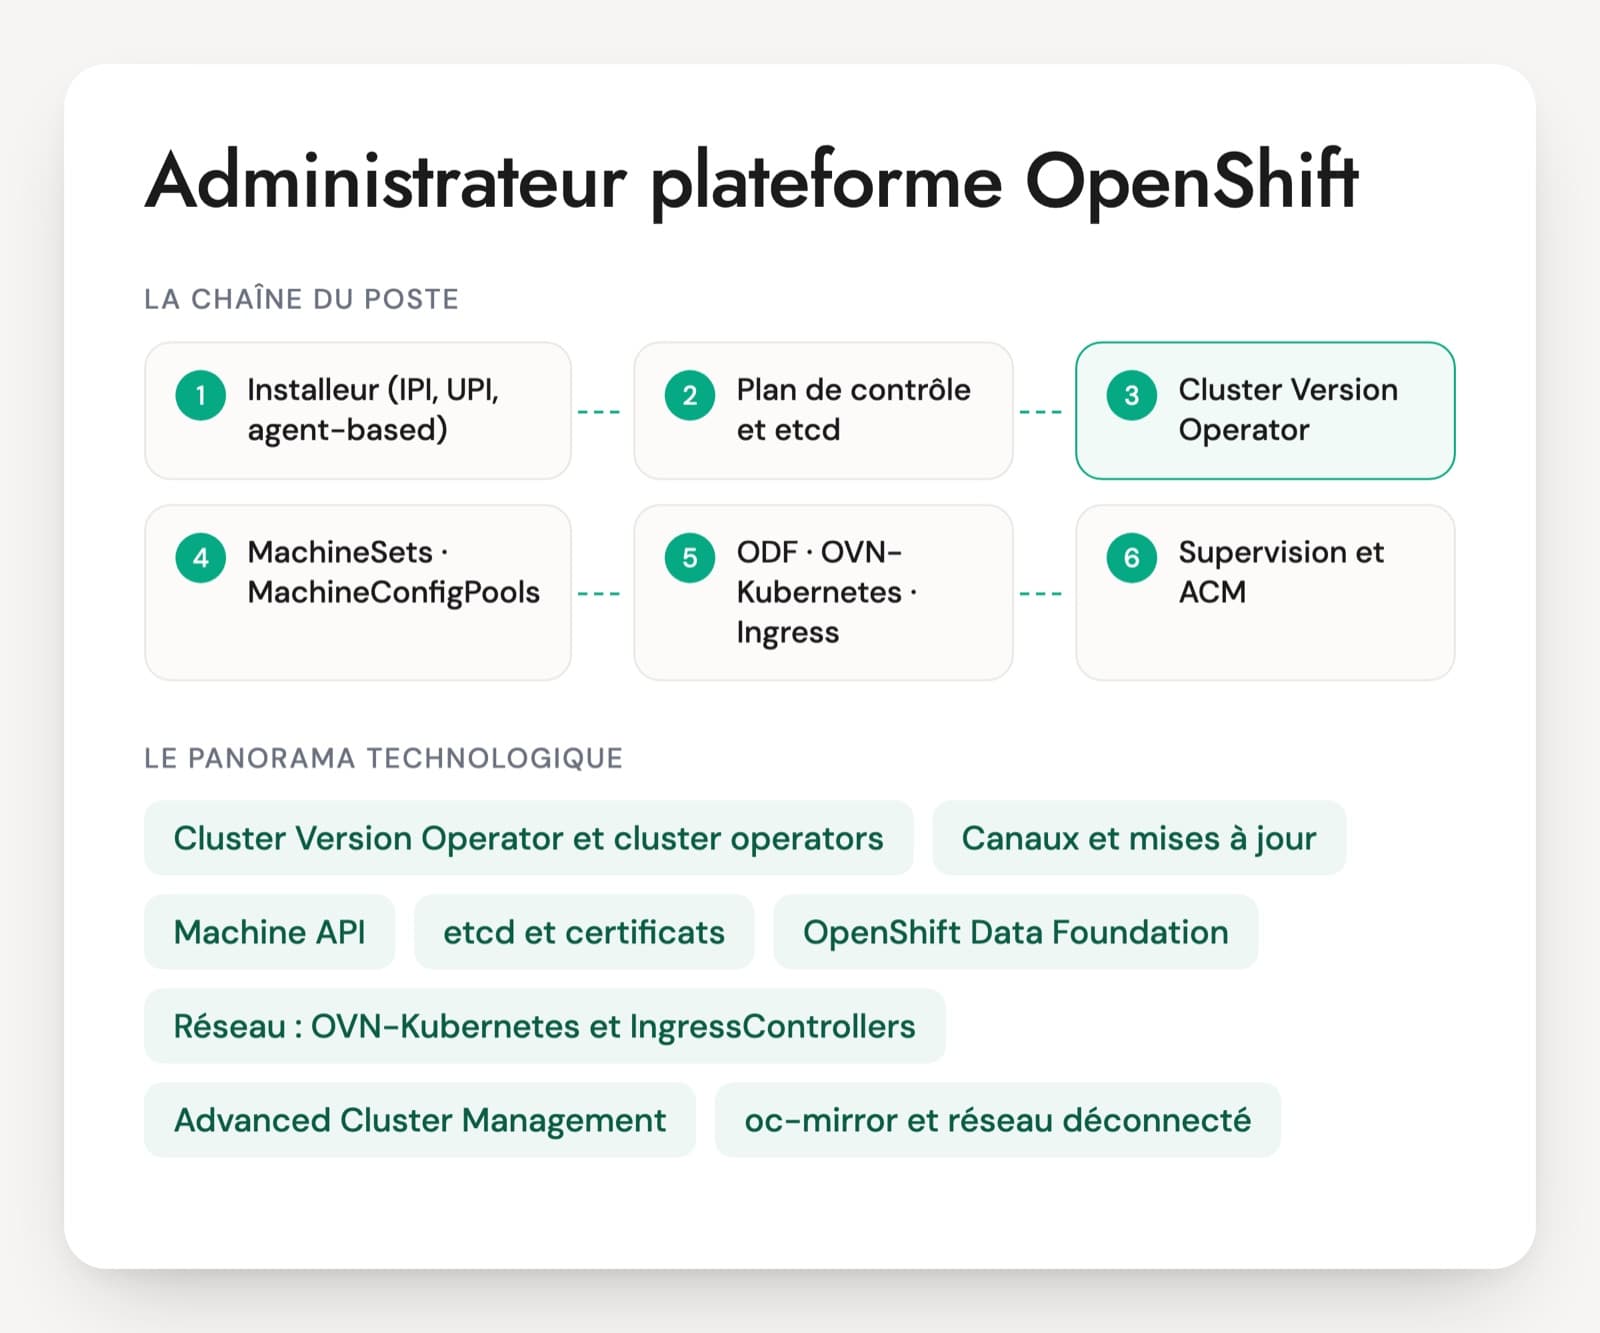
L'administrateur plateforme OpenShift tient des clusters Red Hat OpenShift sur VMware, sur serveurs physiques ou dans un cloud, souvent en réseau fermé. Les offres françaises parlent d'expert ou d'ingénieur OpenShift et citent ODF, OVN-Kubernetes, Ansible, Argo CD et Vault. Les questions d'entretien utiles pour un administrateur OpenShift portent sur les mises à jour, etcd, les certificats, les nœuds et le stockage, plus que sur le déploiement des applications.
Un CV Kubernetes ressemble beaucoup à celui-ci, mais OpenShift gère son plan de contrôle par des opérateurs. Un administrateur venu de Kubernetes classique modifie un Deployment du routeur et voit l'opérateur l'écraser. Les bons profils parlent du Cluster Version Operator, des MachineConfigPools, des canaux de mise à jour et des CSR à approuver.
Le calendrier des versions situe la personne. OpenShift 5.0 est sorti le 3 novembre 2026 avec RHCOS 10 et un nouveau cycle de support. La 4.22, sortie en juin 2026, est la dernière version publiée de la branche 4. La dernière mise à jour menée seule, avec ses versions de départ et d'arrivée, le dit vite. Le PDF détaille l'entretien en 30 questions, un cas de 20 minutes et une grille.
Ce qu'un administrateur OpenShift fait tourner
Cluster Version Operator et cluster operators
OpenShift se gère par des opérateurs. Le Cluster Version Operator applique la version cible, et une trentaine de cluster operators tiennent chacun un composant : API, réseau, ingress, supervision. Toute la santé du cluster se lit avec oc get co. Une modification manuelle d'un composant géré est écrasée.
Canaux et mises à jour
Les versions passent par les canaux candidate, fast puis stable, et le canal eus sert aux mises à jour entre versions paires en ne redémarrant les workers qu'une fois. En branche 4, les versions paires sont des EUS. Avec OpenShift 5, Red Hat annonce un support étendu sur une version sur trois, à partir de la 5.2.
Machine API, MachineSets et MachineConfigPools
En installation IPI, les MachineSets créent et suppriment les machines, ce qui permet l'autoscaling. Les MachineConfigPools regroupent les nœuds par rôle et reçoivent leur configuration système (noyau, fichiers, registres) par le Machine Config Operator. C'est souvent là qu'une mise à jour se bloque.
etcd et certificats
etcd stocke l'état du cluster sur les trois nœuds de contrôle. Sa sauvegarde se fait avec un script fourni par Red Hat, et sa restauration est une opération de dernier recours. Les certificats internes tournent automatiquement, mais un cluster arrêté longtemps redémarre avec des demandes de certificat à approuver.
OpenShift Data Foundation (ODF)
Le stockage logiciel de Red Hat, basé sur Ceph, qui fournit volumes bloc, fichiers et stockage objet aux applications. Il demande au moins trois nœuds de stockage, et Red Hat indique qu'il passe en lecture seule à 85 % de remplissage. Les offres le citent souvent avec les pilotes CSI de VMware ou NFS.
Réseau : OVN-Kubernetes et IngressControllers
OVN-Kubernetes est le seul plugin réseau depuis le retrait d'OpenShiftSDN en 4.17. Les applications sont exposées par des Routes servies par les IngressControllers, basés sur HAProxy. Plusieurs IngressControllers permettent de séparer trafic interne et trafic exposé.
Advanced Cluster Management (ACM)
La console de Red Hat pour une flotte de clusters : création, mises à jour, politiques de conformité, placement des applications avec OpenShift GitOps. Elle tourne sur un cluster hub qu'il faut lui-même sauvegarder. Les offres la citent pour les parcs de plusieurs clusters.
oc-mirror et réseau déconnecté
Dans un réseau sans Internet, oc-mirror recopie les images de la plateforme et des opérateurs vers un registre interne. La version 2 remplace la version 1, dépréciée, et produit des objets de redirection des images (IDMS, ITMS). OpenShift Update Service indique aux clusters déconnectés les versions accessibles.
Le poste existe là où OpenShift porte des dizaines ou des centaines d'applications, souvent dans les datacenters de l'organisation et parfois sans accès à Internet. L'administrateur vient en général de l'administration Linux et de la virtualisation, puis de Kubernetes. Il travaille avec une équipe voisine qui accompagne les projets applicatifs, et il tient les astreintes de la plateforme. Les offres françaises demandent RHEL, Ansible, ODF, OVN-Kubernetes, Argo CD et la supervision intégrée. La certification Red Hat Certified OpenShift Administrator (EX280) atteste la pratique de l'administration courante, sans couvrir l'installation ni les pannes du plan de contrôle.
Ce que l'exploitation d'OpenShift exige du candidat
- Installation IPI, UPI et agent-based
- Mises à jour, canaux et MachineConfigPools
- Nœuds infra, MachineConfig et capacité
- etcd, certificats et accès au plan de contrôle
- ODF, OVN-Kubernetes et IngressControllers
- ACM, supervision et réseau déconnecté
L'administrateur OpenShift en cinq questions de run
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Le cluster est en 4.20 et doit passer en 4.22. Comment préparez-vous et menez-vous cette mise à jour ?
Une bonne réponseIl vérifie le chemin de mise à jour (oc adm upgrade, outil de chemin de Red Hat), les conditions Upgradeable des cluster operators, les API retirées signalées par APIRequestCount et les acquittements administrateur demandés, la compatibilité des opérateurs installés par OLM, et prend une sauvegarde etcd. Entre deux versions paires, il peut faire une mise à jour Control Plane Only par le canal eus : pools de workers en pause, plan de contrôle en 4.21 puis 4.22, puis reprise des workers qui ne redémarrent qu'une fois.
Signal d'alerteUn saut direct de deux versions attendu comme évident, le canal candidate en production, ou aucune sauvegarde avant de commencer.
Question 2 · confirmé
Comment sauvegardez-vous etcd sur OpenShift, et à quoi sert concrètement cette sauvegarde ?
Une bonne réponseLe script cluster-backup.sh lancé sur un nœud de contrôle (par oc debug node) produit un instantané etcd et les ressources des pods statiques. La sauvegarde part hors du cluster et se refait avant chaque mise à jour. Elle sert à revenir à un état antérieur du cluster en dernier recours, par exemple après la perte du quorum. Elle ne contient pas les données des volumes applicatifs.
Signal d'alerteUne copie de /var/lib/etcd à chaud, ou l'idée que Velero ou la sauvegarde des VM remplacent la sauvegarde etcd.
Question 3 · confirmé
Les routeurs, le registre interne et la supervision consomment des ressources sur les nœuds applicatifs. Comment les déplacez-vous sur des nœuds infra ?
Une bonne réponseUn MachineSet dédié en IPI, ou des nœuds existants, avec le label node-role.kubernetes.io/infra, une taint NoSchedule et, si besoin, un MachineConfigPool infra. Chaque composant se place par sa configuration d'opérateur : nodePlacement de l'IngressController, nodeSelector et tolérances dans la configuration du registre, ConfigMap cluster-monitoring-config pour la supervision. Il connaît l'intérêt des nœuds infra pour les souscriptions, sous conditions.
Signal d'alerteUn label sans taint, ou une modification directe du Deployment du routeur.
Question 4 · confirmé
Un cluster arrêté trois semaines redémarre, mais les nœuds restent en NotReady. Que se passe-t-il ?
Une bonne réponseLes certificats des kubelets ont expiré ou doivent être renouvelés pendant l'arrêt. Des CSR restent en attente : il les liste avec oc get csr et les approuve (oc adm certificate approve), d'abord celles du node-bootstrapper, puis les certificats serveur des kubelets. Il connaît la procédure de Red Hat pour reprendre un cluster dont les certificats du plan de contrôle ont expiré.
Signal d'alerteRedémarrer les nœuds en boucle, ou réinstaller le cluster.
Question 5 · confirmé
Le stockage ODF du cluster est rempli à 75 %. Que se passe-t-il au-delà, et comment ajoutez-vous de la capacité ?
Une bonne réponseLes alertes de remplissage commencent vers 75 %, et ODF passe en lecture seule à 85 %, ce qui bloque les applications qui écrivent. Il ajoute de la capacité en étendant le StorageCluster par jeux de trois disques, un par domaine de panne, ou en ajoutant des nœuds de stockage, et surveille la redistribution des données. Il cherche aussi les volumes et objets qui consomment sans raison.
Signal d'alerteAttendre l'alerte suivante, ou ajouter un seul disque sur un seul nœud.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Administrateur OpenShift, les points qui reviennent
Que couvre l'EX280, et que reste-t-il à vérifier en entretien ?
L'EX280 (Red Hat Certified OpenShift Administrator) est un examen pratique sur un cluster réel : utilisateurs, projets, quotas, réseau, déploiements. C'est la certification la plus citée dans les offres. Une certification RHCSA ou RHCE montre un socle Linux utile pour les nœuds. Aucune ne couvre l'installation en réseau fermé, ODF ou la reprise d'un etcd. La date d'obtention compte, car les certifications Red Hat ont une durée de validité.
Que manque-t-il le plus souvent à un administrateur Kubernetes qui découvre OpenShift ?
Le fonctionnement par opérateurs. Il a l'habitude de modifier directement les composants du cluster et découvre que le Cluster Version Operator les remet en place. Il connaît mal les MachineConfigPools, les SCC, les Routes et le cycle des mises à jour par canaux. Le reste de Kubernetes s'applique. Un profil solide s'adapte en quelques semaines, davantage pour l'installation en réseau fermé.
OpenShift 4 ou OpenShift 5 : quelle expérience compte ?
L'expérience de la branche 4 reste la référence, car OpenShift 5.0 vient de sortir et peu de clusters y sont passés. Mieux vaut avoir mené des mises à jour récentes, jusqu'en 4.18 ou au-delà, et connaître les changements de la 5 : RHCOS 10, dépréciation de runC et d'iptables, nouveau cycle de support. Une expérience bloquée sur des versions anciennes demande plus de vérifications.
Quel exercice pratique sans cluster de test à disposition ?
Des sorties de commandes suffisent. Sur une sortie de oc get co avec un opérateur dégradé, un oc get mcp bloqué ou une liste de CSR en attente, la personne livre sa lecture et les commandes suivantes. Un test technique de ce type tient en trente minutes et montre les réflexes de run. Avec un cluster disponible, une panne simple à réparer en direct reste plus parlante.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.