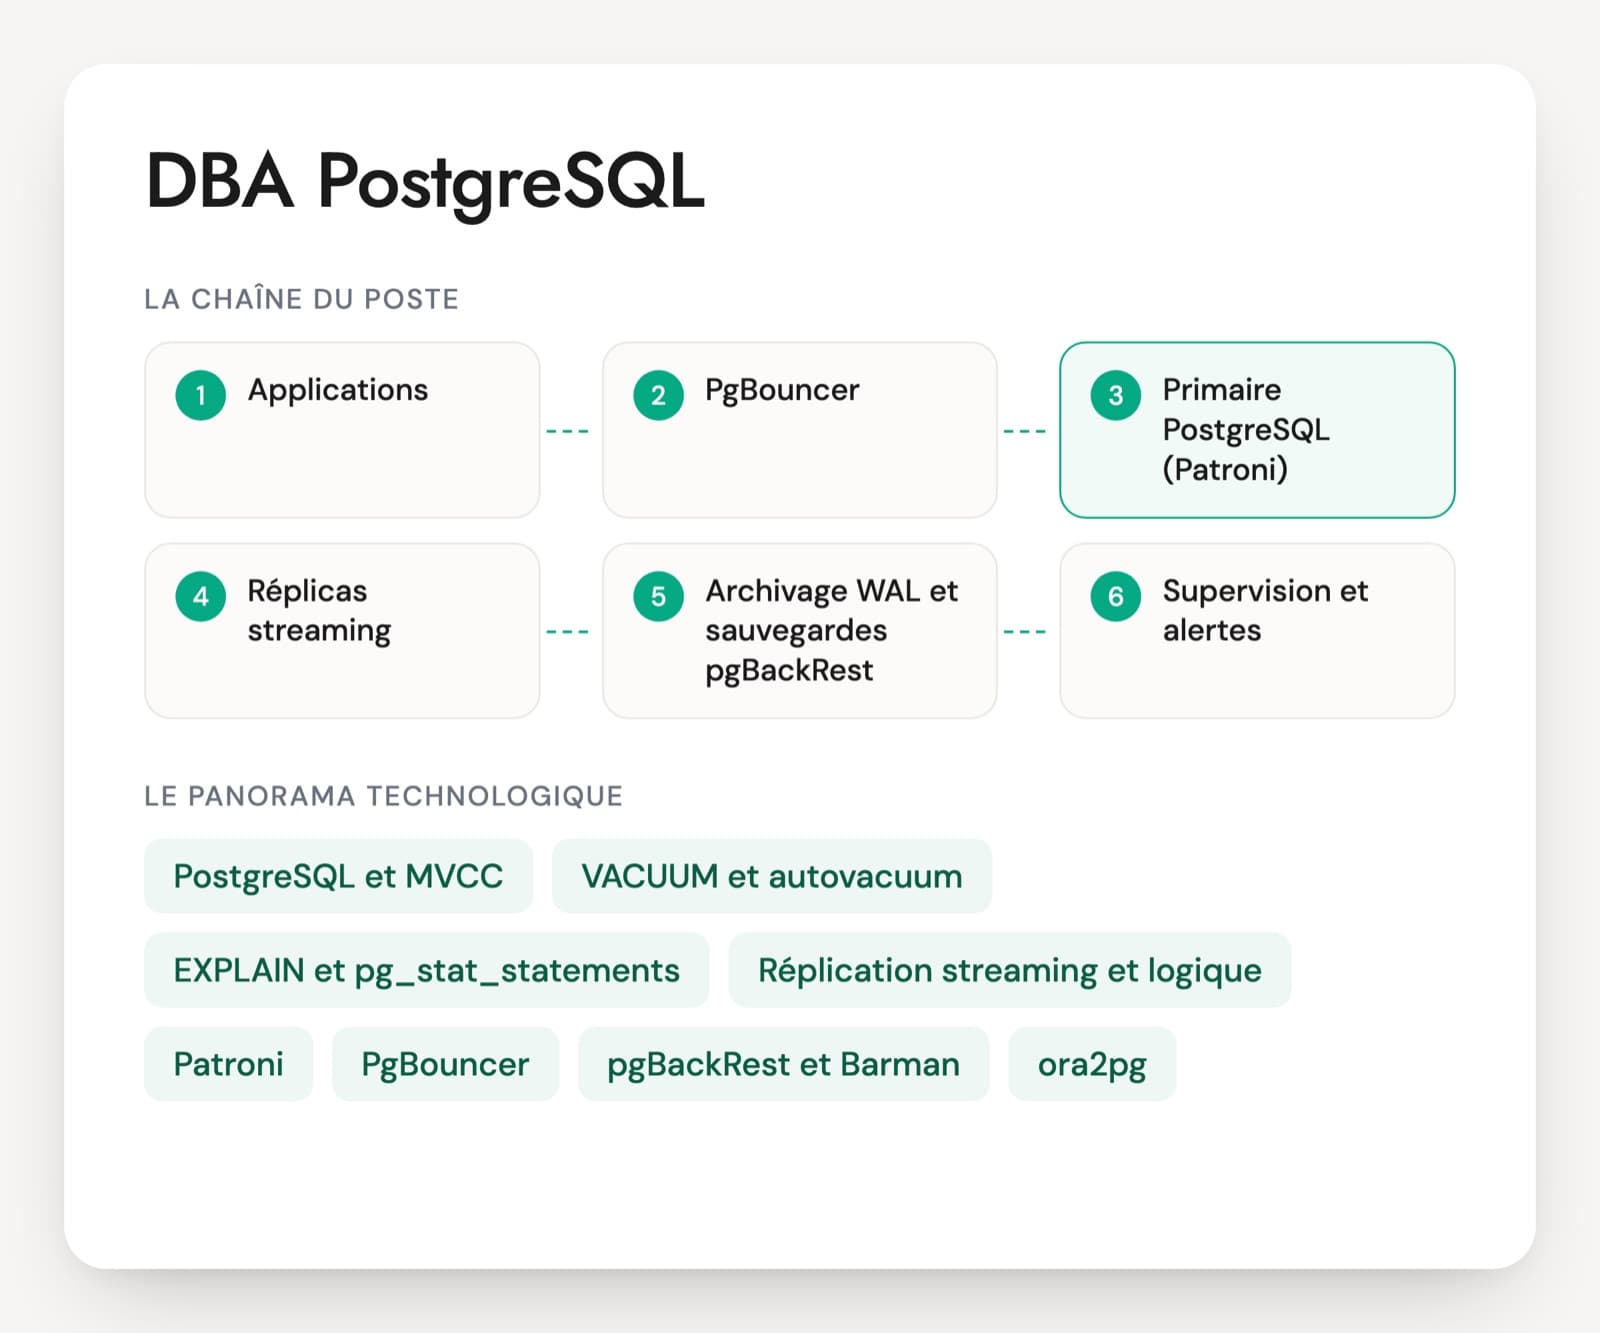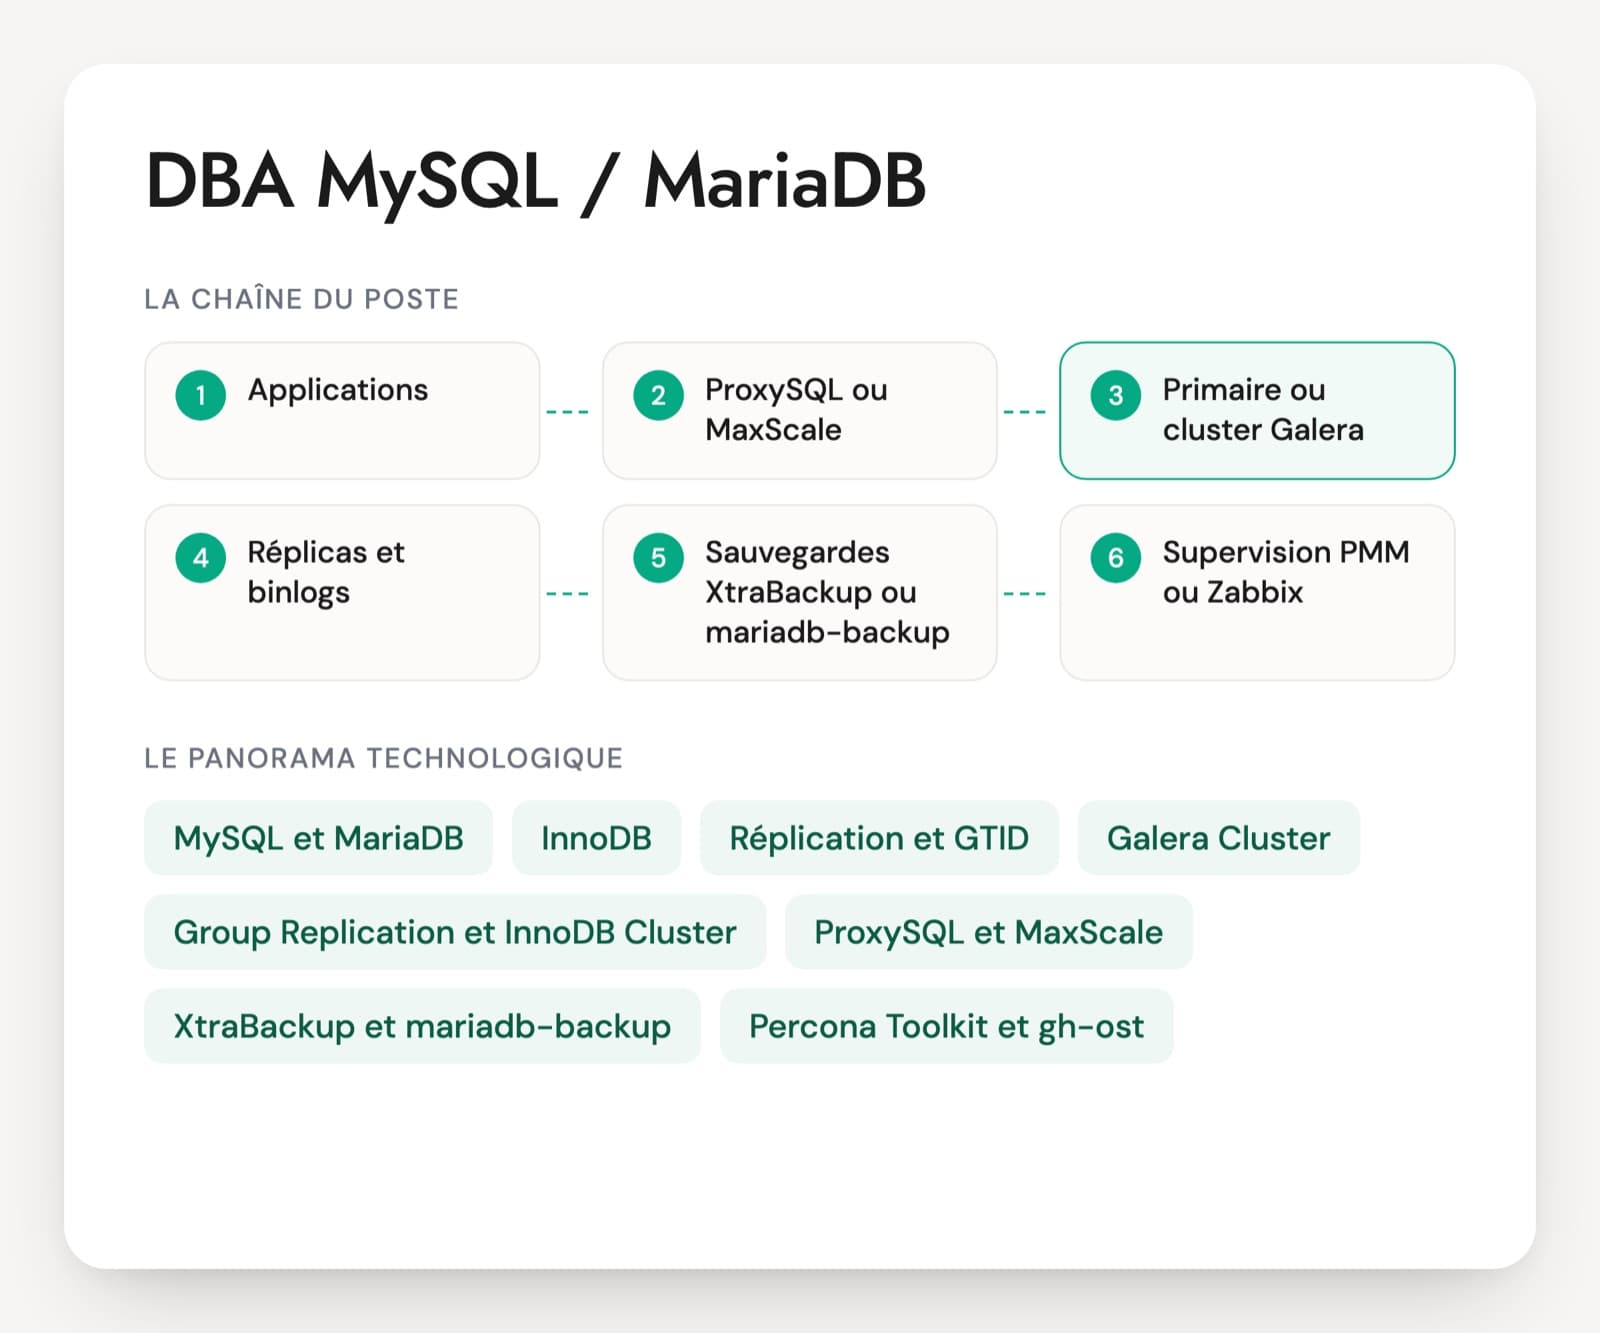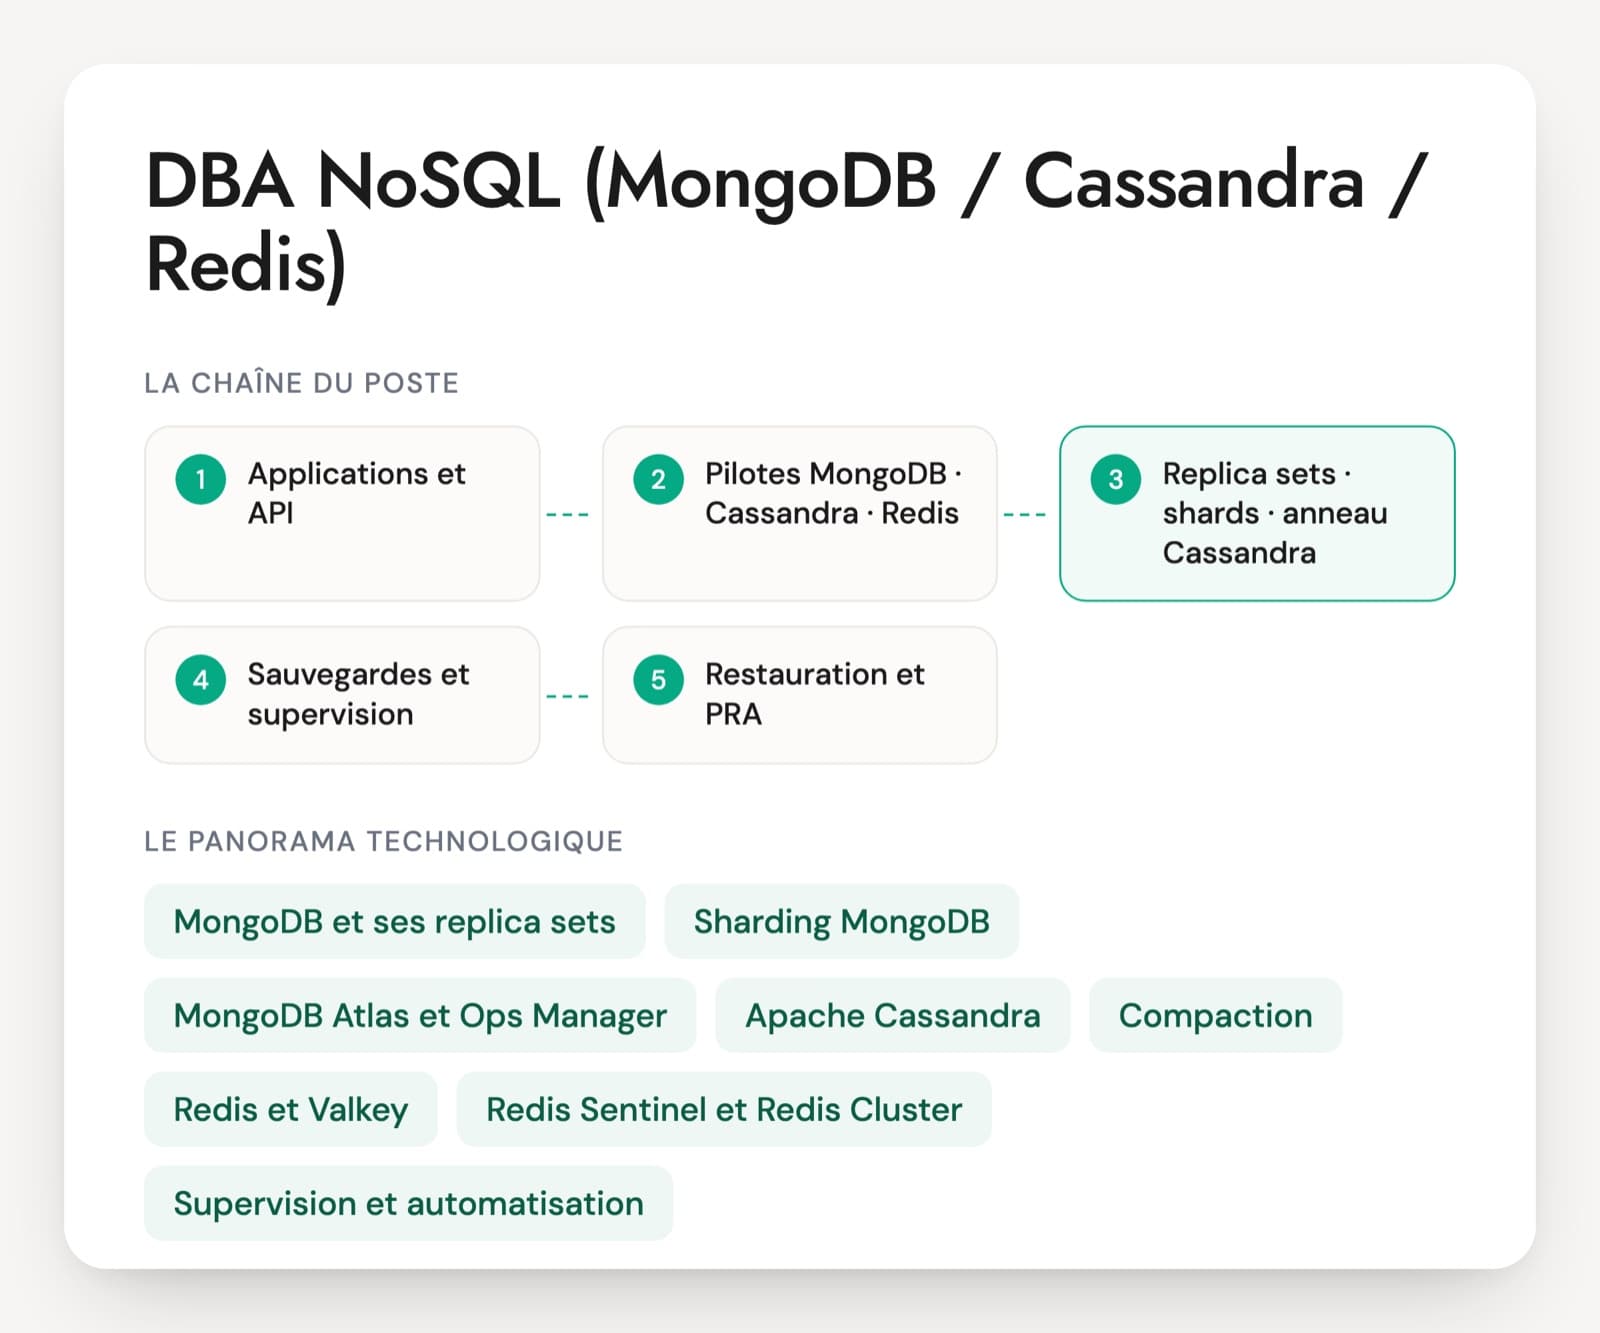
Tout dépend d'abord du parc quand on interroge un DBA NoSQL. MongoDB sert les applications métier et les API, Cassandra absorbe de gros volumes d'écriture répartis sur plusieurs datacenters, Redis tient le cache et les sessions. Les offres françaises, en banque ou chez les infogérants, demandent souvent deux ou trois de ces moteurs à la fois, avec Ansible, Kubernetes et parfois PostgreSQL à côté. Le poste couvre les montées de version, la réplication, les sauvegardes, la performance et le support de niveau 3.
Le risque principal vient des profils développeurs. Écrire des requêtes MongoDB ou utiliser Redis dans une application ne prépare pas à rééquilibrer un cluster shardé, à réparer un nœud Cassandra ou à restaurer une base cohérente à une heure donnée. Les certifications de MongoDB attestent la connaissance du moteur. En entretien, demandez plutôt un incident raconté avec ses chiffres : un oplog trop court, une compaction qui sature les disques, un Redis qui perd ses clés au redémarrage.
Faites préciser par le manager les moteurs réellement en production et leurs versions : un DBA MongoDB solide n'est pas forcément à l'aise sur Cassandra, et l'inverse est vrai aussi. Un cas de 20 minutes sur un catalogue produits qui grossit plus vite que prévu figure dans le PDF.
Les moteurs et les outils d'un DBA NoSQL
MongoDB et ses replica sets
La base orientée documents la plus répandue. En production, elle tourne en replica set : un primaire reçoit les écritures, des secondaires les rejouent depuis l'oplog, et une élection désigne un nouveau primaire en cas de panne. Le DBA règle les write concerns, la taille de l'oplog et l'ordre des montées de version.
Sharding MongoDB
Au-delà d'un certain volume, MongoDB répartit une collection entre plusieurs shards selon une clé choisie par l'équipe. Les routeurs mongos dirigent les requêtes et le balancer déplace les données entre shards. Une mauvaise clé crée un shard surchargé, et la changer après coup reste une opération lourde, même si le resharding existe depuis la version 5.0.
MongoDB Atlas et Ops Manager
Atlas est le service managé de MongoDB sur AWS, Azure et Google Cloud. Ops Manager est son équivalent auto-hébergé, avec supervision, automatisation et sauvegardes. Un DBA qui n'a connu qu'Atlas n'a parfois jamais mené une restauration lui-même, à vérifier en entretien.
Apache Cassandra
Une base distribuée sans maître, faite pour écrire beaucoup et sur plusieurs datacenters. Chaque table se conçoit à partir des requêtes qu'elle sert, et la clé de partition décide où vont les données. Le facteur de réplication et le niveau de cohérence choisi à chaque requête (ONE, QUORUM, LOCAL_QUORUM) fixent le compromis entre disponibilité et exactitude des lectures.
Compaction, tombstones et repair
Les écritures Cassandra s'empilent dans des fichiers SSTables que la compaction fusionne. Une suppression laisse un marqueur (tombstone) qui ralentit les lectures tant qu'il n'est pas purgé. La réparation, avec nodetool repair ou Cassandra Reaper, doit passer plus souvent que le délai gc_grace_seconds, sinon des données supprimées peuvent réapparaître.
Redis et Valkey
Une base clé-valeur en mémoire, utilisée comme cache, comme stockage de sessions ou comme file de messages. La persistance passe par des snapshots RDB, par le journal AOF ou par les deux. Après le changement de licence de Redis en 2024, plusieurs clouds proposent Valkey, un fork compatible, et Redis 8 a ajouté une licence AGPLv3.
Redis Sentinel et Redis Cluster
Sentinel surveille un primaire et ses réplicas et déclenche la bascule. Redis Cluster répartit les clés sur 16 384 slots entre plusieurs primaires. Le DBA règle aussi ce que fait Redis quand la mémoire est pleine (maxmemory-policy), un réglage souvent oublié.
Supervision et automatisation
Prometheus et Grafana avec les exporters de chaque moteur, ou les outils des éditeurs. Ansible pour les installations et les montées de version. Sur Kubernetes, des opérateurs comme celui de MongoDB ou K8ssandra pour Cassandra, avec leurs propres règles de sauvegarde et de mise à jour.
Le périmètre change selon l'employeur. Chez un infogérant ou dans une banque, le DBA NoSQL administre plusieurs moteurs pour de nombreuses équipes, avec astreinte, procédures et support de niveau 3. Dans une scale-up, il travaille avec les développeurs sur le modèle de données et la clé de sharding, souvent sur Atlas ou sur un service managé du cloud comme Amazon ElastiCache ou Azure Cosmos DB. Certains postes demandent aussi un moteur relationnel, PostgreSQL le plus souvent. Les services compatibles MongoDB des clouds, comme Amazon DocumentDB, n'offrent pas toutes les fonctions du moteur, et un candidat venu de là doit le savoir.
Les compétences à contrôler chez un DBA NoSQL
- Réplication MongoDB et replica sets
- Sharding et modèle de données
- Cassandra : cohérence, compaction, repair
- Redis : mémoire, persistance, haute disponibilité
- Sauvegarde et restauration NoSQL
- Supervision, sécurité et montées de version
Cinq questions techniques pour un DBA MongoDB ou Cassandra
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Un secondaire MongoDB est resté arrêté deux jours. Au redémarrage, il ne rattrape pas son retard. Que s'est-il passé et que faites-vous ?
Une bonne réponseL'oplog du primaire a tourné : les opérations dont le secondaire avait besoin n'y sont plus. Le membre se déclare trop en retard (too stale) et doit refaire une synchronisation initiale, depuis un autre membre ou à partir d'une copie des fichiers de données. La personne regarde ensuite la fenêtre d'oplog réelle avec rs.printReplicationInfo() et l'agrandit, ou fixe une durée minimale de rétention de l'oplog, pour couvrir une panne longue ou une maintenance.
Signal d'alerte« Je redémarre jusqu'à ce qu'il rattrape », ou supprimer les fichiers de données sans savoir d'où viendra la resynchronisation. Aucune notion de fenêtre d'oplog.
Question 2 · senior
Une collection de commandes est shardée sur la date de création. Un seul shard reçoit toutes les écritures. Pourquoi, et comment corrigez-vous ?
Une bonne réponseUne clé croissante envoie toutes les nouvelles insertions dans le dernier intervalle, donc sur un seul shard, ce qu'on appelle un shard chaud. La correction passe par une clé à forte cardinalité qui répartit les écritures, souvent composée (identifiant client puis date) ou hachée si les requêtes par plage de dates comptent peu. Depuis MongoDB 5.0, reshardCollection change la clé sans recréer la collection, mais l'opération demande de l'espace disque et du temps, à planifier hors pointe. La personne vérifie aussi que les requêtes fréquentes contiennent la clé, sinon mongos interroge tous les shards.
Signal d'alerte« J'ajoute un shard » : un nouveau shard ne reçoit pas les insertions tant que la clé reste croissante. Ou une clé hachée proposée par réflexe, sans regarder les requêtes par plage de dates.
Question 3 · confirmé
Sur un cluster Cassandra à deux datacenters, avec un facteur de réplication de 3 dans chacun, quel niveau de cohérence choisissez-vous pour les lectures et les écritures ?
Une bonne réponseLOCAL_QUORUM en lecture et en écriture, le cas le plus courant : deux réplicas sur trois répondent dans le datacenter local, une lecture voit la dernière écriture faite dans ce datacenter, et la perte du site distant ne bloque rien. La personne cite la règle selon laquelle réplicas lus plus réplicas écrits doivent dépasser le facteur de réplication. Elle sait que QUORUM tout court attendrait des réponses de l'autre datacenter, avec la latence du lien. EACH_QUORUM en écriture se justifie seulement si les deux sites doivent être cohérents à tout instant.
Signal d'alerteALL « pour être sûr », qui rend chaque requête dépendante de tous les nœuds. Ou ONE partout, sans voir qu'une lecture peut renvoyer une valeur périmée.
Question 4 · confirmé
Un Redis utilisé comme cache atteint sa limite mémoire et l'application reçoit des erreurs OOM à l'écriture. Que regardez-vous ?
Une bonne réponseLa politique d'éviction. Avec noeviction, la valeur par défaut, Redis refuse les écritures une fois maxmemory atteint. Pour un cache, allkeys-lru ou allkeys-lfu libèrent de la place. La personne vérifie aussi les clés sans TTL, les grosses clés (redis-cli --bigkeys ou --memkeys), la fragmentation dans INFO memory et la marge laissée au fork d'une sauvegarde RDB ou d'une réécriture AOF.
Signal d'alerteAugmenter la mémoire de la machine sans regarder ce qui la remplit. Ou passer en allkeys-lru sur une instance qui stocke aussi des sessions ou une file de messages qu'on ne doit pas perdre.
Question 5 · senior
Comment restaurez-vous un cluster MongoDB shardé à un instant précis, par exemple juste avant une suppression accidentelle à 14 h 32 ?
Une bonne réponseUn mongodump ne donne pas de point cohérent sur un cluster shardé en cours d'écriture. Il faut un outil qui coordonne les shards et les config servers : la sauvegarde continue d'Atlas ou d'Ops Manager, qui restaure à un instant donné, ou Percona Backup for MongoDB avec ses sauvegardes physiques et la capture de l'oplog. La personne restaure d'abord sur un environnement à part, vérifie les données, puis choisit entre une restauration complète et la réinjection des seuls documents supprimés.
Signal d'alerte« On a un mongodump chaque nuit » sur un cluster shardé, sans voir que la sauvegarde n'est pas cohérente entre shards. Ou n'avoir jamais testé une restauration.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Recrutement d'un DBA NoSQL : réponses courtes
Quelles compétences attendre d'un DBA MongoDB ?
La réplication d'abord : élections, write concern, fenêtre d'oplog, resynchronisation d'un membre. Puis le sharding avec le choix de la clé, le balancer et le resharding, la lecture d'un explain() et la construction des index composés. Côté exploitation, viennent la sauvegarde cohérente avec restauration à un instant donné, les montées de version sans coupure, la sécurité (authentification, rôles, TLS) et la supervision. Sur Atlas, ajoutez la connaissance de ce que le service fait à votre place.
Un DBA Oracle ou PostgreSQL s'adapte-t-il vite à Cassandra ?
Il garde ses réflexes de sauvegarde, de supervision et de rigueur en production. Le reste change beaucoup. Cassandra n'a pas de jointure, la table se dessine à partir des requêtes, la cohérence se choisit à chaque appel et la réparation fait partie de l'exploitation courante. Un DBA relationnel qui n'a jamais vu une donnée supprimée réapparaître ou un nœud saturé par la compaction a besoin d'un temps d'apprentissage. Interrogez-le sur la modélisation et sur gc_grace_seconds.
Quel test technique proposer à un DBA NoSQL ?
Un exercice proche de la production marche mieux qu'un questionnaire sur la syntaxe. Donnez la sortie de rs.status() d'un replica set en difficulté, un explain() à commenter ou un schéma Cassandra à corriger, et demandez un diagnostic à voix haute. Pour un senior, ajoutez une restauration à un instant donné à décrire étape par étape. Vingt à trente minutes suffisent pour voir si la personne a déjà exploité ces moteurs ou seulement développé dessus.
Faut-il interroger un DBA NoSQL sur le théorème CAP et les transactions ACID ?
Oui, mais par la pratique. Ces notions figurent dans tous les guides de préparation, et un candidat les récite sans peine. Demandez plutôt ce qu'il règle concrètement : un write concern majority et un read concern adapté sur MongoDB, un niveau LOCAL_QUORUM sur Cassandra, et ce qu'on perd si un datacenter tombe. Sur les transactions, il doit savoir que MongoDB les gère sur plusieurs documents depuis la version 4.0, avec un coût en performance qui pousse à les limiter.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.