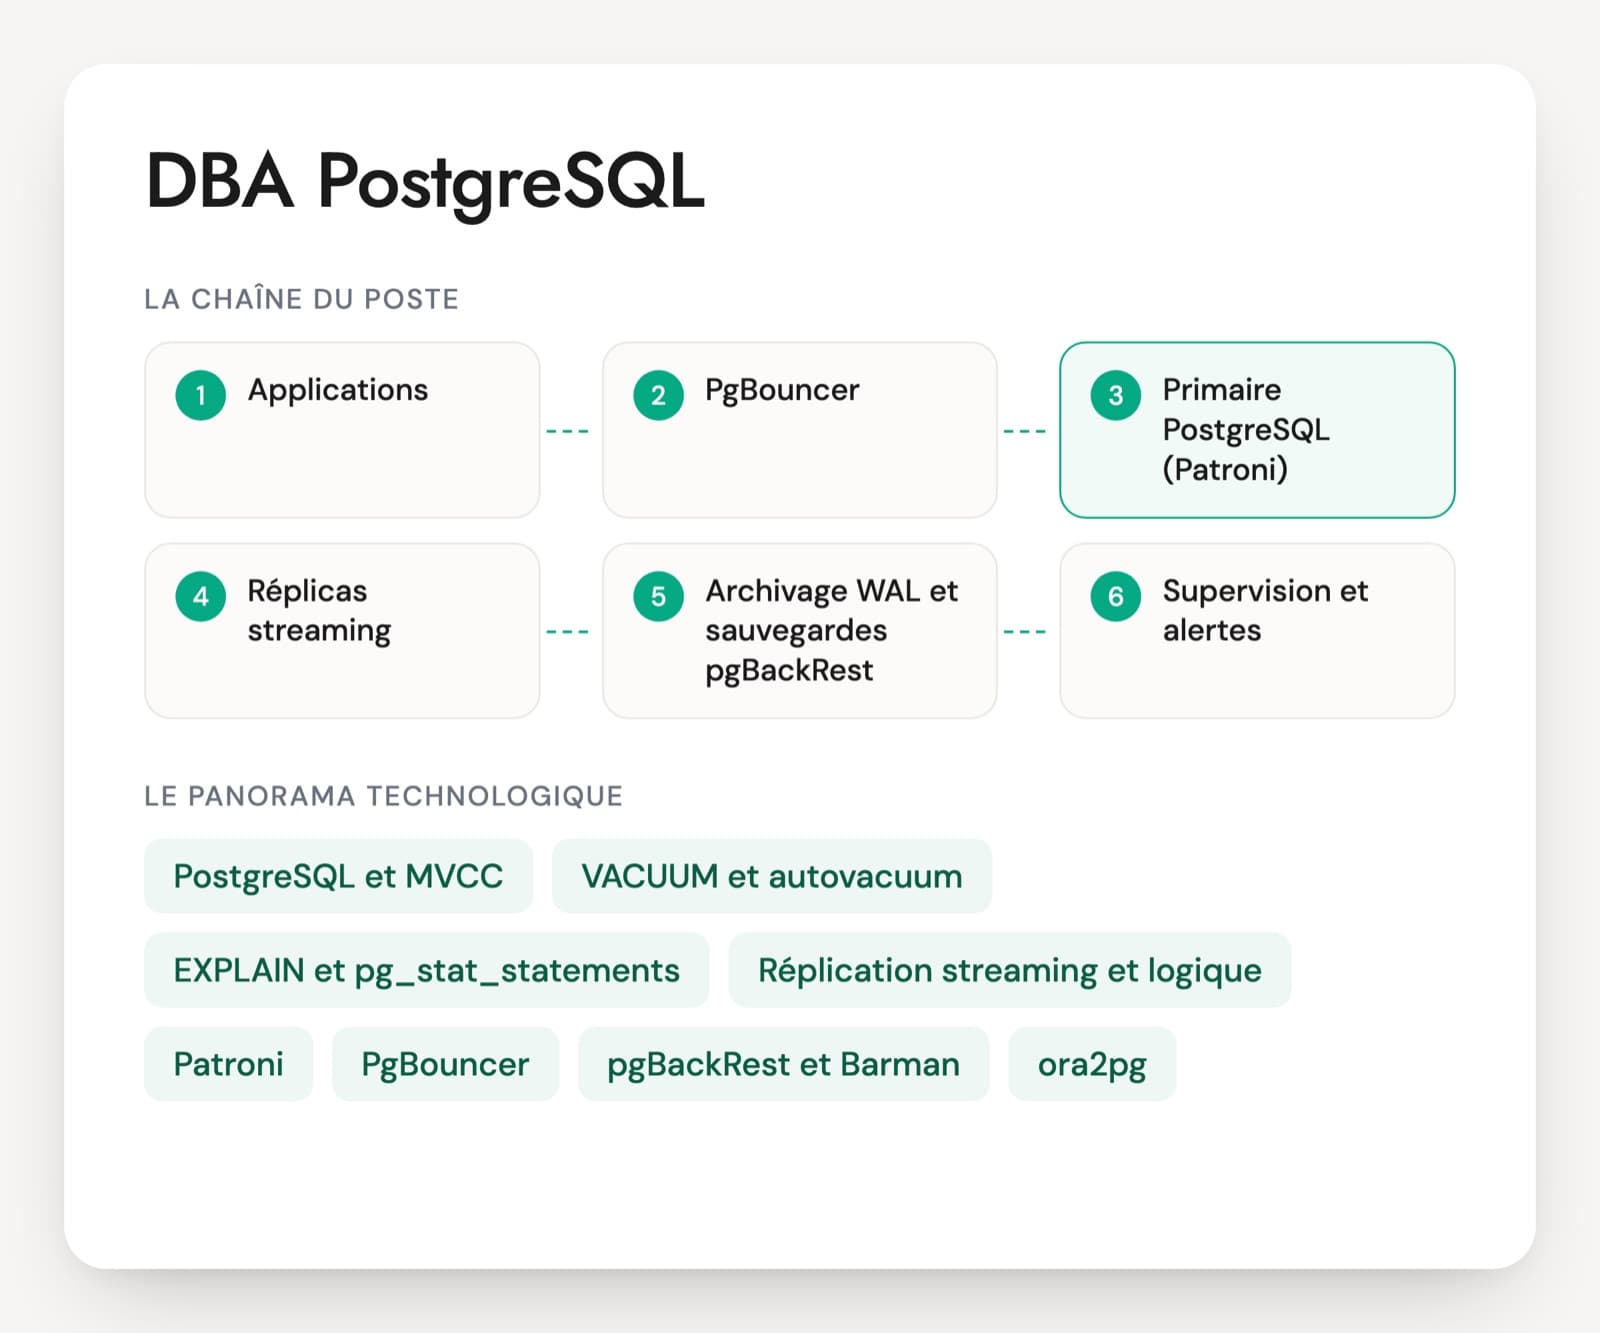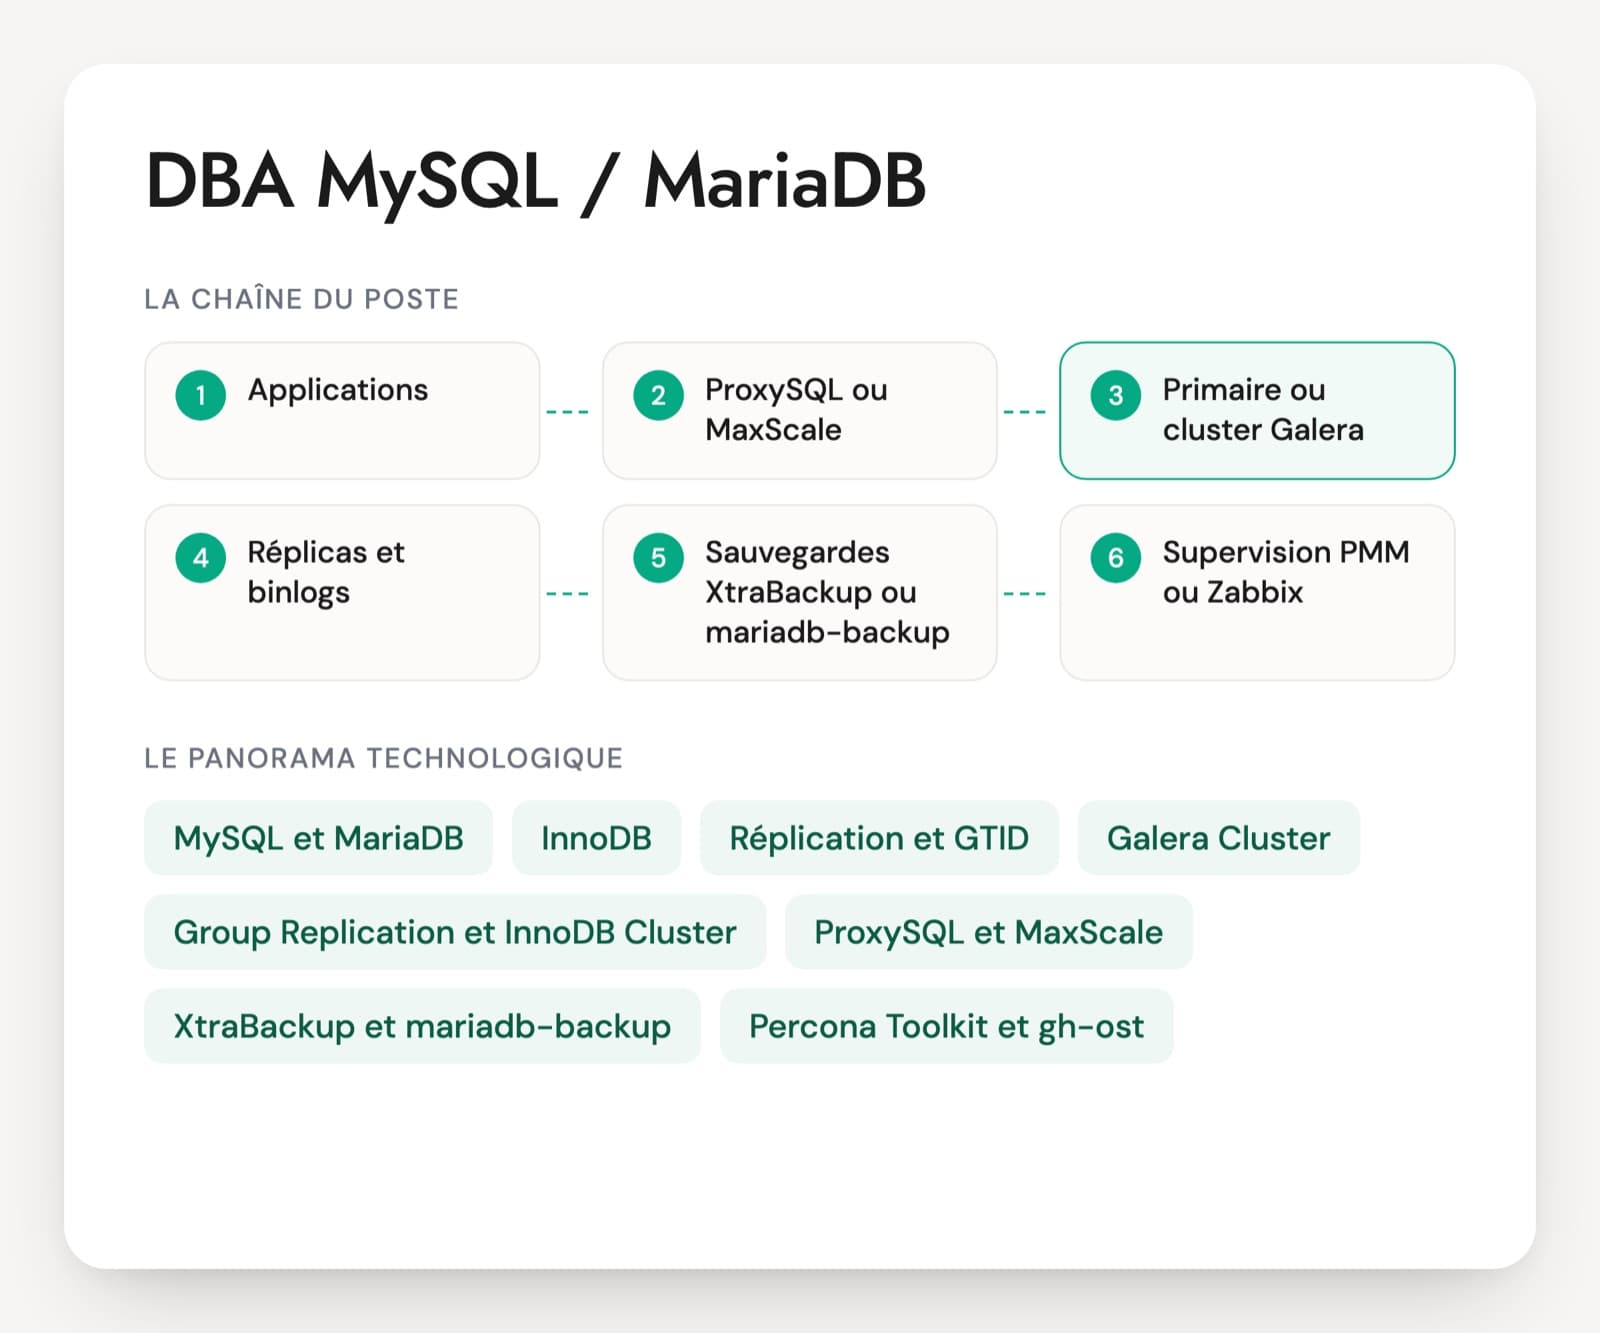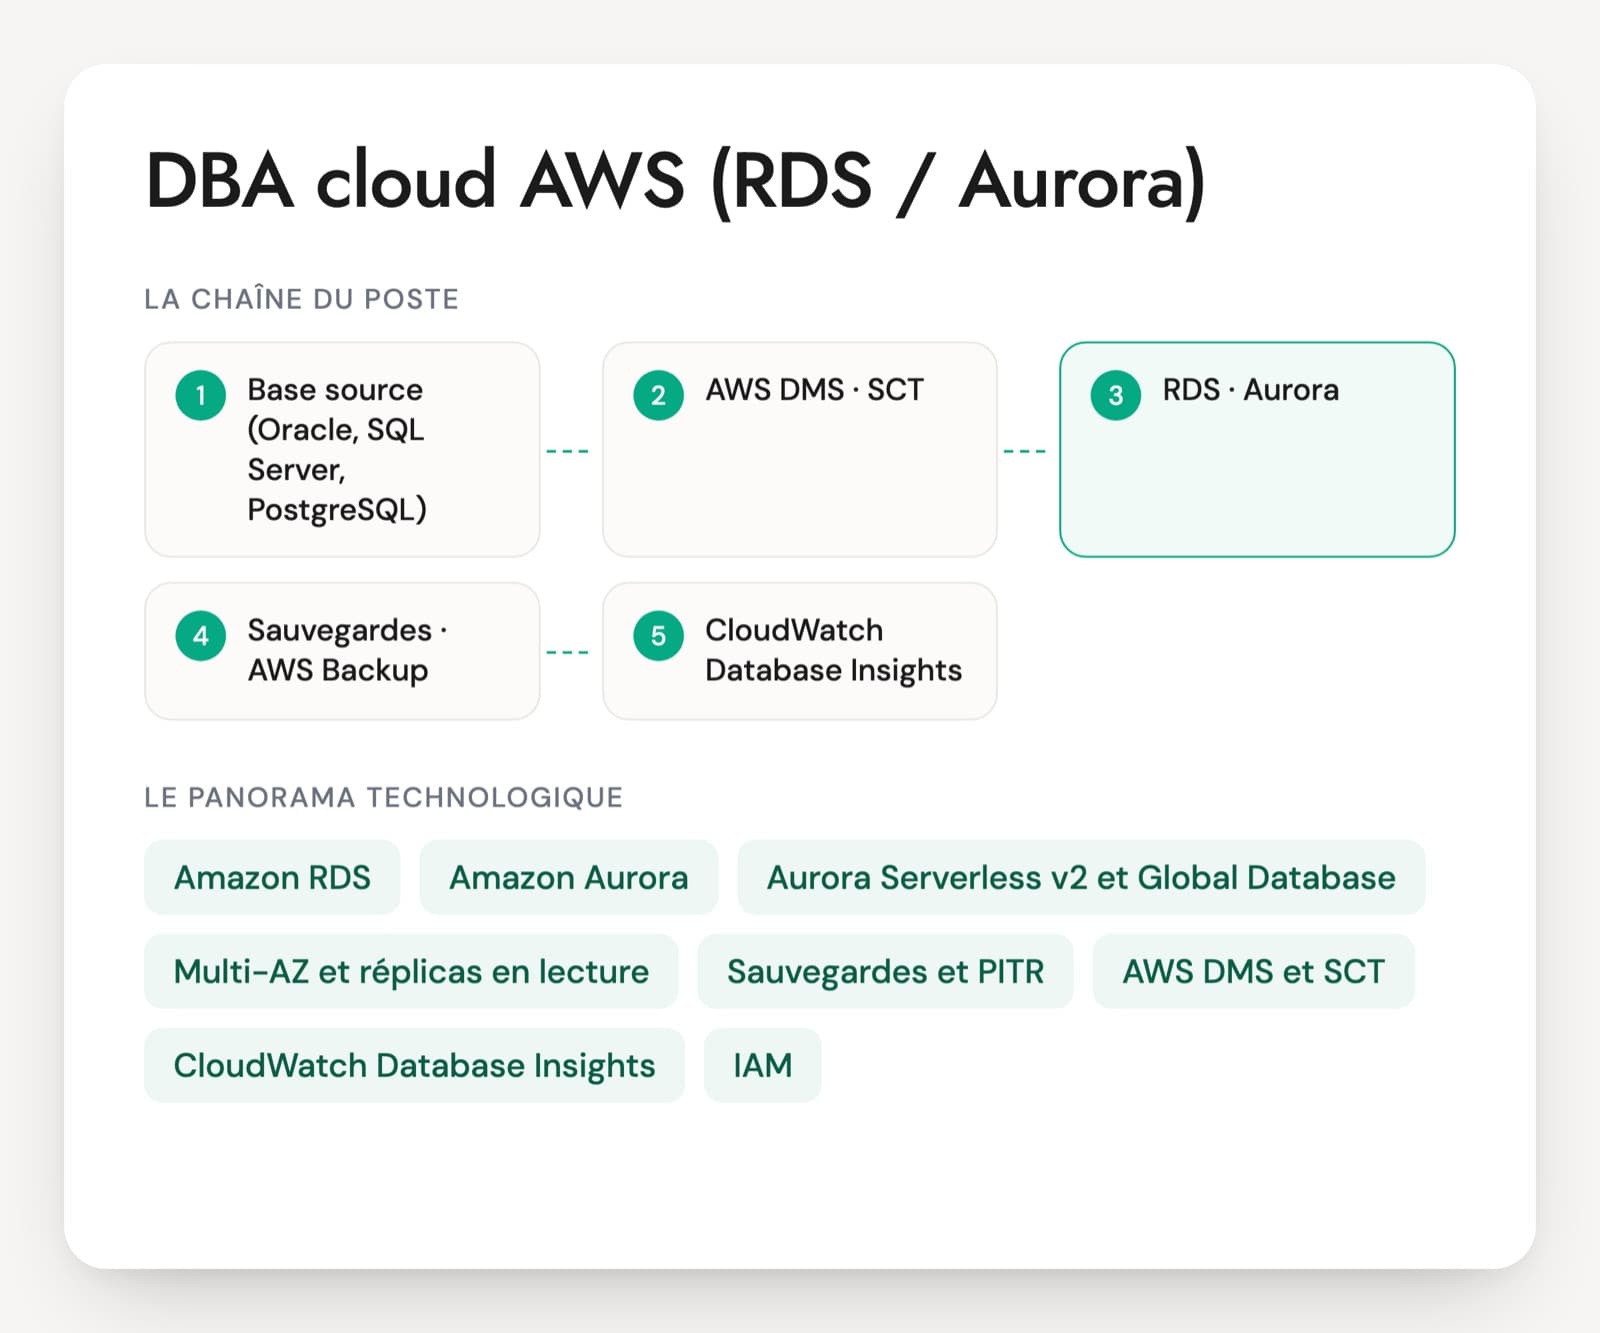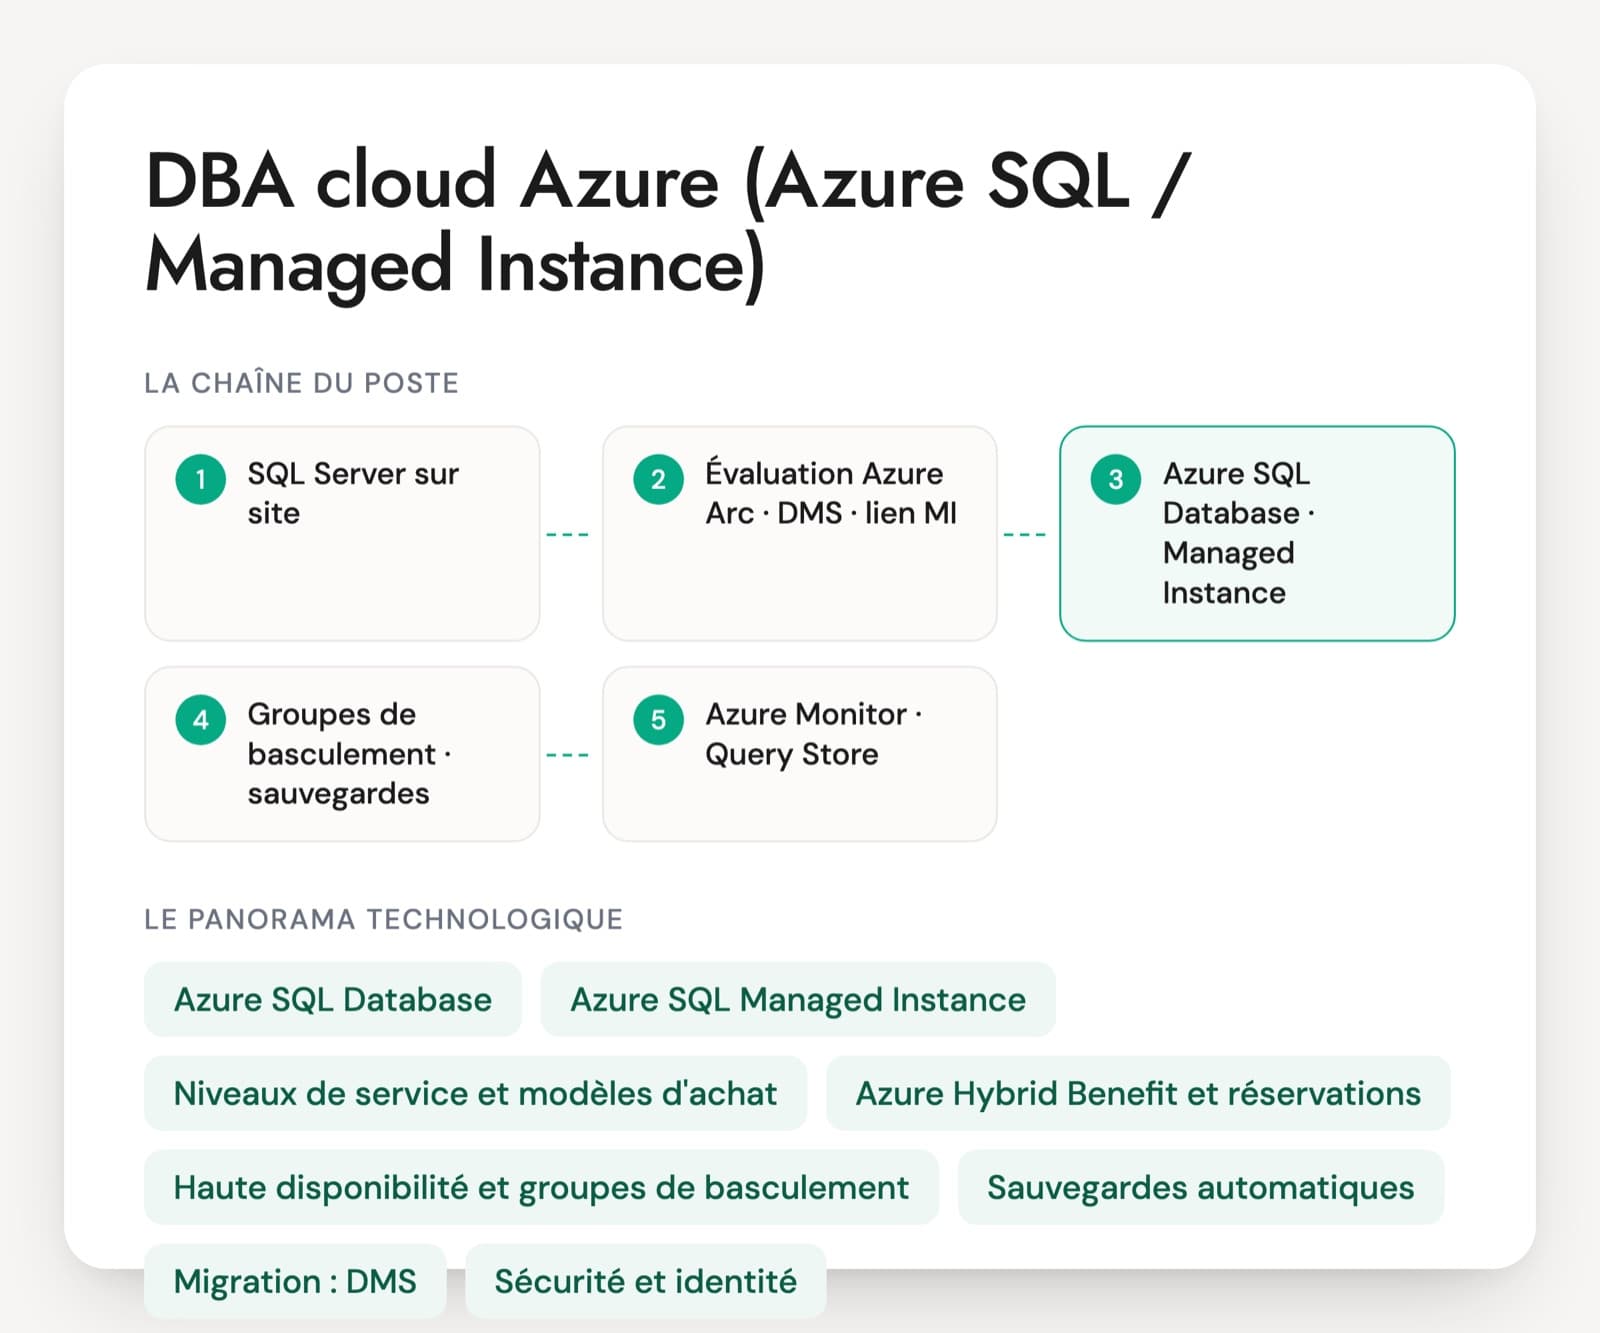
Le titre DBRE apparaît dans deux types d'offres en France. Les scale-ups cherchent quelqu'un pour tenir PostgreSQL ou MySQL sous une charge qui grimpe, avec Kubernetes, Terraform et des déploiements applicatifs plusieurs fois par jour. Les grandes DSI cherchent un DBA orienté DevOps qui industrialise un parc hétérogène (Oracle, SQL Server, PostgreSQL, MongoDB) : provisioning standardisé, patchs par pipeline CI/CD, GitOps. Dans les deux cas, le poste garde du support N2/N3 sur les incidents critiques.
Le risque, à l'entretien, est de recruter un DBA classique qui cite Terraform, ou un SRE qui n'a jamais restauré une base. Le bon profil explique comment il ajoute une colonne NOT NULL à une table de 500 millions de lignes sans bloquer l'application, comment il pose un SLO sur une base, et ce que son pipeline vérifie avant de patcher cent instances. Le livre Database Reliability Engineering (O'Reilly) a donné son nom au poste ; les offres insistent surtout sur l'automatisation.
Choisissez les axes selon le poste : migrations de schéma et passage à l'échelle pour une scale-up, industrialisation du parc pour une DSI. Le PDF couvre les deux avec 30 questions sur six axes, un cas de 20 minutes sur une migration qui a bloqué la production, et une grille de 1 à 4.
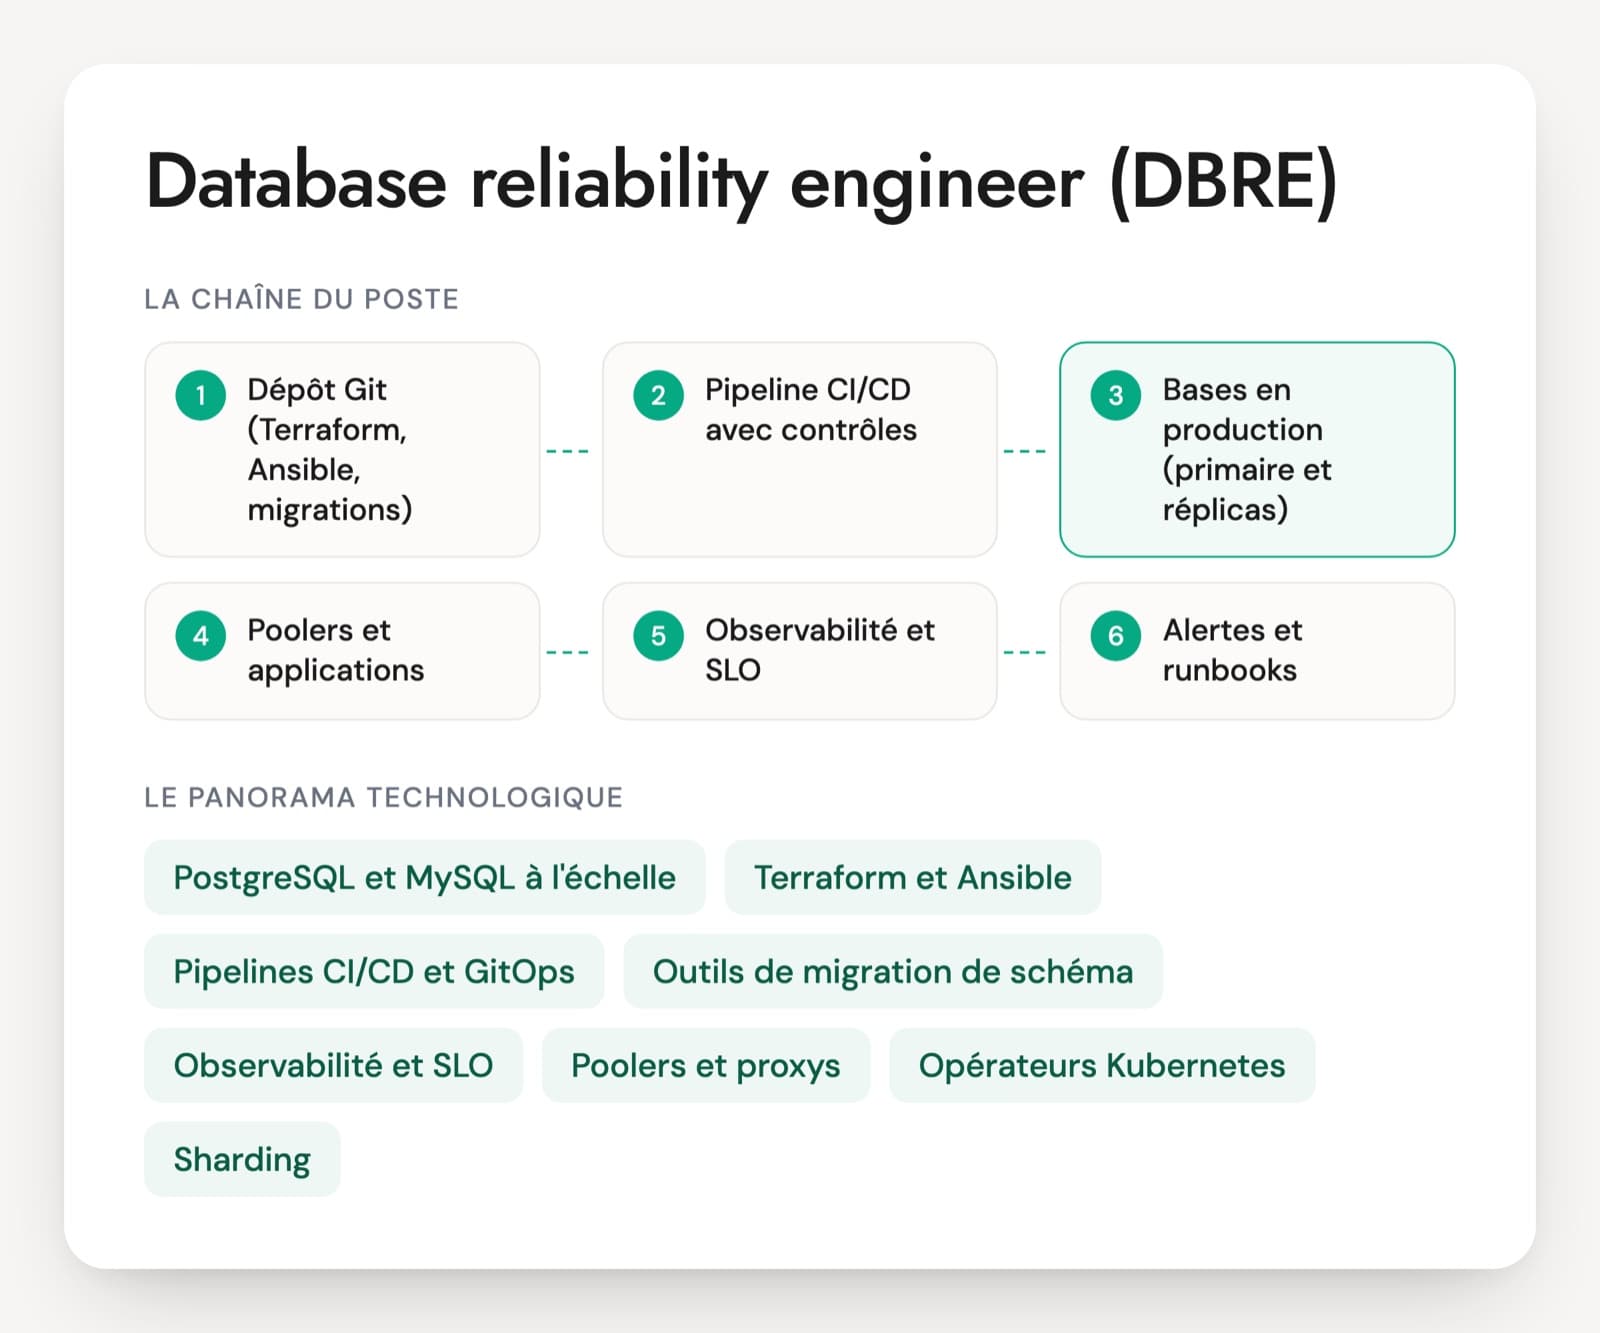
Outils et pratiques d'un DBRE
PostgreSQL et MySQL à l'échelle
Les deux moteurs les plus présents dans les offres de scale-ups. Le DBRE connaît leurs verrous, leur réplication et leurs limites en écriture, car ce sont eux qui décident si une migration de schéma ou une montée en charge passe sans incident.
Terraform et Ansible
Terraform décrit les ressources (instances managées, réseau, paramètres), Ansible configure les serveurs gérés soi-même. Le parc entier se recrée à partir du dépôt, et chaque changement passe par une revue et un pipeline.
Pipelines CI/CD et GitOps
GitLab CI, Jenkins ou ArgoCD appliquent patchs, montées de version et migrations par vagues, avec des contrôles automatiques entre chaque étape. Les grandes DSI en France recrutent des DBRE précisément pour construire ces pipelines.
Outils de migration de schéma
Flyway ou Liquibase versionnent les migrations ; gh-ost et pt-online-schema-change modifient de grosses tables MySQL sans les bloquer. Sous PostgreSQL, le travail repose sur les opérations concurrentes et les contraintes NOT VALID.
Observabilité et SLO
pg_stat_statements, performance_schema, Prometheus, Grafana, Datadog Database Monitoring ou CloudWatch Database Insights. Le DBRE en tire des SLO de latence et de disponibilité, et des alertes qui appellent une action.
Poolers et proxys
PgBouncer, ProxySQL ou RDS Proxy absorbent les connexions des applications conteneurisées, qui se multiplient avec l'autoscaling. Ils servent aussi à basculer les connexions lors d'une montée de version.
Opérateurs Kubernetes
CloudNativePG ou les opérateurs Percona gèrent réplication, bascule et sauvegardes de bases dans Kubernetes à partir de manifestes. Le DBRE doit savoir ce que l'opérateur fait et ce qu'il ne couvre pas, à commencer par le stockage.
Sharding
Citus pour PostgreSQL, Vitess pour MySQL, ou une répartition applicative. C'est la dernière option quand un primaire ne tient plus les écritures, avec un coût durable sur les jointures, les transactions et les migrations.
Le poste a deux visages. En scale-up, le DBRE est souvent seul ou presque sur les bases d'un produit en croissance : il travaille avec les développeurs sur les migrations de schéma, tient les SLO et prépare le passage à l'échelle, le plus souvent sur PostgreSQL ou MySQL managés. Dans une grande DSI ou chez un infogérant, il industrialise un parc hétérogène et ancien : provisioning standardisé, patchs et montées de version par pipeline, supervision unifiée, avec Red Hat, Ansible, Terraform et parfois Kubernetes. Les offres françaises demandent une expertise forte sur au moins deux moteurs, Python pour l'automatisation, et une expérience du support N2/N3. Les candidats viennent soit du DBA de production passé à l'automatisation, soit du SRE qui s'est spécialisé sur les bases. Les deux parcours se valent si le candidat sait à la fois écrire le pipeline et restaurer la base.
Ce qui distingue un DBRE d'un DBA
- Migrations de schéma sans interruption
- Infrastructure as code et provisioning
- Observabilité, SLO et alerting
- Haute disponibilité et restauration testée
- Performance, pooling et sharding
- Bases sur Kubernetes et services managés
Cinq mises en situation pour un DBRE
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · senior
Vous devez ajouter une colonne NOT NULL avec une valeur par défaut et un index sur une table PostgreSQL de 500 millions de lignes très sollicitée. Comment déployez-vous le changement sans coupure ?
Une bonne réponseDepuis PostgreSQL 11, ADD COLUMN avec une valeur par défaut constante ne réécrit plus la table, mais l'ALTER prend quand même un verrou exclusif bref : le candidat fixe lock_timeout et prévoit des reprises, pour que l'ALTER en attente ne bloque pas toutes les requêtes derrière lui. L'index se crée avec CREATE INDEX CONCURRENTLY, en vérifiant qu'aucun index invalide ne reste après un échec. Pour une contrainte, il ajoute un CHECK NOT VALID puis le valide à part avec VALIDATE CONSTRAINT, sans bloquer les écritures ; depuis PostgreSQL 12, SET NOT NULL réutilise ce CHECK validé et évite un nouveau parcours de la table. Il découpe le tout en étapes compatibles avec l'ancienne et la nouvelle version de l'application (expand puis contract), avec un remplissage par lots si la valeur se calcule.
Signal d'alerteUn ALTER TABLE lancé en heure creuse « parce que ça passera », sans lock_timeout, ou un CREATE INDEX classique sur la table de production.
Question 2 · confirmé
Comment définissez-vous un SLO pour la base de données qui sert une API de paiement ?
Une bonne réponseIl part de ce que voit l'utilisateur : la latence des requêtes (par exemple le 99e centile sous un seuil) et le taux d'erreur ou la disponibilité des connexions, mesurés au plus près de l'application ou du proxy. Il fixe un objectif sur une fenêtre glissante, en déduit un budget d'erreur et alerte sur la vitesse de consommation de ce budget plutôt que sur chaque pic de CPU. Les indicateurs internes (retard de réplication, connexions, verrous) servent au diagnostic sans devenir des SLO.
Signal d'alerteUn SLO à 100 %, ou des alertes sur le CPU à 80 % présentées comme un SLO.
Question 3 · confirmé
Comment appliquez-vous un patch mineur de sécurité sur 150 instances PostgreSQL avec un pipeline ?
Une bonne réponseLe parc est décrit dans un inventaire versionné (Ansible, Terraform ou opérateur Kubernetes). Le pipeline avance par vagues : hors production d'abord, puis un premier lot de production, en commençant par les réplicas, puis une bascule contrôlée et la mise à jour de l'ancien primaire. À chaque étape, des contrôles automatiques : réplication à jour, version attendue, requêtes de test, SLO non dégradés, avec arrêt du pipeline si un contrôle échoue. Les rôles sont idempotents et une procédure de retour arrière existe.
Signal d'alerteUne boucle shell qui se connecte en SSH à chaque serveur, sans contrôle entre les vagues.
Question 4 · confirmé
Comment prouvez-vous chaque semaine que vos sauvegardes se restaurent, sur un parc de 300 bases ?
Une bonne réponsePar une restauration automatisée : un job choisit des bases par rotation ou au hasard, les restaure sur une instance temporaire à partir des vraies sauvegardes (pgBackRest, XtraBackup, RMAN ou snapshots du service managé), lance des contrôles (démarrage, comptages, requête applicative), mesure la durée, publie le résultat en métrique et alerte si le test échoue ou dépasse le RTO. Un échec de restauration est traité comme un incident.
Signal d'alerteDes statuts de sauvegarde au vert dans l'outil, sans restauration testée.
Question 5 · confirmé
Sur MySQL 8, un ALTER TABLE sur une table de 2 To fait monter le retard des réplicas à plusieurs heures. Quelles options aviez-vous ?
Une bonne réponseD'abord vérifier si l'opération passe en ALGORITHM=INSTANT (ajout de colonne depuis 8.0.12, à n'importe quelle position depuis 8.0.29) ou en INPLACE. Un ALTER natif, même en ligne sur le primaire, se rejoue ensuite en série sur chaque réplica, d'où le retard. Sinon, un outil de migration en ligne : gh-ost, qui copie la table en suivant le binlog sans triggers et ralentit la copie selon le retard des réplicas, ou pt-online-schema-change, qui s'appuie sur des triggers. Le candidat planifie la bascule finale (cut-over) et garde la possibilité d'interrompre la copie.
Signal d'alerteLancer l'ALTER directement sur le primaire et attendre que les réplicas rattrapent.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
DBA, SRE ou DBRE : vos questions de recrutement
Quelle différence entre un DBA et un database reliability engineer ?
Le DBA de production administre des bases et traite les incidents, souvent instance par instance. Le DBRE garde ces compétences mais traite le parc comme du code : provisioning, patchs et migrations passent par des pipelines, la fiabilité se mesure par des SLO, les tâches répétées sont automatisées. En entretien, la différence se voit sur la question du patch de cent instances : le DBA décrit une procédure, le DBRE décrit un pipeline et ses contrôles.
Un SRE sans expérience des bases peut-il occuper le poste ?
Il apporte l'automatisation, les SLO et la culture des incidents. Il lui manque souvent la connaissance intime d'un moteur : verrous, réplication, VACUUM ou InnoDB, plans d'exécution, restauration à un instant donné. Sur une base critique, ces lacunes coûtent cher au premier incident. Vérifiez au moins une restauration déjà faite et une migration de schéma sur une grosse table avant de retenir ce profil.
Comment construire le test technique d'un DBRE ?
Donnez un cas proche du poste : une migration de schéma à rendre sans coupure, un rôle Ansible ou un module Terraform à relire, un incident à diagnostiquer à partir de graphiques et d'extraits de pg_stat_statements. Une heure d'échange sur ces supports suffit souvent. Un exercice de code générique ne dit rien de la connaissance des bases ; un questionnaire de commandes SQL ne dit rien de l'automatisation.
Faut-il exiger plusieurs moteurs de base de données ?
Cela dépend du parc. Une scale-up sur PostgreSQL a besoin d'une expertise profonde sur ce moteur. Une DSI qui exploite Oracle, SQL Server, PostgreSQL et MongoDB demande au moins deux moteurs maîtrisés, les autres pouvant s'apprendre. Dans tous les cas, préférez une vraie profondeur sur un moteur à une liste longue sur le CV, puisque l'automatisation se construit à partir de la connaissance fine d'un système.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.