Vos questions d'entretien pour un data scientist fraude doivent coller au quotidien du poste. Il entraîne des modèles de détection sur des données où la fraude reste très minoritaire, calcule des variables de vélocité en temps réel, exploite les liens entre comptes, appareils et IBAN, et règle des seuils selon le nombre d'alertes que les analystes peuvent traiter. Banques, prestataires de paiement, néobanques, assureurs et e-commerçants le recrutent, souvent dans une équipe qui couvre aussi la LCB-FT.
Un data scientist venu d'un autre domaine arrive avec de bons réflexes de machine learning et une métrique trompeuse. Il annonce une exactitude de 99,9 %, rééquilibre les classes par habitude et valide son modèle sur des mois dont les fraudes ne sont pas encore toutes connues. Un profil expérimenté raisonne en alertes par jour et en euros détectés, tient compte du délai d'arrivée des étiquettes et sait que le modèle en place biaise les données du suivant.
Si le poste est orienté LCB-FT, prenez aussi l'axe dédié du PDF, où l'explicabilité et la documentation comptent autant que la performance. Le PDF rassemble 30 questions sur six axes, un cas de 20 minutes sur une vague de prises de contrôle de comptes et une grille de 1 à 4.
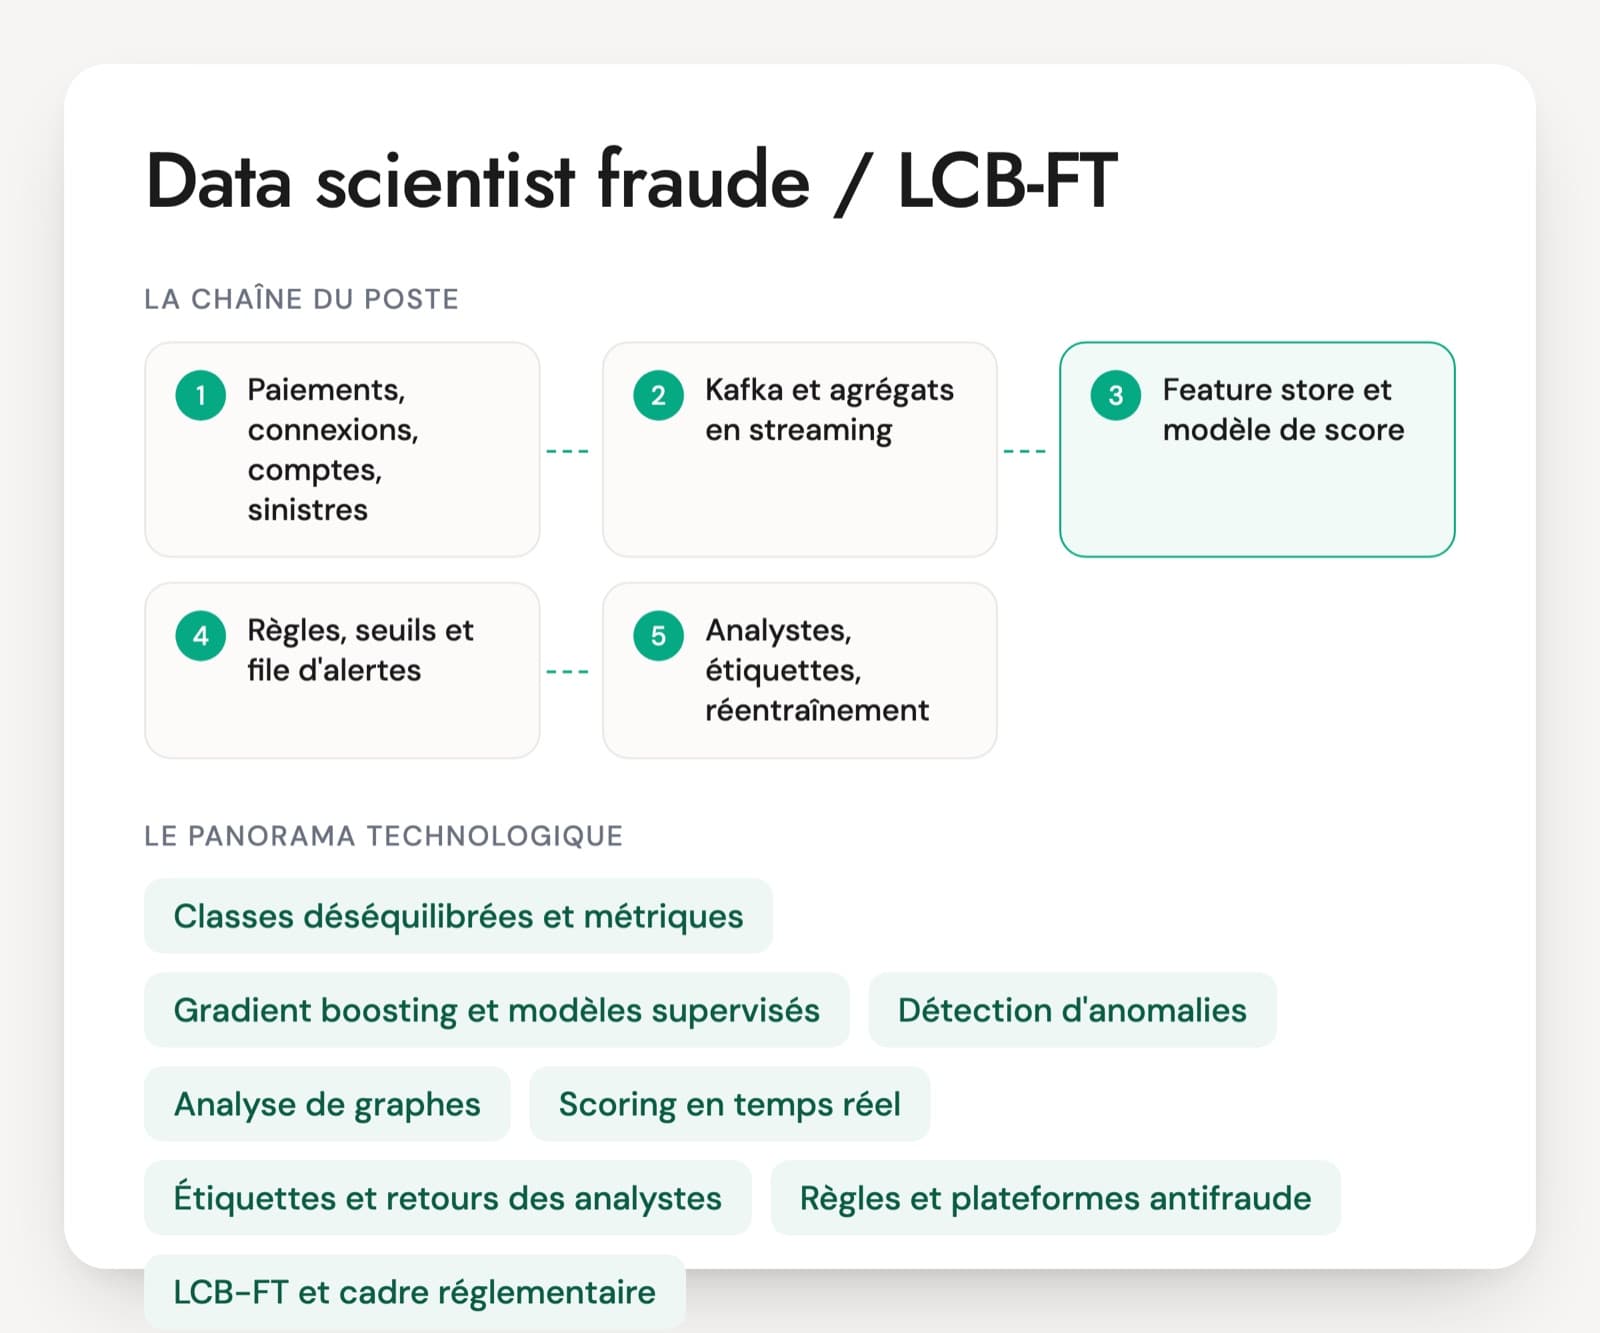
Techniques et outils d'un data scientist fraude
Classes déséquilibrées et métriques
Quand la fraude représente une infime partie des transactions, l'exactitude ne veut plus rien dire. On suit la courbe précision-rappel, la précision pour un volume d'alertes donné et le montant de fraude détecté. Pondérer les classes ou sous-échantillonner les cas normaux est courant, à condition de recalibrer ensuite les probabilités.
Gradient boosting et modèles supervisés
LightGBM, XGBoost ou CatBoost dominent sur ces données tabulaires. Une régression logistique ou une grille de score reste utile quand il faut expliquer chaque décision. Le modèle seul ne fait pas la performance : la qualité des variables et des étiquettes pèse davantage.
Détection d'anomalies
Isolation Forest, autoencodeurs ou méthodes de densité repèrent les comportements inhabituels sans étiquette. Elles servent pour les nouvelles formes de fraude et en LCB-FT, où les cas confirmés sont rares. Une anomalie n'est pas une fraude, et le tri revient aux analystes.
Analyse de graphes
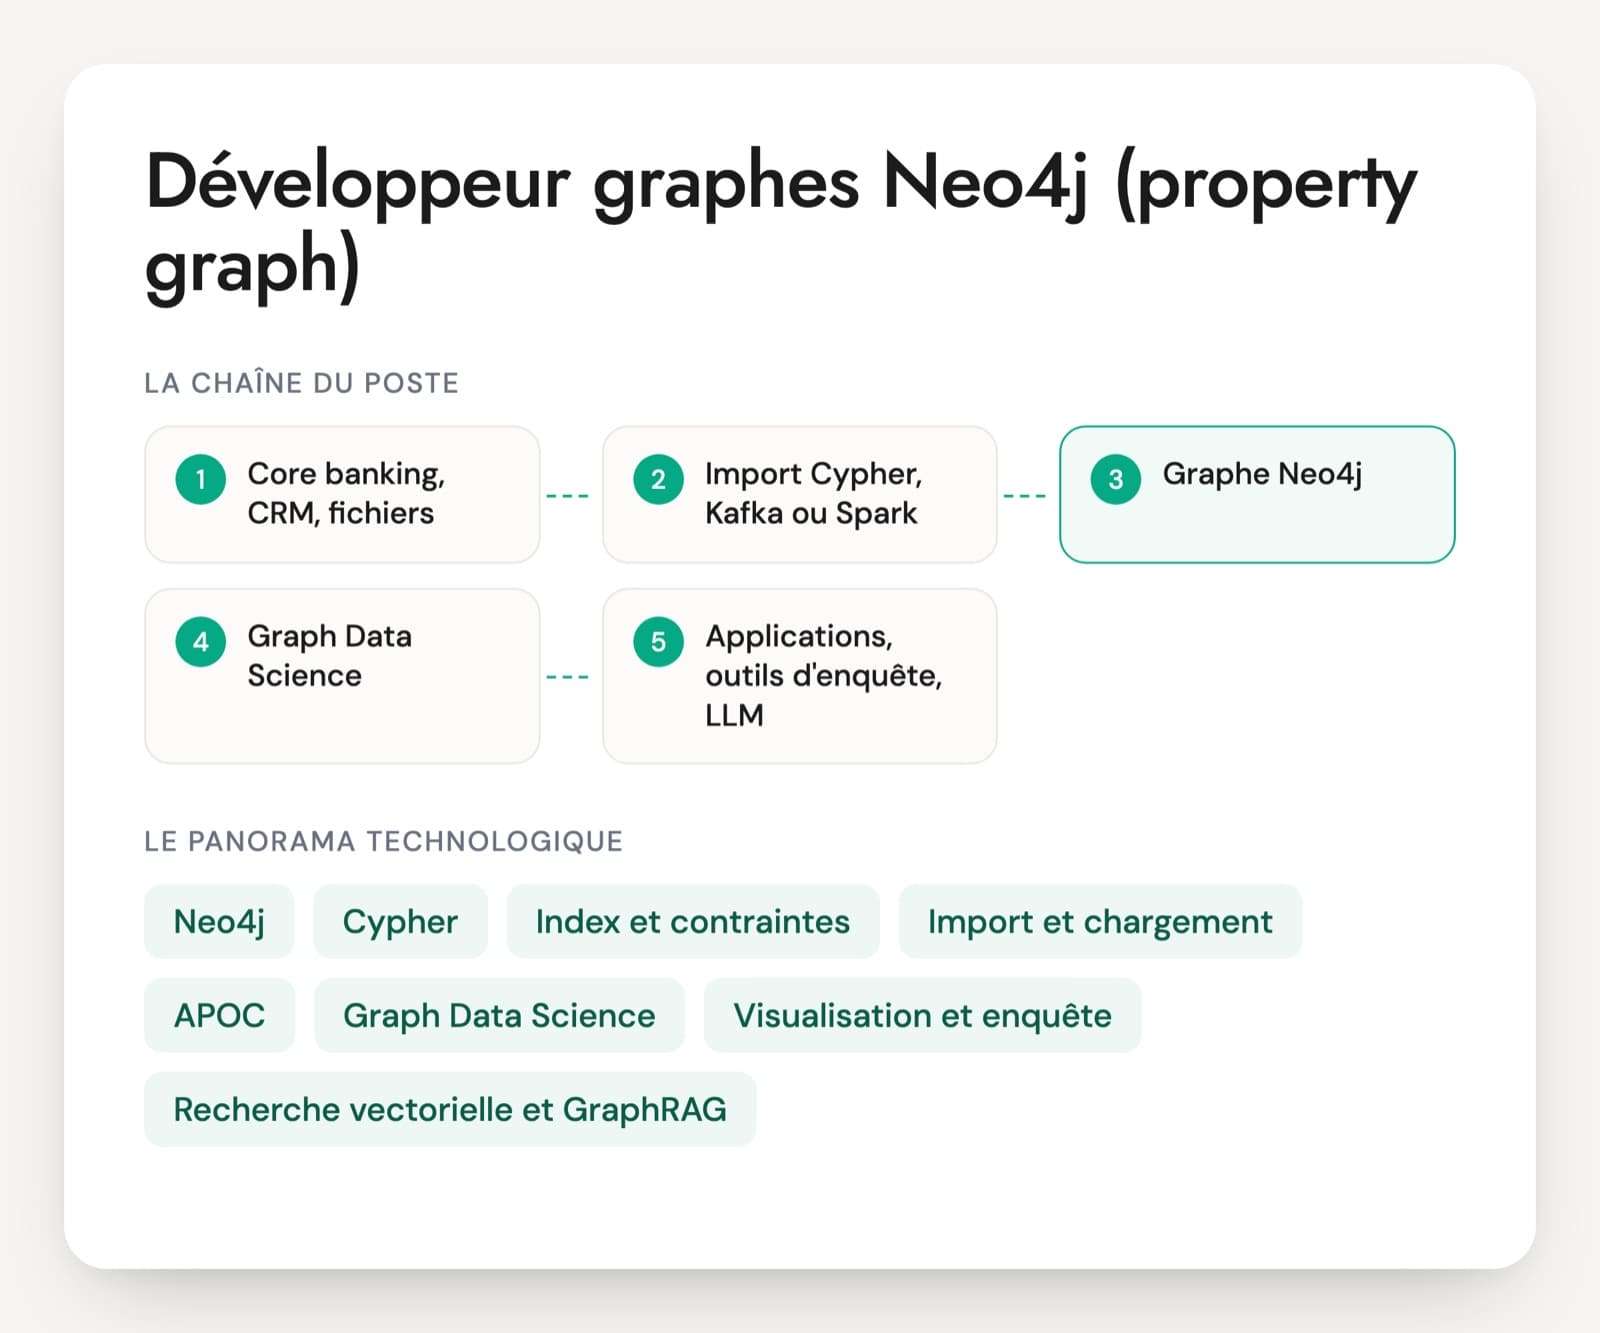
Comptes, appareils, IBAN, adresses et numéros de téléphone forment un réseau. Composantes connexes, centralité et détection de communautés font apparaître les réseaux de mules ou les ouvertures de comptes en série. Les outils cités sont Neo4j et sa bibliothèque Graph Data Science, NetworkX, et PyTorch Geometric pour les réseaux de neurones sur graphes.
Scoring en temps réel
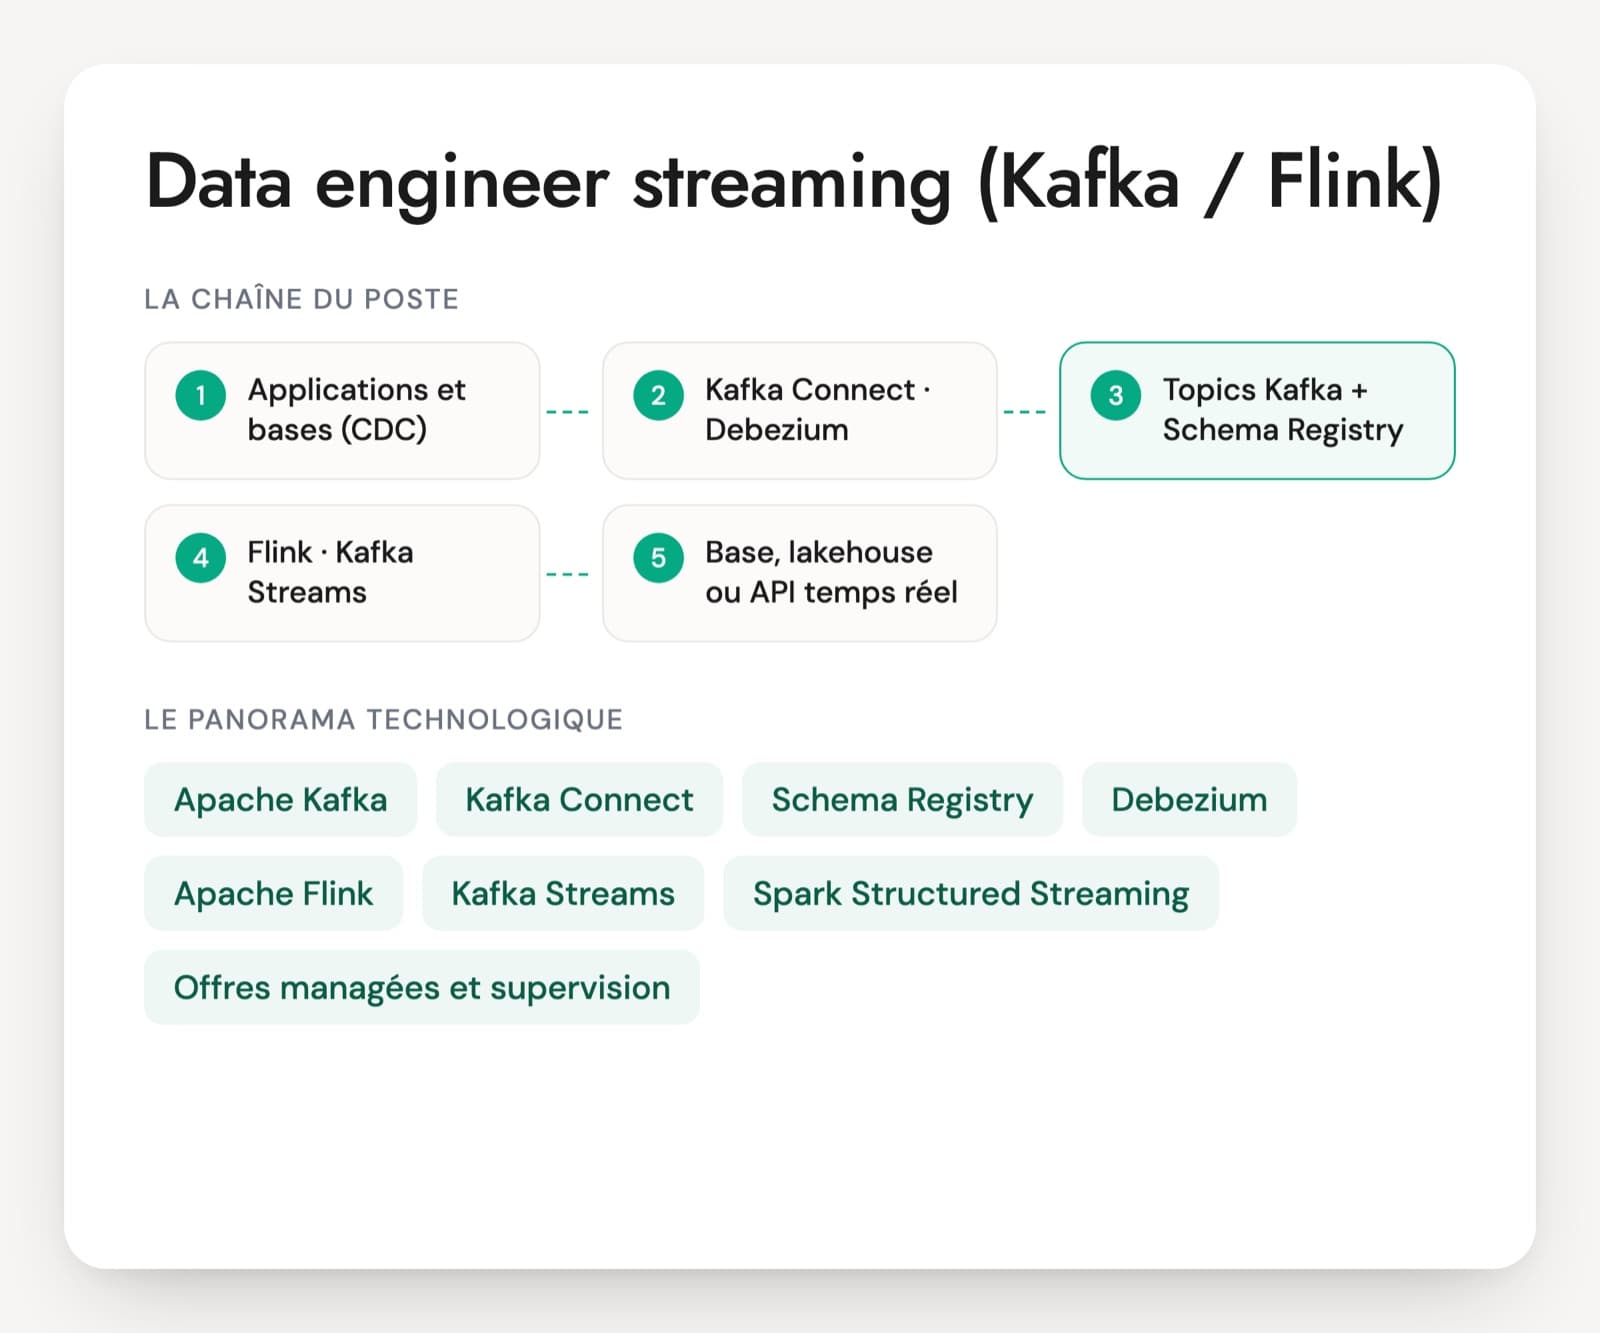
Pour un paiement, le score doit tomber pendant l'autorisation, en quelques dizaines de millisecondes. Les agrégats glissants (nombre de paiements de la carte sur une heure) sont calculés en streaming avec Kafka ou Flink et servis par un feature store en ligne. La même définition doit servir à l'entraînement, faute de quoi le modèle se dégrade en production.
Étiquettes et retours des analystes
Les étiquettes viennent des chargebacks, des réclamations clients et des conclusions des enquêteurs. Un chargeback peut arriver plusieurs semaines ou mois après le paiement, et seules les transactions alertées sont examinées. Comprendre d'où viennent les étiquettes est la moitié du travail.
Règles et plateformes antifraude
Les scores cohabitent avec des règles métier, souvent dans un moteur de décision interne ou une plateforme d'éditeur comme Feedzai, Featurespace ou SAS. Le data scientist propose des seuils et des règles autant que des modèles. Demandez comment les deux étaient combinés dans les projets du candidat.
LCB-FT et cadre réglementaire
La lutte contre le blanchiment repose sur des scénarios de surveillance, l'examen des alertes et les déclarations de soupçon à Tracfin, sous le contrôle de l'ACPR. Le règlement européen AMLR s'appliquera à partir de juillet 2027, avec une nouvelle autorité européenne, l'AMLA. Tout modèle y doit être documenté et ses alertes explicables.
Le poste prend des formes différentes. Chez un prestataire de paiement ou dans une néobanque, le data scientist fraude travaille sur le temps réel, avec des contraintes de latence fortes et une collaboration étroite avec les ingénieurs. Dans une grande banque, il rejoint souvent une équipe qui gère des modèles carte, virement et LCB-FT, avec une validation interne des modèles exigeante. Chez un assureur, la fraude se détecte sur des sinistres, en différé, avec beaucoup de texte et de documents. En ESN, les missions portent sur la refonte d'un modèle ou la réduction des fausses alertes. Le point commun reste la capacité à travailler avec des étiquettes imparfaites.
Les sujets techniques qui comptent pour un data scientist antifraude
- Modélisation sur classes très déséquilibrées
- Gestion des étiquettes tardives et biaisées
- Variables temps réel et scoring en ligne
- Analyse de graphes et réseaux de fraude
- Détection d'anomalies et dérive adversariale
- Modèles LCB-FT explicables et documentés
Cinq situations de détection à soumettre au candidat
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · junior à confirmé
Votre jeu de données contient 0,1 % de fraudes et le modèle affiche 99,9 % d'exactitude. Comment jugez-vous ses performances réelles ?
Une bonne réponseUn modèle qui ne détecte rien obtient ce score. Elle regarde la courbe précision-rappel, la précision et le rappel pour le nombre d'alertes que l'équipe peut traiter chaque jour, et le montant de fraude détecté, pas seulement le nombre de cas. Elle explique que l'AUC ROC flatte le modèle quand les cas normaux sont très nombreux, et met en face le coût des fausses alertes pour les clients bloqués.
Signal d'alerteSe contenter de l'exactitude, ou répondre « j'applique SMOTE » comme si le rééchantillonnage réglait la question de l'évaluation.
Question 2 · confirmé
Vous entraînez un modèle de fraude carte sur les douze derniers mois. Pourquoi les deux derniers mois posent-ils problème ?
Une bonne réponseLes chargebacks et les réclamations arrivent des semaines, parfois des mois après le paiement. Sur les mois récents, une partie des fraudes n'est pas encore étiquetée et passe pour du normal. Elle mesure sur l'historique la courbe d'arrivée des étiquettes, fixe une période de maturation, exclut ou pondère les mois incomplets et valide sur une période plus ancienne mais postérieure à l'entraînement.
Signal d'alerteUtiliser toutes les données telles quelles, en considérant chaque transaction sans étiquette comme légitime.
Question 3 · confirmé
Le score doit répondre en moins de 100 ms pendant l'autorisation, avec le nombre de paiements de la carte sur la dernière heure. Comment calculez-vous cette variable ?
Une bonne réponseUn agrégat glissant mis à jour en streaming (Kafka Streams ou Flink) et stocké dans une base clé-valeur ou un feature store en ligne, lu au moment du score. Pour l'entraînement, la même variable est recalculée telle qu'elle était connue à l'instant de chaque transaction, sans voir le futur. Elle prévoit une valeur par défaut et une décision de repli si la variable n'arrive pas à temps.
Signal d'alerteUne requête SQL sur l'entrepôt à chaque paiement, ou des variables d'entraînement calculées sur la journée entière.
Question 4 · senior
Des dizaines de comptes ouverts en un mois partagent des appareils, des IBAN et des adresses. Comment exploitez-vous ces liens dans la détection ?
Une bonne réponseElle construit un graphe entre comptes et éléments partagés, en calcule des variables (taille de la composante connexe, nombre d'appareils partagés, part de voisins déjà reconnus frauduleux à la date du score, communautés) et les ajoute au modèle. Elle fait attention à la fuite : un voisin étiqueté fraudeur après la date de la transaction ne doit pas compter. Elle cite Neo4j ou NetworkX et envisage un réseau de neurones sur graphe si le volume le justifie.
Signal d'alerteTraiter chaque compte isolément, ou propager les étiquettes dans le graphe sans tenir compte du temps.
Question 5 · confirmé
Trois semaines après la mise en production, la fraude détectée baisse alors que les pertes montent. Que vérifiez-vous ?
Une bonne réponseD'abord un problème de données : variable vide ou figée, changement d'un flux en amont, nouvelle valeur d'une catégorie. Ensuite une dérive réelle : nouveau mode opératoire, comparaison de la distribution des variables et du score (PSI), analyse des pertes par segment (canal, pays, marchand, type d'appareil). Elle demande aux analystes ce qu'ils voient, propose une règle temporaire et prépare un réentraînement.
Signal d'alerteRéentraîner tout de suite sans diagnostic, ou monter le seuil d'alerte à l'aveugle.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Avant d'ouvrir un poste de data scientist fraude
Comment le travail se répartit-il entre data scientist et data analyst fraude ?
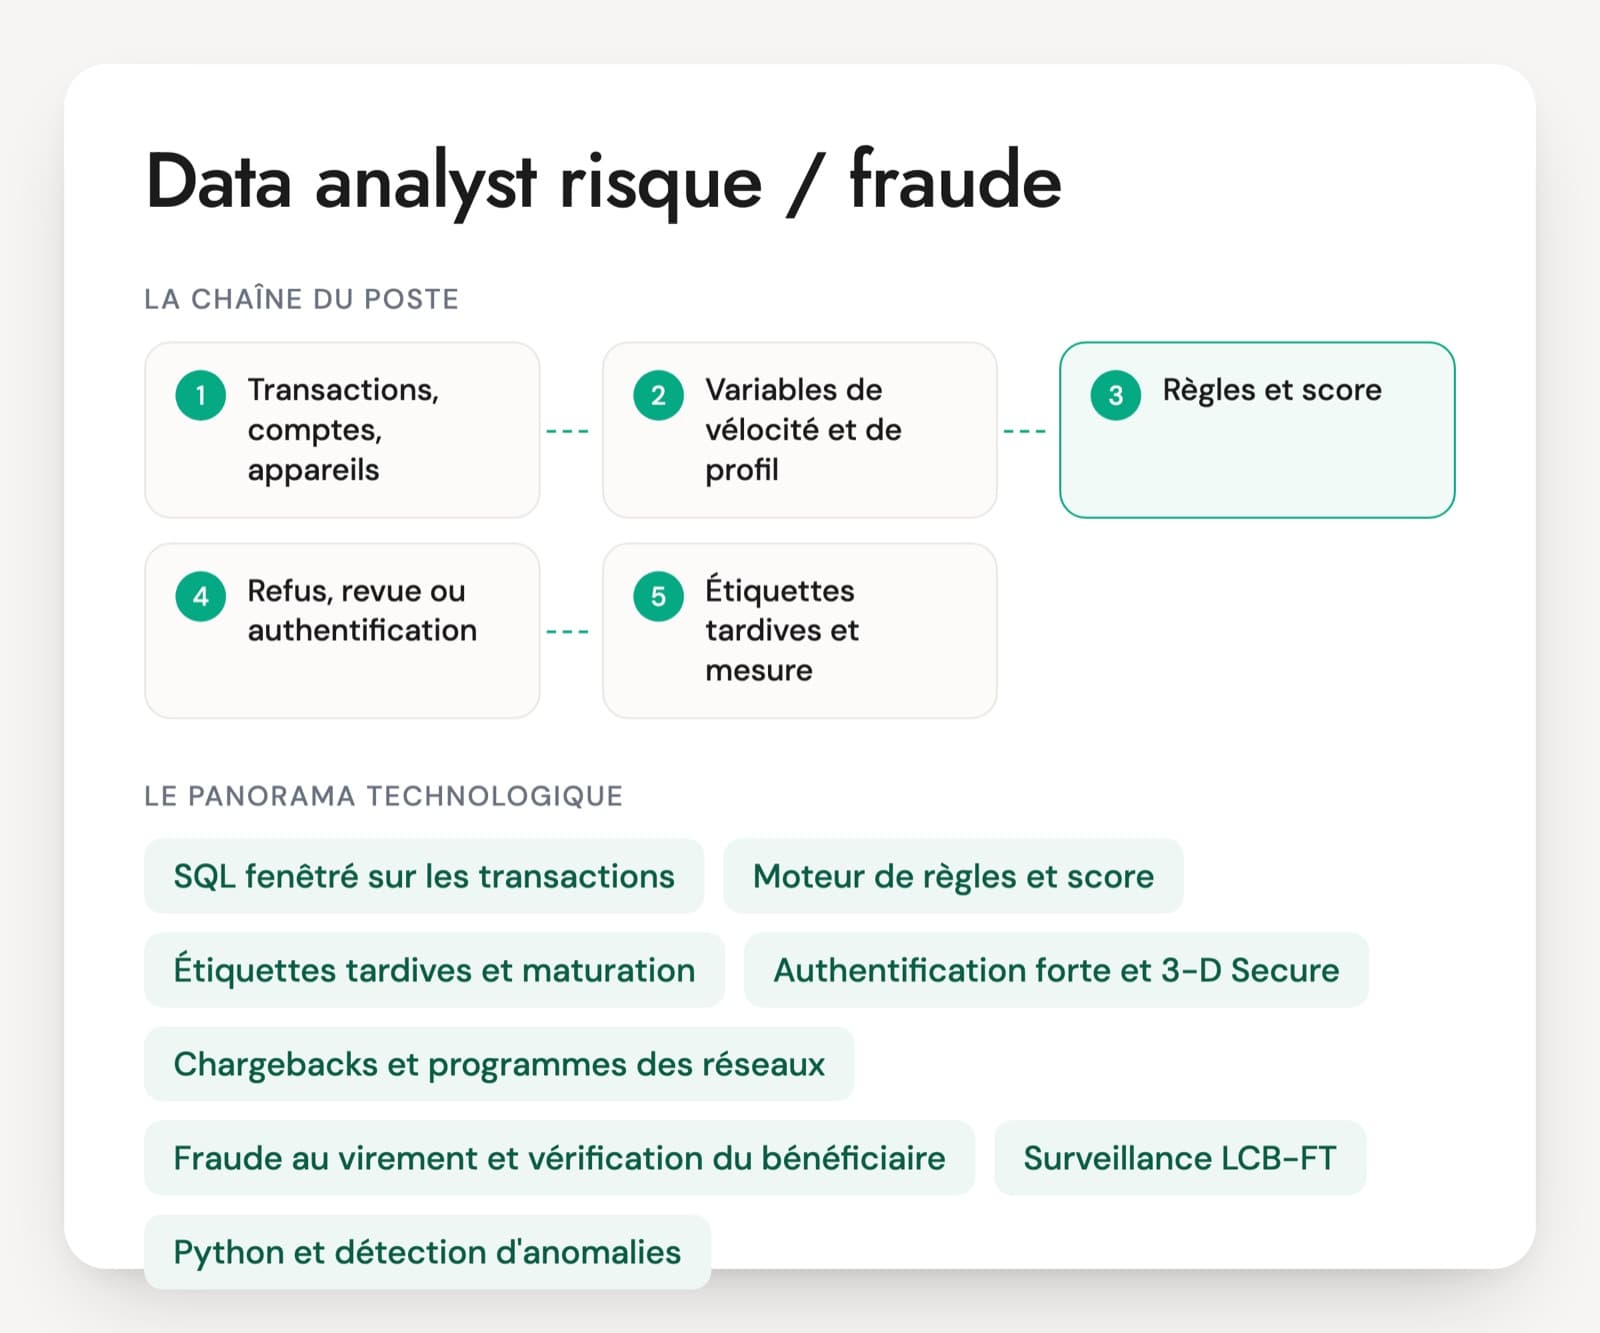
Le data analyst fraude suit les indicateurs, conçoit et règle des règles de détection, analyse les chargebacks et les alertes en SQL. Le data scientist fraude construit les modèles de score, les variables temps réel et les analyses de graphes, et travaille avec les ingénieurs sur leur mise en production. Les deux postes se parlent beaucoup. Si votre dispositif repose surtout sur des règles, un analyste suffit souvent pour démarrer.
Un data scientist sans expérience de la fraude peut-il réussir sur ce poste ?
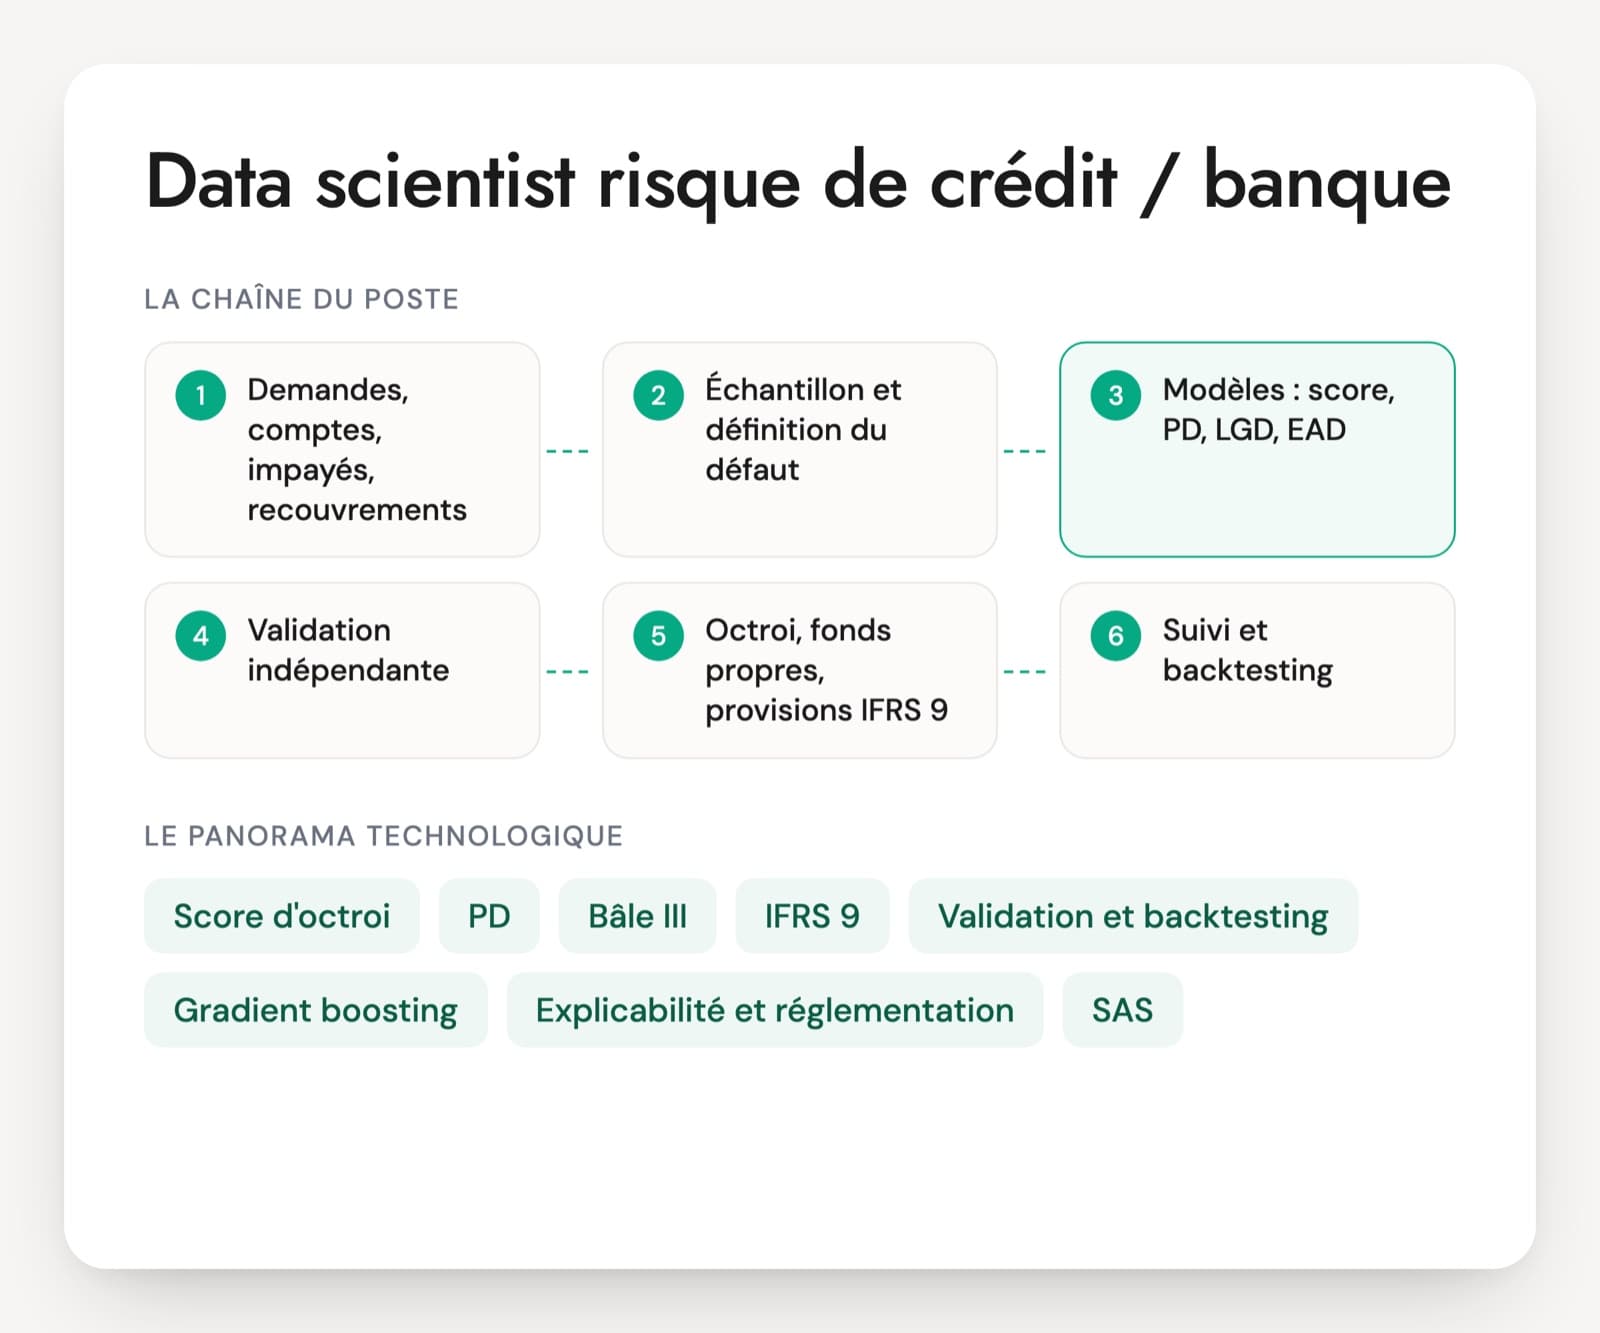
Oui, si les bases sont solides et si vous le testez sur ce qui change : métriques adaptées aux classes rares, étiquettes tardives, biais créé par le modèle en place, contraintes de latence. Un profil qui a travaillé sur le churn ou le risque de crédit a déjà une partie de ces réflexes. Celui qui ne connaît que des jeux de données équilibrés et des validations aléatoires aura plus de chemin à faire.
Sur quel jeu de données tester un data scientist fraude ?
Pour le test technique, un jeu de transactions avec des dates, des identifiants de carte et une étiquette de fraude suffit. Demandez de construire deux ou trois variables de vélocité sans fuite, de choisir une métrique et un seuil pour un volume d'alertes imposé, puis de commenter les résultats. Une heure en direct montre la rigueur sur le temps et l'évaluation. Un dataset public trop connu permet de réciter une solution déjà vue.
Pourquoi l'explicabilité pèse-t-elle autant sur un modèle LCB-FT ?
Chaque alerte est examinée par un analyste qui doit comprendre pourquoi elle est sortie et décider d'une éventuelle déclaration de soupçon. Le dispositif est contrôlé par l'ACPR, et le futur règlement européen AMLR renforcera les attentes. Un modèle performant mais opaque sera refusé par la conformité ou la validation. En entretien, demandez comment le candidat a présenté les motifs d'une alerte à un analyste.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.